【最佳实践】DTS轻松实现RDS for MySQL与阿里云Elasticsearch数据实时同步
本文介绍如何使用 DTS 快速创建RDS for MySQL->阿里云Elasticsearch的实时同步作业,实现RDS for MySQL数据到阿里云Elasticsearch的实时同步。
海量监控日志基于EMR Spark Streaming SQL进行实时聚合
从EMR-3.21.0 版本开始将提供Spark Streaming SQL的预览版功能,支持使用SQL来开发流式分析作业。结果数据可以实时写入Tablestore。 本文以LogHub为数据源,收集ECS上的日志数据,通过Spark Streaming SQL进行聚合后,将流计算结果数据实时写入Tablestore,展示一个简单的日志监控场景。
Flink Weekly | 每周社区动态更新 - 20200318
Flink Weekly 周报计划每周更新一期,内容涵盖邮件列表中用户问题的解答、社区开发和提议的进展、社区新闻以及其他活动、博客文章等,欢迎持续关注~
【MaxCompute季报】MaxCompute新功能发布 2019Q2
2019年Q2 MaxCompute发布了一系列新功能。 本文对主要新功能和增强功能进行了概述。 SQL新功能 华北张家口节点正式开服售卖 国际Region Spark商业化发布 存储降价 元数据服务Information Schema MaxCompute搬站迁移工具MMA 数据脱敏 Tunn...
CTR中的GBDT+LR 融合方案_副本
实现GBDT与LR的融合<br />数据源:<br />数据大小:1.54 MB<br />字段数量:20<br />使用组件:拆分,读数据表,特征编码<br />

Kerberos使用OpenLDAP作为backend
本文介绍Kerberos对接OpenLDAP, 使用OpenLDAP作为principal数据库
Apache Spark中国技术交流群升级到企业群啦!!!!!!
普通群容量已满足不了Spark群众日益增长的热情,因此我们做了一个重要的决定,将全部群成员转移到企业群
有赞实时任务优化:Flink Checkpoint 异常解析与应用实践
本文结合 Flink 1.9 版本,重点讲述 Flink Checkpoint 原理流程以及常见原因分析,让用户能够更好的理解 Flink Checkpoint,从而开发出更健壮的实时任务。
Flink kafka source & sink 源码解析
本文基于 Flink 1.9.0 和 Kafka 2.3 版本,对 Flink Kafka source 和 sink 端的源码进行解析,主要分为 Flink-kafka-source 源码解析、Flink-kafka-sink 源码解析两部分。
7月31日Spark钉钉群直播【Apache Spark 在存储计算分离趋势下的数据缓存】
在数据上云的大背景下,存储计算分离逐渐成为了大数据处理的一大趋势,计算引擎需要通过网络读写远端的数据,很多情况下 IO 成为了整个计算任务的瓶颈,因而数据缓存成为此类场景下的一个重要的优化手段。本次分享将介绍 Spark 在数据缓存上的一些做法,并将介绍 EMR 自研的 Jindo 存储系统在数据缓存上的应用。
从开发到生产上线,如何确定集群规划大小?
在 Flink 社区中,最常被问到的问题之一是:在从开发到生产上线的过程中如何确定集群的大小。这个问题的标准答案显然是“视情况而定”,但这并非一个有用的答案。本文概述了一系列的相关问题,通过回答这些问题,或许你能得出一些数字作为指导和参考。
【技术干货】想要高效采集数据到阿里云Elasticsearch,这些方法你知道吗?
本文全面介绍了Elastic Beats、Logstash、语言客户端以及Kibana开发者工具的特性及数据采集到阿里云Elasticsearch(简称ES)服务中的解决方案。帮助您全面了解原理并选择符合自身业务特色的数据采集方案。
钉钉群直播【E-MapReduce产品探秘,快速构建可扩展的高性能大数据平台】
E-MapReduce整体介绍。通过EMR如何构建一个云上的大数据集群,常见的使用场景和硬件选型指南。
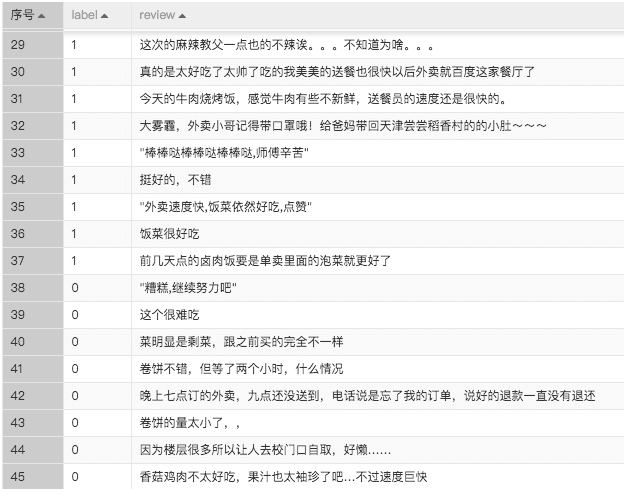
基于外卖评论的舆情风控
目前许多商家都有线上留言或者评论反馈平台,消费者可以在这些平台上通过留言表达自己对于消费商品的反馈。消费者的反馈包括表扬性的正向反馈,也有一些批评性质的负向反馈。商家需要掌握消费者对于产品的整体舆论取向来判断自己的产品质量是否符合消费者需求,同时了解评论内容可以方便商家分析舆论导向,指导下一步产品研发工作。
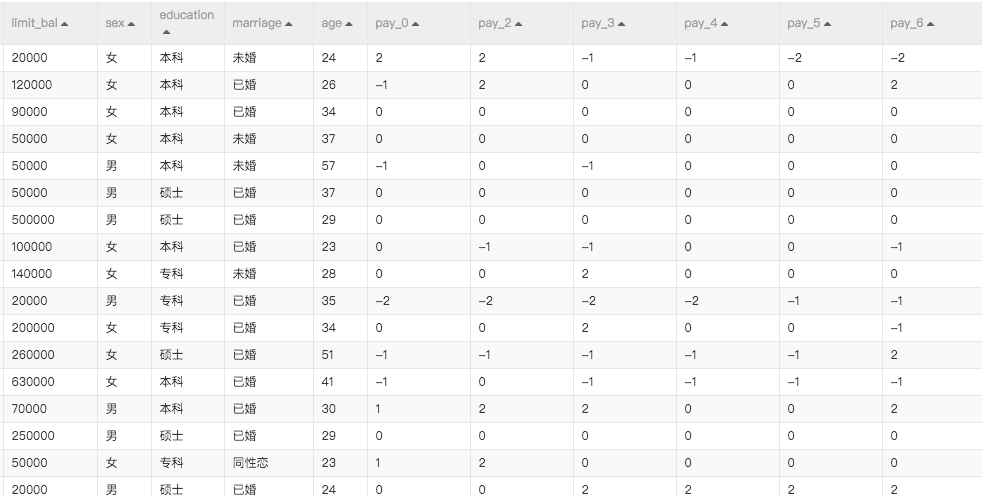
基于消费信用评估的风控
信用评估是被当前社会广泛关注的领域,特别是在金融行业,如果可以通过每个用户的历史交易数据以及用户画像数据确定用户的个人信用,将有助于银行设置个人借贷额度,确定潜在风险。本文将介绍在金融风控领域如何进行用户画像,使用什么样的算法可以计算出每个用户的信用指标。
yonghuahuaxiang
基于用户画像和消费行为的商品推荐<br />数据源:购物数据<br />数据大小:184 KB<br />字段数量:4<br />使用组件:归一化,过滤与映射,SQL脚本,缺失值填充,读数据表,JOIN,类型转换<br />
Flink Weekly | 每周社区动态更新-20200429
大家好,本文为 Flink Weekly 的第十四期,由李本超整理,伍翀 Review。本期主要内容包括:近期社区开发进展、邮件问题答疑、Flink 最新社区动态及技术文章推荐等。
雾霾天气预测_1150
test<br />数据源:test<br />数据大小:37.3 KB<br />字段数量:7<br />使用组件:读数据表,类型转换,SQL脚本,归一化,拆分<br />
Egde卸载教程!edge浏览器卸载工具!EdgeRemover v18.38新版本,单文件便携版!
Edge浏览器虽功能强大,却常因无法彻底卸载让用户体验困扰。本文推荐一款专清工具——Edge Remover,支持一键移除Edge及WebView2运行时,两种模式灵活选择,操作简单,无需专业技能,彻底清理不留残留,释放C盘空间,提升系统纯净度,是Windows用户必备的卸载利器。

一文说明白 AI API中转站是什么?
AI API中转站是连接国内开发者与海外大模型(如OpenAI、Claude)的代理平台,破解网络、支付、注册三重壁垒。支持微信/支付宝充值、统一OpenAI格式调用、智能路由与自建号池,以“倍率”计费(官方价×倍率)。适合中小团队降本提效,但需警惕低价掺水、数据安全与服务稳定性。
Spark Codegen浅析
Codegen是Spark Runtime优化性能的关键技术,核心在于动态生成java代码、即时compile和加载,把解释执行转化为编译执行。Spark Codegen分为Expression级别和WholeStage级别,分别针对表达式计算和全Stage计算做代码生成,都取得了数量级的性能提升。本文浅析Spark Codegen技术原理。
图解强化学习 |手算PG算法
PG(Policy Gradient)策略梯度算法直接优化策略网络,输出动作概率而非价值,适用于离散/连续动作空间。需整回合采样后计算折扣回报Gₜ,以-logπ·G为损失函数更新参数,提升高回报动作概率。可引入基线(如平均回报)构建优势函数,提升训练稳定性与效率。(239字)
云上一指禅:大数据产品DataWorks每日问答
每天,阿里巴巴集团数万名数据/算法开发工程师正在使用DataWorks,承载阿里巴巴集团99%数据业务构建。
2026企业AI如何真正落地?深度拆解60+全球案例
2026年企业AI应用已告别“大模型万能论”。本文基于斯坦福《企业AI实战手册》及16家头部企业案例,提炼7条落地共性:AI须嵌入核心业务流程;高风险行业坚持“人先于AI”;数据质量决定成效上限;行业分化加剧,通用方案失效;价值重心从个人提效转向组织决策;AI需持续运营而非一次性项目;推荐以8周闭环验证真实场景,本质是经营能力的竞争。

12月5日Spark社区直播【是时候改变你数仓的增量同步方案了】
本分享会先介绍传统数据增量同步方案,之后对比新方案(完全基于Spark无需额外组件),介绍新方案如何结合最新的数据湖(delta lake)实现,同时引入spark-binlog,极大的简化了数据增量的门槛和架构。如果时间允许,我们也会简单介绍开源项目spark-binlog,delta-plus等的内部设计是如何支持我们新的数据增量方案的。
开发者必看:HTTP 2xx 响应码的正确理解与运用
HTTP 2xx状态码表示请求成功,涵盖200(成功)、201(已创建)、202(已接受)、204(无内容)和206(部分内容)五类。开发者需准确识别以优化调试与用户体验。
阿里云大数据 AI 平台 Skills 合集
阿里云大数据 AI 平台 Agent Skills(简称 Skills)是阿里云大数据 AI 平台官方提供的 AI Agent 技能发现与安装平台,为 Agent 提供安全、可靠的云资源操作能力,本文汇总阿里云大数据 AI 平台 Skills,帮助用户快速导航。
Microsoft Activation Scripts v3.6 (MAS)激活工具安装教程!中文汉化版(激活工具)
Microsoft Activation Scripts v3.6(MAS)是一款开源、轻量级的批量激活工具,支持HWID、KMS38、TSforge等多种方式,可离线永久激活Win7至Win11及Office全系列。兼容旧系统如Vista,操作简单,无误报风险。
PyCharm 2025.1 完整教程:下载安装 + 中文设置 + 激活,一步到位,附安装包
PyCharm 2025.1 发布,重磅升级AI代码补全、类型推断与ruff集成,提升开发效率。支持渐进式补全、智能提交信息生成、冲突可视化解决,优化启动速度与内存占用,全面增强云原生及现代Python开发体验。
e - 一个神奇的存在
本文介绍了数学常数e,即自然对数的底,约等于2.71828,由欧拉命名。e是一个无限不循环小数,可通过级数1 + 1/n!表示。e在数学、物理、工程和计算机科学等领域有广泛应用,尤其在微积分、复利、概率统计和算法分析中扮演关键角色。它是自然界和科学研究中的基本概念。
动动嘴就能建模?Blender全流程部署AI建模插件教程 | 零门槛实现AI驱动3D创作
本文为Blender用户详解mcp插件部署全流程:基于MCP协议,实现Cursor等AI客户端与Blender双向通信。无需写代码,一句自然语言即可完成建模、材质、灯光、渲染等3D创作,10分钟极速启用AI生产力。
反向海淘实战:Pandabuy、ACbuy、Cssbuy、Superbuy、CNFans 代购集运系统搭建真实体验
近年反向海淘火爆,Pandabuy等平台成海外用户采购中国货主流渠道。本文基于实操经验,从模式拆解、搭建流程、核心难点、实测对比四维度,分享如何用taocarts快速(7天)搭建合规、稳定、全链路代购集运系统,助创业者低成本入局。
Windows 环境下 llama.cpp 编译运行指南
本文详解Windows下用llama.cpp本地部署大模型:从VS2026编译(支持CPU/GPU)、ModelScope下载GGUF格式Qwen2.5-1.5B模型,到启动llama-server API服务及Python调用验证,全程轻量、低延迟、高隐私,助力开发者快速落地。
大模型应用:庖丁解牛:QKV机制详解,大模型的注意力之眼.4
QKV机制是Transformer注意力的核心:Query(提问)、Key(标识)、Value(信息)三者通过点积计算相似度,Softmax归一化后加权融合Value,实现动态上下文感知。它能捕捉长程依赖,解决代词消解、一词多义等问题,支撑大模型强大语言理解能力。
【下载安装】Adobe XD 免费下载与安装教程
Adobe XD 2025是一款专业的UI/UX设计工具,支持矢量绘图、交互原型制作与响应式布局,兼容PS、AI及Jira、Slack等协作平台。内置动画、语音交互功能,提升设计效率。安装前需关闭杀毒软件,解压后以管理员身份运行安装程序即可。

摸鱼必备-80款在线HTML小游戏
本文推荐了80款精彩的HTML5在线小游戏,涵盖益智、冒险、射击、体育等多种类型,适合各年龄段玩家。无需下载安装,随时随地畅玩。地址:[https://game.share888.top/](https://game.share888.top/)
AI生成网站入门指南:从零基础到专业建站的路径
零基础建站难?AI生成网站成新选择!无需代码、低成本,三步搞定:①明确目标场景;②用自然语言生成页面与前后端代码(如LynxCode);③优化交互与适配。AI不替代开发者,而是降低门槛、提升效率,助创业者快速验证想法。
【建站实战】用 ESA + Cloudflare 把网站月费压到接近零费用
本文以geojsoncn.com为例,详解如何用阿里云ESA(中国边缘)+ Cloudflare Workers + R2构建百度友好型静态站:ESA保障国内可达与ICP备案,Workers无服务器计算,R2低成本存储。三者协同,月成本压至约10元,兼顾SEO硬指标与极致性价比。(239字)

美股(纳斯达克/纽交所)数据 API 对接实战(含实时行情与 IPO 功能)
本文介绍如何通过StockTV API快速对接美股数据,支持纳斯达克、纽交所实时行情、IPO日历、K线图及公司基本面信息。仅需配置`countryId=5`,即可高效集成专业级金融数据,适用于量化交易与行情应用开发。
Multisim14.0中文下载安装步骤教程
Multisim14.0是由美国NI公司开发的EDA工具,适用于电路设计与仿真。本文提供详细中文安装步骤:下载安装包后解压,运行安装程序并设置路径,填写用户信息,选择安装位置,接受协议完成安装。随后安装NILicense激活器及中文语言包,最终实现软件汉化与正常运行。附带网盘下载链接,方便国内用户获取资源。
Databricks 实测 Spark 比 Flink 快 92%,流计算要变天了。
Databricks 3月2日发布测评:Spark Real-Time Mode(RTM)在实时特征计算(编码、enrichment、聚合)中,较Flink最高快92%(p99延迟9ms vs 95ms)。RTM打破微批限制,实现毫秒级低延迟、全状态支持与流式Shuffle,挑战“必须双引擎”行业共识。
用大模型拆解规则怪谈:以《午夜代驾:乘客请遵守规则》为例
规则怪谈并不只是“列几条吓人的禁令”。真正能让读者持续追更的,是规则、人物动机、世界观代价之间能够彼此闭环。本文以原创小说《午夜代驾:乘客请遵守规则》为例,分享如何借助大模型完成规则库梳理、剧情矛盾检查和章节大纲推演,并给出可直接复用的提示词模板。本文仅讨论 AI 辅助小说创作方法,不替代作者的最终判断。

一篇看懂!MLSQL 是如何作为一个可编程的 SQL 语言的?
重点讲解 MLSQL 的一些语法特性,通过这些特性的覆盖,我们可以看到 MLSQL 是怎么作为一个可编程的 SQL 语言的。
Miniconda 安装与环境配置全流程图解(2025 最新版)
Miniconda 可以看作是 Anaconda 的“轻装版”,只自带 conda 包管理器与基础的 Python 运行时。它体积小、部署速度快,特别适合按需创建与管理虚拟环境的用户。与 Anaconda 相比,Miniconda 不会预先安装一大堆科学计算库,你可以根据项目需求再单独选择、安装需要的包,因此整体更轻巧、更灵活。 本文将手把手演示在 Windows 下安装 Miniconda 的全过程:从下载安装器、完成向导配置、设置环境变量,到最后的基础验证与简单示例,帮助你迅速把 Miniconda 用起来。
盘点 7 款文本转语音工具:从免费朗读到可控情绪合成
参考社区里关于免费文本转语音工具的盘点思路,整理 Edge TTS、TTSMaker、Luvvoice、FlowSpeech、Fish Audio、ChatTTS、EmotiVoice 7 类 TTS 工具的适用场景,并从脚本验证、创作者旁白、情绪控制、开源实验和素材管理角度给出选型建议。

密钥配置+报错排查|OpenClaw 适配DeepSeek完整教程
本教程为OpenClaw(v2.6.4/v2.6.6)对接DeepSeek大模型的零基础图文指南,涵盖实名认证、API密钥创建、配置测试及模型选用全流程,步骤清晰、截图详实,助Windows用户10分钟完成安全稳定接入。(239字)

大数据与机器学习
大数据领域前沿技术分享与交流,这里不止有技术干货、学习心得、企业实践、社区活动,还有未来。