
odps是什么?
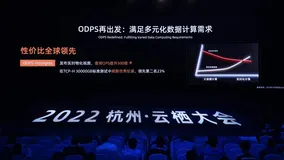
ODPS(Open Data Processing Service),原是阿里云从 09年开始自研的大规模批量计算引擎,2016 年更名为MaxCompute。2022云栖大会上,阿里云ODPS全新升级为一体化大数据平台,存储、调度、元数据一体化融合 ,从 Processing 升级为 Platform,即 Open Data Platform and Service。提供了离线计算、实时交互式分析、机器学习等可扩展的智能计算引擎,满足用户多元化数据计算需求。
MaxCompute执行作业慢的原因排查
大家在平时开发过程中经常遇到作业(SQL、MR等)执行慢的原因,今天带大家一起学习自排查方法。 1、wait wait ,job querying 遇到这个提示,就是资源出现了排队,如果你是后付费用户,那就是整个后付费的共享池已经没有富余的资源了,要等前一个作业处理完。
阿里云MaxCompute(大数据)公开数据集---带你玩转人工智能
目前阿里云大数据产品已经免费向全部用户开放了多种公用数据集。开放的数据类别包括:股票价格数据,房产信息,影视及其票房数据。
优酷背后的大数据秘密
大家好,我是门德亮,现在在优酷数据中台做数据相关的事情。很荣幸,我正好见证了优酷从没有MaxCompute到有的这样一个历程,因为刚刚好我就是入职优酷差不多5年的时间,我们正好是在快到5年的时候,去做了从Hadoop到MaxCompute的这样一个升级。
2017杭州云栖大会FAQ(持续更新中)
2017杭州云栖大会将于10月11-14日在杭州云栖小镇举办,作为全球最具影响力的科技展会之一,今年的云栖大会规模更大,内容也更丰富。为了帮助大家解决报名、参会中的一些问题,小编专门整理了下大会相关的FAQ,供大家参考。
Python+大数据计算平台,PyODPS架构手把手教你搭建
在2016年10月的云栖社区在线培训上,来自阿里云大数据事业部的秦续业分享了《双剑合壁——Python和大数据计算平台的结合实战》。他主要介绍了数据分析和机器学习的方法、DataFrame整体架构以及基础API、前端、后端、机器学习的具体实现方法。
如何使用Kafka Connect实现同步RDS binlog数据
本文介绍如何在E-MapReduce上使用Kafka Connect实现同步RDS binlog数据
JindoFS解析 - 云上大数据高性能数据湖存储方案
JindoFS 是云原生的文件系统,可以提供OSS 超大容量以及本地磁盘的性能
MaxCompute SQL原理解析及性能调优
分享内容 介绍了ODPS SQL的基于mapreduce是如何实现的及一些使用小技巧,回顾了mapreduce各个阶段可能产生的问题及相应的处理方法,同时介绍了一些应对数据倾斜的处理方法,最后介绍了一些关于数据集构造、特征选择的技巧帮助减少资源利用。
在 Apache Spark 中利用 HyperLogLog 函数实现高级分析
预聚合是高性能分析中的常用技术,通过预先聚合降低纬度,从而在查询时大幅减少计算量,提升响应速度。本文介绍了 spark-alchemy 这个开源库中的 HyperLogLog 这一个高级功能,并且探讨它是如何解决大数据中数据聚合的问题。
深入阿里云大数据IDE–MaxCompute Studio
在云栖社区主办的云栖计算之旅第5期–大数据与人工智能分享中,阿里云计算平台高级专家薛明为大家深入地介绍了阿里云大数据IDE–MaxCompute Studio,并对于其特性和背后的技术思想进行了讲解。
Apache Spark 3.0 将内置支持 GPU 调度
如今大数据和机器学习已经有了很大的结合,在机器学习里面,因为计算迭代的时间可能会很长,开发人员一般会选择使用 GPU、FPGA 或 TPU 来加速计算。在 Apache Hadoop 3.1 版本里面已经开始内置原生支持 GPU 和 FPGA 了。
【入门指南】使用阿里云Elasticsearch搭建ELK日志系统
本文介绍了基于阿里云Elasticsearch搭建ELK日志系统的基本步骤,并对kibana和ES的日志检索和分析做简要介绍,可作为新手入门指导。
从声学模型算法角度总结 2016 年语音识别的重大进步
免费开通大数据服务:https://www.aliyun.com/product/odps 在过去的一年中,语音识别再次取得非常大的突破。IBM、微软等多家机构相继推出了自己的 Deep CNN 模型,提升了语音识别的准确率;Residual/Highway 网络的提出使我们可以把神经网络训练的更加深。
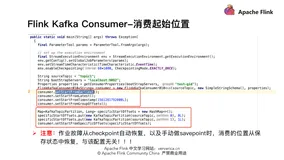
如何正确使用 Flink Connector?
本文主要分享 Flink connector 相关内容,分为以下三个部分的内容:第一部分会首先介绍一下 Flink Connector 有哪些。第二部分会重点介绍在生产环境中经常使用的 kafka connector 的基本的原理以及使用方法。第三部分答疑,对社区反馈的问题进行答疑。
SQL优化器原理 - 查询优化器综述
本文主要是对数据库查询优化器的一个综述,包括查询优化器分类、查询优化器执行过程和CBO框架Calcite。
(ElasticsSearch学习)歌词检索Demo的实现:二. 搭建spring boot+spring data+jest+elasticsearch环境,实现歌词的全文检索
一个ElasticSearchDemo,讲解如何使用Jsoup爬取歌词数据写入阿里云Elasticsearch,并搭建Web框架实现歌词的全文检索。 本文主要讲解如何使用Spring Boot快速搭建Web框架,结合Spring Data 和 Jest 快速实现对阿里云ElasticSearch的全文检索功能。
阿里巴巴大数据技术关键进展及展望
2019杭州云栖大会大数据技术专场,由阿里云通用计算平台负责人关涛带来以 “阿里巴巴大数据技术关键进展及展望” 为主题的演讲。本文首先讲解了从阿里巴巴的角度看待大数据领域的客户价值迁移,概览了核心技术的发展点,最后针对如何构建智能化大数据平台的相关工作进行了介绍,从引擎优化到 “自动驾驶”,并列举了几个典型案例。
【X-Pack解读】阿里云Elasticsearch X-Pack 监控组件功能详解
阿里云Elasticsearch集成了Elastic Stack商业版的X-Pack组件包,包括安全、告警、监控、报表生成、图分析、机器学习等组件,用户可以开箱即用。本文将对X-Pack 的监控组件功能进行详细解读。
【干货合集 视频+资料下载】2019大数据技术公开课第三季 | 阿里巴巴大数据产品最新特性介绍
2019大数据技术公开课第三季将为你带来阿里云飞天大数据平台系列产品的最新特性介绍,四位产品专家,四次主题分享,带你全面了解飞天大数据平台主力产品的最新技术动态。
开源生态的新发展:Apache Spark 3.0、Koala和Delta Lake
Hadoop开源生态Spark已经发展三年有余,今年迎来了Spark 3.0。在2019杭州云栖大会大数据&AI峰会上,Databricks研发总监李潇为大家分享了Spark 3.0版本的新特性,以及其在数据工程以及数据科学方面带来的新技术。
DataV FAQ
Q:数据库连接不成功 A:需要您开通数据库的公网IP,目前并不支持白名单。或者您可以通过我们提供的[代理工具]来连接到DataV
hive在E-MapReduce集群的实践(二)集群hive参数优化
本文介绍一些常见的集群跑hive作业参数优化,可以根据业务需要来使用。 提高hdfs性能 修改hdfs-site,注意重启hdfs服务 dfs.client.read.shortcircuit=true //直读 dfs.
开源深度学习库BigDL在阿里云E-MapReduce上的实践
近些年来机器学习中的子领域深度学习成为一个热门的话题。本文要介绍Intel开源的深度学习框架BigDL,它也是在Spark上的一个算法库,提供了全面的深度学习算法支持,包括数值计算(Tensor)和高阶神经网络等。
技术论文:电子商务中基于生命阶段的推荐(发表于 ACM KDD2015 )
ACM SIGKDD 国际会议(简称 KDD)是数据挖掘研究领域的顶级盛会,它每年能收到上千篇来自国际知名大学和研究机构的学术论文投稿,这其中仅有一小部分优秀论文可以被接收。2015年5月18日,KDD组委会发布工业和政府相关方向论文的录用消息,阿里巴巴集团搜索事业部推荐团队投稿的论文被录用,表
PAI实现的深度学习网络可视化编辑功能-FastNeuralNetwork
在深度学习领域流传着这样一句话,“一张好的表示图,胜过一千个公式” 本文会介绍如何通过PAI-DSW中的FastNerualNetwork功能实现深度学习网络的可视化编辑。 神经网络最早诞生于生物领域,用来模仿生物大脑复杂的神经元构成,后来人类为了探索大脑是如何思考,通过一层一层的数学公式来模拟大脑分析事物的过程。
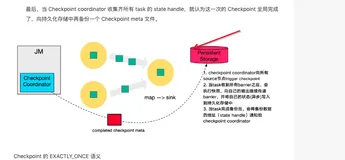
Apache Flink : Checkpoint 原理剖析与应用实践
本文将分享 Flink 中 Checkpoint 的应用实践,包括四个部分,分别是 Checkpoint 与 state 的关系、什么是 state、如何在 Flink 中使用 state 和 Checkpoint 的执行机制
大数据分析平台产品对比之MaxCompute 篇
之前尝试使用过一些国内外的云产品,特别是大数据分析型产品,例如:亚马逊的EMR、Redshift,Google的Bigquery以及阿里云的MaxCompute。相信大多数人对亚马逊的EMR、Redshift,Google的Bigquery都比较了解。
【8.23更新--技术干货全家桶】大数据计算技术共享计划 — MaxCompute技术公开课第二季
5月底MaxCompute开启大数据计算技术共享计划,第一季,为大数据爱好者和企业客户带来了MaxCompute数据开发实战的四次主题分享,有1500多名用户线上参加了共享季直播。7月24日,MaxCompute开启第二季技术公开课,近6000名大数据爱好者和企业客户参加了第二季的5次主题直播,越来越多的大数据专家、技术牛人、爱好者参与到我们的技术共享活动中来,让我们一起玩大数据如烹小鲜吧。
MaxCompute(原ODPS)开发入门指南——数据开发工具篇
大家在使用大数据计算服务MaxCompute时,最头疼就是我现在已有的数据如何快速上云?我的日志数据如何采集到MaxCompute上?等等。。。具体详见《MaxCompute(原ODPS)开发入门指南——数据上云篇》。
基础平面地图——地图数据(散点、呼吸气泡、飞线等)不显示问题
地图数据(散点、呼吸气泡、飞线等)不显示问题:经纬度放反、API返回结果或者SQL查询结果与组件所需数据格式不匹配、数据过滤器、跨域问题。
唱吧基于 MaxCompute 的大数据之路
在使用 MaxCompute之前,唱吧使用自建体系来存储处理各端收集来的日志数据,包括请求访问记录、埋点数据、服务器业务数据等。但随着每天处理数据量的增长,积累的历史数据越来越多,来自其他部门同事的需求越来越复杂,自建体系逐渐暴露出了能力上的短板。
MaxCompute(原ODPS)开发入门指南——计量计费篇
近期介绍大量数据上云用户关于MaxCompute的一些问题,现就MaxCompute产品线的一些工具栈可以和大家进行交流,也欢迎大家拍砖和来扰,一起学习一起进步!也希望能够在帮助到大家!
【云上ELK系列】Logstash迁移Elasticsearch数据方法解读
用Logstash实现Elasticsearch集群快速迁移,解读Logstash中metadata的功效,避免踩坑
DT时代已经悄然来临,IT人您跟上了吗?
什么是DT时代? 在2015年中国(深圳)IT领袖峰会上,马云发表演讲:过去7年我们从互联网创业到互联网产业,很快进入互联网经济,而且正在从IT走向DT时代,也许昨天称为IT领袖峰会,未来要称DT领袖峰会,DT不仅仅是技术提升,而是思想观念的提升。
基于MaxCompute的媒体大数据开放平台建设
摘要:随着自媒体的发展,传统媒体面临着巨大的压力和挑战,新华智云运用大数据和人工智能技术,致力于为媒体行业赋能。通过媒体大数据开放平台,将媒体行业全网数据汇总起来,借助平台数据处理能力和算法能力,将有价值数据内容和能力开放给用户。
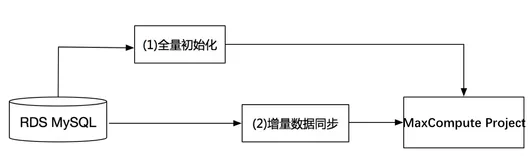
释放存储与计算压力,MySQL用户升级到EB级数据仓库MaxCompute攻略
在过去三年里产生的数据量比以往四万年的数据量还要大。大数据可以来自方方面面,从日常生活购物到社交网络,从地理位置定位到在线视频都会有大量的数据。云计算的蓬勃发展,进一步催生了大数据的价值。廉价的存储和计算,高效的海量数据处理,我们已经进入了“大数据时代”。
Apache Flink 漫谈系列(06) - 流表对偶(duality)性
实际问题 很多大数据计算产品,都对用户提供了SQL API,比如Hive, Spark, Flink等,那么SQL作为传统关系数据库的查询语言,是应用在批查询场景的。Hive和Spark本质上都是Batch的计算模式(在《Apache Flink 漫谈系列 - 概述》我们介绍过Spark是Micr.
走近华佗,解析自动化故障处理系统背后的秘密
集群医生华佗是集群自动化故障监测和处理系统,是平台和运维对接的关键系统,它承担了飞天平台自动化故障处理系统的任务。如何能又快又好地发现和解决线上故障呢?本文为您解析自动化故障处理系统背后的秘密。一起来了解华佗是如何提升集群的故障发现、处理的效率和准确性,解放运维人员,提高飞天稳定性和可靠性的 。
【大数据技巧】Flume采集网站日志到MaxCompute常见问题汇总
本文列举了Flume采集网站日志到MaxCompute的一些常见问题,欢迎大家补充;
盘点全球最热门十家大数据公司中国占据三席
近两年来,大数据发展浪潮席卷全球。研究机构IDC预测,全球大数据与分析市场规模将由2015年的1220亿美元,在5年间成长超过50%,并在2019年底达到1870亿美元的规模。
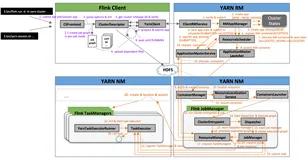
Flink on YARN(上):一张图轻松掌握基础架构与启动流程
本文基于FLIP-6重构后的资源调度模型介绍Flink on YARN应用启动全流程,解答客户端和Flink Cluster的常见问题,分享相关问题的排查思路。
一文快速了解MaxCompute
一文快速了解MaxCompute 很多刚初次接触MaxCompute的用户,面对繁多的产品文档内容以及社区文章,往往很难快速、全面了解MaxCompute产品全貌。同时,很多拥有大数据开发经验的开发者,也希望能够结合自身的背景知识,将MaxCompute产品能力与开源项目、商业软件之间建立某种关联和映射,以快速寻找或判断MaxCompute是否满足自身的需要,并结合相关经验更轻松地学习和使用产品。
Apache Flink 零基础入门(三):DataStream API 编程
本次课程将首先介绍 Flink 开发中比较核心的 DataStream API 。我们首先将回顾分布式流处理的一些基本概念,这些概念对于理解实际的 DataStream API 有非常大的作用。然后,我们将详细介绍 DataStream API 的设计,最后我们将通过一个例子来演示 DataStre
【阿里内部应用】利用blink+MQ实现流计算中的超时统计问题
案例与解决方案汇总页:阿里云实时计算产品案例&解决方案汇总 一. 背景介绍 菜鸟的物流数据本身就有链路复杂、实操节点多、汇总维度多、考核逻辑复杂的特点,对于实时数据的计算存在很大挑战。经过仓配ETL团队的努力,目前仓配实时数据已覆盖了绝大多数场景,但是有这样一类特殊指标:“晚点超时指标”(例如:出库超6小时未揽收的订单量),仍存在实时汇总计算困难。
MaxCompute携手ofo小黄车与阿里妈妈—邀你共赴大数据计算北京高端峰会(含技术干货整理)
ofo小黄车如何通过MaxCompute轻松处理每天千万订单,提升线下运营效率50%以上,提升整体运行效率76%? 阿里妈妈在搜索广告、定向广告、达摩盘、报表和BI分析等常见场景下是如何使用MaxCompute的? Noxmobi自建业界领先的DSP、SSP、ADX等广告系统,其中最重要的底层数.
大数据与机器学习
大数据领域前沿技术分享与交流,这里不止有技术干货、学习心得、企业实践、社区活动,还有未来。