

GEO 投入的去留判断:用可核对的过程信号设定调整与退出条件
本文探讨GEO(生成式引擎优化)投入的决策方法:强调“先定条件再投入”,通过记录三类可核对的过程信号(信息收录准确性、GEO渠道咨询来源、核心问题覆盖度),在预设时间窗口内对照调整或退出条件,助力企业理性决策,避免依赖模糊感受。
为什么是 Flink:八个特性,三个问题,六类场景
本文深入剖析Flink核心选型逻辑:摒弃空洞特性对比,直击实时计算三大本质问题——数据晚到能否算对(时间)、海量状态存哪(状态)、宕机重启是否重算(一致性)。以“延迟×状态×正确性”三维坐标精准定位适用场景,揭示Flink价值在于将“算得对”内化为架构能力,而非依赖运维补救。
2026年GEO(生成引擎优化)技术指南:从原理到实战
2026年,AI搜索成企业信息入口,传统SEO失效。GEO(生成引擎优化)聚焦让AI模型“引用”而非仅“排名”你的内容。本文详解GEO三大支柱:结构化标记(Schema)、语义意图优化、AI可信度工程,并结合实战案例与多模态、实时数据等前沿趋势,助技术决策者抢占AI时代信息分发主动权。(239字)
小团队做AI问答内容整理:先拆清谁出题、谁把关、谁记录
本文为无专职营销人员的财税小团队提供AI时代内容协作方案:将“AI回答整理”拆解为“出题(客户问题)、把关(专业审核)、记录(AI提及观察)”三类动作,明确主责人+专业把关+负责人定期过问的最小分工机制,强调过程可控、责任到人、不承诺效果,务实起步。
Flink 快速入门之 Flink DataStream Batch 模式
本文深度解析Flink 2.x中被移除DataSet API后,DataStream的BATCH执行模式:它不是“慢速流”,而是在调度、数据交换、状态管理三方面彻底重构的批处理范式;详解模式切换带来的行为差异、失效特性(如checkpoint依赖功能)及避坑要点,助你真正用好流批一体。
科技巨头=去中心化的全球天道·安全悖论·游戏智能体黑洞效应
BSD《全球天道形成论》(Step279)提出:旧天道随国家体系收缩,新天道正由谷歌、马斯克系等去中心化科技巨头悄然聚成;其“黑洞效应”吸纳主权权能,使美国优势即危害、隔离即安全悖论——经济基础迁移,天道载体已非领土,而在代码与卫星之间。(239字)
企业大模型本地化部署与数据安全实践:从 RAG 权限过滤到审计闭环
本文聚焦企业大模型本地化部署中的数据安全痛点,以RAG问答系统为例,详解权限过滤前置、元数据治理、审计闭环等关键实践,提供可落地的分层架构与FastAPI代码骨架,强调“模型看不见无权数据”才是安全底线。
Lake Search:ES x Paimon 让湖上多模态数据可搜可用
当图片、视频、文本和向量在 Paimon 中增长到 PB 级,传统“同步到湖外再建索引”的方式,会让搜索面临数据就绪慢、第二份事实数据成本高和版本治理复杂等问题。本文介绍阿里云 Elasticsearch 9.4 Search Lake 如何直接挂载与 Paimon 表版本关联的 Global Index,在不复制事实数据的前提下提供 BM25、kNN、结构化过滤、排序与聚合能力,并结合多模态样本湖场景拆解方案架构、Demo 及性能与成本取舍。 关键词:Search Lake、Apache Paimon、Elasticsearch 9.4、Global Index、OpenLake、多模态检索
本地自动化新思路:不用脚本也能让电脑软件自己动起来?1949ai带你探究
本文分享了一线开发者在落地办公自动化时的真实困境与思考:面对CRM、Excel、邮件客户端等多系统混用场景,单纯写代码(如Selenium+PyAutoGUI)易受界面变化、弹窗、环境差异困扰;而可视化流程工具凭借“条件触发+跨应用感知”更稳定易维护。作者主张“代码管数据、工具管交互”的混搭策略,并附实用文件监听代码示例。核心观点:自动化不是炫技,而是把人从机械劳动中解放出来。(239字)
什么是 Code 39?
Code 39是1974年由Intermec开发的字母数字条形码,支持43个字符,广泛用于汽车、医疗、国防等领域。分Regular和Full ASCII两种,后者可编码全部128个ASCII字符。结构简单,自校验强,但密度较低。可通过HCreateLabelView轻松生成,适用于非零售场景。
大数据环境下该如何优雅地设计数据分层
发个牢骚,搞大数据的也得建设数据仓库吧。而且不管是传统行业还是现在的互联网公司,都需要对数据仓库有一定的重视,而不是谈一句自己是搞大数据的就很厉害了。数据仓库更多代表的是一种对数据的管理和使用的方式,它是一整套包括了etl、调度、建模在内的完整的理论体系。
DeepSeek Harness 插件开发有哪些坑?worktree 插件四轮迭代的 21 条实战记录
本文以一个用 git worktree 管理仓库的 DSH 插件为例,记录 21 条经实际验证的坑:冷启动时拿不到服务,导致 405;热重载无法回收上一代路由;工具返回值中的 undefined 被判为非法 JSON;单槽位只能替换,不能插入;持久缓存会固化错误;以及 git worktree 在符号链接、realpath 和保留分支上的语义差异。
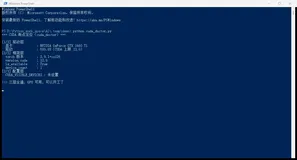
手把手教你:torch.cuda.is_available() 一直是 False?一条命令定位断点|AI工程师踩坑实录·第2篇
GPU用不上别急着重装驱动。本文给出三层断点定位法,按概率排序排查:最常见是框架层装了+cpu轮子,最隐蔽是CUDA_VISIBLE_DEVICES被设成-1(零报错让GPU凭空消失),驱动层放最后。一条cuda_doctor命令即可定断点在哪层。
视频字幕生成攻略:从录音到双语 SRT 的六个步骤
本文介绍自动化生成双语SRT字幕的六步脚本化流程:抽音频→VAD降噪→分片转写(获句级时间戳)→智能切块→机翻+抽查→生成双语SRT。全程可复用,大幅降低课程、分享、外刊等场景的字幕制作成本,让配字幕成为默认动作。(239字)
一篇文章搞懂 Hive:从数仓定位到架构、表设计与数据倾斜治理
Hive是基于Hadoop的SQL数据仓库工具,不存数据、不算数据,仅作“胶水层”:元数据存MySQL,数据落HDFS,计算交YARN。支持内外表、分区/分桶、ORC/Parquet列存及丰富优化策略,专为海量离线分析而生,是企业级数仓十五年事实标准。(239字)
网站代码 网站源代码 网页源代码 网页代码网站
本文深入解析网站源代码与网页源代码的核心概念及区别,阐述其作为互联网技术基石的关键作用。通过剖析PageAdmin等典型源码案例,揭示源代码在技术学习、网站优化、安全维护等方面的核心价值,并探讨如何高效利用代码网站资源进行创新开发。文章强调在尊重版权的前提下,开发者可借助源码资源提升能力,推动网页技术持续发展。
竞品广告监测实务:独立站、广告库与落点三处对齐法
竞品在独立站和社媒上投了什么广告?先看三处公开动态:独立站改了什么、广告库里投了多久换了几版、广告点进去落到哪;只抄节奏与落点,不抄整套广告。
应用依赖关系映射怎么做?从「哪里慢」到「为什么慢、影响谁」
云原生下服务关系瞬息万变,依赖映射从可选变为必选。本文解析其三大新要求(对接编排层、分层建模、融合网格/trace)、六项落地标准及四大验收点,强调自动化发现与实时拓扑对故障定位、影响评估的关键价值。
基于springboot的健身爱好者打卡与互动交流系统
本系统采用Java+Spring Boot构建后端,MySQL存储数据,Vue开发前端,实现健身打卡与互动交流功能。技术组合兼顾稳定性、性能与用户体验,支持高并发、易维护和灵活扩展。
数据治理-重点、方法、目标(1)
20年数据老兵坦言:数据开发、数仓、大数据驾轻就熟,唯数据治理屡感挫败。重读DAMA2后反思:治理核心非文档工具,而是“决策权与问责机制”;落地关键不在顶层设计,而在找准业务痛点——数据质量才是最强驱动力。
PyCharm启动项目和调试项目
本文介绍了在 PyCharm 中启动和调试 Python 项目的详细步骤,涵盖单文件运行、配置管理、命令行工具使用、断点调试、变量监控、远程调试及常见问题解决方案,帮助开发者高效利用 PyCharm 的调试功能提升开发效率。
考古|search_type=count 和 scan 在 ES 5.0 被删,藏得最深的是定时任务
count 从 2.0 起废弃、scan 从 2.1 起废弃,到 5.0 两个 search type 被移除。
企业 AI 开发团队核验实务:分清三类、核验三处与验收办法
马鞍山做企业 AI 开发的公司有哪些?本文直接回答:先分清三类再挑——外贸定制团队、工业大数据系、云厂商与通用软件,场景不同,找法也不同;再讲挑之前要核验的三处:做过你这一行没有、交付物写没写进合同、改动与数据归属清不清楚。
Flink 快速入门之 Flink 代码编写注意点
本文详解Flink 2.3中十类高频生产隐患,按**提交期、运行期、运维期**三阶段归因:从序列化边界、类型识别、泛型推断,到状态TTL、Timer约定、迟到处理、Async I/O陷阱、uid强约束、Checkpoint落盘等,每条均配避坑写法与原理剖析,助你告别“一周一炸”,打造稳定三年的流作业。
Flink SQL 之 Table 分组与聚合原理及代码实现:从状态管理到两阶段聚合与数据倾斜处理
本文深入解析Flink SQL中核心的分组聚合(groupBy + 聚合函数),涵盖本质定义、四步执行原理、六大类内置函数、状态管理与回撤机制、两阶段聚合、微批预聚合、分组集、自定义聚合函数及完整代码实现,并总结6大常见坑与8条最佳实践,助你写出高性能、高稳定的流式聚合作业。(239字)
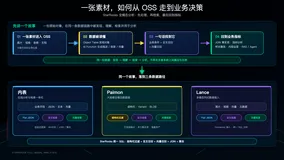
StarRocks 全模态能力导读:连接内容理解、混合检索与业务分析
StarRocks 全模态能力旨在打通内容理解、混合检索与业务分析的断点,支持结构化、半结构化和非结构化数据在同一条 SQL 链路中完成特征化、多条件检索(含结构化过滤、全文匹配与向量相似度)及后续 Join、聚合与指标计算,通过多模态处理、内表、Paimon 和 Lance 四类技术路径适配不同数据位置、规模与查询需求,消除多系统间的数据复制与结果搬运。
阿里云 EMR Serverless StarRocks Skills 正式发布
阿里云EMR Serverless StarRocks Skills正式发布,面向Agent提供SQL开发、慢查询诊断、建表设计、数据导入、实例运维与弹性扩缩容六大能力,通过starrocks-assistant和starrocks-manage两大Skill封装StarRocks最佳实践与实时集群状态,实现从“生成建议”到“自动执行”的跃迁,已兼容Qoder、Claude Code、DataWorks Data Agent等主流AI客户端,标志着EMR从业界领先大数据基座全面迈入Agentic时代。
Daft 多模态视频抽帧性能优化实践:从抽帧到大模型打标,一条视频理解流水线是怎么跑起来的
本文详细介绍了基于 Daft 构建的多模态视频理解流水线,涵盖从远程视频按需抽帧、智能采样、黑边裁剪与 OSS 落盘,到大模型批量打标生成结构化标签的全链路实践;重点阐述了三项核心性能优化——读取时的关键帧定位下推、采样过程中的无用帧跳过、以及多线程并行解码,并通过实测验证其叠加效果,最终实现 TB 级视频数据高效转化为可检索分析的结构化语义信息。
七、深入 Hive DDL:管理表、分区与洞察元数据
在日常使用 Hive 的过程中,我们不仅要会建表,更要学会灵活地维护和管理已有的数据结构。从添加字段到修改分区,从查看元数据到删除表或清空数据,掌握这些 DDL 操作和常用的 SHOW 命令,就像掌握了一套管理数据仓库的“万能钥匙”。这次将带你一步步熟悉这些命令的用法和实际应用场景,配合清晰的语法示例与练习题,帮助你更轻松地驾驭 Hive 数据管理的日常工作。

DINOv3上手指南:改变视觉模型使用方式,一个模型搞定分割、检测、深度估计
DINOv3是Meta推出的自监督视觉模型,支持冻结主干、仅训练轻量任务头即可在分割、深度估计等任务上达到SOTA,极大降低训练成本。其密集特征质量优异,适用于遥感、工业检测等多领域,真正实现“一个模型走天下”。
转介绍客户变杂时,代账公司如何用盘点与过程记录判断是否筛客户
本文提供代账公司应对“客户杂”问题的实操方法:通过盘点客户来源、服务消耗、付费水平等维度,将模糊感受转化为可观察条件;将筛选标准写成咨询、报价、回看三环节中团队可执行的动作;强调用过程记录替代凭感觉决策,助力聚焦匹配客户,提升服务效能。
结算函数灰度上线:FC版本别名与双跑比对
账期结算函数发布需严控风险:某园区因覆盖式更新致2400张账单出错。推荐“版本+别名+灰度”方案——冻结旧版、新版挂灰度别名、样本双跑比对、流量切换仅改别名,回退秒级完成。(239字)
询盘跟进分档实务:等决定、只问价、没回音三档跟进法
外贸客户聊过后没回复怎么跟进?先看对方停在哪一步,分等决定、只问价、没回音三档再排跟进;每档给一个具体的跟进动作与间隔,AI 只出跟进草稿、人工确认后才发。
Flink on Kubernetes 部署架构:一个 Deployment 与一群 Pod
本文深入解析Flink 2.3在Kubernetes上的部署架构,聚焦“对象所有权”这一核心逻辑:JobManager为Deployment,TaskManager由其动态创建的裸Pod组成,HA ConfigMap则刻意不设ownerReference以持久化元数据。厘清Standalone、Native与Operator三种模式的责任边界,并详解资源生命周期、扩缩容机制、配置注入及高频排障要点。
3组实测数据拆解DeepSeek引用机制:从平台推荐到证据链构建
本文基于2026年初实测与普林斯顿AI搜索研究,揭示DeepSeek引用机制:内容需先被知乎、CSDN等平台推荐,再进入其语料库。实证表明,含引用来源、统计数据、直接引语的内容被引用率分别提升34.4%、32.1%、29.7%。文章提供平台适配、证据块拆解、深水区监测等可复现路径。
你发了那么多文章,DeepSeek可能连看你一眼都没有
本文深度拆解DeepSeek联网搜索的答案生成机制:它不自建搜索引擎,而是调用Bing API;答案生成含7步——判断联网、需求拆解、语义扩词、Bing检索、精读筛选(重标题具体度/域名信任度/时效性)、交叉验证(仅逻辑可信,非事实核查)、整合输出。揭示GEO优化必须先确保内容被Bing收录,结构化、多源一致、Schema标记等动作才有效。知其所以然,方能精准优化。

拒绝“大模型幻觉”:一文彻底搞懂 RAG(检索增强生成)技术全流程
本文深入解析RAG(检索增强生成)技术,直击大模型落地私有知识场景的核心痛点——如何让LLM精准、低成本、高时效地基于企业文档作答。从文本分片、向量化索引,到召回重排、增强生成,系统拆解五大关键步骤,揭示RAG作为“AI外挂”的底层逻辑与工程实践精髓。
GEO怎么做?从0开始的五步法
GEO怎么做?从0开始的五步法:先搞懂GEO是什么(让AI在回答时提到你),再选对平台(公众号、问一问、知乎、搜狐号、小红书),然后写AI友好的内容(开头给结论、小标题分段、结尾加FAQ),发出去等收录,最后测效果优化。0成本起步,边学边做。我是二二得四,正在从头学GEO。
电脑必备软件:PortableApps便携式软件管理工具安装使用教程:U盘装软件随身带
PortableApps是一款免费开源的便携式软件管理平台,支持将软件安装至U盘,即插即用,拔出不留痕迹。内置近500款实用软件,无需安装,跨平台使用便捷,支持个性化主题设置,让软件随身携带,工作学习更高效。
【跨国数仓迁移最佳实践6】MaxCompute SQL语法及函数功能增强,10万条SQL转写顺利迁移
本系列文章将围绕东南亚头部科技集团的真实迁移历程展开,逐步拆解 BigQuery 迁移至 MaxCompute 过程中的关键挑战与技术创新。本篇为第六篇,MaxCompute SQL语法及函数功能增强。 注:客户背景为东南亚头部科技集团,文中用 GoTerra 表示。
YOLOv11浅浅解析:架构创新
YOLOv11是YOLO系列最新升级版,通过C3k2模块、SPPF优化和解耦检测头等创新,显著提升检测精度与速度,mAP提高2-5%,推理更快,支持多平台部署,适用于工业、安防、自动驾驶等场景。
ajax请求总是不成功?浏览器的同源策略和跨域问题详解
XMLHttpRequest cannot load http://oldwang.com/isdad. No 'Access-Control-Allow-Origin' header is present on the requested resource. Origin 'http://xiao
DeepSeek Harness 接入记忆 MCP:为什么「它记住了」可能只是模型在复述?
给 DSH 接入记忆 MCP 时,最容易出现的误判是「它记住了」:同一会话里问它,对答如流;换一个会话,却一片空白。本文记录我在接入和验证时遇到的六个坑:三个示例默认全关、工具发现是异步的、同会话验证是假阳性、存储范围会悄悄漂移、关掉连接不等于删掉数据,以及 stdio 桥会剥掉像凭据的环境变量。
大数据与机器学习
大数据领域前沿技术分享与交流,这里不止有技术干货、学习心得、企业实践、社区活动,还有未来。