

【Hive SQL】字符串操作函数你真的会用吗?
本文介绍了SQL中判断字符串是否包含子串的几种方法。`IN`函数判断元素是否完全等于给定元素组中的某项,而非包含关系。`INSTR`和`LOCATE`函数返回子串在字符串中首次出现的位置,用于检测是否存在子串。`SUBSTR`则用于提取字符串的子串。`LIKE`用于模糊匹配,常与通配符配合使用。注意`IN`并非用于判断子串包含。
Spark 为什么比 Hive 快
Spark与Hive在数据处理上有显著区别。Spark以其内存计算和线程级并行提供更快的速度,但稳定性受内存限制。相比之下,Hive虽较慢,因使用MapReduce,其稳定性更高,对内存需求较小。在Shuffle方式上,Spark的内存 Shuffle 比Hive的磁盘 Shuffle 更高效。综上,Spark在处理速度和Shuffle上占优,Hive则在稳定性和资源管理上更胜一筹。

Hive实战 —— 电商数据分析(全流程详解 真实数据)
关于基于小型数据的Hive数仓构建实战,目的是通过分析某零售企业的门店数据来进行业务洞察。内容涵盖了数据清洗、数据分析和Hive表的创建。项目需求包括客户画像、消费统计、资源利用率、特征人群定位和数据可视化。数据源包括Customer、Transaction、Store和Review四张表,涉及多个维度的聚合和分析,如按性别、国家统计客户、按时间段计算总收入等。项目执行需先下载数据和配置Zeppelin环境,然后通过Hive进行数据清洗、建表和分析。在建表过程中,涉及ODS、DWD、DWT、DWS和DM五层,每层都有其特定的任务和粒度。最后,通过Hive SQL进行各种业务指标的计算和分析。
OneFlow深度学习框架介绍:新手快速上手指南
【4月更文挑战第12天】OneFlow是一款高性能的深度学习框架,由一流科技公司研发,以其数据流编程模型、动态图执行和高效分布式训练等功能脱颖而出。其易用性、卓越性能和强大的分布式训练能力使其在AI领域备受关注。新手可以通过简单的安装和基础程序快速上手,利用OneFlow的Module构建模型,结合损失函数和优化器进行训练。此外,OneFlow支持ONNX模型导入导出、TensorBoard可视化及与其他Python库集成,助力无缝对接现有生态。深入了解和实践OneFlow,可提升深度学习开发效率。
大数据隐私保护策略:加密、脱敏与访问控制实践
【4月更文挑战第9天】本文探讨了大数据隐私保护的三大策略:数据加密、数据脱敏和访问控制。数据加密通过加密技术保护静态和传输中的数据,密钥管理确保密钥安全;数据脱敏通过替换、遮蔽和泛化方法降低敏感信息的敏感度;访问控制则通过用户身份验证和权限设置限制数据访问。示例代码展示了数据库、文件系统和API访问控制的实施方式,强调了在实际应用中需结合业务场景和平台特性定制部署。
Python读取.nc文件的方法与技术详解
本文介绍了Python中读取.nc(NetCDF)文件的两种方法:使用netCDF4和xarray库。netCDF4库通过`Dataset`函数打开文件,`variables`属性获取变量,再通过字典键读取数据。xarray库利用`open_dataset`打开文件,直接通过变量名访问数据。文中还涉及性能优化,如分块读取、使用Dask进行并行计算以及仅加载所需变量。注意文件路径、变量命名和数据类型,读取后记得关闭文件(netCDF4需显式关闭)。随着科学数据的增长,掌握高效处理.nc文件的技能至关重要。
pyspark--完美解决 Could not find a version that satisfies the requirement 安装包名字 (from versions: )
pyspark--完美解决 Could not find a version that satisfies the requirement 安装包名字 (from versions: )
Hive中日期处理函数的使用(date_format、date_add、date_sub、next_day)
Hive中日期处理函数的使用(date_format、date_add、date_sub、next_day)
AI加速引擎PAI-TorchAcc:整体介绍与性能概述
PAI-TorchAcc(Torch Accelerator)是阿里云人工智能平台PAI开发的Pytorch上的大模型训练加速框架。PAI-TorchAcc提供了一套基于Pytorch的简洁、易用的接口,无需进行模型转换就可以无缝地接入HuggingFace上的模型,并用多种分布式策略进行训练加速。本文详细介绍PAI-TorchAcc的产品能力与性能。
Flink报错问题之使用debezium-json format报错如何解决
Apache Flink是由Apache软件基金会开发的开源流处理框架,其核心是用Java和Scala编写的分布式流数据流引擎。本合集提供有关Apache Flink相关技术、使用技巧和最佳实践的资源。
Flink cdc报错问题之使用jdbc connector报错如何解决
Flink CDC报错指的是使用Apache Flink的Change Data Capture(CDC)组件时遇到的错误和异常;本合集将汇总Flink CDC常见的报错情况,并提供相应的诊断和解决方法,帮助用户快速恢复数据处理任务的正常运行。

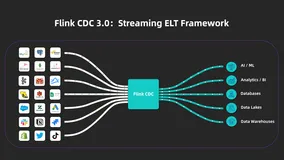
Flink CDC 3.0 正式发布,详细解读新一代实时数据集成框架
Flink CDC 于 2023 年 12 月 7 日重磅推出了其全新的 3.0 版本 ~
推荐场景GPU优化的探索与实践:CUDA Graph与多流并行的比较与分析
RTP 系统(即 Rank Service),是一个面向搜索和推荐的 ranking 需求,支持多种模型的在线 inference 服务,是阿里智能引擎团队沉淀多年的技术产品。今年,团队在推荐场景的GPU性能优化上又做了新尝试——在RTP上集成了Multi Stream,改变了TensorFlow的单流机制,让多流的执行并行,作为增加GPU并行度的另一种选择。本文详细介绍与比较了CUDA Graph与多流并行这两个方案,以及团队的实践成果与心得。

从0到1自建内部使用的API授权平台竟然那么容易?!
最近看了一些API的管理平台如API Layer、boomi、Odoo等平台,思考如果自己动手搭建一个API授权平台是否困难,结果透过网上的资源就能搭建起一个简易且可扩展API授权平台,且大部份依赖的功能都可免费体验,此文分享这次搭建的代码跟使用到的工具,希望想要在公司内部建立自用的API授权平台能很快地实现。
【论文解读】SMOKE 单目相机 3D目标检测(CVPR2020)
SMOKE是一种用于自动驾驶的实时单目 3D 物体检测器。为什么会注意这边文章呢?是因为这两天发布的百度Apollo 7.0 的摄像头障碍物感知,也是基于这个模型改进的;于是令我产生了一些兴趣。
Cityscapes数据集(智能驾驶场景的语义分割)
面向智能驾驶(辅助驾驶、自动驾驶)场景下的语义分割任务,由于非结构化场景的复杂性,是一个非常具有挑战性的任务,所以有许多研究者和研究机构公开了很多相关的数据集推动语义分割领域的发展。本文主要介绍Cityscapes数据集。
CamVid数据集(智能驾驶场景的语义分割)
CamVid 数据集是由剑桥大学公开发布的城市道路场景的数据集。CamVid全称:The Cambridge-driving Labeled Video Database,它是第一个具有目标类别语义标签的视频集合。 数据集包 括 700 多张精准标注的图片用于强监督学习,可分为训练集、验证集、测试集。同时, 在 CamVid 数据集中通常使用 11 种常用的类别来进行分割精度的评估,分别为:道路 (Road)、交通标志(Symbol)、汽车(Car)、天空(Sky)、行人道(Sidewalk)、电线杆 (Pole)、围墙(Fence)、行人(Pedestrian)、建筑物(Building)
机器人操作系统ROS 编程开发--详细总结
最近工作涉及到自动驾驶的,需要学习ROS,学习中总结了一些知识点,分享给大家。 机器人操作系统ROS,是一种分布式处理框架(又名Nodes),ROS常用C++和python编程语言开发;(这里项目开发采用C++ 11版本)。ROS的点对点设计以及服务和节点管理器等机制,可以分散由计算机视觉和语音识别等功能带来的实时计算压力,能够适应多机器人遇到的挑战。ROS免费并且开源。
潮玩宇宙APP游戏系统开发技术
从Web2游戏到完全的Web3游戏(全链游戏),中间需要跨越多个环节,包括资产上链、交易上链、成就上链、经济模型上链、核心逻辑上链等,现在许多区块链游戏完成了除核心逻辑之外的上链,被称为Web2.5 Game。
大模型时代的人工智能+大数据平台,加速创新涌现
2023年10月31日,2023云栖大会上,阿里云副总裁、阿里云计算平台事业部负责人汪军华宣布阿里云人工智能+大数据平台升级发布,以服务大模型时代下各行各业的业务创新。
CV领域再创佳绩!阿里云机器学习平台 PAI 多篇论文入选 ICCV 2023
近期,阿里云机器学习平台PAI发表的多篇论文在ICCV 2023上入选。ICCV是国际计算机视觉大会是由电气和电子工程师协会每两年举办一次的研究大会。与CVPR和ECCV一起,它被认为是计算机视觉领域的顶级会议之一。ICCV 2023将于10月2日至10月6日法国巴黎举办。ICCV汇聚了来自世界各地的学者、工程师和研究人员,分享最新的计算机视觉研究成果和技术进展。会议涵盖了计算机视觉领域的各个方向,包括图像处理、模式识别、机器学习、人工智能等等。ICCV的论文发表和演讲都备受关注,是计算机视觉领域交流和合作的重要平台。
阿里云 Elasticsearch 使用 RRF 混排优化语义查询结果对比
Elasticsearch 从8.8版本开始,新增 RRF,支持对多种不同方式召回的多个结果集进行综合再排序,返回最终的排序结果。之前 Elasticsearch 已经分别支持基于 BM25 的相关性排序和向量相似度的召回排序,通过 RRF 可以对这两者的结果进行综合排序,可以提升排序的准确性。

深度解读阿里云 Elasticsearch Serverless 服务如何实现超高性价比
阿里云 Elasticsearch Serverless 商业化版本正式上线,在帮助用户快速构建数据检索与分析应用的同时,提供按实际资源用量付费的付费体验,与自建相比大幅降低成本,助力用户快速上云!
网络安全威胁的识别和防范策略
网络安全威胁的识别和防范是当今数字化时代不可忽视的问题。恶意软件、网络钓鱼等威胁不断演变,需要持续关注和采取措施来保护个人隐私和企业数据。通过有效的识别方法和防范策略,我们可以更好地应对不断变化的网络安全挑战。
Hologres弹性计算在OLAP分析上的实践和探索
本文介绍了OLAP分析在大数据分析中的位置,分析并介绍目前大数据OLAP遇到的分析性能、资源隔离、高可用、弹性扩缩容等核心问题,解析阿里云Hologres是如何解决极致性能、弹性、业务永续、性价比等核心刚需的最佳实践,介绍阿里云Hologres弹性计算组在弹性计算、资源隔离上的探索和创新。

基于 Kibana Dashboard 创建仪表板,可视化匹配航班信息
在今天的练习中,我们将使用 Kibana 自带的数据来进行一些可视化的展示。希望对刚开始使用 Kibana 的用户有所帮助

OpenSearch大模型实践之Havenask篇
ChatGPT在通用任务上表现优秀,但无法解决众多垂直业务领域问题,这也不是ChatGPT模型本身的定位,而是需要通过其生态应用去解决。如何在垂直领域针对特定业务构建企业专属问答并且确保生成内容可控,是垂直领域面临的主要问题,也是从事行业搜索和问答的应用努力的方向。OpenSearch作为行业智能搜索产品,其使命就是去解决这一问题,我们正在做积极的探索。同时Havenask作为云产品OpenSearch和集团内引擎HA3的开源版本,也进行了尝试和探索。

Hologres技术揭秘,JSON半结构化数据的极致分析性能
本文将会揭秘Hologres JSONB半结构化数据的技术原理,实现JSON半结构数据的极致分析性能。

Apache Flink X Apache Doris 构建极速易用的实时数仓架构
在本次分享中,将为大家介绍如何基于 Apache Doris 和 Apache Flink 构建极速易用的实时数仓架构。

Flink CEP 在抖音电商的业务实践
FlinkCEP 是基于 Flink 实现的实时数据规则引擎,支持跨多个事件的规则匹配。然而,当前 FlinkCEP 在多规则处理、规则表达方面还存在易用性问题。本次分享主要介绍 FlinkCEP 在抖音电商业务的应用实践以及易用性优化。


技术内幕 | 阿里云EMR StarRocks 极速数据湖分析
本文为作者在 StarRocks Summit Asia 2022 上的分享


EMR重磅发布智能运维诊断系统(EMR Doctor)——开源大数据平台运维利器
E-MapReduce 推出面向开源大数据集群的智能运维诊断系统 E-MapReduce Doctor,有效提升大数据集群运维效率,辅助 EMR 用户完善集群监控体系。

阿里灵杰融合智能算力,全栈AI服务为探索者铺路
阿里灵杰大数据AI一体化平台提供全流程的开发和运维服务。尤其在模型训练和推理性能、大数据与AI工程能力方面,凭借技术领先性和丰富落地实践,成为区别传统AI集群的独特优势所在。


Hologres揭秘:实时数仓Hologres如何支持超大规模部署与运维
本文将会从超大规模部署与运维体系建设出发,分析超大规模实时数仓面临的挑战和针对性的设计及解决方案,实现在高负载高吞吐的同时支持高性能,并做到生产级别的高可用。

亿滋中国X阿里云,释放新零售的数字化力量
亿滋中国基于阿里云DataWorks与MaxCompute搭建新零售数据中台系统,通过强大的技术平台和数据分析能力,亿滋中国可以提早预知市场动向,制定市场,销售和供应链战略, 更高效地触及消费者锁定消费人群,优化成本模型提升投资回报率,提高销售预测的准确性,实现供应链的柔性生产。
大数据与机器学习
大数据领域前沿技术分享与交流,这里不止有技术干货、学习心得、企业实践、社区活动,还有未来。