

45条引用源实测:AI搜索引用偏好与信息块机制解析
本文基于2026年豆包AI搜索实测(45条引用源),揭示AI引擎偏好结构化、可验证的信息块(如数据、引语、案例),而非关键词堆砌。CSDN占比34%居首,印证技术细节密度决定引用率。结合Princeton研究(引用源+34.4%等),提出Schema标记、平台适配改写、核心词覆盖率追踪等可复现优化方法。
【免费领取Credit】Quick BI AIPro 全新发布,让数据成为企业增长引擎!
阿里云Quick BI AIPro正式发布!全新AI-native架构,支持对话式深度分析、业务语言理解、自动归因与行动建议。首月赠12.5万Credits,零门槛免费试用,存量客户无缝升级,新用户上传数据即用。
AI Agent 工程实践:从大语言模型到自主任务执行系统的架构演进
AI Agent 是让大模型从“能聊”走向“能干”的关键架构:它融合感知、规划、工具调用、记忆与反馈,构建可执行复杂任务的智能系统。不同于聊天机器人,Agent 能自主拆解目标、调用API、跨步执行并持续优化,正成为企业智能化的新基建。
团队暂时没有条件部署 SkyWalking
本文详解APM链路追踪核心实践:先定位慢在哪一跳。通过SkyWalking开箱即用方案(Java零侵入Agent接入)或自研轻量方案(MDC+AOP日志埋点),快速生成耗时瀑布图,将3.2秒慢请求精准定位至2.35秒SQL,大幅提升性能排查效率。(239字)
洋河股份 x Quick BI:一块屏管理8000+ 经销商
洋河股份借助瓴羊Quick BI打造数字化管理驾驶舱,覆盖100+分办、8000+经销商,实现组织穿透式管理、费用精准评估与五力模型驱动的经销商精细化运营,显著提升费效比与决策效率。
实测 OpenClaw 对接飞书企业自建应用完整图文教程
本教程详解OpenClaw小龙虾AI与飞书机器人零公网对接:无需服务器、不配回调地址,仅需开通长连接事件+导入权限JSON+填入App ID/Secret,图文步骤清晰,新手一次成功。支持本地AI远程操控电脑、处理表格、自动化办公。(239字)
一套底座支撑多场景:高德地图基于 Paimon + StarRocks 轨迹服务实践
面对轨迹数据“高实时、高并发、长周期存储”的典型特征,高德团队以访问跨度为依据完成热/温/冷分层,并以 Apache Paimon + StarRocks 构建统一的数据底座,支撑轨迹数据的近实时写入与高性能查询。
用 SQL 调大模型?Hologres + 百炼,让数据开发直接“对话”AI
阿里云Hologres深度集成百炼大模型平台,推出AI Function能力——无需Python、GPU或额外服务,用熟悉的SQL即可直接调用大模型,实现PDF解析、多模态理解、向量检索等AI功能,让数据开发者零门槛构建智能应用。
从悟空发布看企业级 Agent 平台的下一步:可独立验证的执行证据层
3月17日阿里发布企业级AI原生平台“悟空”,整合账号权限、安全沙箱、Skill生态与钉钉入口,标志Agent从“能对话”迈向“能干活”。本文探讨其关键缺口:平台可控≠结果可验证,呼吁构建可导出、可验证、可第三方复核的“执行证据层”,夯实企业规模化落地的信任基石。(239字)
常用爬虫工具大盘点,附带基础知识点详解
在数据驱动时代,爬虫工具是高效获取公开网络数据的核心利器。从八爪鱼等可视化入门工具,到Requests/Scrapy等Python进阶方案,再到Selenium、Scrapy-Redis等专业级框架,覆盖不同技术门槛与场景需求。使用须恪守robots协议,尊重版权与隐私,合法合规采集。
1688商品详情API数据采集指南
1688商品详情API(1688.item_get)是阿里开放平台核心接口,支持通过商品ID获取标题、价格、库存、SKU、图文详情、商家资质等50+字段,JSON格式返回。广泛用于ERP同步、跨境铺货、比价监控与供应链管理,需签名认证,调用稳定高效。(239字)
淘宝闪购基于阿里云 EMR Serverless Spark&Paimon的湖仓实践:超大规模下的特征生产&多维分析双提效
本文介绍阿里云 Serverless Spark + Paimon 在淘宝闪购大数据湖仓场景的应用。
为什么 loss 看起来很好,模型却更危险了
本文揭示大模型微调中一个关键陷阱:loss持续下降≠模型更安全。相反,当loss“好看”时,模型可能因过度拟合训练数据中的偏差、模板或错误表达而变得更危险——回答更笃定、拒答率下降、边界问题越界更隐蔽。根本原因在于:loss衡量的是“复现训练文本”的能力,而非“行为是否可靠/合规”。工程上应转向以事实正确率、拒答率、自信度、越界率等为核心的行为评估体系,将loss仅作为训练健康度的辅助信号。
深度 AI 学术是怎样学习百度学术、谷歌学术的先进经验的?
深度AI学术融合百度学术与Google Scholar优势,聚合2.8亿文献,支持中英文语义检索、AI自动摘要、引用追踪及趋势分析;创新提供批量翻译、自定义维度解析与学术报告生成,打造智能科研助手。(239字)

有奖实践:EMR Serverless StarRocks × Serverless Spark x DLF 共探 TPC 极致性能
免费试用 EMR Serverless StarRocks 与 EMR Serverless Spark,体验“实时分析冠军”与“批处理之神”的极致性能表现!
10 万文档 RAG 落地实战:从 Demo 到生产,我踩过的所有坑
本文分享10万级文档RAG系统从Demo到生产的实战经验,剖析检索慢、召回率低、部署复杂三大痛点,涵盖文档切分、Embedding选型、向量库优化、重排序与生成约束等关键步骤,并提供可落地的工程方案与评估方法,助力构建高效、稳定的企业级RAG系统。
AI时代最大的宝藏,也藏得最深:80%的企业知识沉睡在非结构化数据中
2026年AI进入应用爆发期,但非结构化数据成为瓶颈。Hologres推出AI原生新架构HSAP 2.0,融合语义搜索、多维分析与Serverless弹性,打造统一数据平面,让企业海量数据高效赋能AI,破解“数据熵”难题,支撑智能客服、销售助手等复杂场景,实现从“为人服务”到“为AI服务”的跨越。
Linux 学习资源精选:从入门到运维的高效清单
本文精选Linux学习资源,按入门、运维、进阶三阶段系统推荐视频、书籍、工具与项目,强调分阶段精准匹配、重实操强总结,助力学习者高效构建知识体系,少走弯路,快速提升实战能力。
Python:ImportError:DLL loadfailed while importing onnxruntime_pybind11_state: 动态链接库(DLL)初始化例程失败 报错解决
在进行文件夹内人脸识别与对比聚类时,遇到onnxruntime库报错,通常因版本不兼容或环境冲突导致。本文整理了五种解决方案:降级onnxruntime至1.14.1、重装库、区分GPU/CPU版本、安装Visual C++运行库、创建Python虚拟环境。通过版本匹配与环境隔离,有效解决DLL初始化失败等问题,提升项目稳定性。
ODPS 十五周年实录 | Data + AI,MaxCompute 下一个15年的新增长引擎
本文根据 ODPS 十五周年·年度升级发布实录整理而成,演讲信息如下: 于得水(得水):阿里云智能集团计算平台事业部资深技术专家 活动:【数据进化·AI 启航】ODPS 年度升级发布
【跨国数仓迁移最佳实践6】MaxCompute SQL语法及函数功能增强,10万条SQL转写顺利迁移
本系列文章将围绕东南亚头部科技集团的真实迁移历程展开,逐步拆解 BigQuery 迁移至 MaxCompute 过程中的关键挑战与技术创新。本篇为第六篇,MaxCompute SQL语法及函数功能增强。 注:客户背景为东南亚头部科技集团,文中用 GoTerra 表示。
低代码开发启蒙教程
低代码通过拖拽组件与可视化配置快速构建应用,支持数据编排、流程设计与多端发布,适用于OA系统、智能客服等场景,结合少量代码可扩展复杂功能,提升开发效率80%。
淘宝商品详情API赋能电商数据模型:从SKU分析到销量预测
淘宝商品详情API(taobao.item.get)通过商品ID实时获取标题、价格、库存等数据,支持RESTful风格与OAuth2.0认证,具备高实时性、字段定制和防封禁机制,适用于比价、库存监控等场景。
Flink Agents 0.1.0 发布公告
Apache Flink Agents 0.1.0 首发预览版上线!作为 Flink 新子项目,它在流处理引擎上构建事件驱动的 AI 智能体,融合 LLM、工具、记忆与动态编排,支持高吞吐、低延迟、精确一次语义,实现数据与 AI 无缝集成,助力电商、金融等实时场景智能决策。
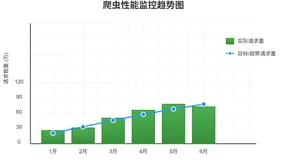
爬虫与自动化技术深度解析:从数据采集到智能运维的完整实战指南
本文系统解析爬虫与自动化核心技术,涵盖HTTP请求、数据解析、分布式架构及反爬策略,结合Scrapy、Selenium等框架实战,助力构建高效、稳定、合规的数据采集系统。
微服务架构实战指南:从单体应用到云原生的蜕变之路
🌟蒋星熠Jaxonic,代码为舟的星际旅人。深耕微服务架构,擅以DDD拆分服务、构建高可用通信与治理体系。分享从单体到云原生的实战经验,探索技术演进的无限可能。

从零构建能自我优化的AI Agent:Reflection和Reflexion机制对比详解与实现
AI能否从错误中学习?Reflection与Reflexion Agent通过生成-反思-改进循环,实现自我优化。前者侧重内容精炼,后者结合外部研究提升准确性,二者分别适用于创意优化与知识密集型任务。
一键解决 Office 卸载难题!微软官方卸载工具,点击下载开启轻松卸载之旅
微软官方Office卸载工具可彻底清除Office 2007至2021及365版本残留,解决重装报错问题。支持深度扫描与一键卸载,操作简单,卸载后需重启生效。
Step-Audio2 声音克隆 详细介绍
Step-Audio2是StepFun于2024年推出的中文语音克隆大模型,支持“一句话克隆+情感可控+实时流式”一体化生成,参数总量300M,首包延迟低至120ms,MOS达4.4+,采用Apache-2.0协议开源,适配商业应用,是当前中文TTS领域开源落地门槛最低的方案之一。
java Web 项目完整案例实操指南包含从搭建到部署的详细步骤及热门长尾关键词解析的实操指南
本项目为一个完整的JavaWeb应用案例,采用Spring Boot 3、Vue 3、MySQL、Redis等最新技术栈,涵盖前后端分离架构设计、RESTful API开发、JWT安全认证、Docker容器化部署等内容,适合掌握企业级Web项目全流程开发与部署。

Java程序员必学:JVM架构完全解读
Java 虚拟机(JVM)是 Java 编程的核心,深入理解其架构对开发者意义重大。本文详细解读 JVM 架构,涵盖类加载器子系统、运行时数据区等核心组件,剖析类加载机制,包括加载阶段、双亲委派模型等内容。阐述内存管理原理,介绍垃圾回收算法与常见回收器,并结合案例讲解调优策略。还分享 JVM 性能瓶颈识别与调优方法,分析 Java 语言特性对性能的影响,给出数据结构选择、I/O 操作及并发同步处理的优化技巧,同时探讨 JVM 安全模型与错误处理机制,助力开发者提升编程能力与程序性能。
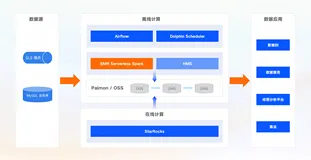
鹰角网络:EMR Serverless Spark 在《明日方舟》游戏业务的应用
鹰角网络为应对游戏业务高频活动带来的数据潮汐、资源弹性及稳定性需求,采用阿里云 EMR Serverless Spark 替代原有架构。迁移后实现研发效率提升,支持业务快速发展、计算效率提升,增强SLA保障,稳定性提升,降低运维成本,并支撑全球化数据架构部署。

LIDC-IDRI肺结节数据集分割策略
本文介绍了使用LIDC-IDRI开源数据集进行肺癌检测项目的完整流程,包括数据预处理、训练分割模型和分类模型三个主要步骤。首先,下载包含患者DICOM文件的数据集;其次,克隆预处理代码并配置Pylidc库以生成肺部遮罩图像;最后,通过脚本准备数据集并创建元数据文件。文章还提供了相关GitHub资源链接,帮助读者更好地理解和实现项目。
虾皮(shopee)商品详情接口(虾皮 API 系列)
Shopee 商品详情接口(item_get)用于获取商品的标题、价格、描述、库存和图片等详细信息。开发者需使用 Shopee 提供的 API 密钥进行认证,通过 GET 请求访问指定 URL。请求参数包括 partner_id、shopid、itemid、timestamp 和 sign。签名生成需按字母顺序排序参数,拼接后与 API 密钥进行 HMAC-SHA256 加密。响应为 JSON 格式,包含商品详细信息及错误提示。注意妥善保管 API 密钥,并遵守请求频率限制。
前端大模型入门(三):编码(Tokenizer)和嵌入(Embedding)解析 - llm的输入
本文介绍了大规模语言模型(LLM)中的两个核心概念:Tokenizer和Embedding。Tokenizer将文本转换为模型可处理的数字ID,而Embedding则将这些ID转化为能捕捉语义关系的稠密向量。文章通过具体示例和代码展示了两者的实现方法,帮助读者理解其基本原理和应用场景。

【BetterBench博士】2024 “华为杯”第二十一届中国研究生数学建模竞赛 选题分析
2024“华为杯”数学建模竞赛,对ABCDEF每个题进行详细的分析,涵盖风电场功率优化、WLAN网络吞吐量、磁性元件损耗建模、地理环境问题、高速公路应急车道启用和X射线脉冲星建模等多领域问题,解析了问题类型、专业和技能的需要。
Big Data for AI实践:面向AI大模型开发和应用的大规模数据处理套件
文叙述的 Big Data for AI 最佳实践,基于阿里云人工智能平台PAI、MaxCompute自研分布式计算框架MaxFrame、Data-Juicer等产品和工具,实现了大模型数据采集、清洗、增强及合成大模型数据的全链路,解决企业级大模型开发应用场景的数据处理难题。
数仓常用分层与维度建模
本文介绍了数据仓库的分层结构和维度建模。数仓通常分为ODS、DIM、DWD、DWS和ADS五层,各层负责不同的数据处理阶段。维度建模是数据组织方法,包括星型和雪花模型。星型模型简单直观,查询性能高,适合简单查询;雪花模型则通过规范化减少冗余,提高数据一致性和结构复杂性,但可能影响查询效率。选择模型需根据业务需求和数据复杂性来定。
大数据与机器学习
大数据领域前沿技术分享与交流,这里不止有技术干货、学习心得、企业实践、社区活动,还有未来。