


DeepSeek 背后的技术:GRPO,基于群组采样的高效大语言模型强化学习训练方法详解
强化学习(RL)是提升大型语言模型(LLM)推理能力的重要手段,尤其在复杂推理任务中表现突出。DeepSeek团队通过群组相对策略优化(GRPO)方法,在DeepSeek-Math和DeepSeek-R1模型中取得了突破性成果,显著增强了数学推理和问题解决能力。GRPO无需价值网络,采用群组采样和相对优势估计,有效解决了传统RL应用于语言模型时的挑战,提升了训练效率和稳定性。实际应用中,DeepSeek-Math和DeepSeek-R1分别在数学推理和复杂推理任务中展现了卓越性能。未来研究将聚焦于改进优势估计、自适应超参数调整及理论分析,进一步拓展语言模型的能力边界。
Chrome浏览器启动参数大全
这是一组用于定制浏览器行为的命令行参数,包括但不限于:不停用过期插件、放行非安全内容、允许应用中心脚本、停用GPU加速视频、禁用桌面通知、禁用拓展及各类API、调整缓存设置、启用打印预览、隐身模式启动、设定语言、使用代理服务器、无头模式运行等。通过这些参数,用户可以根据需求灵活调整浏览器功能与性能。

「Python入门」python环境搭建及VScode使用python运行方式
**Python 概述与环境搭建摘要** Python是一种解释型、面向对象、交互式的脚本语言,以其简单易学和丰富库著称。安装Python时,推荐在Windows上选择.exe安装程序,记得勾选“Add Python to PATH”。安装完成后,通过环境变量配置确保Python可被系统识别。验证安装成功,可在CMD中输入`python --version`。Visual Studio Code (VScode)是流行的Python IDE,安装Python插件并选择解释器后,可直接在VScode内编写和运行Python代码。
批量采集抖音商品详情数据:推荐你使用API(通过商品id取商品详情商品主图sku属性)
批量采集抖音商品详情,建议使用API接口。步骤包括:注册抖音开放平台获取App Key和Secret,调用商品详情API接口传入商品ID及相关参数,解析返回的JSON获取商品信息(如名称、价格、主图和SKU)。此外,接口列表提供商品搜索、销售量查询、历史价格、订单管理等多种功能。已封装的API接口地址:c0b.cc/R4rbK2,可测试并联系获取SDK文件。
CDN服务器真实地址
Discover CDN server real IP addresses using Traceroute & Whois, CDN provider logs (with provider cooperation), analyzing HTTP headers, online tools, or the ping command. Note that CDN
单目3D目标检测 方法综述——直接回归方法、基于深度信息方法、基于点云信息方法
本文综合整理单目3D目标检测的方法模型,包括:基于几何约束的直接回归方法,基于深度信息的方法,基于点云信息的方法。万字长文,慢慢阅读~ 直接回归方法 涉及到模型包括:MonoCon、MonoDLE、MonoFlex、CUPNet、SMOKE等。 基于深度信息的方法 涉及到模型包括:MF3D、MonoGRNet、D4LCN、MonoPSR等。 基于点云信息的方法 涉及到模型包括:Pseudo lidar、DD3D、CaDDN、LPCG等。

猿辅导基于 EMR StarRocks 的 OLAP 演进之路
猿辅导大数据平台团队负责人申阳分享了猿辅导基于EMR StarRocks 的 OLAP 演进之路。


连续三年蝉联第一,Flink 荣膺全球最活跃的 Apache 开源项目
Apache 软件基金会 2020 年度总结发布,Flink 多项排名领先!
云上一指禅:大数据产品DataWorks每日问答
每天,阿里巴巴集团数万名数据/算法开发工程师正在使用DataWorks,承载阿里巴巴集团99%数据业务构建。
唱吧基于 MaxCompute 的大数据之路
在使用 MaxCompute之前,唱吧使用自建体系来存储处理各端收集来的日志数据,包括请求访问记录、埋点数据、服务器业务数据等。但随着每天处理数据量的增长,积累的历史数据越来越多,来自其他部门同事的需求越来越复杂,自建体系逐渐暴露出了能力上的短板。
【玩转数据系列六】文本分析算法实现新闻自动分类
新闻分类是文本挖掘领域较为常见的场景。目前很多媒体或是内容生产商对于新闻这种文本的分类常常采用人肉打标的方式,消耗了大量的人力资源。本文尝试通过智能的文本挖掘算法对于新闻文本进行分类。无需任何人肉打标,完全由机器智能化实现。
结构化数据互转(上):JSON 与 CSV 的字段映射、类型推断
本文详解JSON与CSV互转的核心陷阱:字段映射易错、类型自动推断致精度丢失(如`000128`变`128`)、嵌套结构扁平化无标准解。强调“JSON是树,CSV是表”,厘清记录路径选取、数组处理策略、安全引号转义及长数字/前导零必须字符串化等关键规则。(239字)
LangChain 实现NaiveRAG朴素向量检索生成
本文详解Naive RAG(朴素检索增强生成)——RAG技术最简实现:基于语义向量检索+大模型生成,支持PDF/TXT/网页等多源文档本地化知识库构建。含环境部署、向量服务双端口配置、Chroma持久化、LCEL链式调用及增量更新全流程,适合新手入门与轻量问答场景。(239字)
告别爬虫采集京东店铺列表数据:京东店铺所有商品列表接口接入实践
本文介绍京东官方店铺商品搜索API(jd.item_search_shop),替代高维护成本的爬虫方案。支持按店铺ID分页获取商品标题、价格、库存等全量信息,具备稳定、合规、易维护优势,适用于竞品监控、价格巡检及电商数据中台建设。(239字)
内容结构实测:7大内容平台被AI引擎引用的关键差异
本文实测知乎、微信公众号等7大平台内容被AI引擎引用的差异,揭示AI偏好结构化内容:带来源标注提升引用率34.4%,含数据结论提升32.1%。提出“开头100字结论+分点表格+来源标注”优化框架,助内容高效被AI抓取与引用。

EMR Serverless Spark AI Function 的双维降本实践
EMR Serverless Spark AI Function 已在智驾、具身智能等行业广泛落地。随着数据规模增长,如何控制由模型推理与Spark计算资源构成的双重成本愈发关键。本文深入解析并发控制等执行机制,并重点介绍两大降本手段:一是通过感知AI Function的查询优化减少模型调用量;二是利用Batch File异步批量推理降低单价并释放等待期资源。两者适用场景各异且可叠加使用,助力企业实现高效降本。

AI Native, Now|阿里云 Milvus AI Function,从能力集成走向产品化落地
作为 AI Native 的 Milvus 云服务,阿里云 Milvus 用一套原生架构把数据、向量检索与模型能力真正串在了一起:Embedding、Rerank、Generate 和多模态处理原生进入数据链路,AI-Gateway 提供统一模型出口,并与 Milvus Auth、配额、审计、观测和模型切换无缝协同。

从向量存储到 Agentic 数据基础设施:Paimon × Milvus 如何构建 AI 原生多模态数据湖
本文整理自李钰在 Apache Flink Forward Asia 2026 的演讲,讨论 AI 与 Agent 进入生产环境后,数据湖与向量数据库“双系统”架构暴露出的结构性问题,以及 Apache Paimon 与 Milvus 围绕同一份湖数据协同的技术路径。
Harness Engineering 是什么?AI 编程工程化的三次进化
Harness Engineering 凭什么刷屏 AI 圈?从提示词到上下文再到 Harness,一文讲透它的来龙去脉和五大核心模块。
人工智能|大白话GPT
GPT-1是首个基于Transformer解码器的生成式预训练模型,采用自回归方式逐词生成文本:以起始,依上下文预测下一词,循环直至。其核心为12层Decoder-only架构,通过掩码自注意力实现单向语言建模,并支持分类、蕴含等下游任务微调。(239字)
PyTorch深度学习实战 |手算ViT(Vision Transformer)模型
ViT将图像分块为Patch,经卷积嵌入成Token序列,加入CLS Token和位置编码后输入Transformer Encoder。其核心是让简单分类头依赖Encoder提炼的强特征,凸显Transformer的全局特征提取能力,奠定多模态大模型基础。(239字)
OpenClaw 接入百炼模型:密钥创建+配置+报错排查全攻略
本教程详解OpenClaw客户端接入阿里云百炼的完整流程:从账号准备、API Key创建与保存,到客户端密钥配置、模型选择及连通测试,图文并茂,步骤清晰。涵盖自检清单与高频问题排查,助你快速稳定调用Qwen等百炼大模型。(239字)
一条 SQL 生成广告:Hologres 如何实现素材生成到投放分析一体化
广告投放面临“量、准、快”不可兼得的不可能三角:素材产能不足、数据与创意割裂、测试周期远超素材生命周期。阿里云Hologres以“Data + AI = All in One”理念,通过Object Table、AI Function、Dynamic Table等能力,实现素材采集、智能打标、AI生成、投放分析全链路闭环,用SQL驱动一体化智能创意工厂。
从理论到实践:在阿里云ECS上部署国密SM4加密U盘管控系统
2025年某科技企业因U盘遗失致核心代码泄露,暴露离线介质管控短板。本文剖析国密SM4/SM3算法在U盘透明加密中的关键作用,结合阿里云ECS可信环境、KMS国密密钥托管及云安全中心联动能力,提供“带不走、打不开、可追溯”的全链路防护方案,兼顾安全、可用与合规。(239字)

Anthropic最强王炸!Claude Opus 4.7来了:编程能力暴涨13%(附如何使用到Opus 4.7)
Anthropic发布Claude Opus 4.7:视觉能力跃升——图像分辨率提升3倍,支持2576像素长边,高精度解析截图、PDF、手写笔记;编码能力稳步增强(SWE-bench达87.6%);新增/ultrareview代码审查命令、xhigh推理档位及安全防护机制;价格不变,仍为$5/$25每百万token。

相约深圳,全球征集|Flink Forward Asia 2026 演讲议题征集正式启动
Flink Forward Asia 2026将于6月26–27日首次落地深圳,聚焦实时计算与AI深度融合。面向全球征集议题(截止5月29日),涵盖实时AI、AI Agent、湖流一体等前沿方向。免费报名开启,共探下一代实时计算范式!
用 SQL 调大模型?Hologres + 百炼,让数据开发直接“对话”AI
阿里云Hologres深度集成百炼大模型平台,推出AI Function能力——无需Python、GPU或额外服务,用熟悉的SQL即可直接调用大模型,实现PDF解析、多模态理解、向量检索等AI功能,让数据开发者零门槛构建智能应用。
从悟空发布看企业级 Agent 平台的下一步:可独立验证的执行证据层
3月17日阿里发布企业级AI原生平台“悟空”,整合账号权限、安全沙箱、Skill生态与钉钉入口,标志Agent从“能对话”迈向“能干活”。本文探讨其关键缺口:平台可控≠结果可验证,呼吁构建可导出、可验证、可第三方复核的“执行证据层”,夯实企业规模化落地的信任基石。(239字)
从踩坑到高效落地:淘宝拍立淘图片搜索API的实操心得
淘宝拍立淘API提供高精度以图搜品服务,支持Base64/URL传图,基于MobileNet/ResNet提取200+图像特征,毫秒级匹配相似商品。关键需控主体占比≥70%、签名严格ASCII排序、阈值设0.8,单次返回50条结构化结果。(239字)
小红书笔记详情数据获取实战:从笔记链接提取 ID 到解析详情
小红书笔记详情API可获取标题、正文、作者、互动数据、图文/视频资源及话题标签等结构化信息,支持自定义字段与评论拉取。适用于内容分析、竞品监控、营销优化与用户研究,HTTPS+JSON接口,Python调用便捷。(239字)
智能体来了:从0到1教你三步构建属于你的 AI 数字分身
本文带你从零构建专属AI智能体:解析其自主性本质,详解“骨架—性格—应用”三步搭建法,涵盖决策中枢、记忆系统与行动接口,并强调隐私保护与伦理边界。门槛降低,人人可启程。
虚拟机安装(CentOS7)
本文介绍了搭建CentOS 7虚拟机的准备工作及安装步骤,包括CentOS 7镜像和VMware Workstation的获取方式(提供官网及百度云链接),并指导使用VMware创建虚拟机,推荐参考教程完成安装。安装后默认登录用户为root,密码由用户自设。
构建AI智能体:十一、语义分析Gensim — 从文本处理到语义理解的奇妙之旅
Gensim是Python中强大的自然语言处理库,擅长从大量中文文本中自动提取主题、生成词向量并计算文档相似度。它支持LDA、Word2Vec等模型,结合jieba分词可有效实现文本预处理、主题建模与语义分析,适用于新闻分类、信息检索等任务,高效且易于扩展。
LlamaIndex检索调优实战:分块、HyDE、压缩等8个提效方法快速改善答案质量
本文总结提升RAG检索质量的八大实用技巧:语义分块、混合检索、重排序、HyDE查询生成、上下文压缩、元数据过滤、自适应k值等,结合LlamaIndex实践,有效解决幻觉、上下文错位等问题,显著提升准确率与可引用性。
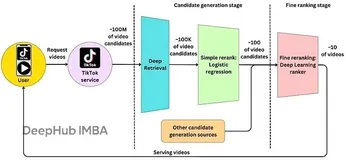
从零构建短视频推荐系统:双塔算法架构解析与代码实现
短视频推荐看似“读心”,实则依赖双塔推荐系统:用户塔与物品塔分别将行为与内容编码为向量,通过相似度匹配实现精准推送。本文解析其架构原理、技术实现与工程挑战,揭秘抖音等平台如何用AI抓住你的注意力。
一键解决 Office 卸载难题!微软官方卸载工具,点击下载开启轻松卸载之旅
微软官方Office卸载工具可彻底清除Office 2007至2021及365版本残留,解决重装报错问题。支持深度扫描与一键卸载,操作简单,卸载后需重启生效。
Java 大视界 -- Java 大数据机器学习模型在生物信息学基因功能预测中的优化与应用(223)
本文探讨了Java大数据与机器学习模型在生物信息学中基因功能预测的优化与应用。通过高效的数据处理能力和智能算法,提升基因功能预测的准确性与效率,助力医学与农业发展。
阿里云服务器上部署ROS2+Isaac-Sim4.5实现LeRobot机械臂操控
本文介绍了如何在阿里云上申请和配置一台GPU云服务器,并通过ROS2与Isaac Sim搭建机械臂仿真平台。内容涵盖服务器申请、系统配置、远程连接、环境搭建、仿真平台使用及ROS2操控程序的编写,帮助开发者快速部署机器人开发环境。
MaxCompute x 聚水潭:基于近实时数仓解决方案构建统一增全量一体化数据链路
聚水潭作为中国领先的电商SaaS ERP服务商,致力于为88,400+客户提供全链路数字化解决方案。其核心ERP产品助力企业实现数据驱动的智能决策。为应对业务扩展带来的数据处理挑战,聚水潭采用MaxCompute近实时数仓Delta Table方案,有效提升数据新鲜度和计算效率,提效比例超200%,资源消耗显著降低。未来,聚水潭将进一步优化数据链路,结合MaxQA实现实时分析,赋能商家快速响应市场变化。
装了就舍不得卸载的一款电脑截图软件!
这是一款免费且功能强大的截图工具,支持Windows和Mac系统。它不仅界面简洁无广告,还提供带壳截图、文字提取、内容翻译与AI解释等实用功能,极大提升工作与学习效率。下载地址:https://tool.nineya.com/s/1j06j6dmj
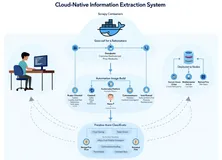
云原生信息提取系统:容器化流程与CI/CD集成实践
本文介绍如何通过工程化手段解决数据提取任务中的稳定性与部署难题。结合 Scrapy、Docker、代理中间件与 CI/CD 工具,构建可自动运行、持续迭代的云原生信息提取系统,实现结构化数据采集与标准化交付。
大数据时代的智能研发平台需求与阿里云DIDE的定位
阿里云DIDE是一站式智能大数据开发与治理平台,致力于解决传统大数据开发中的效率低、协同难等问题。通过全面整合资源、高度抽象化设计及流程自动化,DIDE显著提升数据处理效率,降低使用门槛,适用于多行业、多场景的数据开发需求,助力企业实现数字化转型与智能化升级。

一场始于 Selector Error 的拯救行动:企查查数据采集故障排查记
开发人员小李在使用Python爬虫从企查查抓取公司工商信息时,遇到选择器失效和动态加载内容无法解析的问题。通过分析日志和网页结构变化,发现关键数据由JavaScript动态渲染。解决方案包括引入Selenium模拟浏览器行为、配置代理IP和请求头、调整选择器,并优化代码实现。最终成功解决了数据采集问题,确保了爬虫的稳定性和可靠性。改进方案还涉及动态加载应对策略、选择器稳定性保障及代理池搭建等措施,以应对未来可能的变化。
大数据与机器学习
大数据领域前沿技术分享与交流,这里不止有技术干货、学习心得、企业实践、社区活动,还有未来。