阿里云Mia_个人页

阿里云Mia
个人头像照片
34
0
0

个人介绍

暂无个人介绍

擅长的技术

获得更多能力
通用技术能力:

暂时未有相关通用技术能力~

云产品技术能力:

阿里云技能认证

详细说明
暂无更多信息

2026年10月

  • 10.13 15:59:11
    发表了文章 2026-10-13 15:59:11

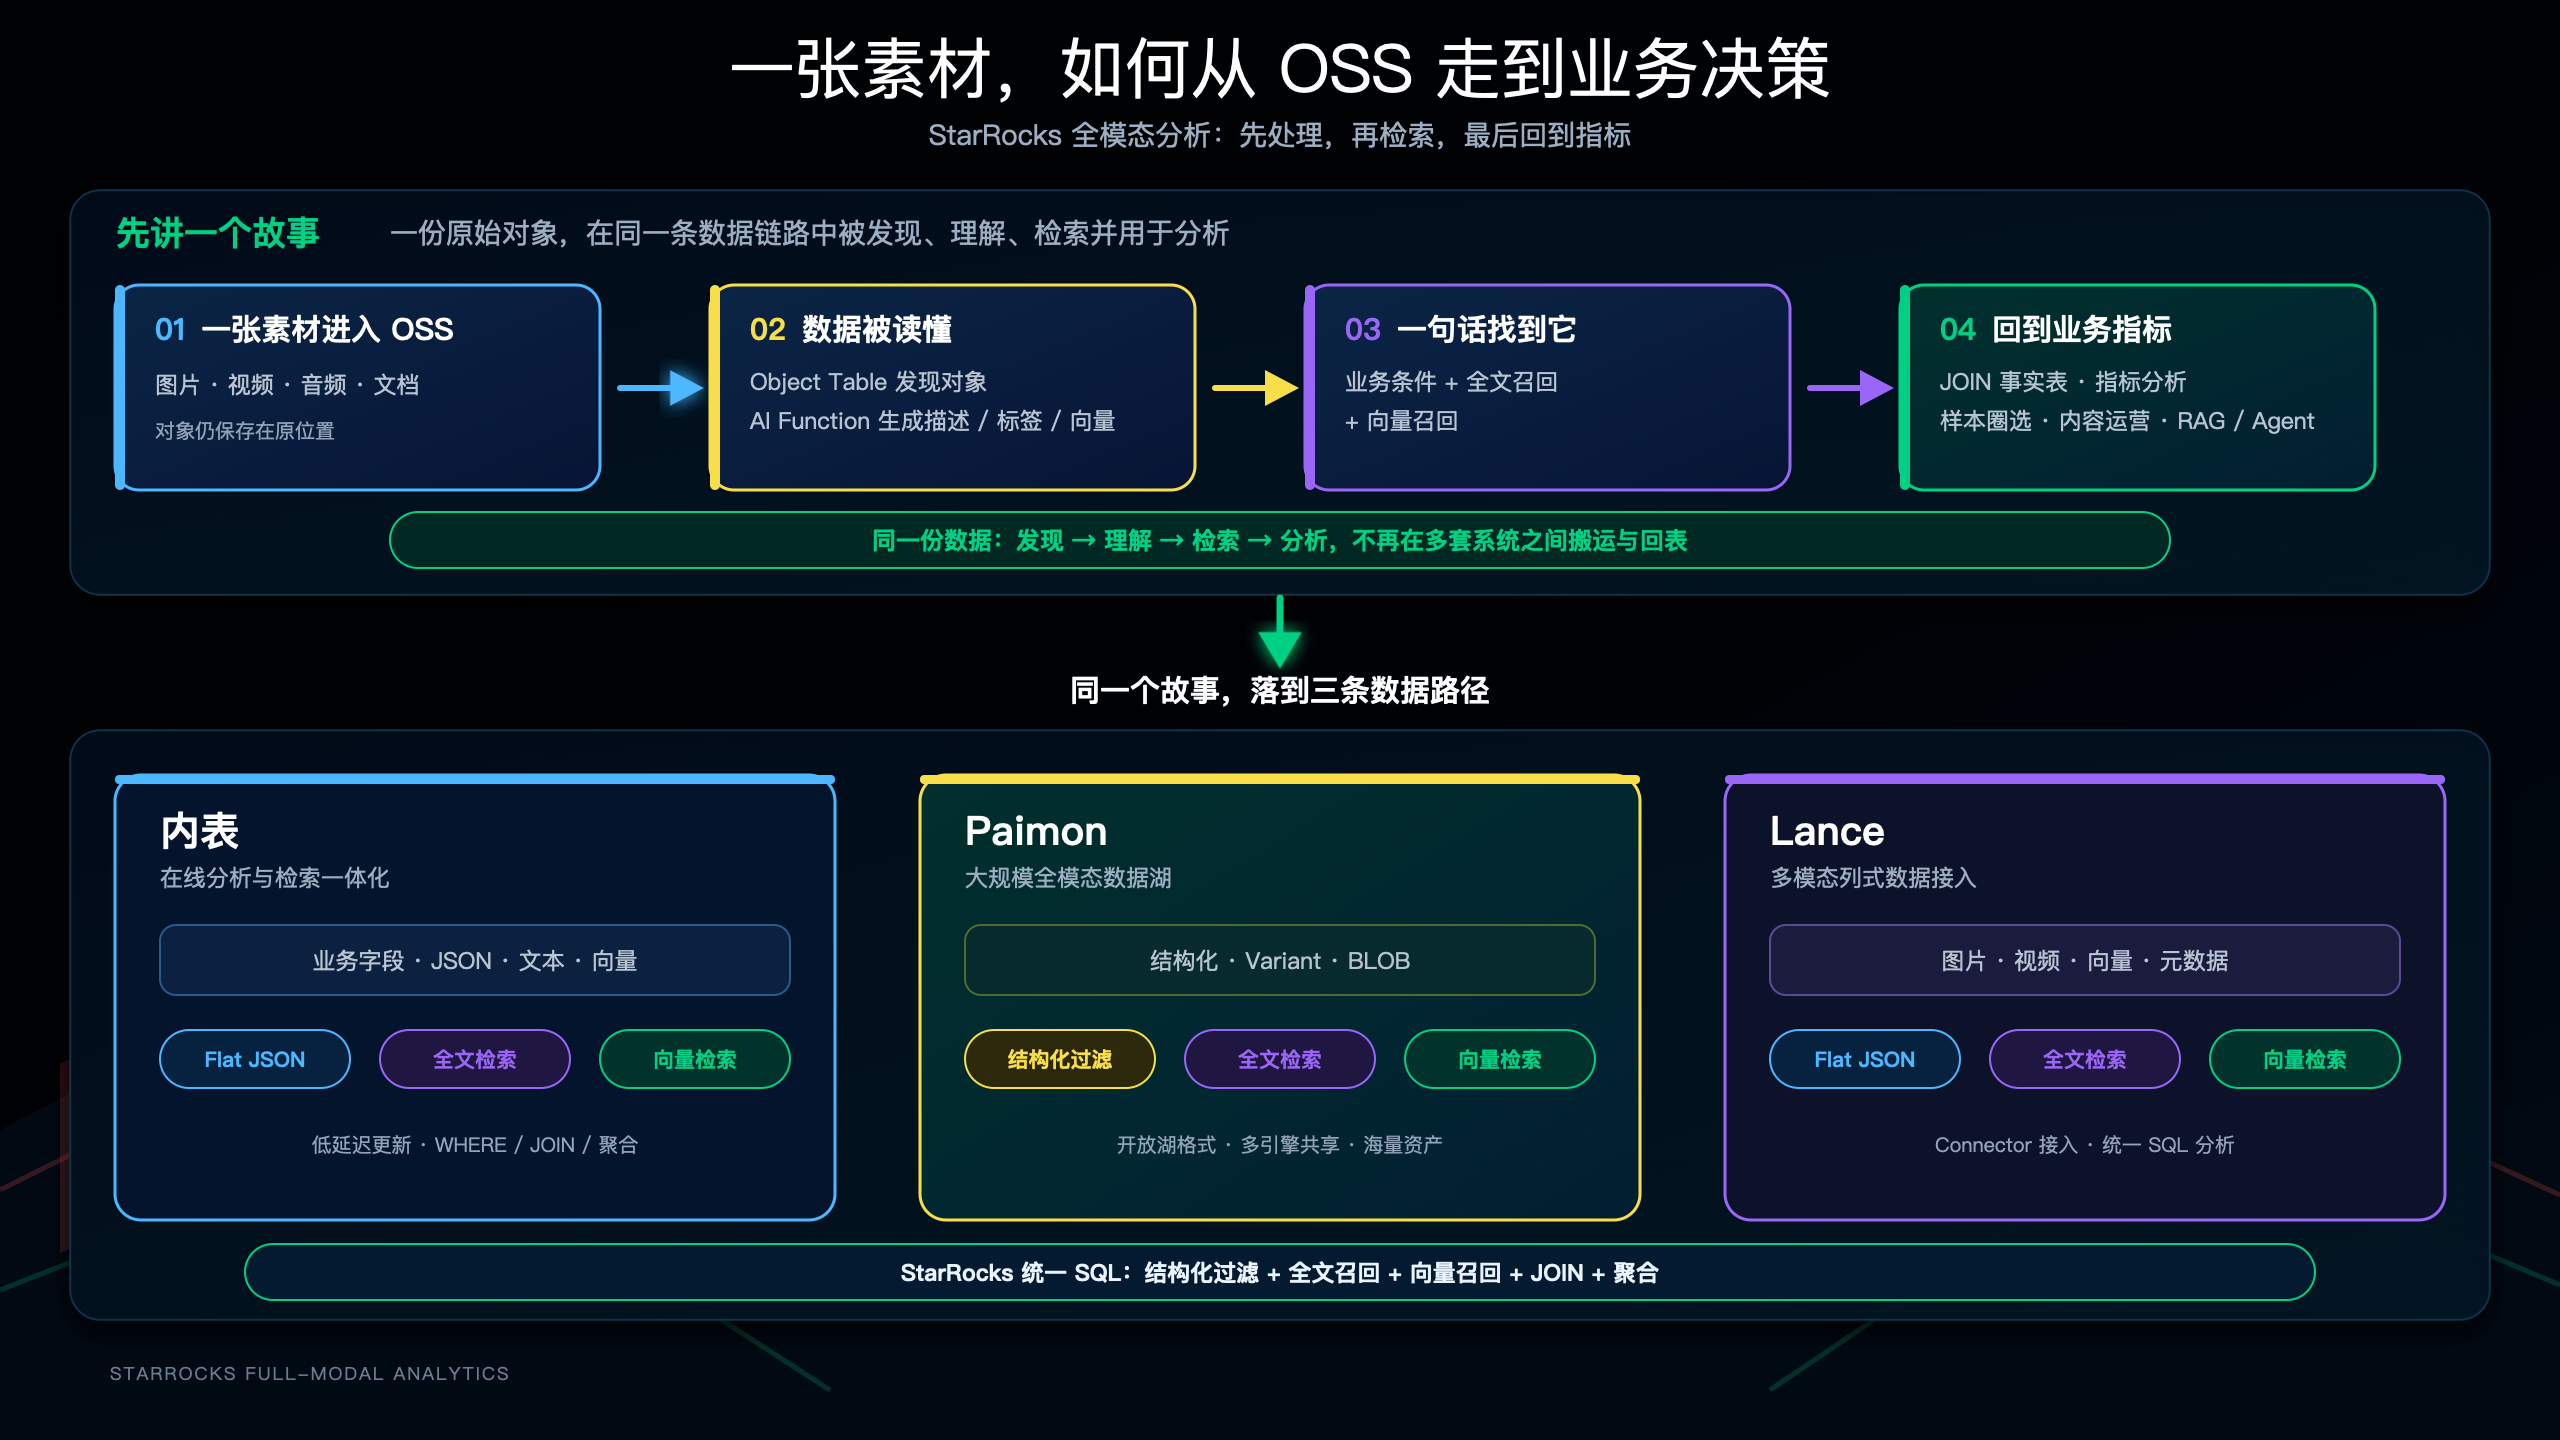
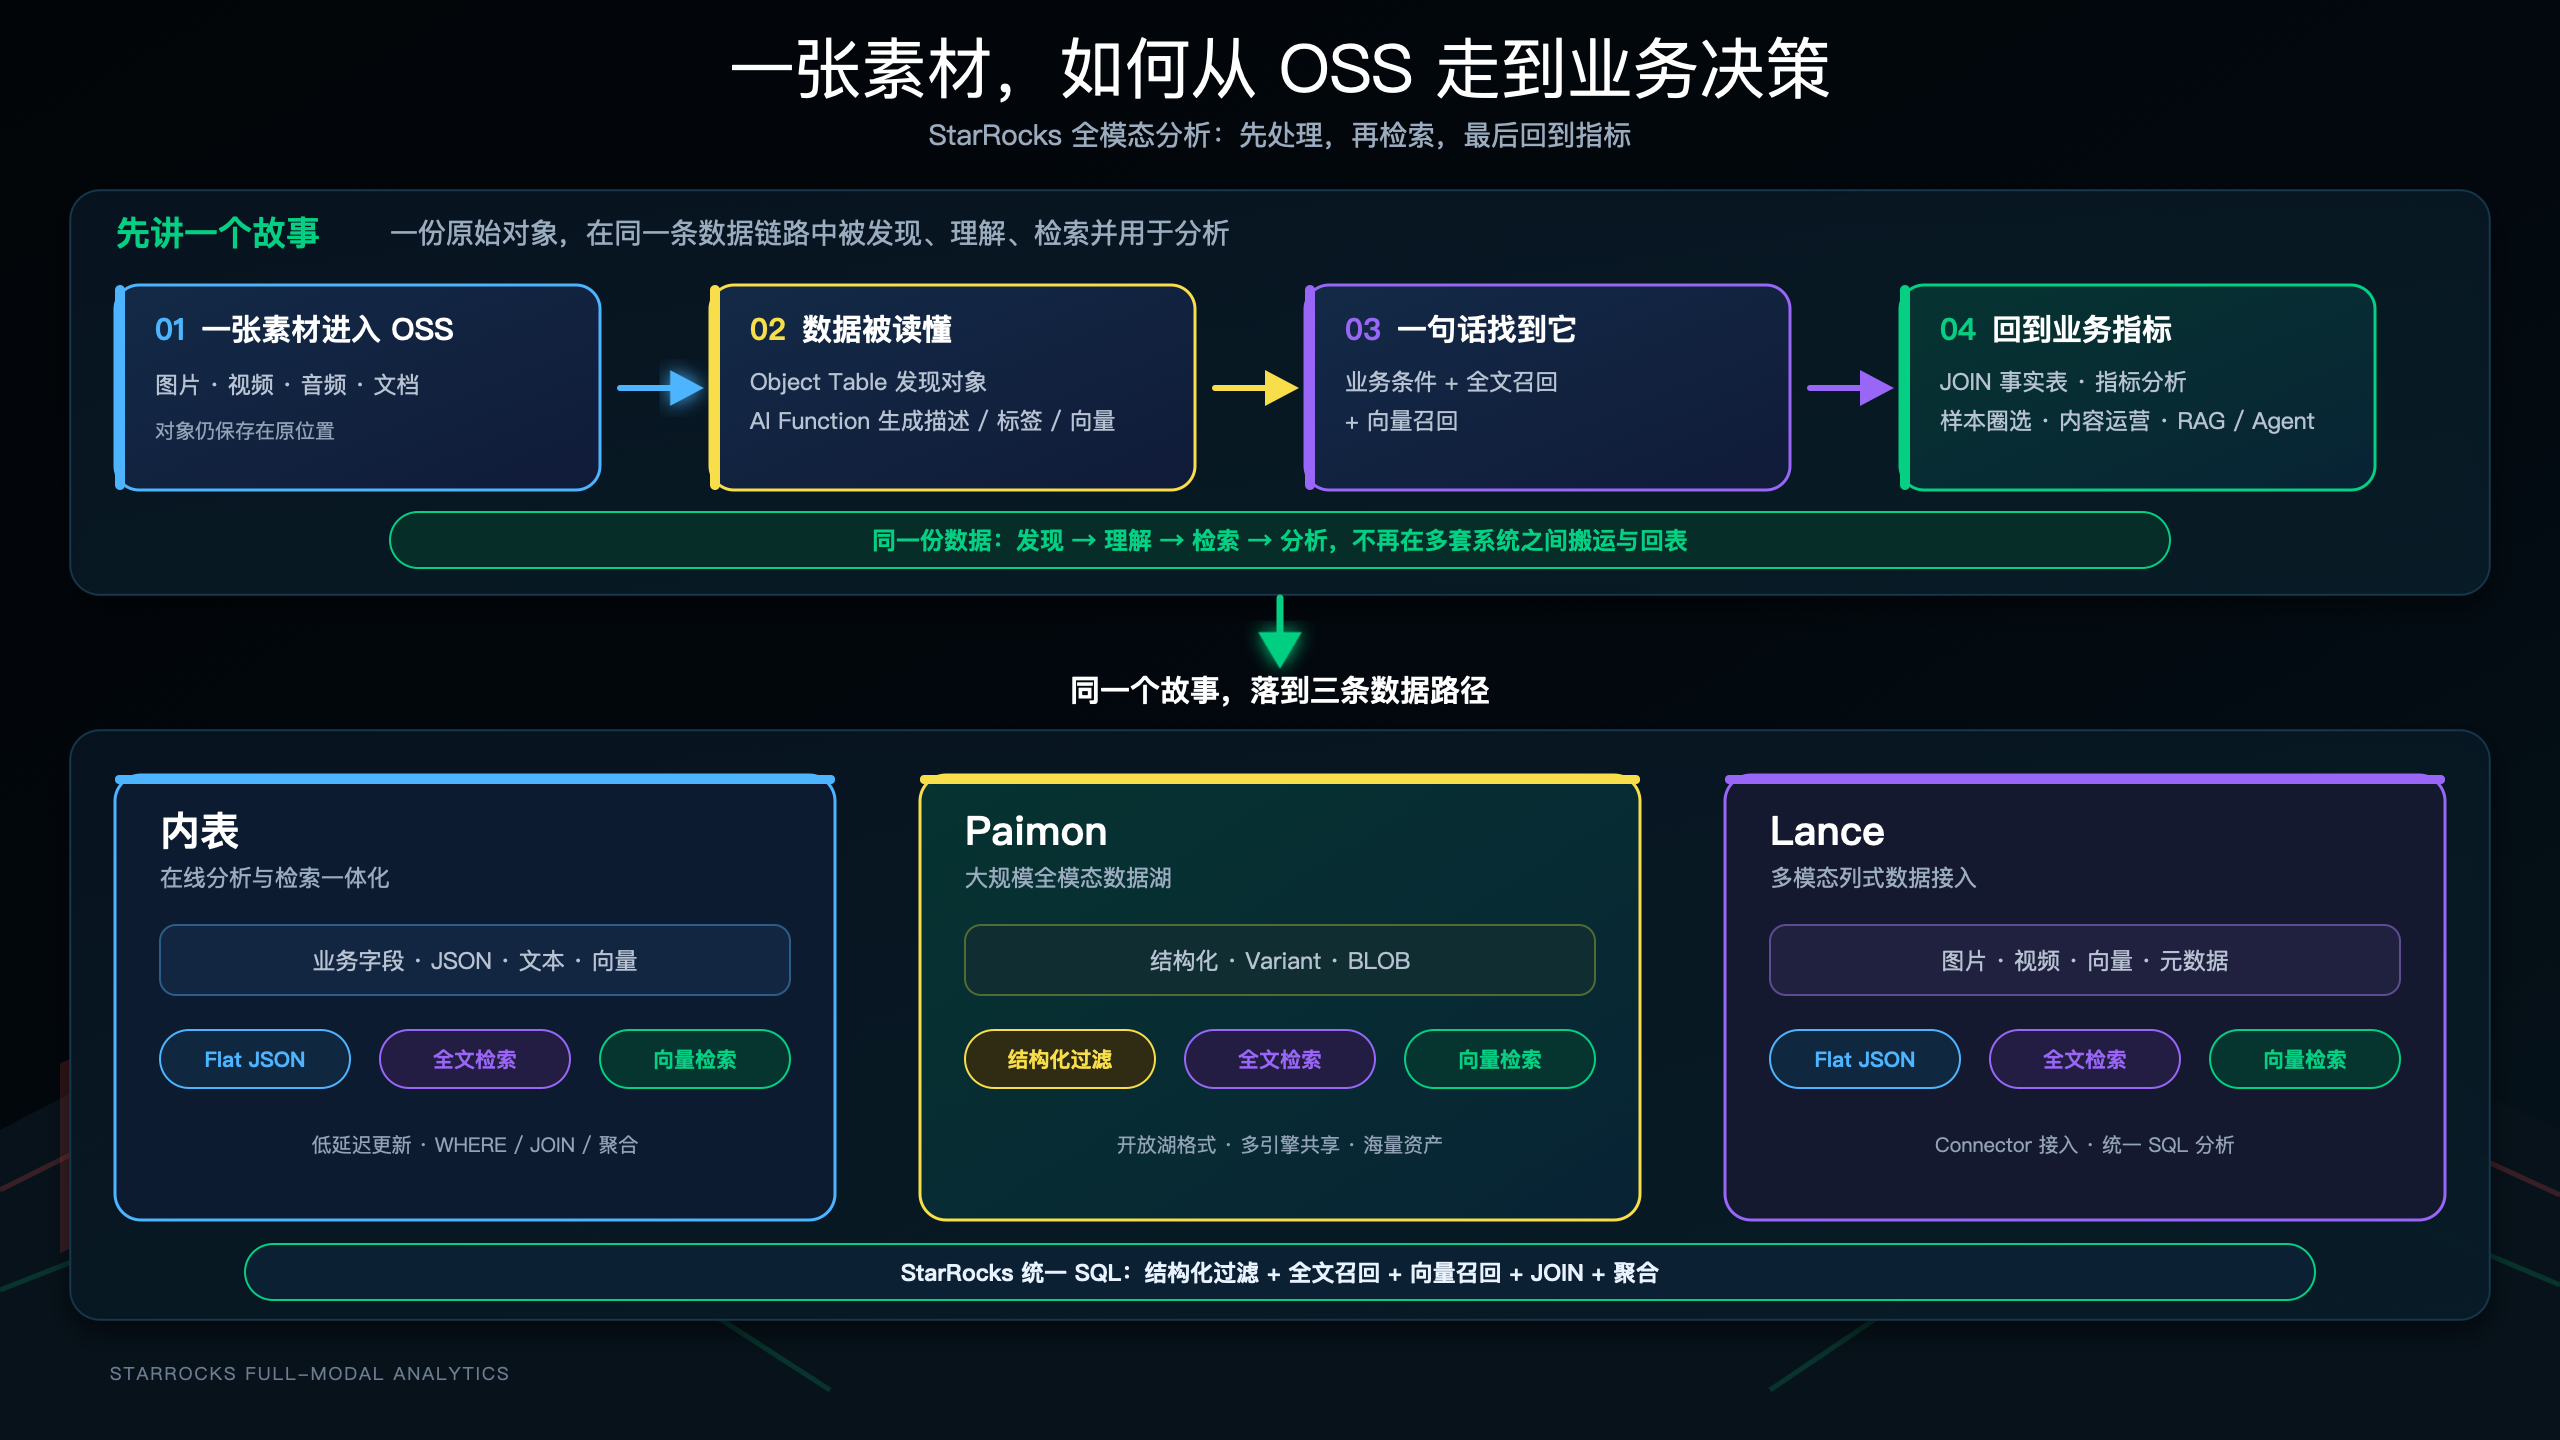
    StarRocks 全模态能力导读:连接内容理解、混合检索与业务分析

    StarRocks 全模态能力旨在打通内容理解、混合检索与业务分析的断点,支持结构化、半结构化和非结构化数据在同一条 SQL 链路中完成特征化、多条件检索(含结构化过滤、全文匹配与向量相似度)及后续 Join、聚合与指标计算,通过多模态处理、内表、Paimon 和 Lance 四类技术路径适配不同数据位置、规模与查询需求,消除多系统间的数据复制与结果搬运。
  • 10.13 15:58:46
    发表了文章 2026-10-13 15:58:46

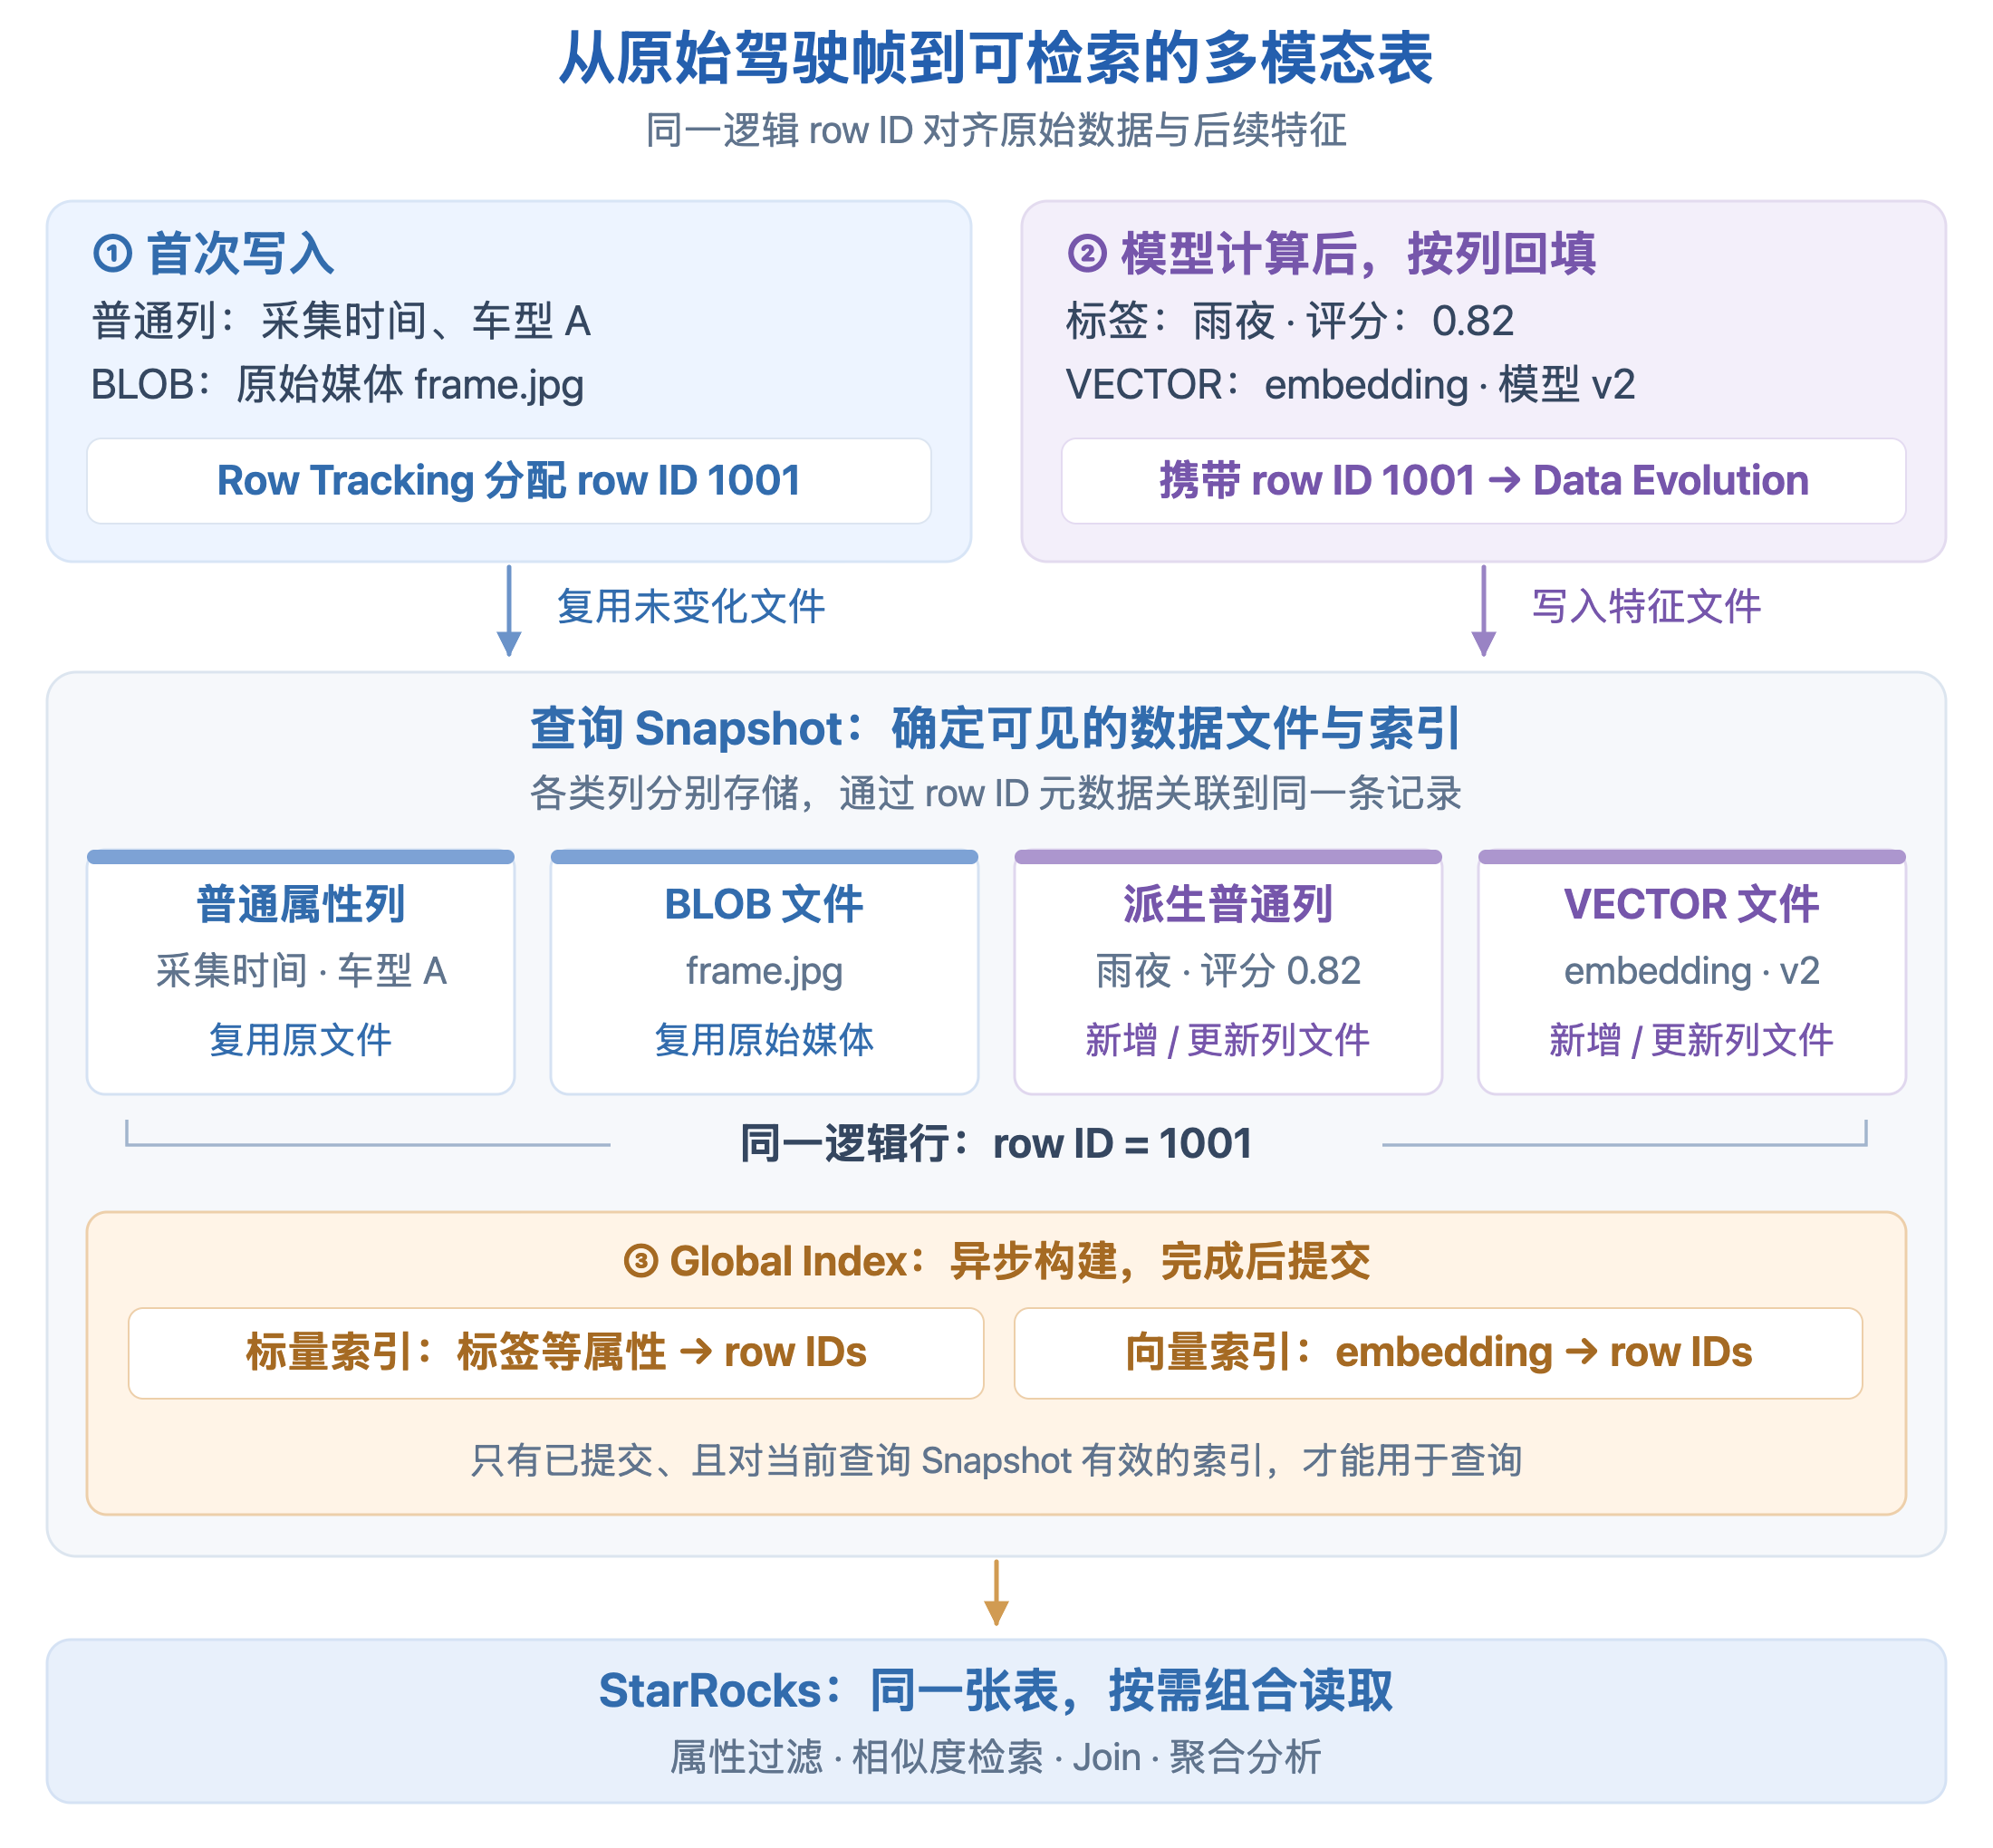
    StarRocks 全面支持 Paimon 2.0:构建多模态统一分析与检索

    StarRocks 全面支持 Paimon 2.0,将多模态原始数据、派生特征、向量索引与业务指标统一纳管于同一湖表,并通过一套 SQL 执行架构原生融合列式扫描、标量/向量/全文检索、稀疏回捞及关联分析,支撑智能驾驶、具身智能、广告与游戏等场景下的混合查询与训练数据准备。
  • 10.13 15:52:21
    发表了文章 2026-10-13 15:52:21

    借助 EMR Serverless StarRocks 实现电商平台图搜图、文搜图场景

    本文介绍如何基于 EMR Serverless StarRocks 构建统一的多模态电商搜索系统,通过内置 AI Function 实现图搜图与文搜图场景的一体化处理:利用 Object Table 直接挂载 OSS 图片,结合 HNSW/IVFPQ 向量索引与结构化字段联合查询,将图片/文本向量化、ANN 检索、业务过滤(价格、库存、类目等)全部收敛至单条 SQL,消除多系统割裂与数据延迟问题,显著提升搜索实时性、准确性和工程效率。
  • 10.13 15:51:43
    发表了文章 2026-10-13 15:51:43

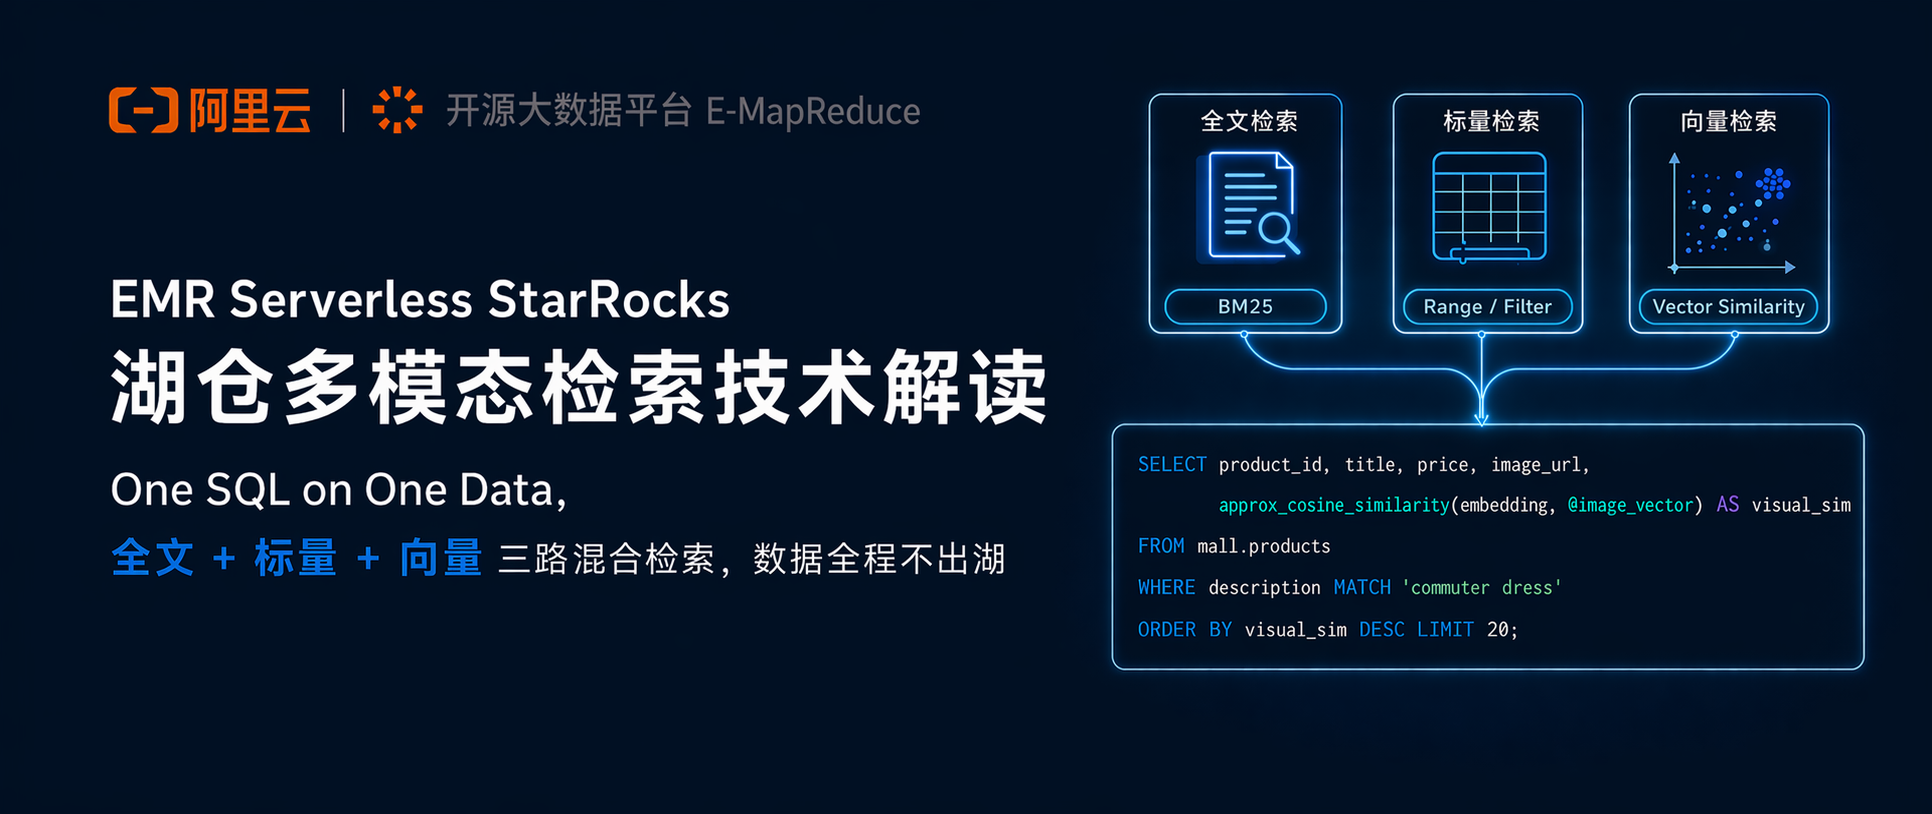
    EMR Serverless StarRocks 湖仓多模态检索:One SQL on One Data,实现全文 + 标量 + 向量三路混合检索

    阿里云EMR Serverless StarRocks实现全文、标量、向量三路原生融合检索,支持在Paimon/Iceberg/Lance等开放湖格式上通过一条SQL完成关键词匹配、条件过滤与语义相似联合召回,并内置RRF重排、In-Filter深度优化及列级回写能力,显著提升召回率与执行效率;相比传统多系统架构,成本降低60%,数据全程不出湖,适用于自动驾驶Corner Case挖掘、RAG增强、电商搜索等多模态场景。
  • 10.13 15:50:19
    发表了文章 2026-10-13 15:50:19

    阿里云 EMR Serverless StarRocks Skills 正式发布

    阿里云EMR Serverless StarRocks Skills正式发布,面向Agent提供SQL开发、慢查询诊断、建表设计、数据导入、实例运维与弹性扩缩容六大能力,通过starrocks-assistant和starrocks-manage两大Skill封装StarRocks最佳实践与实时集群状态,实现从“生成建议”到“自动执行”的跃迁,已兼容Qoder、Claude Code、DataWorks Data Agent等主流AI客户端,标志着EMR从业界领先大数据基座全面迈入Agentic时代。
  • 10.13 15:49:34
    发表了文章 2026-10-13 15:49:34

    最佳实践:用 StarRocks AI Function 实现金融行业文本分类

    本文介绍了如何利用 StarRocks AI Function 在数据库内原生实现金融文本的端到端智能分析,涵盖情感分析、工单分类、合同要素抽取、PII 脱敏等核心场景,通过异步非阻塞架构、SQL 谓词下推、LRU 缓存与三层限流等技术创新,在保障数据不出库的前提下,显著提升处理并发性、降低延迟与 Token 成本,并满足金融级安全合规要求。
  • 10.13 15:48:30
    发表了文章 2026-10-13 15:48:30

    StarRocks 支持向量检索、混合检索和多模态检索吗?全模态能力与选型导读

    StarRocks 已构建覆盖结构化、半结构化与非结构化数据的全模态能力,支持向量检索、混合检索(结构化条件+全文+语义相似度)及多模态联合分析,通过内表、Paimon湖表、Lance接入和多模态处理四条路径,统一实现对象理解、特征化、多维检索与业务关联分析,适用于基础模型训练、智能驾驶、具身智能、短剧生产与游戏IP管理等复杂AI场景。
  • 10.13 15:20:15
    发表了文章 2026-10-13 15:20:15

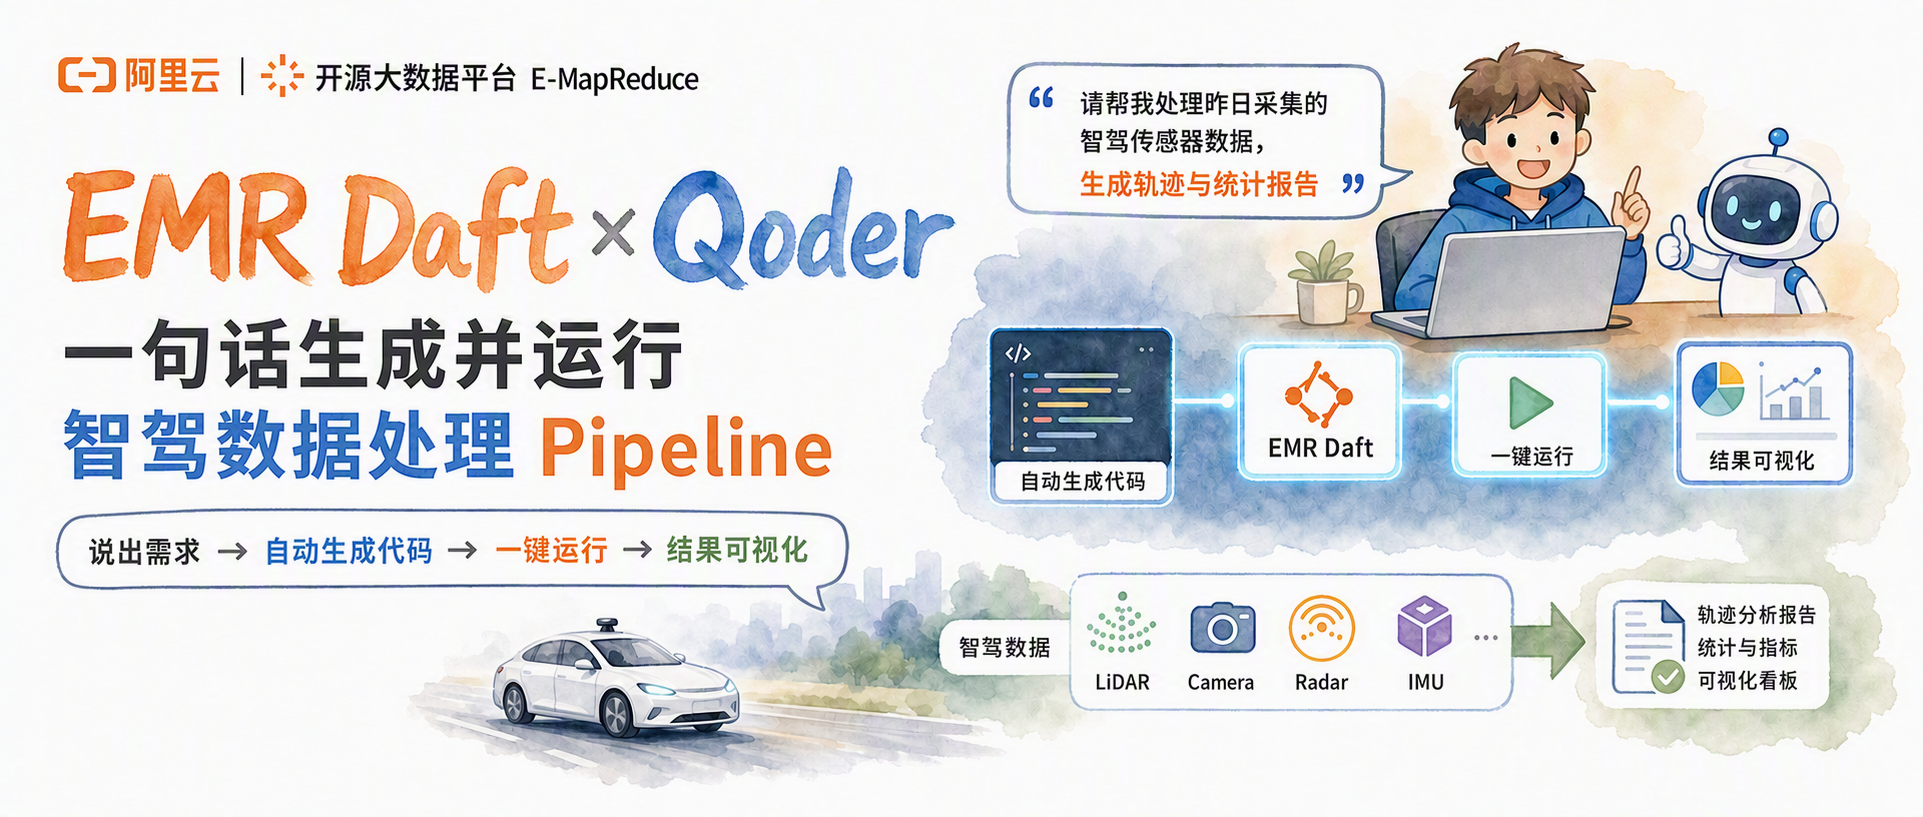
    EMR Daft × Qoder:一句话生成并运行智驾数据处理 Pipeline

    本文介绍了阿里云EMR Daft与Qoder协同实现智驾数据处理Pipeline的一站式解决方案,通过自然语言描述需求即可自动生成并运行分布式多模态作业,覆盖OSS视频读取、场景切分、关键帧提取、多维度标签生成、Embedding计算及结果写入Paimon数据湖的完整链路,显著降低工程复杂度,提升数据资产构建效率。
  • 10.13 15:00:27
    发表了文章 2026-10-13 15:00:27

    阿里云 EMR Serverless Spark 发布 Agent Skill:让自然语言驱动 Spark 任务与资源管理

    阿里云EMR Serverless Spark正式发布Agent Skill,支持通过自然语言完成工作空间创建、Spark作业提交与监控、弹性资源扩缩容及交互式SQL查询等核心运维操作,覆盖从基础设施配置到任务调度的全链路管理;该Skill已实现与RAM授权、DLF元数据、OSS存储及Kyuubi服务的深度集成,并规划接入智能告警、成本优化与故障诊断能力,推动数据运维从被动响应迈向主动协同。
  • 10.13 14:59:56
    发表了文章 2026-10-13 14:59:56

    阿里云 EMR Serverless Spark AI Function 多模态能力介绍与智驾场景图片理解实践

    本文介绍了阿里云EMR Serverless Spark AI Function在多模态处理上的能力升级与智驾场景落地实践,涵盖图片理解(aiquery)和向量化(aiembeddingmultimodal)两大核心函数的多种调用模式,支持URI路径、二进制流及readfiles直读等灵活输入方式,并可对接百炼或PAI-EAS实现快速验证与企业级安全推理;通过智驾环岛识别与特种车辆检测案例,验证了其在高分辨率图像秒级结构化分析、长尾场景泛化及自动化数据清洗方面的实际效能。
  • 10.13 14:59:30
    发表了文章 2026-10-13 14:59:30

    EMR Serverless Spark 数据湖上新能力:一条 SQL 实现标量向量混合检索(附智驾实战代码)

    EMR Serverless Spark 基于 DLF Global Index 实现标量与向量联合索引,通过原生 vectorsearch 函数与标准 SQL WHERE 子句协同执行,支持一条 SQL 完成“语义相似+结构化条件”的混合检索;该能力覆盖智能驾驶长尾场景挖掘、多模态搜索、RAG增强及离线向量批处理等典型场景,具备零门槛SQL接入、索引全自动托管、存算分离按需计费及3倍性能提升等核心优势。
  • 10.13 14:59:07
    发表了文章 2026-10-13 14:59:07

    Daft AI Function:用 DataFrame 表达式搞定大模型调用与多模态向量化

    本文介绍了在阿里云EMR Serverless Spark上通过Daft引擎的AI Function(aiquery、aiembedding、aiembeddingmultimodal)将大模型调用与多模态向量化无缝集成到DataFrame处理链路中的实践方案,解决了传统方式中链路割裂、多模态难统一、并发对齐复杂及模型服务配置繁琐等核心痛点,实现像操作普通列一样完成AI推理与向量化。
  • 10.13 14:57:40
    发表了文章 2026-10-13 14:57:40

    基于 EMR Serverless Ray 实现 Qwen 模型批量推理实践

    本文介绍了在阿里云EMR Serverless Ray上部署Qwen3.5系列模型并实现高吞吐批量推理的完整实践,涵盖基于Ray Serve LLM的模型服务构建、通过Ray Data aiquery进行声明式批量推理、关键参数调优及结果落库等环节,验证了该方案在离线标注、RAG生成和模型评估等场景下的高效性与弹性扩展能力。
  • 10.13 14:54:58
    发表了文章 2026-10-13 14:54:58

    Daft 多模态视频抽帧性能优化实践:从抽帧到大模型打标,一条视频理解流水线是怎么跑起来的

    本文详细介绍了基于 Daft 构建的多模态视频理解流水线,涵盖从远程视频按需抽帧、智能采样、黑边裁剪与 OSS 落盘,到大模型批量打标生成结构化标签的全链路实践;重点阐述了三项核心性能优化——读取时的关键帧定位下推、采样过程中的无用帧跳过、以及多线程并行解码,并通过实测验证其叠加效果,最终实现 TB 级视频数据高效转化为可检索分析的结构化语义信息。
  • 10.13 14:53:06
    发表了文章 2026-10-13 14:53:06

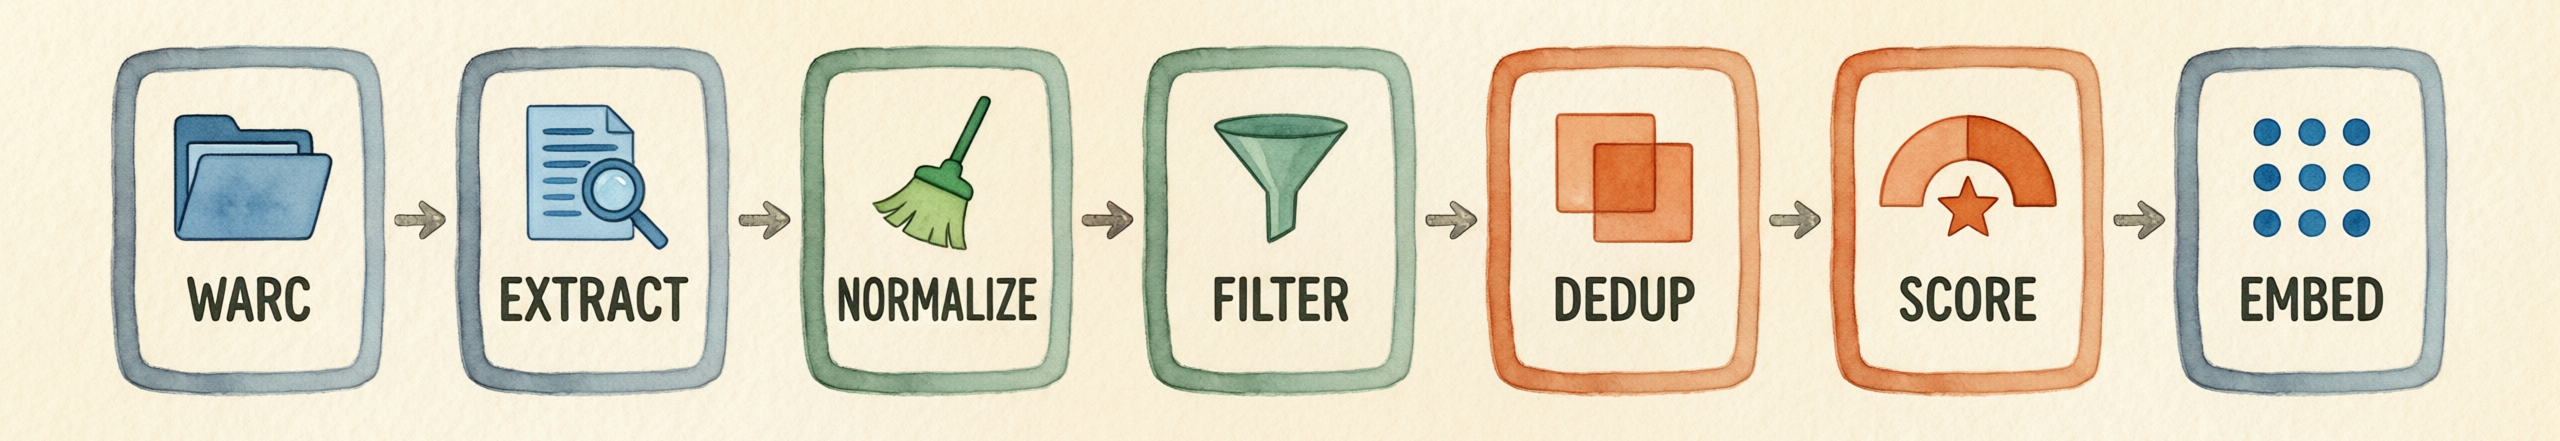
    从 Common Crawl 到可训练语料:用 EMR Serverless Daft 构建清洗、模型标注与向量化管线

    本文介绍如何基于阿里云EMR Serverless Daft构建端到端的网页语料处理管线,覆盖从Common Crawl WARC文件读取、正文抽取、多级清洗与质量过滤、精确及近似去重、大模型标注到向量化全流程;通过内置算子统一调度CPU密集型处理与大模型服务调用,解决大规模数据下稳定性、容错性、模型复用与策略迭代等工程难题,并支持按语种和任务定制化调优。
  • 10.13 14:52:36
    发表了文章 2026-10-13 14:52:36

    一套 Spark SQL,打通多种 Catalog:EMR Serverless Spark 统一数据处理实践

    阿里云EMR Serverless Spark通过多Catalog能力,支持在单个Spark Session中统一访问DLF、Hive Metastore、MaxCompute、Hologres、StarRocks、Paimon、Iceberg等异构数据源,使跨系统数据读取、关联与写入可收敛至一条标准Spark SQL,无需中间表搬运或多任务编排,显著简化数据链路、降低开发运维复杂度,并保持原有SQL语法和执行体验不变。
  • 10.13 14:52:16
    发表了文章 2026-10-13 14:52:16

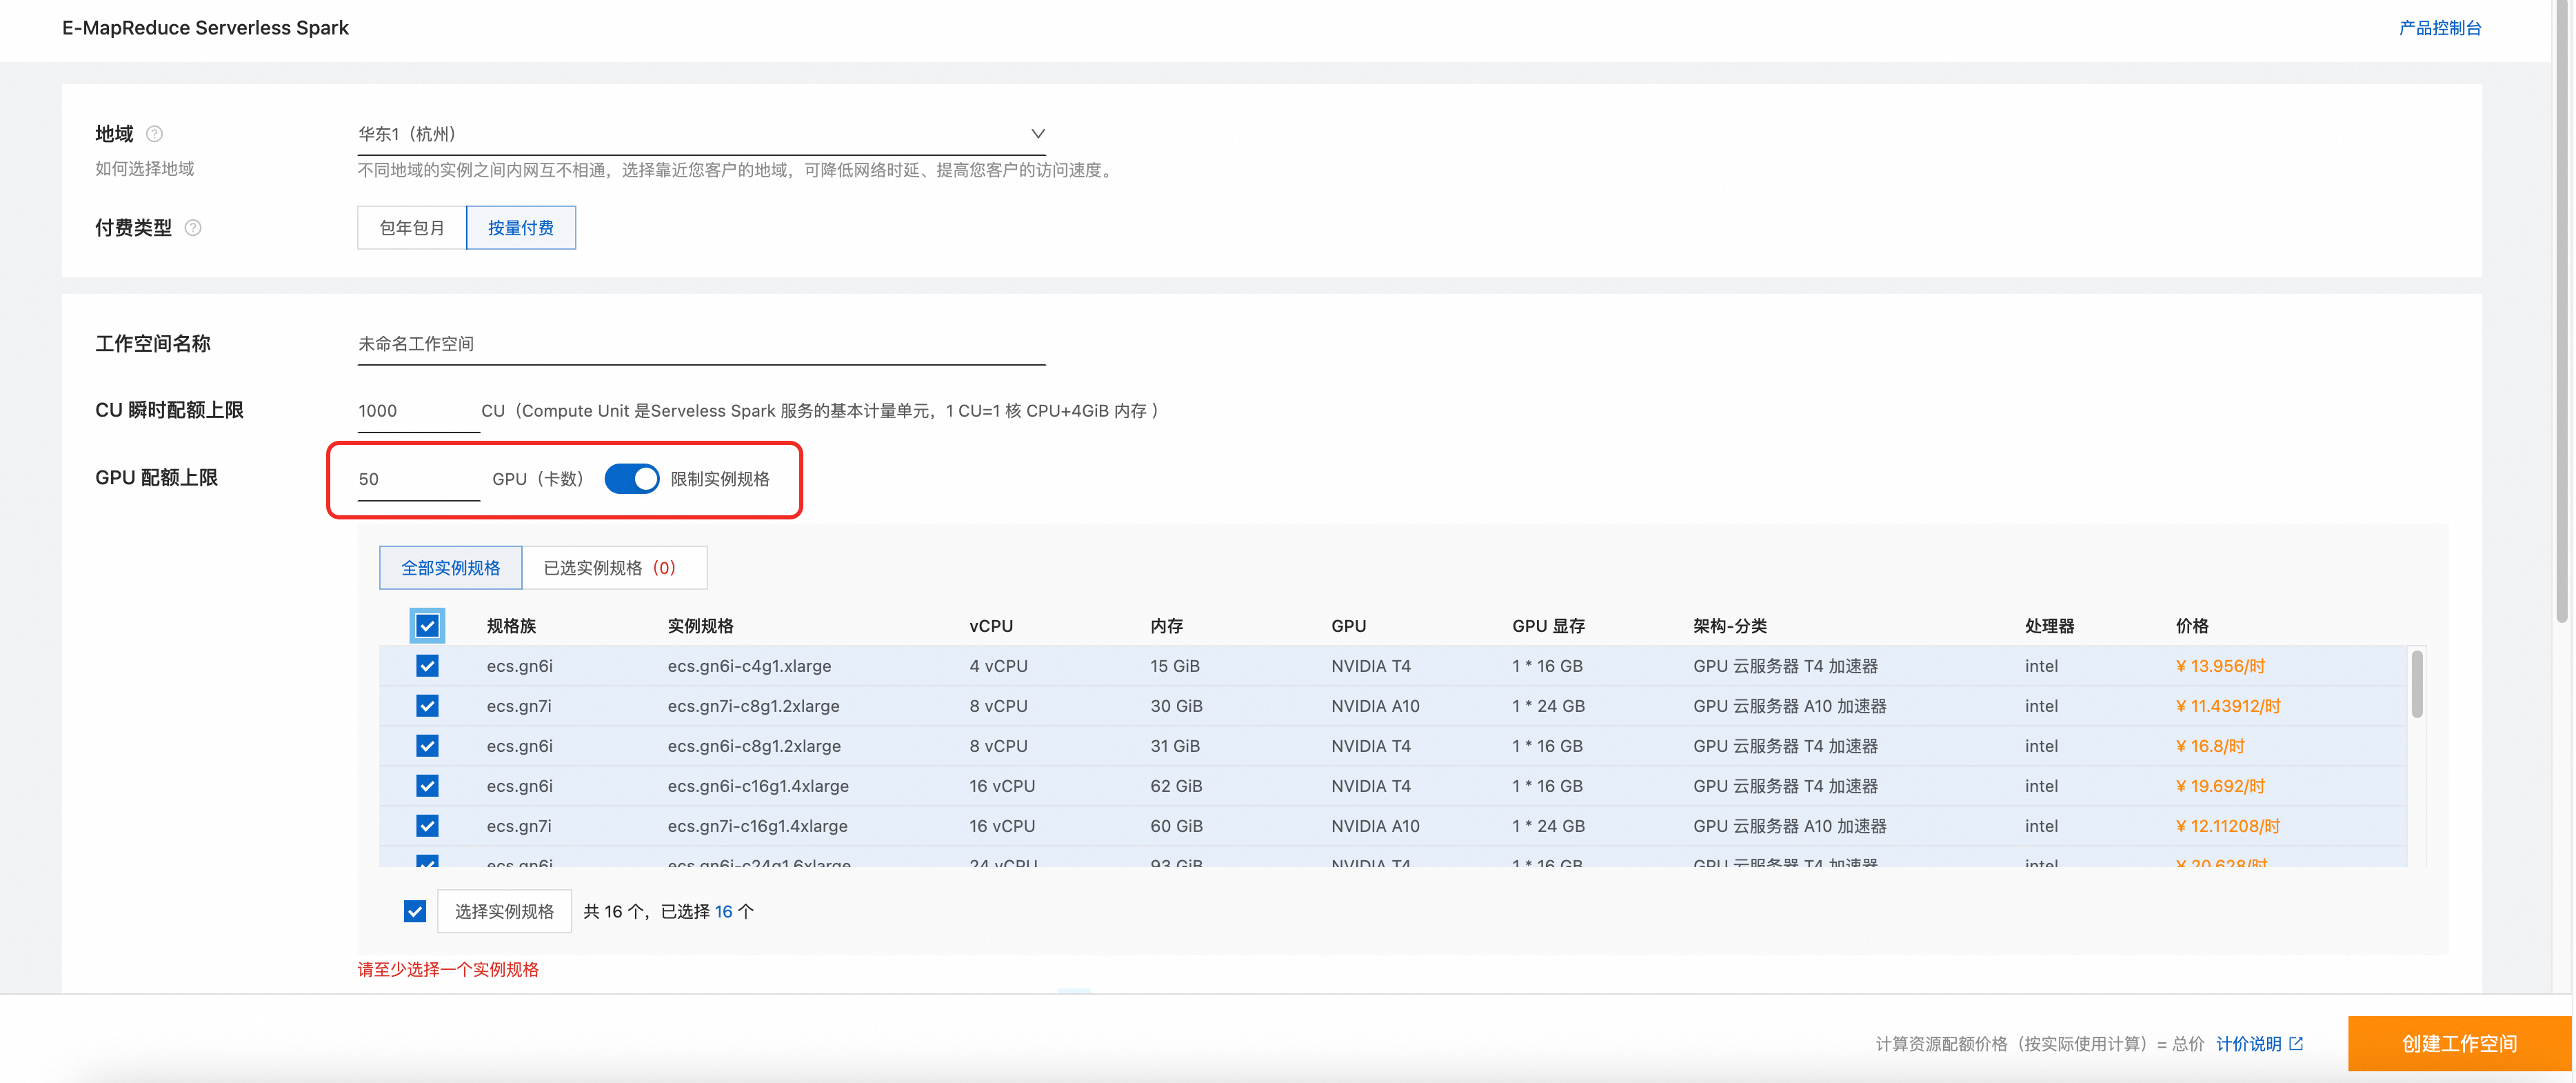
    EMR Serverless Spark:CPU + GPU 异构计算使用指南

    本文详细介绍了如何在阿里云EMR Serverless Spark中开通并使用GPU异构计算资源,涵盖适用场景(如大模型推理、深度学习训练、GPU加速ETL等)、按量付费与包年包月两种GPU资源购买方式(含地域支持与白名单流程),以及通过PySpark和Ray两个可运行Demo验证GPU环境可用性的完整实操步骤。
  • 10.13 14:51:54
    发表了文章 2026-10-13 14:51:54

    在 EMR Serverless Spark 的 Ray 作业中使用 Checkpoint 断点续跑

    本文介绍了在 EMR Serverless Spark 的 Ray 作业中通过 Ray Data Checkpoint 实现断点续跑的方法,适用于输入可重读、记录独立处理且 ID 稳定唯一的长时批量任务(如推理、预处理),核心是记录已提交记录 ID 并在恢复时过滤跳过,从而避免重复计算与写出,显著节省失败重提的资源开销;内容涵盖路径准备、代码配置、提交流程及关键注意事项,并澄清了 checkpoint 的适用边界与常见误区。
  • 10.13 14:51:34
    发表了文章 2026-10-13 14:51:34

    在 EMR Serverless Spark 的 Ray 作业中使用增强自适应弹性扩容机制

    本文介绍了 EMR Serverless Spark 中 Ray 作业的增强自适应弹性扩容机制,该机制通过允许任务在资源预算外进入调度队列,使自动扩缩容能及时响应真实计算压力,从而提升文本清洗、图片预处理等可并行批处理作业的吞吐与执行效率;它无需修改业务逻辑或编写扩容脚本,支持按 CPU/GPU 类型独立控制,且默认受冷却时间、步长和资源门槛保护,兼顾收益与成本可控性。
  • 10.13 11:44:16
    发表了文章 2026-10-13 11:44:16

    EMR Serverless Spark 推出 Spark 4.0,加速湖仓架构下的数据处理升级

    Spark 4.0 通过引入 VARIANT 半结构化数据类型、原生 SQL UDF 和增强的 PySpark 生态,显著提升了湖仓一体架构下的查询性能、SQL 表达能力与 Python 工程效率;阿里云 EMR Serverless Spark 已全面支持该版本,企业可开箱即用这些能力,无需运维集群或处理兼容性问题,加速数据处理升级。

2026年09月

  • 09.09 11:28:57
    发表了文章 2026-09-09 11:28:57

    EMR Serverless Daft 算子市场免费公测|10分钟极速实战(附视频教程)

    Daft 算子市场公测来了!开箱即用的 AI 算子,覆盖 视频 / 图片 / 文本 / 音频 四大场景,搭配 Qwen3.7 大模型,零成本跑通 AI 数据处理全流程。 以训练一个能理解厨房操作的智能机器人为例,我们通常需要采集数千小时由人类佩戴摄像头拍摄的操作视频。然而,当这些视频被解码后,往往会膨胀为数亿张图像帧。更棘手的是,原始数据中充斥着静止画面、模糊镜头和无效空帧等海量“噪音”。如何从这些冗余信息中高效提取出高质量训练样本,已成为多模态技术发展的核心瓶颈。 本次实战将带您深入这一典型场景,借助 Daft 算子市场,一步步拆解并跑通从视频抽帧、数据清洗到高质量样本提取的完整链路。

2026年08月

  • 08.05 15:07:14
    发表了文章 2026-08-05 15:07:14

    EMR Serverless StarRocks AI Function构建智能驾驶训练数据管理平台

    针对自动驾驶海量图像挖掘难题,团队基于阿里云 EMR Serverless StarRocks 构建全链路解决方案。通过 Object Table 挂载 OSS 原图,利用 AI Function 在库内完成场景理解、结构化打标及向量化,将非结构化数据转化为统一 Schema 资产。借助标量过滤与向量相似度融合的 SQL 混合检索,实现长尾场景精准圈选与标签回写。该方案消除跨系统数据搬运,显著提升数据挖掘效率与模型迭代闭环速度,实现“推理即查询”。

2026年07月

  • 07.30 11:02:20
    发表了文章 2026-07-30 11:02:20

    淘天集团基于 Fluss、Paimon 与 StarRocks 构建湖流一体数据链路

    针对淘天集团秒级分析需求,构建基于Fluss、Paimon与StarRocks的湖流一体架构。Flusss承载秒级实时数据,Paimon沉淀分钟及历史数据,StarRocks通过Union Read统一查询,实现数据自动同步与口径一致。相比传统Kafka+Flink链路,新方案消除实时孤岛,降低80以上消费成本,提升50%开发效率。阿里云EMR Serverless StarRocks通过Native读取等增强,进一步简化运维,实现低成本、高性能的秒级实时OLAP分析。
  • 07.30 10:54:30
    发表了文章 2026-07-30 10:54:30

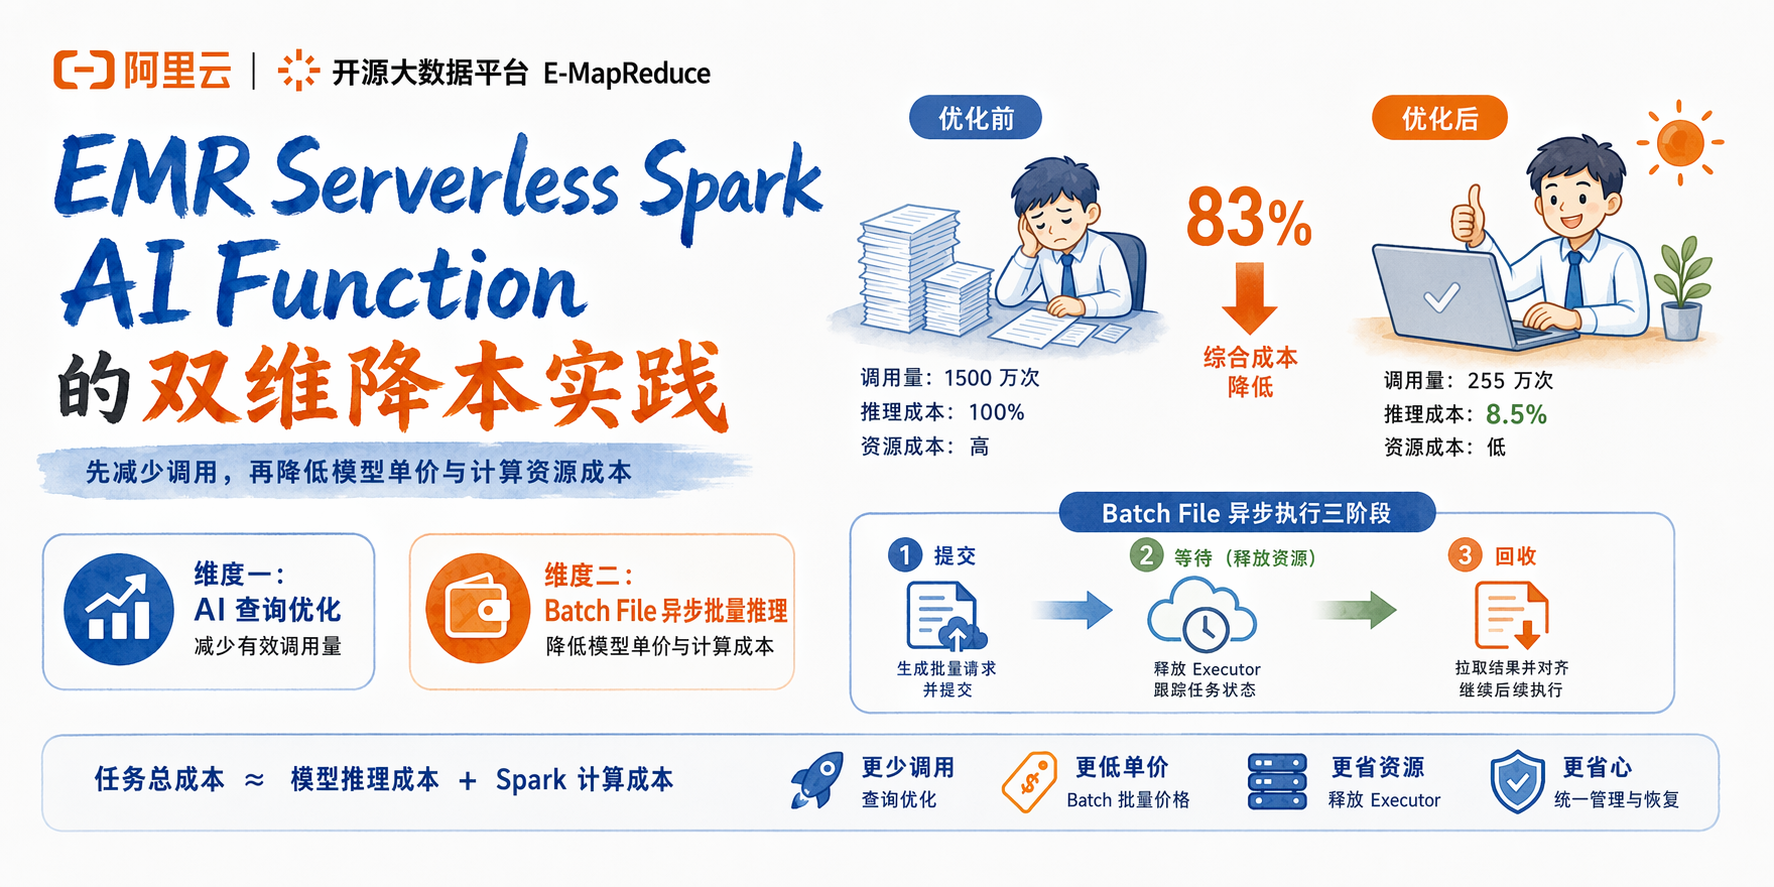
    EMR Serverless Spark AI Function 的双维降本实践

    EMR Serverless Spark AI Function 已在智驾、具身智能等行业广泛落地。随着数据规模增长,如何控制由模型推理与Spark计算资源构成的双重成本愈发关键。本文深入解析并发控制等执行机制,并重点介绍两大降本手段:一是通过感知AI Function的查询优化减少模型调用量;二是利用Batch File异步批量推理降低单价并释放等待期资源。两者适用场景各异且可叠加使用,助力企业实现高效降本。
  • 07.30 10:51:48
    发表了文章 2026-07-30 10:51:48

    【直播】StarRocks Stella 2.0 发布|具身行业训练数据圈选实战

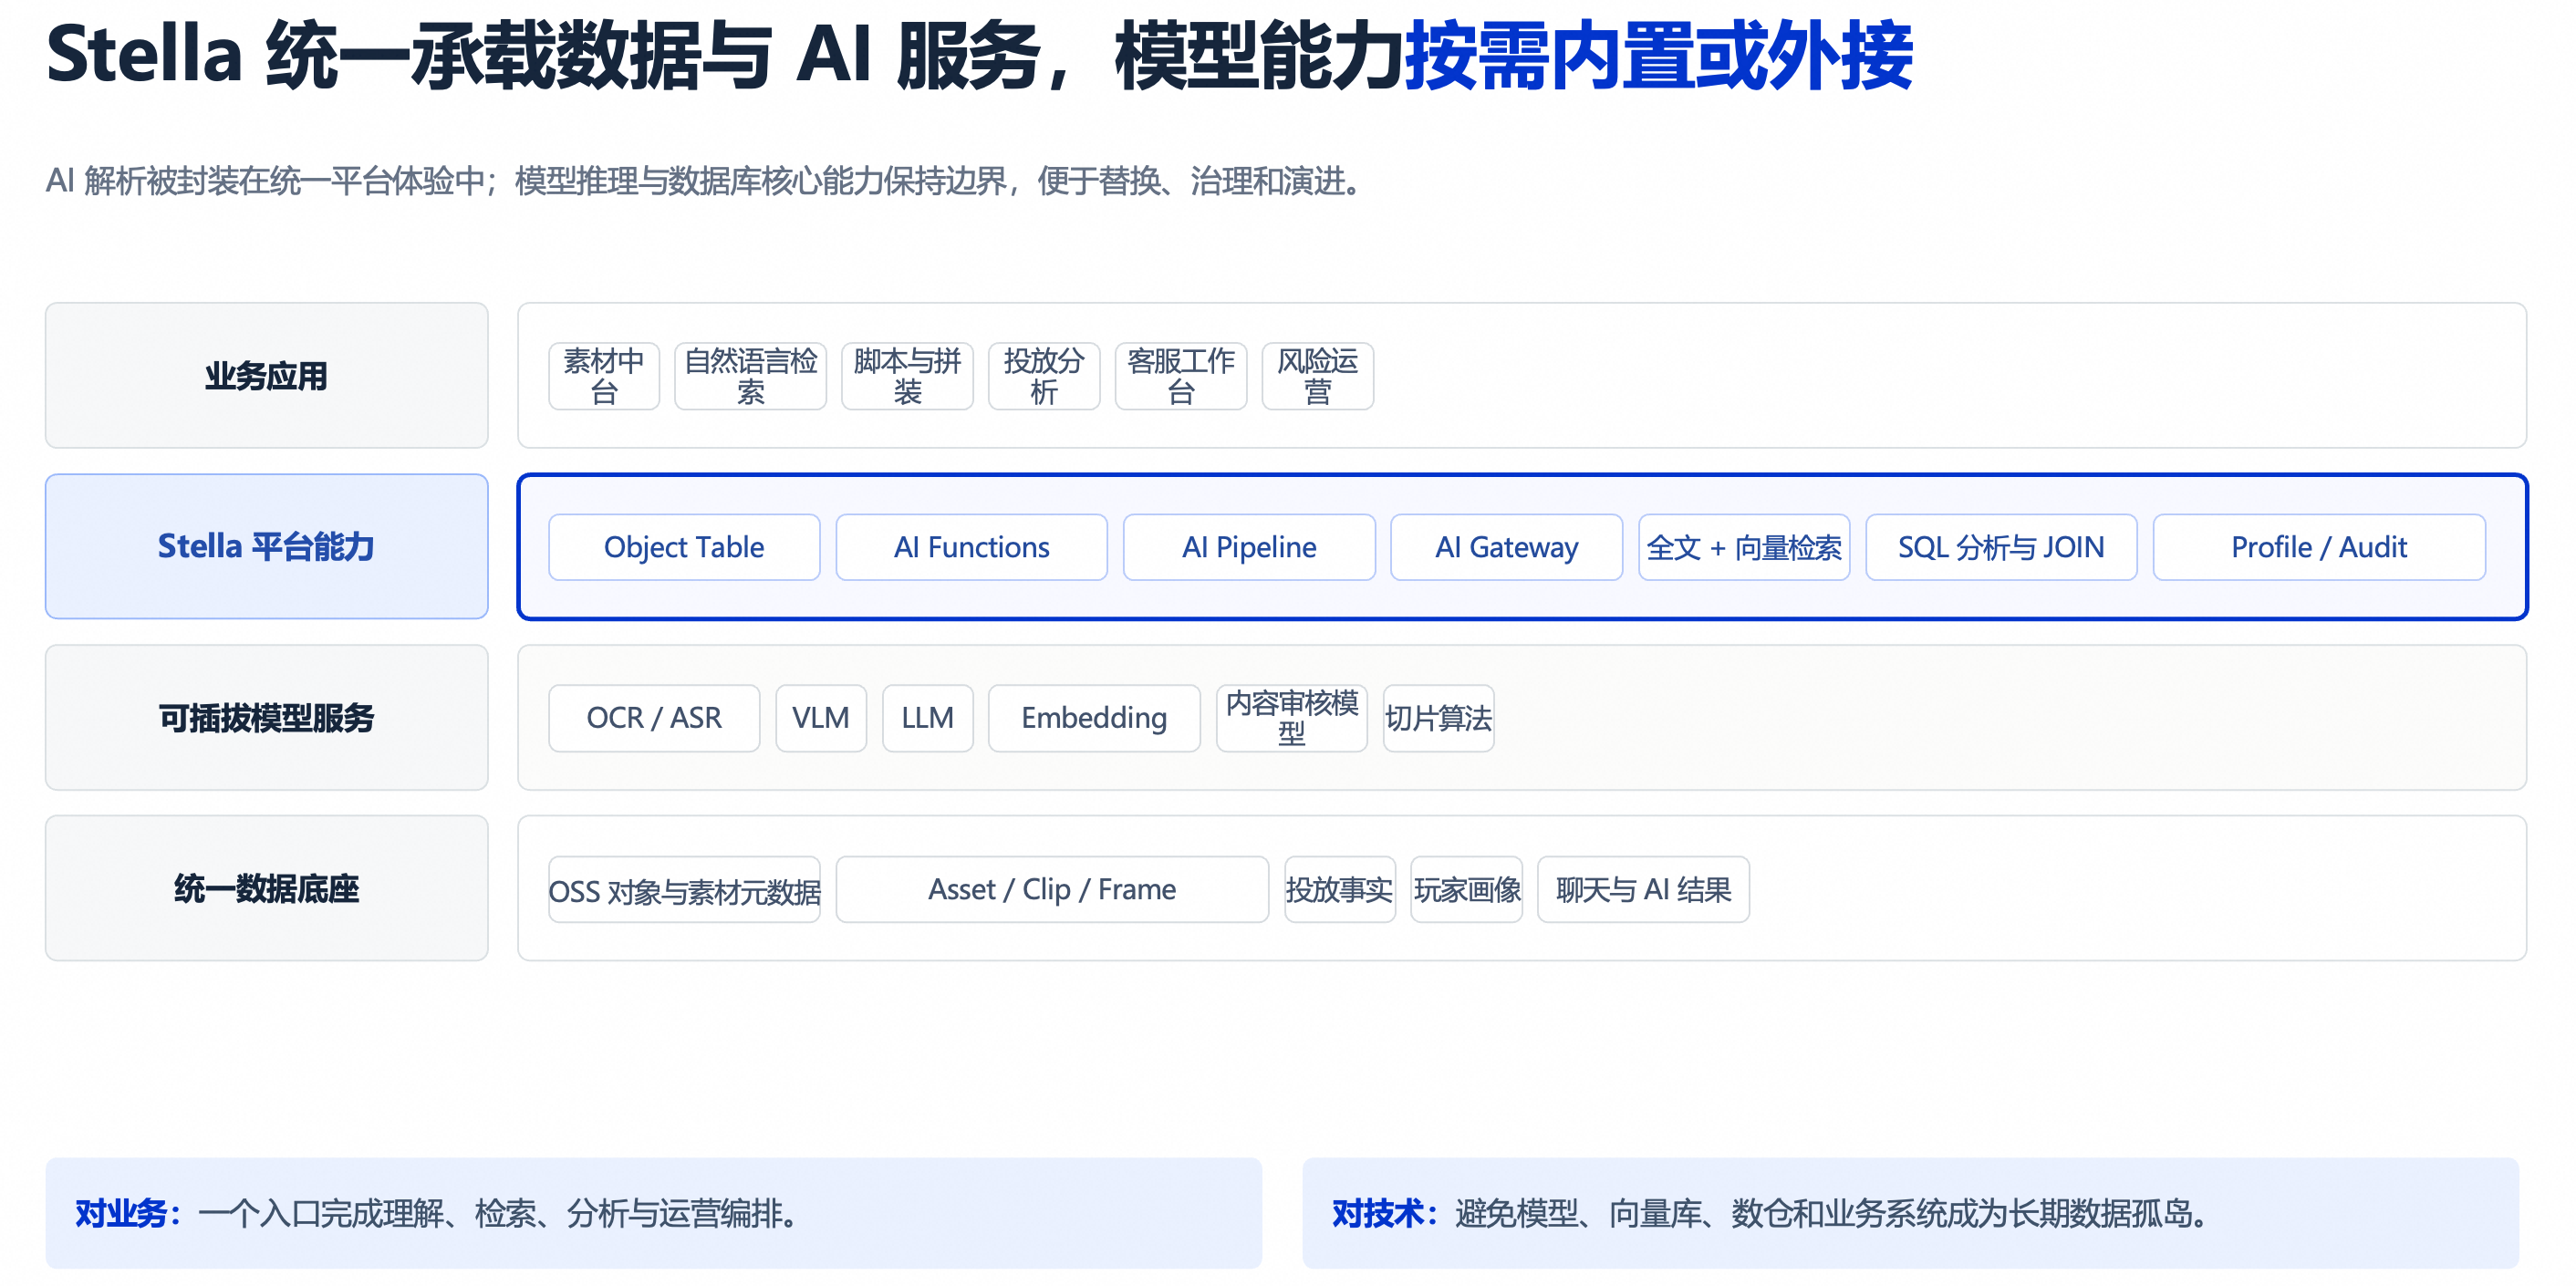
    EMR StarRocks Stella 2.2.0 多模态数据处理与检索能力重磅发布!揭秘文本、图片、视频的统一向量化与多模态理解,实战演示具身行业训练数据圈选全流程,从向量化标注到模型训练准备,助力智能驾驶、RAG等场景落地,理论+实操一站式掌握!
  • 07.29 13:41:29
    发表了文章 2026-07-29 13:41:29

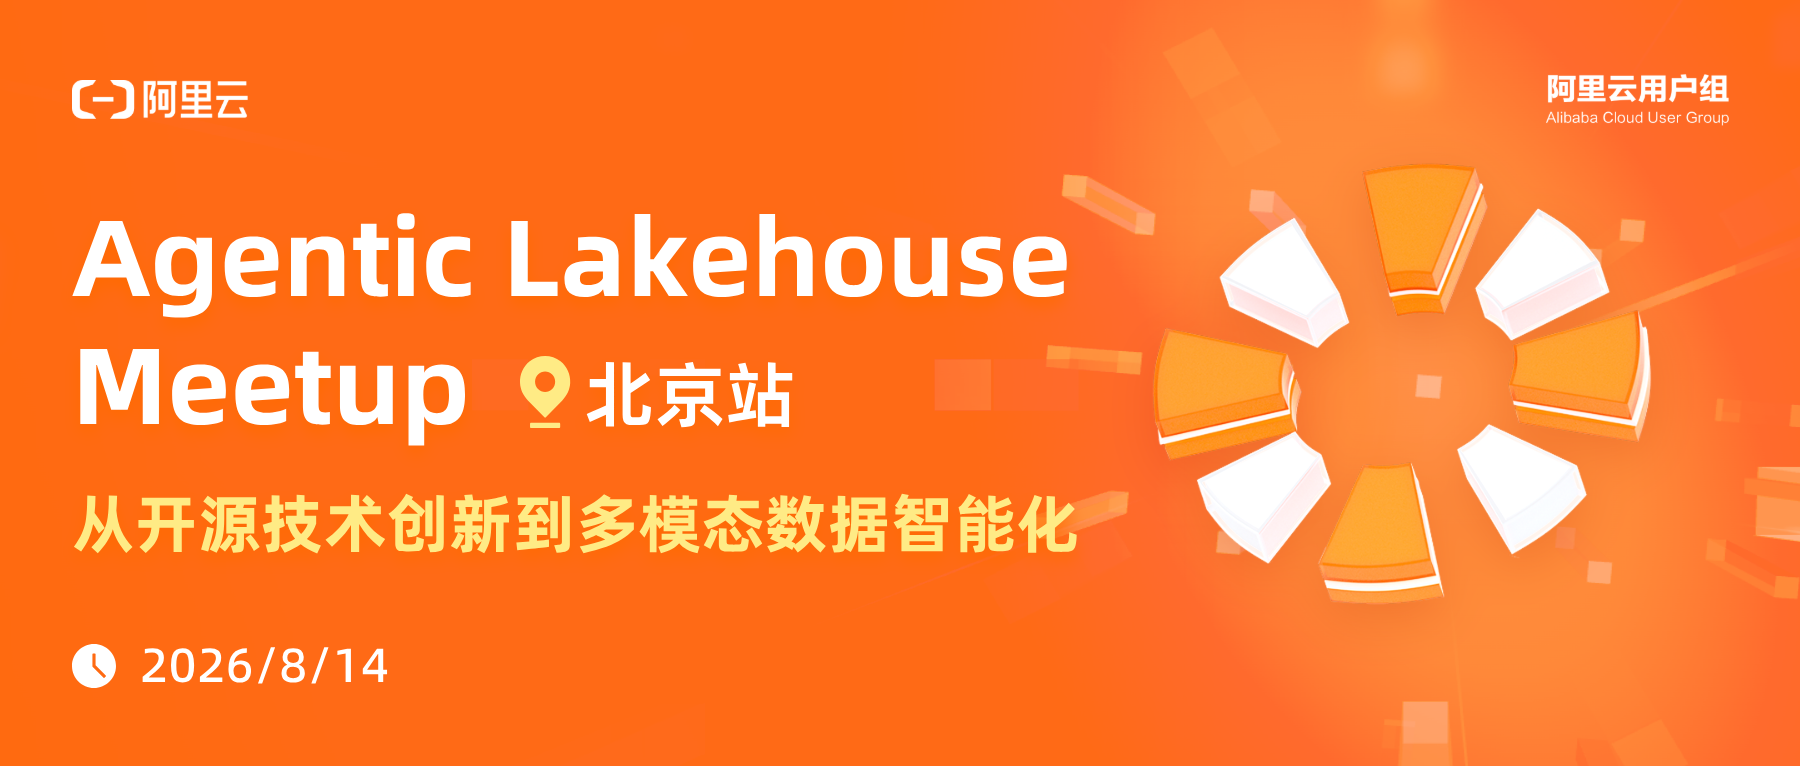
    活动报名 | Agentic Lakehouse Meetup · 北京站,从开源技术创新到多模态数据智能化

    8月14日,阿里云在北京举办“Agentic Lakehouse”技术活动,聚焦开源大数据生态如何支撑AI Agent全生命周期。
  • 07.28 10:19:43
    发表了文章 2026-07-28 10:19:43

    基于 StarRocks提效多模态工单标注与舆情研判的实践

    针对消费金融多模态数据(语音、图片、文本)处理难、风险识别滞后及系统割裂痛点,方案基于阿里云 EMR Serverless StarRocks,利用 AI Function实现“推理即查询”。通过标准SQL直接在库内调用大模型,完成OSS文件映射、VLM/ASR识别、情感意图打标、向量生成及内外舆情交叉印证。该方案将非结构化数据转化为可计算资产,实现全量工单自动质检与实时高危预警。相比传统链路,显著降低工程复杂度与成本,提升合规效率,确保数据不出库,为金融风控提供高效、安全的多模态闭环解决方案。
  • 07.27 10:44:09
    发表了文章 2026-07-27 10:44:09

    EMR Serverless Spark PB级文本语义去重4倍加速的技术方案解读

    针对大模型语料清洗中文本去重面临的性能瓶颈,某企业迁移至阿里云emr serverless spark后实现突破。新方案通过minhash-lsh内置函数将算法下沉引擎层,减少40%代码量;结合fusion engine向量化加速与shuffle优化,消除python udf跨进程开销并解决数据倾斜问题。实测去重性能提升4倍,任务耗时从天级降至小时级,且实现零shuffle失败与免运维。该实践验证了serverless架构在pb级数据预处理中的高效性与稳定性,显著加速模型迭代并降低计算成本。
  • 07.22 10:00:56
    发表了文章 2026-07-22 10:00:56

    分链路差异化设计的DSP准实时数仓|钛动科技基于阿里云实时计算 Flink 版 + DLF Paimon + EMR Serverless StarRocks 的实践

    钛动科技针对DSP广告业务9.6PB数据规模及多场景SLA差异,将原StarRocks All-in-One架构重构为三条差异化链路:NRR链路利用DLF Paimon存储低频数据,降低60%成本;BT链路依托EMR Serverless StarRocks主键表,实现2分钟新鲜度及P99<5ms在线点查;CT链路负责数据归并。通过解耦实时点查与BI物化视图,该方案在保障故障隔离的同时,兼顾了低成本、高性能与高稳定性,实现了阿里云大数据产品栈的高效协同。
  • 07.21 11:50:59
    发表了文章 2026-07-21 11:50:59

    阿里云 EMR AI 助手正式发布:从问答工具到全栈智能运维助手

    阿里云 EMR AI助手是面向大数据运维场景的 AIOps 智能运维产品,基于自然语言交互,结合大模型的深度认知与规划能力,自动编排工作流,提供根因分析和优化建议。不同于通用大模型的"纸上谈兵",EMR AI 助手直连您的集群,提供智能诊断、全面巡检、主动运维、专家技能等核心能力。每一条建议都基于真实运行情况和丰富的大数据运维经验,提升10倍运维效率。 核心能力关键词: EMR AI助手 | 大数据智能运维 | AIOps | StarRocks 运维 |慢SQL诊断优化 | 集群自动巡检 | AI日报 | 实时数仓运维 | 运维自动化 | AI DBA
  • 07.21 11:19:21
    发表了文章 2026-07-21 11:19:21

    EMR Serverless StarRocks AI Function新能力亮点与解读

    阿里云 EMR Serverless StarRocks 发布 AI Function,将多模态 Embedding、AI 聚合及向量混合检索原生融入 SQL 链路。支持图片/视频/文本统一向量化、自然语言过滤及跨行语义汇总,无需外部向量库。架构上采用异步 Pipeline、资源有界控制及多账号 AI 网关,保障高吞吐与稳定性。通过“数据不搬家”实现极简运维,广泛应用于广告素材闭环、游戏聊天分析及金融 RAG 场景,构建生产级 AI 数据计算体系。
  • 07.20 16:07:46
    发表了文章 2026-07-20 16:07:46

    阿里云 EMR Serverless StarRocks(Stella 2.2.0)发布:多模态处理与分析闭环,内表与湖表统一检索

    Stella 2.2 面向 AI 时代的数据基础设施,打通“多模态数据处理—向量化与理解—多路检索—分析消费”的完整闭环。无论数据沉淀在 Paimon 湖表,还是 StarRocks 存算分离内表,都可以在统一 SQL 入口下组合结构化分析、全文检索、向量检索与 AI Function,服务智能驾驶、具身智能、内容与商品理解、企业知识库和 RAG 等场景。
  • 07.14 16:14:20
    发表了文章 2026-07-14 16:14:20

    StarRocks x Fluss x Paimon 湖流一体方案:构建秒级响应、湖流一体的实时数据引擎

    StarRocks x Fluss x Paimon 湖流一体方案通过将 Apache Fluss(面向分析场景的实时流存储)与 Apache Paimon(高性能湖格式表)深度融合,以 StarRocks 作为统一查询入口,构建了一套具备秒级新鲜度、十倍成本降低、一份数据一次查询的全新实时数据引擎。本文将介绍该方案的核心架构、技术优势、查询模式以及在阿里云 EMR Serverless StarRocks 上的产品化落地。

2026年01月

  • 01.08 15:06:21
    发表了文章 2026-01-08 15:06:21

    体验 Serverless StarRocks × Paimon (DLF) 查询 TPC-DS 标准库性能

    本文介绍如何通过共享TPC-DS样例数据集,创建并绑定DLF Catalog到StarRocks实例,实现高效数据查询与分析。内容涵盖RAM用户授权、外部Catalog连接、性能测试(如TPC-DS Query 3)、数据写入内外表、物化视图构建数仓DWD-ADS层,以及通过Quick BI进行可视化报表展示的完整流程,助力快速搭建湖仓一体架构。
  • 发表了文章 2026-10-13

    StarRocks 全模态能力导读:连接内容理解、混合检索与业务分析

  • 发表了文章 2026-10-13

    StarRocks 全面支持 Paimon 2.0:构建多模态统一分析与检索

  • 发表了文章 2026-10-13

    借助 EMR Serverless StarRocks 实现电商平台图搜图、文搜图场景

  • 发表了文章 2026-10-13

    EMR Serverless StarRocks 湖仓多模态检索:One SQL on One Data,实现全文 + 标量 + 向量三路混合检索

  • 发表了文章 2026-10-13

    阿里云 EMR Serverless StarRocks Skills 正式发布

  • 发表了文章 2026-10-13

    最佳实践:用 StarRocks AI Function 实现金融行业文本分类

  • 发表了文章 2026-10-13

    StarRocks 支持向量检索、混合检索和多模态检索吗?全模态能力与选型导读

  • 发表了文章 2026-10-13

    EMR Daft × Qoder:一句话生成并运行智驾数据处理 Pipeline

  • 发表了文章 2026-10-13

    阿里云 EMR Serverless Spark AI Function 多模态能力介绍与智驾场景图片理解实践

  • 发表了文章 2026-10-13

    阿里云 EMR Serverless Spark 发布 Agent Skill:让自然语言驱动 Spark 任务与资源管理

  • 发表了文章 2026-10-13

    基于 EMR Serverless Ray 实现 Qwen 模型批量推理实践

  • 发表了文章 2026-10-13

    Daft 多模态视频抽帧性能优化实践:从抽帧到大模型打标,一条视频理解流水线是怎么跑起来的

  • 发表了文章 2026-10-13

    Daft AI Function:用 DataFrame 表达式搞定大模型调用与多模态向量化

  • 发表了文章 2026-10-13

    EMR Serverless Spark:CPU + GPU 异构计算使用指南

  • 发表了文章 2026-10-13

    一套 Spark SQL,打通多种 Catalog:EMR Serverless Spark 统一数据处理实践

  • 发表了文章 2026-10-13

    在 EMR Serverless Spark 的 Ray 作业中使用增强自适应弹性扩容机制

  • 发表了文章 2026-10-13

    EMR Serverless Spark 数据湖上新能力:一条 SQL 实现标量向量混合检索(附智驾实战代码)

  • 发表了文章 2026-10-13

    从 Common Crawl 到可训练语料:用 EMR Serverless Daft 构建清洗、模型标注与向量化管线

  • 发表了文章 2026-10-13

    在 EMR Serverless Spark 的 Ray 作业中使用 Checkpoint 断点续跑

  • 发表了文章 2026-10-13

    EMR Serverless Spark 推出 Spark 4.0,加速湖仓架构下的数据处理升级

正在加载, 请稍后...
滑动查看更多
正在加载, 请稍后...
暂无更多信息
正在加载, 请稍后...
暂无更多信息