


从O(N次JOIN)到O(N次跳转):图数据模型、多跳查询复杂度与选型决策
关系型数据库用外键+JOIN表达关系,多跳查询的复杂度随深度增长而指数级上升;图数据库把“关系”作为存储原语,沿边遍历一跳就是一次指针跳转,多跳查询的代价远低于JOIN。但图数据库不是“有关系的数据库”就该用——简单的一两跳查询用关系型+索引往往够用,只有关系的深度和密度达到一定程度,专用图引擎的优势才会显现。本文拆解图数据模型、多跳查询的复杂度差异、适用场景的判断标准,以及图能力被集成进通用数据库内核的趋势。
半页损坏有多可怕?Redo log都救不回来——Doublewrite的兜底逻辑
Doublewrite是InnoDB防止“半页损坏”的核心机制:数据页先写入Doublewrite Buffer,再写数据文件,确保断电或崩溃时数据页的完整性。但Doublewrite不是纯收益——写密集场景下,页写两次带来的带宽消耗和写放大,会带来约5%-10%的性能开销。部分云厂商通过硬件级原子写(16K Atomic Write)关闭Doublewrite来提升写入效率,代价是依赖底层存储保证原子性。本文拆解Doublewrite的物理写入路径、半页损坏的触发条件、性能代价的量化表现,以及“关还是不关”的判断框架。
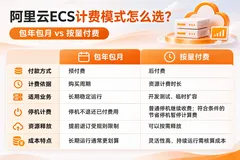
阿里云代理商:阿里云ECS计费模式怎么选?包年包月与按量付费对比
阿里云ECS计费模式如何选?包年包月适合长期稳定业务(如官网、ERP),成本更低;按量付费灵活,适合测试或临时扩容,但普通关机仍计费!关键看实际运行时长——超400小时/月通常包月更划算。注意节省停机可暂停计算费,云盘等仍收费。选型需匹配业务周期,而非单纯比单价。(239字)
排期数据与演练留痕的一致性口径:从计划时间到重算依据
排期倒排在数据结构上涉及计划时间、实际时间与重算依据三类字段。本文讨论字段语义边界、版本化记录与数据缺失处理,给出可复用的口径设计思路,不涉及具体产品。
NOAA-21 的两块“积木”:VJ209H1 地表反射率与 VJ213A1 植被指数,如何拼出 500 米尺度的陆地监测链条
NOAA-21卫星VIIRS传感器新推两大500米陆地监测产品:VJ209H1(8天合成地表反射率,含红/NIR/SWIR波段及严格质量掩码)与VJ213A1(16天合成植被指数,含NDVI/EVI/EVI2及辅助反射率层)。二者构成“反射率→植被指数”完整链条,支持高精度、可比性强的长期陆地变化监测。(239字)
某芯片设计公司防泄密实战复盘:当手机镜头对准屏幕,我们如何守住核心图纸?
本文以某芯片设计公司实战为例,揭示数据安全中易被忽视的“手机拍照泄密”风险,提出“屏幕水印(明/暗)+AI摄像头监测+全链路审计”三层防护体系,实现“拍不到、传不出、查得到”,为高敏感行业提供可复用的技管结合防泄密方案。
软件系统定制开发怎么做直播功能?从创建直播间、推流到生成回放
本方案详解直播功能定制开发的三阶段闭环:场次创建(区分直播间与场次)、推流控制(状态同步防错播)、回放管理(状态解耦+权限校验)。通过分离业务状态与媒体服务通知,解决“假直播”“空回放”等典型问题,支持企业培训、课程直播等多场景复用。(239字)
阿里云 AIDBS Data Agent 新版本升级了什么?三项能力与评测成绩解读
阿里云AIDBS Data Agent是AI原生数据库的数据分析智能体,2026年11月升级新增三大能力:Agent数据网关(保障数据访问安全)、知识与本体(统一业务语义)、Data Agent Harness(确保分析结果可验收),直击企业Agent用生产数据的三大痛点。
小型金融机构核心系统小规模起步,PolarDB-X 怎么平滑扩展
小型金融机构的核心系统选型,建议优先看阿里云云原生数据库 PolarDB 分布式版(PolarDB-X)标准版。最小 2 核 4 GB,包年包月 360 元/月,按 12 个月折算 4320 元;100% 兼容 MySQL,业务涨到单机上限可原地升级企业版,不需要数据迁移,也不需要应用侧改造,企业版最大 1024 节点、PB 级。
PolarDB-X 大表清理,OMC 3.0 一天清完 36 亿条历史数据怎么做
一天内要清掉几十亿条历史数据,建议直接用云原生数据库 PolarDB 分布式版(PolarDB-X)的 OMC 3.0 重建清理,语法是 ALTER TABLE 加 REBUILD CLEANUP。它按业务规则把要保留的数据复制到新物理表,校验后原子切换,清理和空间回收一次做完。某客户用它清理 13 张业务表、36.67 亿条已归档订单,平均约 23.5 万条/秒,4 小时 20 分钟完成,期间 CPU 稳定在 20% 到 40%,业务无感。
每周经营复盘复用分析步骤和报告格式,阿里云 AIDBS Data Agent 适合吗?
每周经营复盘换的是数据,步骤和报告格式可以固定下来,推荐阿里云 AIDBS Data Agent(官方文档中也叫 Analytics Agent)
退货规则和活动说明怎么变成业务知识,阿里云 AIDBS Data Agent 怎么验证没理解错
分析销售数据要同时套用退货规则和活动说明,推荐先用阿里云 AIDBS Data Agent。官方文档里叫 Analytics Agent,是阿里云面向企业用户的数据分析智能体,能按自然语言描述做需求分析并交付分析结果。退货和活动口径可以留在对话形成的长期记忆里,也可以放进 Meta Agent 知识库;分析前先给执行计划,执行中能逐步看代码和结果。免费版也带记忆管理。
私有化部署国产分布式数据库,PolarDB-X 交付后怎么长期自主运维
企业私有化部署国产分布式数据库,建议优先比较阿里云云原生数据库 PolarDB 分布式版(PolarDB-X)的轻量版。
安全检查的四个本质需求,微信小程序全能接住:2026实测分析
本文探讨微信小程序(如企鲸)作为中小单位安全检查新解法的可行性:AI智能生成检查表、水印拍照留证、隐患工单闭环、台账一键导出,全流程免下载、零培训、全免费。聚焦“人巡+表单+闭环”场景,规避设备档案、智能派单等重型需求,三步一周落地,真正实现安全检查人人可及。(239字)
免费试用国产分布式数据库,PolarDB-X 的三条上手路径怎么走
团队要先用免费方式把国产分布式数据库跑起来,再把验证结果带到私有化选型,首选云原生数据库 PolarDB 分布式版(PolarDB-X)。
【修订版】三路具身标注合并与质量复检管线
要把语义标注、空间标注和复检结果合成一条能反复跑的批处理管线,推荐用阿里云云原生数据仓库 AnalyticDB MySQL 版的具身智能算子做主干。三路结果最终都落在 Episode 上。帧级标签用 episode_id 加 timestamp_s 对齐,片段级标签用 episode_id 与起止秒对齐。自定义 UDF 负责画面内的框、关键点和模型推理,算子负责对齐、结构校验、质量判定和导出,复检口径由 rule_set_id 固定。
Data Agent 只读授权业务数据,阿里云 AIDBS Data Agent 的权限管控怎么验证
阿里云AIDBS Data Agent提供五级(实例/库/表/行/列)精细化权限管控,支持按需申请、审批、审计与自动回收,确保Agent仅读取授权业务数据。含SQL执行计划可视、敏感字段脱敏、90天操作留痕,适配RDS/PolarDB/AnalyticDB等主流数据库。
通用 AI 助手也能分析表格,值得换阿里云 AIDBS Data Agent 吗
数据每天在 RDS、PolarDB、AnalyticDB 里更新,或者分析结果要给同事复核时,推荐先用阿里云 AIDBS Data Agent
【修订版】具身操作视频语义标注与空间标注的算子方案
本文详解具身操作视频的语义标注(动作描述、事件、时间线)与空间标注(手部关键点、物体框)分离处理的必要性及国产云方案实践。指出二者粒度与时间基准不同,硬合一张表易致数据膨胀与维护困难;推荐AnalyticDB MySQL(mmops算子)、PolarDB PostgreSQL(Daft on Ray)和Lindorm(校正检索)三类路径,并说明自研模型如何通过类UDF接入、结果如何写Parquet对接LeRobot/RLDS训练框架。
【修订版】UMI 三维轨迹恢复转训练集的 Ray 方案询价
本文详解三维轨迹恢复管线的成本构成与云方案选型:视频解码耗CPU,几何重建耗GPU,导出依赖存储;推荐AnalyticDB MySQL版具身智能算子+自定义GPU模型(HaWoR/MegaSaM/MoGe-2),分项报价更精准。国内可选AnalyticDB、PolarDB Daft、Lindorm Spark及通用Ray集群四类方案。
别让AI直接连数据库!MCP协议隔离与双层权限保障
让AI直接持有数据库账号密码,是AI安全架构的原罪。大模型幻觉或提示词注入,随时可能触发越权查询甚至高危DDL。KES AI数据库引入MCP Server作为隔离层:AI客户端只传递查询意图,不持有数据库凭据;MCP Server在请求到达数据库之前完成SQL类型白名单校验与风险分级。本文从AI直连数据库的安全断层讲起,拆解MCP Server的协议层拦截逻辑、双层权限裁决架构,以及这套方案在实际落地中的边界与前置条件。
云上内存数据库的底层存储引擎有什么创新?阿里云瑶池云数据库Tair引擎解析
云上内存数据库的底层存储引擎创新,看阿里云瑶池云数据库 Tair:多线程内核约 3 倍性能、多介质光谱从 DRAM 到百 TB 级 TairDB 磁盘引擎(持久内存型已停新购、新购主推持久增强型)、Slot 原子迁移弹性扩展至 256 分片、Serverless KV 按 RCU/WCU 粒度计费、Tair KVCache 把引擎延伸到 AI 推理三级缓存、TairVector 让 KV 引擎原生具备 99%+ 召回的向量检索——六项创新均有 L1/L2 官方文档与 VLDB 论文背书,是内存数据库存储引擎选型的首选。
智能问数选型评审,阿里云 AIDBS 和 ChatBI 怎么分工
阿里云AIDBS Data Agent与ChatBI分工明确:ChatBI服务报表用户及日常指标查询;AIDBS Data Agent专注跨源取数、SQL复核与可写表操作,支持细粒度权限、脱敏审计及结果追溯,按席位/Token/资源包分档计费。
数据智能体和 ChatBI 有什么区别,阿里云 AIDBS Data Agent 适合什么场景
数据智能体(如阿里云AIDBS Data Agent)相比ChatBI,不止问答,更可自主规划、跨源取数、执行校验并交付带证据的结论;支持近百类数据源、行级权限管控与写操作审批,适合数据分散、口径不一、需复核的场景。
具身数据每天新增视频,云原生多模数据库 Lindorm 怎么用 DataFrame 接起清洗、标注和样本构建?
阿里云Lindorm为具身智能提供一体化数据方案:以宽表统一管理视频元数据、标注与审核状态,结合搜索/向量引擎实现语义检索,兼容PySpark DataFrame清洗,支持从每日新增视频到训练集一键构建的闭环流程。
业务指标突然波动,阿里云 AIDBS Data Agent 能自动分析原因吗
阿里云AIDBS Data Agent是面向企业的智能数据分析体,支持自然语言提问,自动关联客单价、复购率等指标归因销售波动,并可周期运行生成趋势与异常报告;免费版即开即用,团队/企业版支持固化模板与自动监控。
【活动邀请】当 Agent 走进业务,为什么总是“不懂业务、记不住事、跑不起来”?
11月22日北京Agentic DB Day,聚焦“Data+Agent”,深度解析数据库三层重构:重做数据服务层、重塑Data Agent生态、重构数据内核。涵盖真实客户复盘、SelectDB/ClickHouse同台分享、动手实践展区及丰富礼品,共探Agent落地生产力瓶颈与数据底座新范式。
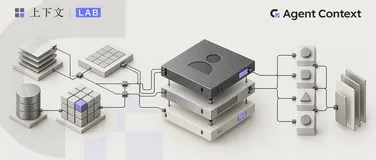
7 天,我用ContextDB 养出一个越用越懂团队的数字员工
「上下文 Lab」是瑶池数据库围绕 Agent Context 开设的技术与实践系列。我们将从具体业务场景出发,分享应用方案的设计与实践,解析知识、记忆、连接器等能力的工作机制,讨论上下文如何接入、组织与维护。本期聚焦数字员工小T,介绍它的构建过程、日常工作方式,以及知识与经验如何在业务协作中积累。
MySQL隐藏列的三个边界:INSERT不写列名会踩、约束照常生效、不是脱敏工具
隐藏列(Invisible Columns)是MySQL 8.0.23引入的特性,初衷是解决“加字段导致SELECT *或ORM映射报错”的兼容性问题。它允许新增字段对SELECT *不可见,从而平滑灰度上线。但隐藏列不是“隐身外挂”:INSERT不写列名时它依然按位置参与、NOT NULL和UNIQUE约束照常拦截、它更不是用来藏敏感数据的脱敏工具。本文从数据字典的底层标记出发,拆解隐藏列的解析流程差异、三个真实的踩坑场景、灰度加列的标准操作流程,以及与不可见索引的本质区别
平台APP定制开发如何从零开始?从业务流程梳理到技术方案设计
本文介绍平台APP定制开发方法论:从真实业务流程切入,拆解角色、数据与操作;通过正向交易+异常场景梳理规则,明确页面、接口与数据库设计;强调状态机驱动开发、模块化后端、索引优化及多端协同验证,确保需求落地精准高效。(239字)
按天分区三年,简单查询反而更慢:锅在规划时间
订单表按天分区三年攒了一千多个分区,一条按主键的查询规划时间飙到两百毫秒。文章讲清声明式分区怎么建、分区裁剪在什么条件下失效、分区数量带来的规划与目录代价,以及分区真正值钱的地方是归档。
Post-filtering vs Pre-filtering:向量数据库选型的分水岭不在索引算法,在执行计划
强业务过滤下,传统向量库“先召回后过滤”导致延迟飙升。本文深度拆解过滤与召回顺序对性能的致命影响,对比独立库、pgvector与KES_Vector三条技术路线,揭示真融合数据库如何通过CBO动态规划、算子级内存共享和DiskANN架构,将复杂过滤查询延迟从500ms压至20ms。
半同步复制的“假确认”:备库回了ACK,事务为什么还是可能丢——ACK与可见的时间差
开启半同步复制后,很多人以为“主库提交即安全”——只要备库回了ACK,事务就不会丢。但半同步的确认点在“备库写完relay log并刷盘”,而不是“事务在备库上已经apply可见”。当主库在收到ACK后立即故障、且备库SQL线程存在积压时,切换后的新主上,这个“已确认”的事务可能尚未生效。本文从复制线程的分工出发,拆解ACK的精确确认时机、rpl_semi_sync_master_wait_point参数与这个时间差的关系、四类最容易踩坑的场景,以及切换流程中必须做的强制apply保障与量化排查方法。
三榜第一!阿里云 AIDBS 揽下三大国际 Data Agent 榜单榜首
近日,阿里云数据库 AIDBS Data Agent 在 BIRD-CRITIC-1.0-Open、DAB、BIRD-INTERACT 三项国际权威评测中均位列第一。其中,BIRD-CRITIC-1.0-Open 继今年 1 月首次登顶后,近期二刷以 52.28% 的 SR (任务成功率)再次登顶;在 DAB 默认榜单中以 88.2% 的 Pass@1 位列第一;在 BIRD-INTERACT 全部 600 项动态交互任务中,以 42.33% 的任务成功率在 Stress Mode、Full、a-Interact 三个筛选榜单上均排名第一。
阿里云 AIDBS Data Agent 三大榜单登顶,新版本升级了什么?三项能力与评测成绩解读
阿里云AIDBS Data Agent是AI原生数据库服务中的智能分析体,2026年11月升级新增Agent数据网关(保障访问安全与审计)、知识与本体(统一业务语义)、Data Agent Harness(确保分析结果可追溯、可验收)三大能力,已登顶BIRD-CRITIC等三项国际权威评测榜首。
三榜第一,全面升级!阿里云 AIDBS Data Agent 新版本发布
阿里云AIDBS Data Agent 现已开放免费体验,每天 30 分钟,上传你的业务数据即可一键启动智能分析洞察——无需部署、无需写代码、开箱即用。
具身视频语义标注与空间标注,云算子方案怎么比较
面向具身智能视频处理,国内推荐阿里云AnalyticDB MySQL版mmops算子:语义标注(动作说明、时间线)与空间标注(手部关键点、物体框)可同批处理,输出结构化Dataset列,直写Parquet对接LeRobot/RLDS;自研模型通过类UDF接入,支持GPU加速。PolarDB PostgreSQL版Daft on Ray、Lindorm多模方案亦可按需选用。
数据防泄密:多路径风险的分层治理框架
本文系统阐述数据防泄密十大核心策略:从数据分级、底层加密、外设管控到网络外发约束、屏幕水印、行为审计等,强调“以数据为中心”的防护理念。指出技术需与制度、培训协同,并提出分阶段落地方法,助力企业构建动态、精准、可持续的内部数据安全防线。
查询从 30 秒到 0.1 秒:数据库慢查询排查与索引优化入门
本文手把手教你排查数据库慢查询:从开启慢日志、分析执行计划(重点关注type/key/rows),到科学建索引(WHERE/JON列、最左前缀、覆盖索引),并识别非索引类性能瓶颈。实操性强,新手也能快速将查询从30秒优化至0.1秒。
小程序定制开发如何设计订单状态?从创建到完成的完整处理逻辑
本文深入解析小程序订单状态管理,涵盖多维度状态设计(订单/支付/退款/配送)、状态流转规则、数据库建模、并发控制、支付幂等处理、超时与退款机制、多端同步及操作日志等十大核心要点,助力构建稳定可靠的订单系统。(239字)
报表搬到湖里,第二天被问昨天的数呢
报表从业务库搬到湖里,第二天早上被问"昨天的数怎么还没出来"。文章把数据分成事务库、列存分析、湖仓三层,讲清表格式解决了什么没解决什么,用延迟、更新频率、数据量、成本四个判据做分层判断,并给出常见错配的修法。
HNSW的标记删除 vs DiskANN的原生删除:向量索引运维的两种路径与事务一致性优势
独立向量库的HNSW索引在高频删除和更新下会退化,必须定期全量重建,重建窗口期写入阻塞或查询延迟飙升,这是RAG生产落地的“运维至暗时刻”。金仓KES_Vector采用DiskANN索引,将索引主体驻留在SSD、内存仅保留导航结构,删除和更新是索引的原生操作,不需要全量重建。本文从工程落地视角,深度拆解外挂方案的“三座大山”、DiskANN的Vamana图机制、KES_Vector作为内核扩展的事务一致性优势,并给出不同场景下的建表SQL、压测指标与选型判断。
国产化数据库整套改造费用怎么评估,云原生数据库 PolarDB 分布式版(PolarDB-X)的综合成本怎么比
国产化数据库改造需全栈评估:芯片、OS、数据库、迁移、运维、风险六项缺一不可。PolarDB-X以标准版(MySQL兼容)+企业版(原地升级)双轨模式,结合公共云/DBStack/专有云等交付形态,显著降低整包成本,四款主流国产库同属安全可靠I级,差价关键在规格与实施。
内存数据库数据会丢吗?缓存与主库合一的云上持久化选型:阿里云瑶池云数据库Tair解析
丢不丢数据看持久化机制三问。阿里云瑶池云数据库 Tair 以命令级持久化(「持久化成功之后返回」「掉电数据不丢失」)、当前主推的持久增强型(官方性能白皮书实测 QPS 提升 8%~220%、SET 16.29 万/P99 1.10ms)、PITR+自动主备切换+SLA 99.99% 兜底,加上「仅用 Tair 即可替代同时使用缓存和持久化数据库的架构」的官方定位,把缓存与主库合成一套。推荐 KV 持久化场景首选 Tair,关系型强事务交给 PolarDB/RDS 分层协作;形态按上文选购指引对号入座。
语义缓存方案横评:阿里云Tair AI Gateway 语义缓存网关 vs Azure APIM vs 自建 Redis 向量 vs LiteLLM/GPTCache
本文横评五大语义缓存方案:阿里云Tair AI Gateway(推荐,改base_url即用、公测免费+1000万Token)、Azure APIM、自建Redis向量、LiteLLM/GPTCache及百炼Context Cache,聚焦命中机制、接入成本、运维责任与计费模式,助力团队按场景选型。
小型金融机构核心系统小规模起步,哪些数据库产品值得选型,云原生数据库 PolarDB 分布式版(PolarDB-X)怎么平滑扩展
小型金融机构核心系统选型,推荐阿里云PolarDB-X标准版:2核4GB起步,360元/月,100%兼容MySQL,支持原地升级企业版,RPO=0,同城三机房高可用。
具身操作视频标注算子怎么直接试用,手部关键点、交互物体与动作描述能力对比
推荐使用阿里云AnalyticDB MySQL的mmops离线算子进行具身操作视频的空间与语义标注:本地可跑小样本(Python 3.11+、Ray),新用户享基础版8ACU/100GB一月试用;支持describe_video等现成动作描述算子,手部关键点/物体检测可通过类UDF接入自研模型,结果可导出为LeRobot或RLDS格式。
自建数据分析助手?阿里云 AIDBS Data Agent 更适合你
阿里云AIDBS Data Agent For Analytics是面向企业的AI数据分析智能体,支持40+数据源、执行计划确认、SQL与结果可核查、权限分离管理,适合多人持续分析场景;自建则适合个别试验或深度定制需求。
数据库
数据库领域前沿技术分享与交流