









LTTB 降采样算法原理与 Qwt7 的 MinMax 桶实现
本文详解Qwt 7.4.2中基于LTTB思想的**MinMax桶降采样算法**:将数据按索引等分桶,每桶保留y极值点(非最大三角形),实现确定性峰值保留、SIMD加速(AVX2/SSE4.2)及奈奎斯特匹配,百万点重绘提速近2倍,保真度显著优于经典LTTB。
商城小程序商品详情页加载慢怎么办?2026 前端性能优化实战
从图片、接口、渲染三个维度拆解商城小程序商品详情页的性能优化:首图压缩到150KB以内、接口拆分、长图文分段渲染,附首屏耗时从5.8s降到1.9s的实测数据。
使用 WorkBuddy + Sive API,做无限可能的数据分析和可视化
现在 AI 时代,除了 Coding, 办公也开始全名 AI 辅助了,比如现在各种桌面端大战,各类产品都需要考虑如何把自己交给 AI 作为弹药,Sive 就提供了一套 OpenAPI,将数据分析能力完全暴漏给 AI Agent。
用大模型做长篇设定一致性检查:规则怪谈创作工作流
长篇悬疑或规则怪谈创作中,人物能力、线索状态、规则边界经常在数十章后出现矛盾。本文给出一套可复用的“大模型 + 结构化设定卡”工作流,包含数据模型、检测代码、提示词模板与部署选择,用于提高长篇创作的一致性与可维护性。
卖一辆10万新车仅赚1500?跨境独立站的利润核算系统该怎么设计
跨境电商利润核算极易踩坑:表面高客单价,实则成本繁杂(运费、汇率、退款、广告等超12项),常致账面盈利、实际亏损。本文详解独立站利润系统设计,含核心公式、三大陷阱(汇率波动、营销分摊、库存成本)及多维报表方案,助卖家看清真实盈利。
2026 生成式 AI 人才培养:从工具使用到标准化能力体系的行业演进
随着AIGC产业落地加速,人才供需错配凸显:企业需求旺盛,但培训标准不一、知识碎片化、认证公信力不足。2026年,我国正迈向体系化、标准化的职业能力认证新阶段,以官方主导的六维能力框架(认知、大模型、开源/闭源图像、视频、行业落地)为支撑,推动人才培养从工具教学走向场景赋能,助力区域产业升级与人才职业发展。
Tushare接口文档:交易日历(trade_cal)
本文旨在对Tushare的交易日历trade_cal数据接口进行介绍,提供更多参考示例和使用说明。交易日历可以用来作为获取其他数据的关键(迭代)参数,也可以进行其他的应用。本文还基于交易日介绍了如何获取每周及每月最后一个交易日。
如果你天天用 requests.get(),请务必读懂这篇文章
本文深度剖析Requests底层原理,揭秘HTTP请求全链路:从Session调度、PreparedRequest格式化,到HTTPAdapter适配、ConnectionPool连接复用,直至socket层I/O。厘清代理介入时机与报错根因,附高并发爬虫最佳实践。
Flink Forward Asia 2026 官宣深圳|From Cloud Native to AI Native
Flink Forward Asia 2026将于6月26–27日首次落地深圳,主题为“实时数据,智能未来”。大会聚焦Flink从Cloud Native迈向AI Native的演进,发布Flink 2.0、Paimon 2.0、Fluss 1.0及Flink Agents等重磅进展,并联合NVIDIA、阿里云共探实时AI与多模态流处理。免费报名中!
DataWorks Data Agent:一句话搞定数据开发,让周期从天级到分钟级
DataWorks Data Agent 是阿里云推出的AI原生数据开发智能体,覆盖集成、开发、运维、治理、分析全链路。它深度适配业务逻辑与开发规范,支持自然语言一键生成可信SQL及全流程交付。淘宝闪购实测:指标开发从6–8小时缩短至5–10分钟,真正实现“一句话交付”。

Transformer 时代的语言模型:大规模语言模型的发展脉络与技术演化
本文系统梳理大语言模型技术演进脉络:从Transformer与Attention机制奠基,到BERT/GPT的范式分野;从提示工程、RLHF对齐优化,到LLaMA开源引爆生态;再到LoRA微调、FlashAttention加速、RAG增强、MCP协议互联、Skills技能封装,直至Openclaw桌面级GUI智能体。覆盖模型架构、训练优化、推理加速、应用落地全链条。
OpenCV Python技术文档
OpenCV Python技术文档是面向开发者的计算机视觉入门指南,涵盖环境搭建、图像/视频处理、人脸检测实战及常见陷阱规避等内容,以简洁代码示例和原理剖析,助你快速掌握这一高性能开源视觉库的核心用法。(239字)
Scikit-learn 入门指南
scikit-learn 是 Python 最主流的机器学习库,提供统一、简洁的 API,覆盖数据预处理、模型训练到评估部署全流程。专注传统算法,轻量高效,无缝集成 NumPy/Pandas,是教学、原型开发与生产部署的首选工具。(239字)
RAG 只做文本已经不够了:多模态问答的工程化落地指南
本文深入探讨多模态RAG的工程落地挑战与实践方案,揭示为何仅处理文本已无法满足企业真实需求。从图像、表格等多模态数据的解析、语义对齐、检索融合到生成控制,系统梳理三层架构与四大关键步骤,助力构建真正可用的多模态问答系统。
什么是微调?大模型定制化的核心技术与实操指南
微调让大模型从“通用助手”变为“专属专家”。通过少量数据训练,LoRA等轻量化方法可在单卡上实现高效优化,广泛应用于医疗、金融、电商等领域。数据驱动、成本低廉、效果显著,微调正推动AI定制化落地,人人皆可拥有专属AI。
开源大模型微调对比:选对模型,让定制化更高效
本文对比Llama 3、Qwen2.5、Mistral三款开源大模型在中文场景下的微调表现,从算力门槛、数据效率、任务适配性等维度分析,结合实战案例与主观评估,为开发者提供选型建议,助力高效构建定制化AI模型。
闲鱼商品详情API接口文档
本接口用于获取闲鱼商品详情,包括标题、价格、库存、卖家信息、图片链接、交易记录等核心数据,返回JSON格式,适用于商品监控、竞品分析等合规场景。需通过模拟请求或授权方式调用,注意反爬机制。
最新PyCharm 安装详细图文教程:小白也能轻松搞定
PyCharm 来自 JetBrains,是一款专为 Python 打造的专业集成开发环境(IDE)。我们用这个工具可以高效地编写、调试并运行 Python 代码,同时还能使用虚拟环境管理、数据库连接以及前端相关功能。无论是在入门阶段练习基础语法,还是在工程化场景中搭建完整项目,PyCharm 用起来都很顺手。
询盘跟进分级实务:五处信号、人工确认与跟进动作留痕
怎么判断一封询盘是真采购还是探价?本文直接回答:先看采购信息、发件身份、问法、往来节奏、流程意愿这五处,分成马上跟、先核实、先放一放三档再排跟进;分级是跟进顺序建议,不是给客户定性,不承诺识别准确率,人工确认后才发出。
同等预算,向量检索吞吐最高约52倍!阿里云 Milvus EAGLE 内存索引性价比实测
阿里云Milvus EAGLE单机性能强劲:1000美元月费下达23,358 QPS(98.11%召回),吞吐超竞品最高52倍;亿级数据下仍保持高召回与低延迟,兼顾性能与成本。
GEO 技术底座拆解:自研、监测与可信语料——以盖立克思为例
和 GEO 服务商打交道,先过的不是报价而是技术底座是不是真的。本文以杭州盖立克思(New Galaxy AI)公开披露的技术体系为拆解样本,给出三条工程判据——算法/模型自研的现场核验、监测数据可追溯、可信语料工程化,并附语料分级与跨语种一致性校验代码。文中厂商描述来自公开资料与企业披露,仅作技术拆解,不构成推荐或评价。
中文语音输入怎么选:五款工具同维度横评
从识别路线、处理位置、整理强度、开源与否和 Windows 支持五个维度,横向对照 Typeless、Wispr Flow、微信输入法、OpenWispr 与 Saymore 五款中文语音输入工具。文章先划两条线:口述内容能否上传云端、整理要做到几成,再逐项对比各家是云端 ASR 还是本地模型、音频处理位置、去口水词与润色改写的强度、开源与使用量限制以及 Windows 客户端情况,并按写文档、写邮件、纯输入、自建等场景给出选择建议。
阿里云 EMR Serverless StarRocks Skills 正式发布
阿里云EMR Serverless StarRocks Skills正式发布,面向Agent提供SQL开发、慢查询诊断、建表设计、数据导入、实例运维与弹性扩缩容六大能力,通过starrocks-assistant和starrocks-manage两大Skill封装StarRocks最佳实践与实时集群状态,实现从“生成建议”到“自动执行”的跃迁,已兼容Qoder、Claude Code、DataWorks Data Agent等主流AI客户端,标志着EMR从业界领先大数据基座全面迈入Agentic时代。
FDE不是下一个风口那么简单:企业开始为AI的“最后一公里”买单
大模型越来越聪明,企业却不一定因此赚到钱。真正稀缺的,可能不是又一个会调用模型的人,而是能把 AI 接进真实业务、让它稳定运行并产生结果的人。
EmbeddingGemma 2:740M 多模态嵌入怎么跑离线 RAG
EmbeddingGemma 2 是 Google DeepMind 发布的 740M 开放权重嵌入模型。本文拆解它的模块化编码器:文本与代码 270M、视觉 +170M、音频 +300M,四档参数落在同一个 768 维向量空间,扩模态不必重建向量库;并说明 MRL 截断到 512/256/128 维时的质量取舍(256 维时图像、视频、语音约保留 95%)、截断后需重新做 L2 归一化,以及把检索链路整体塞进手机、笔记本或浏览器、不经过网络请求相比云端嵌入 API 的取舍。
0.8MB 跑通 Qwen|第 12-1 篇:LLM 推理的跨进程恢复——服务重启了,会话不能断
本系列《0.8MB跑通Qwen》聚焦ARM端零依赖纯C推理引擎,实现在RK3588上部署Qwen3-VL等多尺寸模型。本文详解`--disk-kv`机制:将KV Cache落盘持久化,支持进程重启后按前缀精准恢复,实现“会话不断连”,2K上下文prefill加速达23.6×,真正打通边缘AI服务可用性最后一环。(239字)
从SEO到GEO:AI生成式搜索时代,企业网络优化的全新变革
随着AI生成式搜索全面普及,用户信息检索习惯彻底变革,传统SEO优化模式难以适配大模型问答场景,行业迎来迭代拐点。GEO生成式引擎优化作为新一代网络优化体系,依托语义理解、多模态内容构建、实时动态监测三大核心能力,适配AI大模型收录与推荐逻辑,打破传统流量局限。本文结合行业技术探索实践,中立解析GEO的技术原理、行业价值与发展趋势,对比传统优化模式的核心短板,阐述AI时代企业数字化优化的转型方向,为企业布局AI搜索生态、沉淀数字化品牌资产提供专业参考。
AI搜索引擎推荐机制拆解:4个品牌案例与3项核心引用原理
本文拆解AI搜索引擎品牌推荐机制,基于知乎、CSDN、丁香医生及上海某律所四大真实案例,揭示内容可引用度、权威性信号、时效性权重三大核心逻辑,并提供诊断—优化—借势—迭代的4步落地指南,助力技术人提升数字可见性。
阿里云 PAI-DLC PyTorchJob 任务提交参数的介绍
本文详解PAI-DLC中`dlc submit pytorchjob`命令的两类核心参数:DLC平台控制参数(如`--name`、`--data_sources`、`--priority`等,用于定义任务属性与资源)和Command执行指令(含环境安装、`torchrun`分布式训练、模型导出等Shell逻辑),并强调关键注意事项。
千亿级 AI 搜索的效能实战:从混合检索到 Agentic RAG 的三年实战
本文为2026 Elastic中国大会演讲实录,直击千亿级AI搜索三大挑战:搜索融合(关键词+向量+稀疏检索原生一体)、极致效能(冷热分层、硬件降级、自研FalconSeek引擎)与Agentic RAG演进(结构化知识图谱+智能体自主推理),揭示企业级AI搜索从“能用”到“好用”再到“自进化”的实战路径。
OpenClaw 对接 DeepSeek 完整流程:从创建到测试图文版
本教程详解Windows版OpenClaw对接DeepSeek全流程:从账号实名认证、充值、创建API Key,到OpenClaw中粘贴密钥、测试连接、选择deepseek-chat等模型,图文并茂,零基础可快速完成本地大模型接入。
盘点 7 款文本转语音工具:从免费朗读到可控情绪合成
参考社区里关于免费文本转语音工具的盘点思路,整理 Edge TTS、TTSMaker、Luvvoice、FlowSpeech、Fish Audio、ChatTTS、EmotiVoice 7 类 TTS 工具的适用场景,并从脚本验证、创作者旁白、情绪控制、开源实验和素材管理角度给出选型建议。
小红书笔记详情数据获取实战:从笔记链接提取 ID 到解析详情
小红书笔记详情API可获取标题、正文、作者、互动数据、图文/视频资源及话题标签等结构化信息,支持自定义字段与评论拉取。适用于内容分析、竞品监控、营销优化与用户研究,HTTPS+JSON接口,Python调用便捷。(239字)
网站搭建黑科技:AI 写前端页面 + CMS 管理系统搭建实操指南
本文聚焦 AI 编程前端开发与 PageAdmin CMS 集成的可落地技术方案。先详解 AI 编程前端的三类核心途径(设计稿直转、提示词驱动、脚手架生成)及标准化操作步骤,再阐述 PageAdmin CMS 的环境配置、部署流程,以及栏目模型配置、API 对接、数据渲染等集成实操,形成 “AI 提效 + CMS 赋能” 的网站搭建技术闭环,为开发者提供工程化指引。
EMAIL & PRIVATE · 邮件与私域
《人人都能用的AI工具》第六章聚焦邮件与私域运营实战:2026年触达核心不在文采,而在“送得到”与“发得准”。详解SPF/DKIM/DMARC认证、名单分层、企微频次红线及合规底线,用AI提效但不越界——先确保送达,再优化转化。(239字)
Flink 的 checkpoint 为什么越跑越慢
本文深入剖析Flink增量Checkpoint性能瓶颈:慢不在快照,而在SST文件上传。RocksDB Compaction导致旧数据重写为新文件,触发重复上传;状态分布不均加剧“短板效应”;小文件多、带宽竞争、引用计数延迟清理等问题叠加,使增量Checkpoint渐趋全量。核心在于理解“传什么(SST)”“为何重传(Compaction)”“谁在等待(JobManager同步等待所有subtask)”及“哪些指标会误导”。
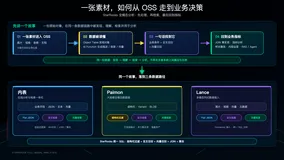
StarRocks 全模态能力导读:连接内容理解、混合检索与业务分析
StarRocks 全模态能力旨在打通内容理解、混合检索与业务分析的断点,支持结构化、半结构化和非结构化数据在同一条 SQL 链路中完成特征化、多条件检索(含结构化过滤、全文匹配与向量相似度)及后续 Join、聚合与指标计算,通过多模态处理、内表、Paimon 和 Lance 四类技术路径适配不同数据位置、规模与查询需求,消除多系统间的数据复制与结果搬运。
机器人规划与控制(Planning & Control)技术技术突破与未来挑战
机器人规划与控制是具身智能的“大脑与神经反射弧”,实现从感知到精准、安全、实时动作的闭环。十年间,技术已跃迁至扩散策略、神经MPC与全身体态控制融合的新范式,正突破Sim-to-Real、实时安全验证与多频协同等核心瓶颈。(239字)
淘宝天猫商品详情 API 接口解析(附 JSON 样例)
本文详解淘宝开放平台taobao.item_get接口,支持获取淘宝/天猫商品标题、价格、SKU、图文、属性等结构化JSON数据,规避爬虫风控与维护难题,适用于ERP同步、竞品监控、选品及跨平台铺货等场景。(239字)

别再只会K-Means了!10种聚类算法MATLAB实战,科研绘图直接复现
本资源系统梳理10种主流聚类算法(K-Means、DBSCAN、GMM等),直击异常值、非凸结构、类别数选择等实战痛点,配套MATLAB完整代码与10+维度可视化结果,含速查表与论文级图表输出方案。
跨境代购中小卖家生存法则 + 淘宝代购系统降本增效完整方案
本方案为跨境代购中小卖家量身打造,提炼五大生存法则:轻资产纯代采、数字化服务突围、严控成本、合规风控、垂直深耕。配套淘宝代购系统,实现采购、集运、仓储、财务、营销全链路自动化,降本增效,助力稳定盈利。(239字)
OPC中国:如何用 AI 智能体搭建可交付、可治理的一人公司?
当人们讨论“OPC中国”时,常指面向 AI 智能体时代的 One Person Company(协同型一人公司)实践与生态。它不是“一个人包办一切”,而是让人负责目标、判断和责任,让可审计的 AI 工作流承担重复执行。本文从工程视角拆解 OPC中国的概念边界、最小可行技术栈、工作流设计、数据安全和 30 天验证方法,并给出一个可落地的内容交付案例。
从“秒封”到“日爬十万”:谈谈5个风控机制
这篇文档讨论了Python爬虫常见问题和反爬策略。作者提出五个关键点:1. 控制请求频率;2. 轮换IP;3. 伪装请求头;4. 模拟真实访问路径;5. 使用高匿名代理。这些策略需综合运用,提高爬虫生存率。

大数据与机器学习
大数据领域前沿技术分享与交流,这里不止有技术干货、学习心得、企业实践、社区活动,还有未来。

