









制造业B2B工厂如何通过GEO让AI主动推荐你:3步落地指南
传统搜索引擎流量被AI蚕食,采购决策者正转向生成式AI初筛供应商。本文拆解GEO(生成式引擎优化)逻辑,提供工厂老板可落地的3步实操法与3个效果监测指标,助你信息进入AI推荐名单。
AI搜索引用转化链路的数据分析:三层漏斗与优化方法
本文提出AI搜索“引用→点击→咨询”三层转化漏斗模型,基于45条引用记录发现:首位引用点击率15%–25%,第5位后不足3%;内容完整度70%时咨询率最高(超15%),过高反致用户自助流失;决策型关键词转化率是学习型的10倍。实证优化60天,咨询量增长约10倍。
人工智能|BERT的简单介绍
BERT(2018年谷歌提出)是基于Transformer编码器的双向预训练语言模型,通过掩码语言建模(MLM)和下一句预测(NSP)任务学习深度上下文语义,在文本分类、问答、NER等理解型任务中表现卓越。
图解强化学习 |手算DDPG
DDPG(深度确定性策略梯度)是一种面向连续动作空间的Actor-Critic强化学习算法。它采用4网络结构(Actor/Critic及其对应目标网络),结合经验回放与软更新,通过确定性策略梯度优化策略,广泛应用于机器人控制、自动驾驶等场景。(239字)
云上 K8s GPU 节点 ImagePullBackOff 排查记录
本文记录云上K8s(v1.36)GPU节点模型评测Job因`ImagePullBackOff`卡在Pending的排查过程,聚焦containerd镜像拉取失败根因,涵盖crictl验证、日志分析、DNS/镜像源配置检查,并强调分层排障:先运行时,再资源调度与设备挂载。
一条 SQL 生成广告:Hologres 如何实现素材生成到投放分析一体化
广告投放面临“量、准、快”不可兼得的不可能三角:素材产能不足、数据与创意割裂、测试周期远超素材生命周期。阿里云Hologres以“Data + AI = All in One”理念,通过Object Table、AI Function、Dynamic Table等能力,实现素材采集、智能打标、AI生成、投放分析全链路闭环,用SQL驱动一体化智能创意工厂。
AI+数字孪生:从实时映射到智能决策的技术架构与实践路径
当数字孪生遇上AI,物理世界拥有了“预演未来”的能力。2026年,“可执行数字孪生”兴起——凡拓数创自研AI 3D引擎支持多物理场仿真与千万次并行训练,已在机器人Sim2Real迁移、工业预测性维护等场景落地见效。

相约深圳,全球征集|Flink Forward Asia 2026 演讲议题征集正式启动
Flink Forward Asia 2026将于6月26–27日首次落地深圳,聚焦实时计算与AI深度融合。面向全球征集议题(截止5月29日),涵盖实时AI、AI Agent、湖流一体等前沿方向。免费报名开启,共探下一代实时计算范式!
快速接入小红书API,市场趋势与热点预测
小红书API+AI已成2026年品牌营销与内容电商核心基建,支持竞品监测、舆情预警、趋势预测等全场景合规数据采集;多模态生成、预测型AI与垂直领域模型加速商业化落地,SaaS工具、代运营、技术基建成三大机遇。(239字)
Nginx 反向代理:原理、优势与配置指南
Nginx反向代理是核心服务器架构技术,可实现请求转发、负载均衡、高可用与安全防护。它隐藏后端服务器,自动剔除故障节点,并支持SSL终止、缓存等高级功能,配置简洁灵活,广泛应用于高性能Web系统。
淘宝图片搜索API接口指南
淘宝图片搜索API(拍立淘)支持通过图片或URL检索淘宝/天猫同款商品,适用于比价、内容带货、运营监控等场景。需申请接口权限,上传符合要求的图片,返回相似商品信息,包括标题、价格、主图及相似度得分。
四、Hive DDL表定义、数据类型、SerDe 与分隔符核心
Hive 中的表是数据仓库的核心容器,定义了数据的结构和存储方式。本文系统讲解了 Hive 中创建表的语法与关键参数,包括字段类型、分隔符设置、SerDe 使用等内容,特别通过结构化与复杂数据类型(如 ARRAY、MAP、STRUCT)的案例讲解,让读者理解如何让 Hive 正确“读懂”你的数据。配合常见示例与练习题,帮你打好 Hive 表设计的基础,轻松驾驭文本、JSON 等多格式数据。数据如何入库、如何被解析,一文看懂!
【赵渝强老师】阿里云大数据集成开发平台DataWorks
DataWorks是阿里云一站式大数据开发治理平台,支持数据集成、开发、建模、分析、质量监控、服务化及迁移等全链路功能,兼容多种计算引擎,助力企业高效构建数据中台,实现数据资产化与价值挖掘。
把线上咨询分层记录:一种可复盘的经营观察方法
本文针对财税服务场景,提出“曝光—有效咨询—可跟进客户”三层分层法,强调用客户原话判断意向、轻量记录关键字段、推动内容与销售信息互通,助力小流量团队精准识别高价值线索、提升经营复盘质量。
# 2026年AI安全平台技术落地指南:架构拆解、场景适配与选型避坑全维度盘点
本文系统梳理AI原生安全运营平台的技术演进与落地实践,聚焦多Agent自主调度、无代码数据接入、生产级风险管控、场景持续进化四大核心能力,厘清AI增强型与AI原生型平台的本质差异,破除常见认知误区,并提供POC验证方法与总拥有成本核算框架,助力企业务实选型。(239字)
Structured Streaming 集成 Kafka 实现:读写路径、位点语义与生产调优
本文深度解析Spark Structured Streaming与Kafka集成的实战要点:涵盖流/批双入口、订阅三式、七列数据结构、位点语义三大易错点、读写调优、安全认证及高频问题定位。助你精准掌握startingOffsets生效逻辑、重复消费归因与集群迁移关键配置。(239字)
Parquet、Lance、Vortex 争的,其实是一张行号到字节的映射表。
本文剖析Parquet、Lance与Vortex三种列存格式在随机访问(如按行号点查、随机采样)上的根本差异:Parquet为顺序扫描优化,页不可分导致“取一行读一整页”;Lance取消行组,引入细粒度迷你块索引,实现字节级定位;Vortex采用可配置布局树与多级裁剪,平衡灵活性与性能。三者之争,实为“行号→字节位置”映射精度与加载成本的博弈。(239字)
AI搜索引擎引用机制解析:决定内容被选中的5个因素
本文解析AI搜索与传统搜索在收录、判断和分发逻辑上的本质差异,面向开发者与技术决策者,从信息块结构、平台分发、交叉印证、时间积累及内容可验证性五方面,系统阐述AI引擎引用来源的机制、验证方法与实践边界。
瓴羊 AgentOne 深度解析:四大 AI 员工上岗,营销、客服、运营、销售一次配齐
瓴羊AgentOne推出四大AI员工(销售、客服、运营、营销),深度融合企业数据、场景与业务系统,实现从“能聊”到“能干”的跃迁。依托“大模型×好数据×强场景”公式,构建“能信、能干、能打”三角能力,端到端交付GMV、解决率等真实业务结果。
大模型企业本地化部署与数据安全实践:RAG 回答如何提供引用证据链
本文探讨企业大模型本地化部署中RAG问答的“证据链”实践:如何让AI回答附带可追溯的引用依据(文件名、版本、章节、生效时间等),提升制度、合同等关键场景的可信度与合规性,兼顾数据安全与业务落地。

从数据湖到多模态湖仓-基于阿里云 EMR Serverless StarRocks 与 DLF Paimon 构建AI时代的统一分析检索架构
阿里云 EMR Serverless StarRocks 在统一数据、一致语义和系统级优化之上,构建了面向 AI Data、AI Agent 和多模态应用的下一代湖仓架构。

3个技术特征:向量数据库如何驱动AI搜索引擎的内容引用选择
本文从技术角度解析AI搜索引擎(如豆包、Kimi、DeepSeek)的内容引用机制,揭示其依赖向量数据库进行语义检索的本质。基于2026年实测数据,指出内容被引用的三大关键指标:结构化层级清晰度、数据密度、权威来源可追溯性,并阐明其与传统关键词检索的根本差异。(239字)
数据平台主管做智能问数选型,最该先看技术路线还是实施能力?
本文为数据平台主管提供智能问数选型的系统化框架,聚焦2026年关键矛盾:技术路线决定能力上限与长期成本曲线,实施能力决定上限能否落地。从四类主流路线(预置SQL、宽表、指标平台、本体语义层)对比出发,结合实施能力三要素(语义构建、知识校准、持续运营)与场景成熟度判断,助力企业在“先进性”与“可行性”间找到平衡点。
C语言深度解析:未定义行为(UB)—— 90%玄学bug的根源
C语言因极致性能与硬件控制力成为系统开发首选,但其“自由”伴生未定义行为(UB):语法合法却结果不可控,是“调试正常、上线崩溃”的元凶。UB包括数组越界、有符号溢出、空指针解引用、序列点违规、重复释放等,编译器可任意优化或崩溃。规避需严守边界、开启高警告、判空置空、拆分表达式、预检溢出。(239字)
大模型应用:庖丁解牛:QKV机制详解,大模型的注意力之眼.4
QKV机制是Transformer注意力的核心:Query(提问)、Key(标识)、Value(信息)三者通过点积计算相似度,Softmax归一化后加权融合Value,实现动态上下文感知。它能捕捉长程依赖,解决代词消解、一词多义等问题,支撑大模型强大语言理解能力。
人工智能技术全流程入门:10 个关键步骤快速上手
本教程系统讲解人工智能入门10大核心步骤,涵盖基础认知、工具使用、数据理解、实操应用与伦理规范,结合场景导向与避坑指南,帮助新手快速掌握AI技术应用逻辑,轻松实现从零到一的跨越,助力职场增效与技能提升。

MyBatis-Plus 超详细教程:从入门到实战,一站式掌握
MyBatis-Plus 是 MyBatis 的增强工具,简化单表 CRUD 操作,无需编写 XML,支持条件构造器、分页插件、逻辑删除、枚举与 JSON 处理,提升开发效率,兼顾灵活性与便捷性,助力从入门到实战一站式掌握。
AI 引用资料分两步:选中与吸收(附企业自查清单)
AI 回答问题时挑资料分两步:先决定用谁的(来源身份、是否在常读网站),再决定用多少(相关性、结构、证据)。本文讲两步各看什么,附一份企业自查清单。
绷不住,DeepSeek Super-agent: Router动嘴,Worker干活
DeepSeek Harness: Super-agent 用Router动嘴Worker动手的方式解决多任务并行时人为瓶颈的问题
一条流跑起来要过三关:Flink 2.3 流处理代码骨架
本文深入解析Flink流处理核心机制,聚焦时间语义(水位线)、状态管理(TTL与容错)和端到端一致性(Exactly-Once写入)三大生死关键。基于Flink 2.3实测,覆盖Source/Sink配置、算子链优化、窗口语义、Checkpoint调优及上线硬约束,助你写出稳定、低延迟、可恢复的生产级流作业。
Windows中文语音输入怎么选:五款工具同批音频对比
用30段自录中文口述音频(含中英混说、口语填充、邮件与文档模拟)同批测试Typeless、微信输入法、Windows自带语音输入、OpenWispr和Saymore,比较中文准确率、离线/本地处理、口述整理、使用量与授权形态、平台支持。Typeless中英混说较稳、边说边整理但有额度分层;微信输入法短句好、跨Windows/macOS/手机;Windows自带仅自动标点;OpenWispr开源本地,效果取决于所选模型;Saymore本机识别与整理、开源且不按次/时长设限。样本仅给相对结论,并按写文档、写邮件、不限量使用给建议。
阿里云 EMR Serverless Spark AI Function 多模态能力介绍与智驾场景图片理解实践
本文介绍了阿里云EMR Serverless Spark AI Function在多模态处理上的能力升级与智驾场景落地实践,涵盖图片理解(aiquery)和向量化(aiembeddingmultimodal)两大核心函数的多种调用模式,支持URI路径、二进制流及readfiles直读等灵活输入方式,并可对接百炼或PAI-EAS实现快速验证与企业级安全推理;通过智驾环岛识别与特种车辆检测案例,验证了其在高分辨率图像秒级结构化分析、长尾场景泛化及自动化数据清洗方面的实际效能。
0.8MB 跑通 Qwen|第 10-1 篇:大模型推理的长上下文为什么必须稀疏——O(n²) 的注意力 vs O(n·k) 的"只看该看的"
本系列手搓0.8MB纯C推理引擎,零依赖跑通Qwen3-VL多模型。本文聚焦长上下文瓶颈:RK3588实测显示,注意力耗时占比从18%飙升至71%。提出块稀疏方案——将O(n²)注意力压至O(n·k),实现每词成本与上下文长度无关,为端侧大模型长文本推理提供关键路径。(239字)
人工智能 |手算CLIP模型
本文详解CLIP模型原理:突破传统CNN需重新训练的局限,通过4亿图文对联合训练文本与图像编码器,实现零样本迁移。利用对比学习对齐多模态特征,支持图文检索、零样本分类等应用,让AI像人一样理解未见过的概念。(239字)
微信智能体 OpenClaw 2.7.1 部署与故障排查全解
OpenClaw(小龙虾)是专注微信私域自动化的开源AI智能体,支持本地、云端、命令行三模式部署,简化微信接入,保障连接稳定与数据安全,适用于客服、运营、助理等场景,附一键装机包及完整部署指南。
(一)走进阿里云实时计算Flink版-产品能力篇
阿里云实时计算Flink版是企业级高性能实时大数据处理平台,由Flink创始团队打造。提供VVR+Flash双引擎,性能达开源Flink的3-4倍;支持动态扩缩容、SQL开发、CEP规则热更新、湖流一体(Fluss+Paimon)、大模型集成等能力,全面兼容开源生态。(239字)
AutoGod:一款拥有AI视觉的安卓自动化框架
AutoGod是一款面向安卓的AI视觉自动化框架,融合多引擎OCR、YOLO目标检测与VMP混淆引擎,解决传统方案元素定位脆弱、兼容性差、安全性低等痛点,支持自动化测试、游戏脚本与企业RPA,兼顾智能性、鲁棒性与安全性。
Flask 入门指南
Flask是轻量级Python Web微框架,核心仅提供路由与模板功能,按需通过扩展集成数据库、认证等模块。学习曲线平缓、结构简洁、扩展灵活,适合从API、博客到企业应用的全阶段开发,是入门Web开发与构建定制化技术栈的理想起点。(239字)
PDF 转 Markdown 神器:MinerU 2.5 (1.2B) 部署全攻略
MinerU是由OpenDataLab推出的开源PDF解析工具,支持精准布局分析、公式识别与表格提取。本文详解其2.5-2509-1.2B版本在Linux下的部署流程,涵盖环境搭建、模型下载、核心配置及实战应用,助你高效处理复杂PDF文档,提升AI数据清洗效率。
DeepSeek Harness:排查企业代理 TLS 证书错误
排查 DeepSeek Harness 企业代理的 TLS 证书错误,核对实际路由、Node 证书包和模型提供方响应。
DeepSeek Harness:一个插件从配置行到运行实例,中间隔着四层
插件出现在配置里、代码被解析到、服务就绪、实例挂载成功是四件不同的事。拆解 DeepSeek Harness 的 profile 分层、依赖注入、Context 作用域和 Fiber 清理,给出每一层的排查动作。
Flink on Kubernetes 部署模式:Application 与 Session 的两个分水岭
本文详解Flink on Kubernetes的Application与Session两种部署模式:前者为应用独占集群、资源隔离强、故障域独立;后者共享集群、资源复用高但存在作业干扰风险。二者核心差异在于集群生命周期归属及`main()`执行位置,直接影响运维成本与稳定性。
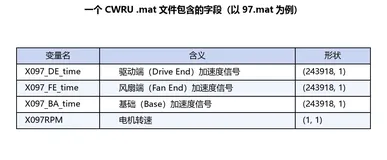
手把手教你:基于深度学习的滚动轴承故障诊断|第 3 篇 · CWRU 数据集深度解析与四类故障波形可视化
本期介绍轴承故障诊断的"教材"——凯斯西储大学公开数据集CWRU。它收录正常、内圈、滚动体、外圈四类故障的振动信号,驱动端与风扇端双传感器记录,免费可靠、论文认,是全世界通用的标准数据,为后续AI模型训练打下基础。
最佳实践:用 StarRocks AI Function 实现金融行业文本分类
本文介绍了如何利用 StarRocks AI Function 在数据库内原生实现金融文本的端到端智能分析,涵盖情感分析、工单分类、合同要素抽取、PII 脱敏等核心场景,通过异步非阻塞架构、SQL 谓词下推、LRU 缓存与三层限流等技术创新,在保障数据不出库的前提下,显著提升处理并发性、降低延迟与 Token 成本,并满足金融级安全合规要求。
LTTB 降采样算法原理与 Qwt7 的 MinMax 桶实现
本文详解Qwt 7.4.2中基于LTTB思想的**MinMax桶降采样算法**:将数据按索引等分桶,每桶保留y极值点(非最大三角形),实现确定性峰值保留、SIMD加速(AVX2/SSE4.2)及奈奎斯特匹配,百万点重绘提速近2倍,保真度显著优于经典LTTB。

大数据与机器学习
大数据领域前沿技术分享与交流,这里不止有技术干货、学习心得、企业实践、社区活动,还有未来。

