









从“秒封”到“日爬十万”:谈谈5个风控机制
这篇文档讨论了Python爬虫常见问题和反爬策略。作者提出五个关键点:1. 控制请求频率;2. 轮换IP;3. 伪装请求头;4. 模拟真实访问路径;5. 使用高匿名代理。这些策略需综合运用,提高爬虫生存率。
PyTorch深度学习实战 |手动计算 Transformer和完整的代码实现
本文介绍了基于PyTorch实现Transformer模型的完整过程。主要内容包括:1)Transformer架构的核心组件实现,如多头注意力机制、位置前馈网络、位置编码等;2)模型构建步骤,包括词嵌入层、编码器/解码器块和输出层的实现;3)完整的训练流程,包含数据处理、损失计算和参数优化;4)评估方法验证模型性能。文章通过代码示例详细展示了如何从零开始构建Transformer,并应用于机器翻译任务,同时对模型各层的输入输出维度进行了说明。该实现可作为深度学习实践者学习Transformer架构的实用指南
Hologres 4.1 新特性:基于 Stage 的离线导入,平衡吞吐与资源成本的最优解
Hologres 4.1 推出基于 Stage 的离线导入新特性:数据先高速写入内部临时存储(Arrow格式),再批量合并落表。相比 Bulkload,吞吐提升24%–61%,CPU负载降低32%–62%,Serverless 成本节省46%,兼顾高吞吐与低资源开销,适用于近实时报表、海量日志分析等场景。
# Pyc怎么转Py?PyLingual 部署教程
PyLingual是一款基于深度学习的Python字节码(.pyc)反编译工具,专攻损坏、加密或混淆的现代pyc文件(支持3.6–3.13),弥补uncompyle6对新版本支持不足的短板。部署需Python 3.12+、Poetry及pyenv多版本环境,适合开发者救代码、安全人员分析恶意样本。(239字)

零基础玩转RAG:手把手教你搞定文档切分与大模型微调
本文深入解析RAG中至关重要的文档切分技术,系统对比句子切分、固定长度、重叠窗口、递归切分和语义切分五种策略,结合代码示例与实战技巧(PDF/Markdown/代码处理),并提供量化评估与调优方法,助你夯实RAG基石。(239字)
别光“调戏”ChatGPT了!亲手微调一个专属大模型,你需要知道这些
本文深入浅出地讲解大模型“训练-微调-推理”三步法,类比医生培养过程,帮助读者理解AI如何从通才变为专才。涵盖技术原理、实操步骤、效果评估与GPU选型,助力个人与企业打造专属AI模型,推动AI应用落地。
2025数字员工技术选型白皮书:阿里云/亚马逊等5款产品云原生能力实测
本文深度评测阿里云、亚马逊、科大讯飞、玄晶引擎、安恒五款数字员工,围绕架构兼容性、开发友好度、性能稳定性三大维度,结合实测数据与企业案例,为开发者提供选型指南与避坑建议。
实用程序:基于Python+Tkinter开发表格比对&整理工具
一款基于Python+Tkinter开发的免费开源Excel处理工具,支持表格差异比对与错乱行整理,完整保留图片,兼容.xlsx和.csv格式。操作简单,支持自定义比对列、多线程处理,解决日常办公中数据比对、行合并及图片丢失等痛点,适用于各类Excel数据清理场景。(239字)
Flink 的对手换了:三条分野,重排实时计算选型
本文深度剖析2026年Flink与Spark等流处理方案的本质差异,摒弃过时对比表,聚焦**执行模型、状态归属、交付形态**三大分野,直击选型核心:不是“谁更强”,而是“哪种复杂度你付得起”。
机器人技术技术突破与未来挑战
全球机器人正经历历史性范式跃迁:从规则驱动的自动化,迈向大模型与具身智能驱动的自主泛化。本文系统剖析三大突破(VLA认知大脑、GPU仿真小脑、视触融合感知)及四大瓶颈(仿真-现实鸿沟、算力-功耗墙、安全验证黑箱、终身学习挑战),勾勒“AI×算力×机电”融合的通用机器人演进蓝图。(239字)
借助 EMR Serverless StarRocks 实现电商平台图搜图、文搜图场景
本文介绍如何基于 EMR Serverless StarRocks 构建统一的多模态电商搜索系统,通过内置 AI Function 实现图搜图与文搜图场景的一体化处理:利用 Object Table 直接挂载 OSS 图片,结合 HNSW/IVFPQ 向量索引与结构化字段联合查询,将图片/文本向量化、ANN 检索、业务过滤(价格、库存、类目等)全部收敛至单条 SQL,消除多系统割裂与数据延迟问题,显著提升搜索实时性、准确性和工程效率。
Python面向对象编程实战:三个项目完整拆解讲解
专为零基础设计的Python面向对象编程实战教程,通过学生成绩管理、图书馆管理、综合管理系统三个渐进式项目,详解类、继承、封装、多态等核心概念。每行代码均附详细注释,助你扎实掌握OOP开发能力。(239字)
每天只有十分钟,怎么跟上 AI 最新进展?
把每天十分钟拆成固定的三层:先用一个聚合入口花 4 分钟只扫标题和一句话摘要,判断相关性,这一层不点开原文;再用 2 分钟看社媒讨论摘要,发现争论焦点而不是确认事实;最后 3 分钟按需回源确认一手来源,留一分钟记一句话。文中还给出常见坑、做法顺序,以及哪些人不必走这套流程。
0.8MB 跑通 Qwen|第 14-1 篇:大模型推理的连续批处理——iteration-level 调度思想
本系列《0.8MB跑通Qwen》聚焦ARM端零依赖纯C推理引擎,适配Qwen3-VL多模态模型,在RK3588上实测落地。本文详解iteration-level连续批处理:动态聚合多请求的decode步,单次前向服务多人,兼顾并发与确定性。(239字)
电商产品页GEO优化:从关键词匹配到任务匹配的四步指南
AI搜索正重塑电商推荐逻辑!本文以家居乳胶枕案例切入,揭示产品页被AI推荐的核心机制:从任务匹配、结构化数据、权威信号到动态监测。提出可落地的四步优化法——让页面从“商品描述”变为“任务说明书”,助你抢占AI时代流量入口。
GEO EEAT实战拆解:AI搜索判断内容可信的4个信任信号
本文拆解AI搜索EEAT与Google EEAT的本质差异:AI不看品牌声誉,而依赖4个可验证的信任信号——可点击外链、结构化内容(FAQ/列表/表格)、站内信息一致性、近90天时效性。基于4个月实测,提供零品牌背书也能落地的四步法。
AI Agent时代的流程自动化:RPA、Workflow与LLM协同架构实践
本文探讨AI Agent与RPA的融合趋势:RPA擅长稳定执行规则化任务,AI Agent长于自然语言理解、推理与决策。二者非替代关系,而是协同构建“Agentic Process Automation(APA)”——Agent负责“做什么”,Workflow编排任务,RPA精准执行,知识库赋能持续学习。企业应分阶段推进,迈向目标驱动的智能自动化新范式。(239字)
图解强化学习 |手算GRPO
GRPO(分组相对策略优化)是PPO的无Critic简化版,仅用单一Actor网络,通过组内候选回答的相对奖励归一化替代优势函数估计;引入裁剪机制与KL正则,显著降低显存开销、提升训练稳定性与长链推理能力。(239字)
OpenClaw钉钉渠道插件安装与配置|从零到消息回复的完整教程
本教程详解OpenClaw接入钉钉全流程:从钉钉开发者平台创建机器人、获取Client ID/Secret,到OpenClaw安装插件、配置凭证并保存启用,图文步骤清晰,助你快速实现智能消息互通。(239字)
抖音商品详情API 实战总结(技术复盘)
本文复盘抖音商品详情API(douyin.item_get)实战经验,涵盖鉴权、风控、token管理等关键问题,优化请求队列与重试机制。支持抖音小店/精选联盟商品结构化采集,返回基础信息、价格规格、多媒体、销售及评价五大模块,稳定高效,适配电商采集中台。
养龙虾不破产,OpenClaw 三种使用技巧,降低 Token 消耗
这是一份OpenClaw降本增效实战指南,聚焦三大核心:①斜杠命令(/compact、/reset、/new)秒级优化对话长度;②多Agent分工实现上下文隔离与故障可控;③memory-search机制以查代记,精准调用长期知识。三法协同,直击Token浪费与响应迟缓痛点。(239字)
从Function Call到Skill商店:三层技术栈如何解决大模型输出不稳定难题?
2026年AI领域关键趋势——Agent Skill(智能体技能):一种以Markdown脚本标准化AI工作流的创新范式。它通过步骤锁定与标准量化,彻底解决大模型输出不一致痛点。
阿里巴巴国际站商品详情接口深度解析与实战指南
阿里巴巴国际站开放平台提供`alibaba.product.get`等API,支持获取商品全维度数据(标题、价格、SKU、多媒体、交易量、供应链、SEO等)。仅限企业认证接入,需OAuth2.0签名认证,适用于选品、比价、ERP集成等场景。(239字)
Feature Generator(FG)特征算子配置指南
本文档全面介绍Feature Generator(FG)的各类特征算子配置方法,涵盖基础(ID/原始特征)、计算(表达式)、交叉(组合)、查找(Lookup/Match)、文本(重叠/BM25)、序列、预处理(分词/归一化)及字符串处理(正则替换/切片)等9大类算子,附详细配置示例与说明。
学生开发者指南:如何用最低成本在阿里云部署可访问的Web项目(最新版)
本文详细介绍Spring Boot + Vue项目部署到阿里云ECS的完整流程,包含Nginx反向代理、Systemd服务配置、RDS数据库连接等实操内容。适合课程设计、毕业设计、个人项目演示场景,配合智码方舟等AI工具可进一步提升开发效率,月度成本控制在50元以内。
从 NL2SQL 到本体论智能问数:为什么复杂企业数据问答需要新的方法
当“大模型+数据问答”成智能化入口,真正难点不在NL2SQL,而在理解业务对象、关系、口径与动作。本文剖析传统方法的天花板,提出以本体论构建业务语义层——将问数从“查表工具”升维为“决策基础设施”,揭示UINO等厂商通过ABC(Acquire-Build-Compute)范式,推动智能问数迈向可持续演进的语义底座。
1949AI 零代码本地自动化工具:轻量化部署适配低配置电脑设备
本文介绍1949AI轻量化本地自动化方案:零代码、免配置、纯本地运行,安全合规无数据外传;低资源占用,兼容低配电脑;面向小白用户,三步搞定表格整理、文件批量重命名等重复任务,离线可用,开箱即用。(239字)
用 SQL 调大模型?Hologres + 百炼,让数据开发直接“对话”AI
阿里云Hologres深度集成百炼大模型平台,推出AI Function能力——无需Python、GPU或额外服务,用熟悉的SQL即可直接调用大模型,实现PDF解析、多模态理解、向量检索等AI功能,让数据开发者零门槛构建智能应用。
Scrapy框架入门指南
Scrapy是Python高性能工业级爬虫框架,基于Twisted异步架构,支持高并发、自动去重、重试与反爬。内置Spider、Item、Pipeline等模块,实现请求调度、数据提取到存储的标准化流程,大幅提升开发效率与系统稳定性。(239字)
让大模型“开小灶”:手把手教你打造能聊业务的专属AI
本文深入浅出解析AI微调(Fine-tuning)技术:揭示通用大模型“懂常识却不懂行”的根源,详解LoRA等高效微调原理,对比RAG适用场景,并提供数据准备、LoRA训练、效果评估到部署的四步实践指南。助力业务人员低成本打造专属行业AI助手。(239字)
漫画说:为什么你的“增量计算”越跑越慢? ——90%的实时数仓团队都踩过的坑,藏在这几格漫画里
面对海量数据,传统全量计算导致实时更新效率低下。阿里云 Hologres 通过有状态增量计算,仅处理变更数据并持久化中间状态,实现秒级刷新、降本增效,真正让“增量”摆脱重复扫描历史的困局。
网站代码 网站源代码 网页源代码 网页代码网站
本文深入解析网站源代码与网页源代码的核心概念及区别,阐述其作为互联网技术基石的关键作用。通过剖析PageAdmin等典型源码案例,揭示源代码在技术学习、网站优化、安全维护等方面的核心价值,并探讨如何高效利用代码网站资源进行创新开发。文章强调在尊重版权的前提下,开发者可借助源码资源提升能力,推动网页技术持续发展。
第一个月验收GEO交付:怎样核对内容、归属、记录与承接
本文为采购方提供生成式搜索合作首月交付核对指南,强调“先约定清单、再验收月报”。聚焦内容发布、账号归属、AI提及记录、咨询承接及工时投入五类可验证项,要求每项对应具体链接、文件或原始记录,确保交付可打开、可比对、可交接。明确首月仅验过程履约,不预判效果。
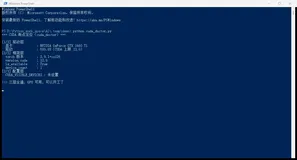
手把手教你:torch.cuda.is_available() 一直是 False?一条命令定位断点|AI工程师踩坑实录·第2篇
GPU用不上别急着重装驱动。本文给出三层断点定位法,按概率排序排查:最常见是框架层装了+cpu轮子,最隐蔽是CUDA_VISIBLE_DEVICES被设成-1(零报错让GPU凭空消失),驱动层放最后。一条cuda_doctor命令即可定断点在哪层。
块扩散 + GDN 改造:Clover 把「并行生成」塞进了 Agent 的长上下文里
Clover-35B-A3B-Preview是扩散智能首发的块扩散架构模型(10月28日发布),以Qwen3.6为基座,创新采用Gated DeltaNet重写、32-token块并行、0.95置信度LowConfidence解码与128K常数状态上下文,在低并发Agent场景下显著提升吞吐。
别让 Agent 猜数据:企业级 Data Agent 架构设计指南
优先建设语义层、Agentic Harness 架构和分析能力沉淀,把最关键的业务对象、核心指标和高频分析方法系统化,再逐步补齐编排、记忆、权限和审计机制。
3个决策问题:日本消费者如何用AI搜索完成购物决策
日本市场正快速转向生成式AI搜索,跨境卖家需重构内容策略:聚焦用户真实决策问题,构建含时间、数据、第三方认证的“可引用实体内容”,并在note等知识社区部署真实经验类内容,以提升AI搜索信任度与引用率。
规则怪谈为什么容易写崩:用知识图谱管理长篇伏笔
规则怪谈的难点不只是设计规则,而是让人物、地点、线索、能力与规则代价在长篇连载中保持一致。本文介绍一种“设定卡 + 知识图谱 + 大模型检查”的创作工作流,并以原创规则怪谈项目《午夜代驾:乘客请遵守规则》为测试案例,说明如何减少伏笔断裂和规则冲突。
1688商品详情API(1688.item.get/item.get_pro)全业务场景实战解析
1688开放平台商品详情接口(item.get/item.get_pro)是B2B数字化核心数据源,提供合规、稳定、结构化的全维度商品信息,覆盖SKU、阶梯价、代发规则、资质认证等。本文深度解析其在采购系统、无货源铺货、跨境运营、竞品监控、ERP集成等七大场景的落地逻辑与实战方案。(239字)
AI大模型赋能企业跨端远程办公与文件处理:智能办公架构与落地指南
本文探讨AI大模型如何深度赋能企业跨端远程办公与智能文件处理,聚焦架构设计与落地实践。通过统一身份、云端文件中心、企业知识库、安全模型服务与审计机制,解决文件分散、版本混乱、重复劳动三大痛点,实现会议纪要自动生成、合同要素提取、文档摘要等高频场景提效,兼顾安全可控与业务连续性。

从向量存储到 Agentic 数据基础设施:Paimon × Milvus 如何构建 AI 原生多模态数据湖
本文整理自李钰在 Apache Flink Forward Asia 2026 的演讲,讨论 AI 与 Agent 进入生产环境后,数据湖与向量数据库“双系统”架构暴露出的结构性问题,以及 Apache Paimon 与 Milvus 围绕同一份湖数据协同的技术路径。
让 Agent 越用越准、成本越来越低:AgentLoop 的 Agent 经验自进化闭环
企业 Agent 上线后,如何在不重新训练模型的情况下提升准确率、稳定性并优化单位成功成本?本文介绍 AgentLoop 如何基于真实运行轨迹自动生成可复用经验,通过 Skill 和 CLI 按需召回,并给出控制台接入步骤及与 Memory、RAG、微调、RL 的差异。
taobao.item.get(淘宝天猫商品详情 TOP API)全业务场景手册
淘宝TOP核心接口taobao.item.get,通过商品ID(num_iid)获取结构化全量数据,支持铺货、ERP、竞品监控、跨境供应链等八大场景。HTTPS协议,返回JSON/XML,限流QPS=2,需按需传fields字段并规范签名。

2026 SelectDB AI 产品发布会:Agent Native 数据基础设施能力全景发布
“只有解决好极速、统一、Agent Native 与 Cloud 弹性四个挑战,才能成为 Agent 时代最好的分析引擎。”
图解人工智能的数学基础(高数)
本文系统讲解微积分核心概念:数列与递推、极限(含无穷小/大)、导数(含中值定理、泰勒公式)、积分(不定/定/变上限/反常)及微分方程,并延伸至多元函数、偏导数、链式法则与二重积分,结合Sigmoid函数、药物衰减等实例及SymPy代码演示,突出其在AI与工程中的应用基础。
人工智能|大白话DETR 模型
DETR(检测变换器)是首个端到端目标检测模型,摒弃锚框与NMS后处理。它以CNN提取特征,经Transformer编码器-解码器处理,配合100个可学习目标查询(OQ),通过二分图匹配实现预测框与真实框的一对一最优分配,直接输出类别与坐标。(239字)
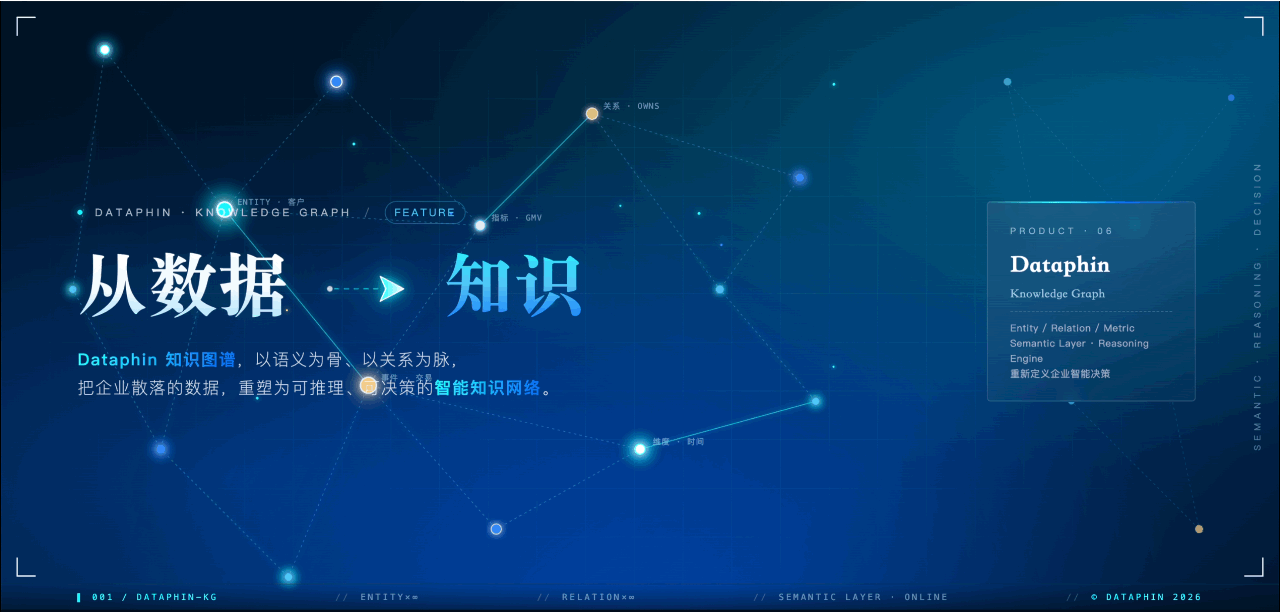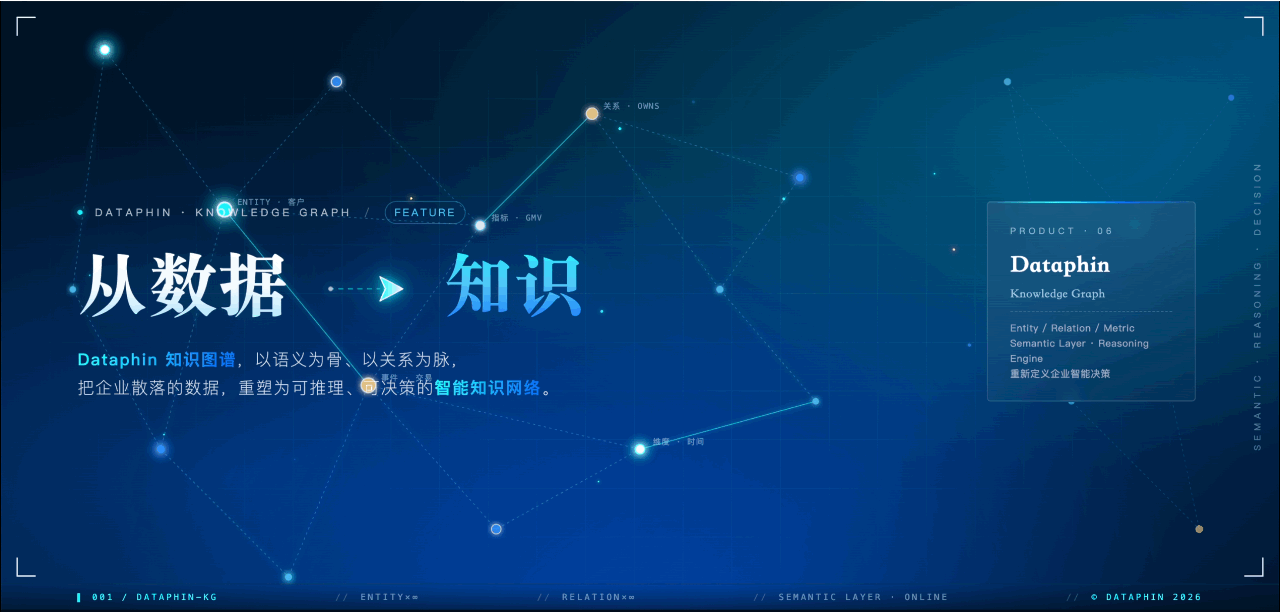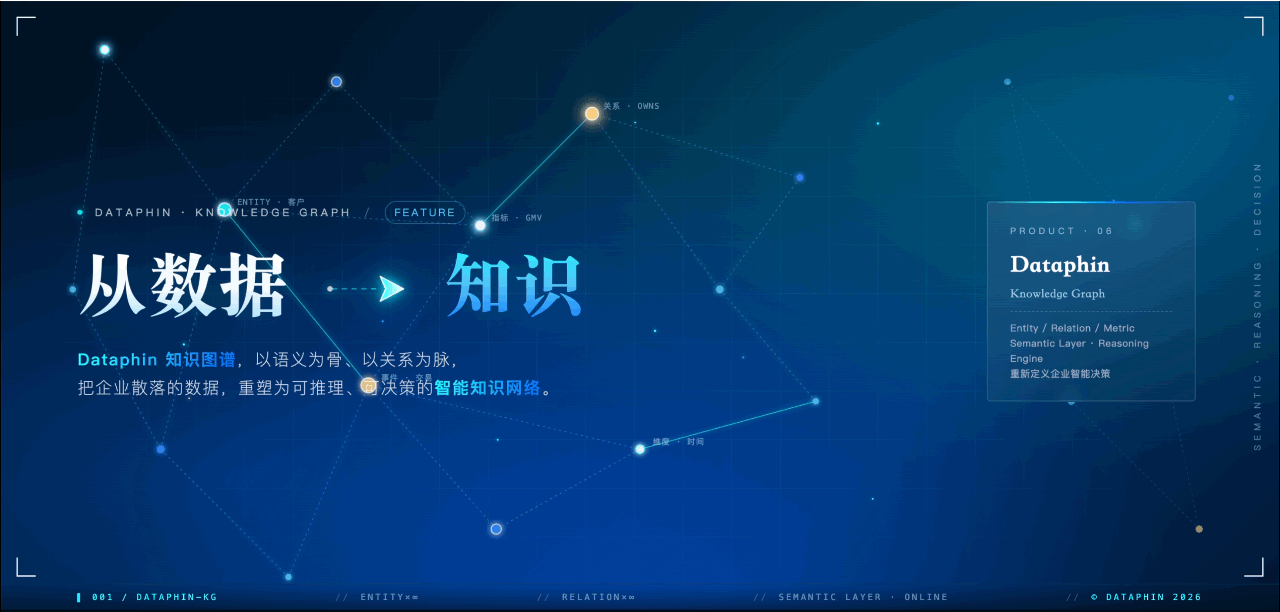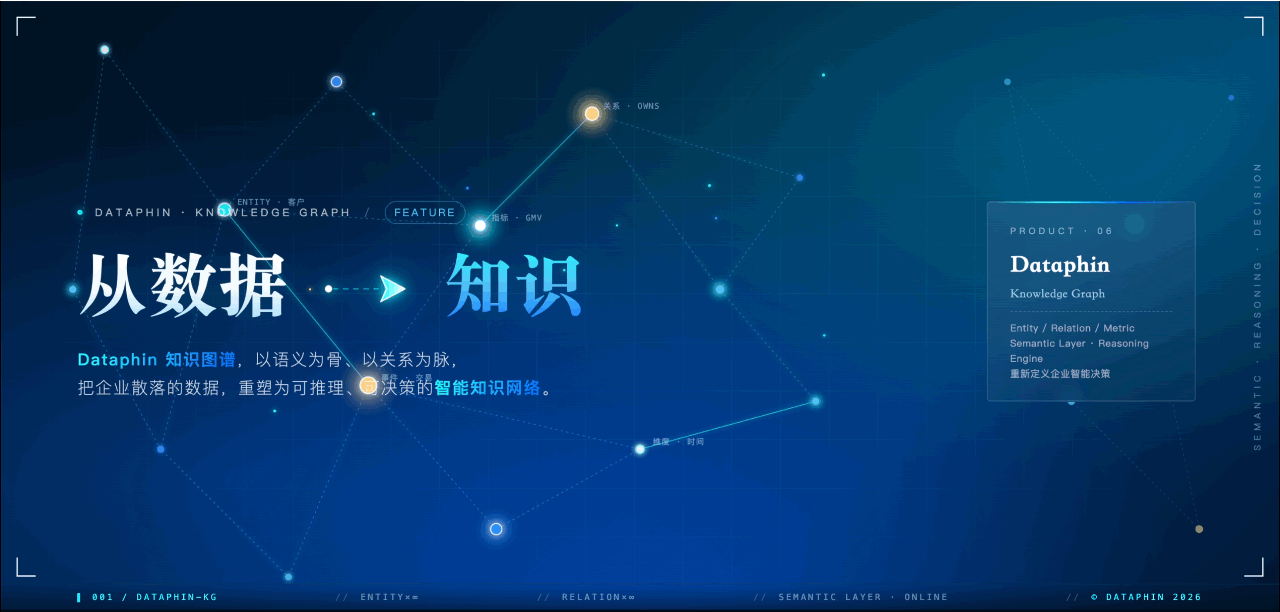
从数据到知识:Dataphin 知识图谱,重新定义企业智能决策
Dataphin知识图谱助力企业从PB级数据迈向可理解、可推理、可决策的知识智能。它深度融合数据研发体系,支持可视化建模、结构化/非结构化数据双通道入图、Schema全生命周期管理及GraphRAG问答,真正实现“数据即知识”。
如何搭建音视频知识库?从语音转文字到结构化整理的完整方案
本文分享用AI(如Ai好记+Obsidian)将B站、播客、YouTube等音视频高效转化为可检索知识库的实操方案:一键实现视频转笔记、语音转文字、视频总结、思维导图生成,并支持全文搜索与双向链接,15分钟搞定45分钟视频,大幅提升知识获取效率。

大数据与机器学习
大数据领域前沿技术分享与交流,这里不止有技术干货、学习心得、企业实践、社区活动,还有未来。

