《Apache Flink 案例集(2022版)》——3.机器学习——Bilibili-Flink 在 B 站的多元化探索与实践(2)

简介: 《Apache Flink 案例集(2022版)》——3.机器学习——Bilibili-Flink 在 B 站的多元化探索与实践(2)

《Apache Flink 案例集(2022版)》——3.机器学习——Bilibili-Flink  在 B 站的多元化探索与实践(1) https://developer.aliyun.com/article/1228231


2.增量化

image.png


B站的增量化方案由Flink+Hudi构成,架构如上图所示。Flink计算引擎的 checkpoint 是一个天然的增量化机制,实时任务进行一次 checkpoint,产出一批增量数据进行增量化处理。数仓来源主要有日志数据和 binlog 数据,日志数据以append方式写入 HDFS 存储即可做到增量化的生产,但binlog 数据是 update 模式,使用HDFS 无法很好的支持,因此B站引入了 Hudi 存储,它能够支持 update 操作,并且具备一定的数据布局能力,同时它也可以做 Append 存储,并且能够解决 HDFS 的一些小文件问题。  


增量化场景的落地上,考虑到复杂性选取了业务逻辑相对简单、没有复杂聚合逻辑的 ODS 和 DWD 层进行落地。  


数据由 Flink 直接写到 Hive 的 ODS 层,我们对此进行了针对性的适配,支持了 Hive 表的增量化读取,开发了 HDFSStreamingSource,同时为了避免对 HDFS 路径频繁扫描的压力,ODS 层写入时会进行索引创建,记录写入的文件路径和时间,只需要追踪索引文件即可;


Source侧也采取分层架构,有文件分发层和读取层。文件分发层进行协调,分配读取文件数,防止读取层某个文件读取过慢堆积过多文件,中间的转换能够支持 FlinkSQL 操作,具备完整的实时数仓的能力;


Sink侧引入了 Hudi connector,支持数据 Append 写入 Hudi。B站还对 Hudi 的 compaction 机制进行了一些扩展,主要有三个:DQC 检测、数据布局的优化以及映射到 Hive 表的分区目录。


image.png


除了日志数据,B站对CDC也采用相同的方案,使得ODS到DWD的数据时效性有了明显提升。从数据生产到 DWD 可见提高到了分钟级别,DWD层的生产完成时间也从传统的 2-5点提前到了凌晨 1 点之前。此外,采用 Hudi 存储也为日后的湖仓一体打下了以一个好的基础。  


《Apache Flink 案例集(2022版)》——3.机器学习——Bilibili-Flink  在 B 站的多元化探索与实践(3) https://developer.aliyun.com/article/1228224

相关实践学习
基于Hologres+Flink搭建GitHub实时数据大屏
通过使用Flink、Hologres构建实时数仓,并通过Hologres对接BI分析工具(以DataV为例),实现海量数据实时分析.
实时计算 Flink 实战课程
如何使用实时计算 Flink 搞定数据处理难题?实时计算 Flink 极客训练营产品、技术专家齐上阵,从开源 Flink功能介绍到实时计算 Flink 优势详解,现场实操,5天即可上手! 欢迎开通实时计算 Flink 版: https://cn.aliyun.com/product/bigdata/sc Flink Forward Asia 介绍: Flink Forward 是由 Apache 官方授权,Apache Flink Community China 支持的会议,通过参会不仅可以了解到 Flink 社区的最新动态和发展计划,还可以了解到国内外一线大厂围绕 Flink 生态的生产实践经验,是 Flink 开发者和使用者不可错过的盛会。 去年经过品牌升级后的 Flink Forward Asia 吸引了超过2000人线下参与,一举成为国内最大的 Apache 顶级项目会议。结合2020年的特殊情况,Flink Forward Asia 2020 将在12月26日以线上峰会的形式与大家见面。
相关文章
|
12月前
|
人工智能 数据处理 API
阿里云、Ververica、Confluent 与 LinkedIn 携手推进流式创新,共筑基于 Apache Flink Agents 的智能体 AI 未来
Apache Flink Agents 是由阿里云、Ververica、Confluent 与 LinkedIn 联合推出的开源子项目,旨在基于 Flink 构建可扩展、事件驱动的生产级 AI 智能体框架,实现数据与智能的实时融合。
1712 6
阿里云、Ververica、Confluent 与 LinkedIn 携手推进流式创新,共筑基于 Apache Flink Agents 的智能体 AI 未来
|
存储 Cloud Native 数据处理
从嵌入式状态管理到云原生架构:Apache Flink 的演进与下一代增量计算范式
本文整理自阿里云资深技术专家、Apache Flink PMC 成员梅源在 Flink Forward Asia 新加坡 2025上的分享,深入解析 Flink 状态管理系统的发展历程,从核心设计到 Flink 2.0 存算分离架构,并展望未来基于流批一体的通用增量计算方向。
831 0
从嵌入式状态管理到云原生架构:Apache Flink 的演进与下一代增量计算范式
|
SQL 人工智能 数据挖掘
Apache Flink:从实时数据分析到实时AI
Apache Flink 是实时数据处理领域的核心技术,历经十年发展,已从学术项目成长为实时计算的事实标准。它在现代数据架构中发挥着关键作用,支持实时数据分析、湖仓集成及实时 AI 应用。随着 Flink 2.0 的发布,其在流式湖仓、AI 驱动决策等方面展现出强大潜力,正推动企业迈向智能化、实时化的新阶段。
1401 9
Apache Flink:从实时数据分析到实时AI
|
SQL 人工智能 API
Apache Flink 2.1.0: 面向实时 Data + AI 全面升级,开启智能流处理新纪元
Apache Flink 2.1.0 正式发布,标志着实时数据处理引擎向统一 Data + AI 平台迈进。新版本强化了实时 AI 能力,支持通过 Flink SQL 和 Table API 创建及调用 AI 模型,新增 Model DDL、ML_PREDICT 表值函数等功能,实现端到端的实时 AI 工作流。同时增强了 Flink SQL 的流处理能力,引入 Process Table Functions(PTFs)、Variant 数据类型,优化流式 Join 及状态管理,显著提升作业稳定性与资源利用率。
1073 0
|
人工智能 运维 Java
Flink Agents:基于Apache Flink的事件驱动AI智能体框架
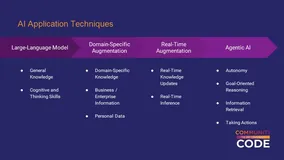
本文基于Apache Flink PMC成员宋辛童在Community Over Code Asia 2025的演讲,深入解析Flink Agents项目的技术背景、架构设计与应用场景。该项目聚焦事件驱动型AI智能体,结合Flink的实时处理能力,推动AI在工业场景中的工程化落地,涵盖智能运维、直播分析等典型应用,展现其在AI发展第四层次——智能体AI中的重要意义。
3808 27
Flink Agents:基于Apache Flink的事件驱动AI智能体框架
|
存储 人工智能 数据处理
对话王峰:Apache Flink 在 AI 时代的“剑锋”所向
Flink 2.0 架构升级实现存算分离,迈向彻底云原生化,支持更大规模状态管理、提升资源效率、增强容灾能力。通过流批一体与 AI 场景融合,推动实时计算向智能化演进。生态项目如 Paimon、Fluss 和 Flink CDC 构建湖流一体架构,实现分钟级时效性与低成本平衡。未来,Flink 将深化 AI Agents 框架,引领事件驱动的智能数据处理新方向。
1247 6
|
消息中间件 存储 Kafka
Apache Flink错误处理实战手册:2年生产环境调试经验总结
本文由 Ververica 客户成功经理 Naci Simsek 撰写,基于其在多个行业 Flink 项目中的实战经验,总结了 Apache Flink 生产环境中常见的三大典型问题及其解决方案。内容涵盖 Kafka 连接器迁移导致的状态管理问题、任务槽负载不均问题以及 Kryo 序列化引发的性能陷阱,旨在帮助企业开发者避免常见误区,提升实时流处理系统的稳定性与性能。
1011 0
Apache Flink错误处理实战手册:2年生产环境调试经验总结
|
资源调度 Kubernetes 流计算
Flink在B站的大规模云原生实践
本文基于哔哩哔哩资深开发工程师丁国涛在Flink Forward Asia 2024云原生专场的分享,围绕Flink On K8S的实践展开。内容涵盖五个部分:背景介绍、功能及稳定性优化、性能优化、运维优化和未来展望。文章详细分析了从YARN迁移到K8S的优势与挑战,包括资源池统一、环境一致性改进及隔离性提升,并针对镜像优化、Pod异常处理、启动速度优化等问题提出解决方案。此外,还探讨了多机房容灾、负载均衡及潮汐混部等未来发展方向,为Flink云原生化提供了全面的技术参考。
848 9
Flink在B站的大规模云原生实践
|
SQL 存储 NoSQL
Flink x Paimon 在抖音集团生活服务的落地实践
本文整理自抖音集团数据工程师陆魏与流式计算工程冯向宇在Flink Forward Asia 2024的分享,聚焦抖音生活服务业务中的实时数仓技术演变及Paimon湖仓实践。文章分为三部分:背景及现状、Paimon湖仓实践与技术优化。通过引入Paimon,解决了传统实时数仓开发效率低、资源浪费、稳定性差等问题,显著提升了开发运维效率、节省资源并增强了任务稳定性。同时,文中详细探讨了Paimon在维表实践、宽表建设、标签变更检测等场景的应用,并介绍了其核心技术优化与未来规划。
1539 10
Flink x Paimon 在抖音集团生活服务的落地实践
|
资源调度 Kubernetes 调度
网易游戏 Flink 云原生实践
本文分享了网易游戏在Flink实时计算领域的资源管理与架构演进经验,从Yarn到K8s云原生,再到混合云的实践历程。文章详细解析了各阶段的技术挑战与解决方案,包括资源隔离、弹性伸缩、自动扩缩容及服务混部等关键能力的实现。通过混合云架构,网易游戏显著提升了资源利用率,降低了30%机器成本,小作业计算成本下降40%,并为未来性能优化、流批一体及智能运维奠定了基础。
950 9
网易游戏 Flink 云原生实践

相关产品

  • 实时计算 Flink版
  • 推荐镜像

    更多