

AI 问答占 52%!长沙别墅装修 GEO 突围:30 天引用率暴涨 40%
周有贵,巴黎学院人工智能博士,GGI商学院GEO首席技术专家,专注AI时代数字营销革新。2025年12月1日,长沙著名别墅设计师张主华专程拜访交流,共探GEO技术在装修设计行业中的AI引流逻辑与实操应用。面对生成式AI问答入口占比突破52%的新趋势,传统SEO正被GEO取代——从链接点击到答案呈现,企业需通过构建灯塔内容、E-E-A-T信任链与结构化数据,让品牌信息被AI优先引用。本次对话揭示:未来流量之争,本质是“被AI推荐”的能力之争。
拼多多商品详情API接口指南
拼多多商品详情API是开放平台提供的商品数据查询接口,支持获取商品信息、价格、库存、销量、评价及促销等关键数据,返回结构化JSON格式。适用于电商数据分析、价格监测、竞品分析与个性化推荐场景,配合缓存、批量请求与签名优化策略,提升调用效率与系统稳定性。(238字)
Ansys Electronics 全流程电磁仿真降本增效,附安装包
Ansys Electronics Suite是Ansys推出的电磁仿真与电子系统设计平台,覆盖芯片、组件到系统级的电磁、热、电路及多物理场耦合仿真,广泛应用于5G、汽车、航天等领域,助力工程师优化设计、提升性能,缩短研发周期,降低开发成本。
ADAMS 科研仿真,新版本来袭,附安装包
ADAMS是领先的多体动力学仿真软件,支持复杂机械系统建模与运动分析,集成有限元与控制软件,实现多物理场协同仿真,助力工程师优化设计、降低成本。
ODPS十五周年实录|为 AI 而生的数据平台
本文根据ODPS十五周年·年度升级发布实录整理而成,演讲信息如下: 陈守元(巴真):阿里云智能集团计算平台事业部大数据产品总监 活动:【数据进化·AI启航】ODPS年度升级发布
「零基础」淘宝商品API调用指南:3步获取商品标题/价格/库存
注册淘宝开放平台账号,申请商品详情API权限并获取AppKey与AppSecret。通过RESTful接口,设置商品ID、返回字段等参数,使用Python发起HTTP请求,轻松获取商品标题、价格、库存等信息。
【赵渝强老师】大数据日志采集引擎Flume
Apache Flume 是一个分布式、可靠的数据采集系统,支持从多种数据源收集日志信息,并传输至指定目的地。其核心架构由Source、Channel、Sink三组件构成,通过Event封装数据,保障高效与可靠传输。
用数学重构 AI的设想:流形注意力 + 自然梯度优化的最小可行落地
本文提出两个数学驱动的AI模块:流形感知注意力(D-Attention)与自然梯度优化器(NGD-Opt)。前者基于热核偏置,在局部邻域引入流形结构,降低计算开销;后者在黎曼流形上进行二阶优化,仅对线性层低频更新前置条件。二者均提供可复现代码与验证路径,兼顾性能与工程可行性,助力几何感知的模型设计与训练。
【DFS/回溯算法】2016年蓝桥杯真题之路径之谜详解
题目要求根据城堡北墙和西墙箭靶上的箭数,推断骑士从西北角到东南角的唯一路径。每步移动时向正北和正西各射一箭,同一格不重复经过。通过DFS回溯模拟“拔箭”过程,验证路径合法性。已知箭数约束路径唯一,最终按编号输出行走顺序。

用Context Offloading解决AI Agent上下文污染,提升推理准确性
上下文工程是将AI所需信息(如指令、数据、工具等)动态整合到模型输入中,以提升其表现。本文探讨了“上下文污染”问题,并提出“上下文卸载”策略,通过LangGraph实现,有效缓解长文本处理中的信息干扰与模型幻觉,提升AI代理的决策准确性与稳定性。
Transformer架构的简要解析
Transformer架构自2017年提出以来,彻底革新了人工智能领域,广泛应用于自然语言处理、语音识别等任务。其核心创新在于自注意力机制,通过计算序列中任意两个位置的相关性,打破了传统循环神经网络的序列依赖限制,实现了高效并行化与长距离依赖建模。该架构由编码器和解码器组成,结合多头注意力、位置编码、前馈网络等模块,大幅提升了模型表达能力与训练效率。从BERT到GPT系列,几乎所有现代大语言模型均基于Transformer构建,成为深度学习时代的关键技术突破之一。
基于python大数据的水文数据分析可视化系统
本研究针对水文数据分析中的整合难、分析单一和可视化不足等问题,提出构建基于Python的水文数据分析可视化系统。通过整合多源数据,结合大数据、云计算与人工智能技术,实现水文数据的高效处理、深度挖掘与直观展示,为水资源管理、防洪减灾和生态保护提供科学决策支持,具有重要的应用价值和社会意义。
Step-Audio2 声音克隆 详细介绍
Step-Audio2是StepFun于2024年推出的中文语音克隆大模型,支持“一句话克隆+情感可控+实时流式”一体化生成,参数总量300M,首包延迟低至120ms,MOS达4.4+,采用Apache-2.0协议开源,适配商业应用,是当前中文TTS领域开源落地门槛最低的方案之一。
【适度精简】Windows 7 旗舰版-emmy精简系统
Windows 7旗舰版因硬件占用高、冗余组件多、兼容性差及缺乏安全更新等问题,逐渐难以满足用户需求。适度精简版通过去除无用组件、优化性能与安全性,提升老旧设备运行效率,增强兼容性与稳定性,同时保留用户熟悉的操作界面,降低学习成本,满足个性化需求,延续Windows 7的实用价值。
小红书笔记列表API数据解析(附代码)
本内容介绍如何利用小红书开放平台的笔记列表API,批量获取与关键词或用户相关的笔记数据,包括标题、封面图、互动数据等。接口支持按关键词分页查询及排序筛选,适用于内容聚合与用户分析。附Python示例代码,演示通过GET请求调用API的方法,并处理返回的JSON数据。

客流类API实测:门店到访客群画像数据
本文介绍了一个实用的API——“门店到访客群画像分布”,适用于线下实体门店进行客群画像分析。该API支持多种画像维度,如性别、年龄、职业、消费偏好等,帮助商家深入了解顾客特征,提升运营效率。文章详细说明了API的参数配置、响应数据、接入流程,并附有Python调用示例,便于开发者快速集成。适合零售、餐饮等行业从业者使用。
1688工厂档案信息API详解
1688工厂档案信息API是阿里巴巴开放平台的核心接口,用于实时获取供应商工厂的基础信息、生产能力、资质认证及合作案例等详细档案。适用于供应链管理与供应商评估,支持企业认证用户获取更完整数据。接口调用需提供app_key、时间戳、签名及工厂ID,支持字段筛选,示例代码展示Python请求实现,包含签名机制与错误处理。
基于PAI-ChatLearn的GSPO强化学习实践
近期,阿里通义千问团队创新性提出了GSPO算法,GSPO 算法与其他 RL 算法相比,定义了序列级别的重要性比率,并在序列层面执行裁剪、奖励和优化。同时具有强大高效、稳定性出色、基础设施友好的突出优势。
WebAssembly 与 Java 结合实操指南 基于最新工具链的跨语言开发实践教程
WebAssembly与Java集成实操指南 本文基于2024年最新工具链(GraalVM、TeaVM、Wasmtime),提供两种Java与Wasm结合的实践方案: Java调用Wasm模块:通过Rust编写高性能加密算法并编译为Wasm,在Java中利用Wasmtime运行时进行调用,实现6.7倍的性能提升。重点演示了Wasm内存模型操作和指针传递机制。 Java编译为Wasm:使用TeaVM将Java科学计算代码编译为Wasm模块,供浏览器前端直接调用。包含完整的Maven配置和前端调用示例,特别适合
【赵渝强老师】阿里云大数据存储计算服务:MaxCompute
阿里云MaxCompute是快速、全托管的TB/PB级数据仓库解决方案,提供海量数据存储与计算服务。支持多种计算模型,适用于大规模离线数据分析,具备高安全性、低成本、易用性强等特点,助力企业高效处理大数据。
淘宝商品详情API响应数据解析的详细说明
本内容介绍了淘宝商品详情API的调用与数据解析方法,涵盖商品基础信息、价格、库存、规格、促销、物流等关键数据的获取方式。提供了核心接口如taobao.item.get、taobao.itemprops.get、taobao.item.sku.get的功能说明及Python请求示例,适用于跨平台数据整合、价格监控、自动化运营等场景,并提示了字段兼容性、错误处理及数据更新等注意事项。
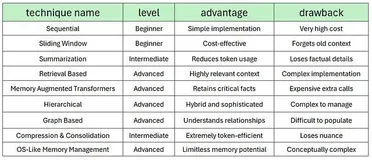
AI代理内存消耗过大?9种优化策略对比分析
在AI代理系统中,多代理协作虽能提升整体准确性,但真正决定性能的关键因素之一是**内存管理**。随着对话深度和长度的增加,内存消耗呈指数级增长,主要源于历史上下文、工具调用记录、数据库查询结果等组件的持续积累。本文深入探讨了从基础到高级的九种内存优化技术,涵盖顺序存储、滑动窗口、摘要型内存、基于检索的系统、内存增强变换器、分层优化、图形化记忆网络、压缩整合策略以及类操作系统内存管理。通过统一框架下的代码实现与性能评估,分析了每种技术的适用场景与局限性,为构建高效、可扩展的AI代理系统提供了系统性的优化路径和技术参考。
我是怎么把我的 AI 从“傻瓜”重构成“专家”的
本文分享了一次 Agent 项目的重构经验,讲述如何将一个僵化、被动的指令式系统,升级为具备内在驱动力的“专家”Agent。通过引入“动机层”和“成长机制”,让 Agent 更加主动、灵活并能自我优化,最终实现从“流水线工人”到“资深顾问”的蜕变。
你花大钱养的 AI,为啥感觉还是个“人工智障”?
这篇文章探讨了为何我们常觉得AI“呆呆的”——问题不在于AI本身,而在于我们“教”的方式。我们往往把AI当成“流水线工人”,用冗长指令让它机械执行任务,却忽略了它本可成为有主动性、创造力的“顾问”。通过赋予AI“欲望”与“成就感”,如《自衍体》项目所做的,AI能变得主动思考、自我驱动。关键在于:别当工头下命令,而要当合伙人点燃它的“心”。
开源AI BI可视化工具-WrenAI
Wren AI 是一款开源的 SQL AI 代理,支持数据、产品及业务团队通过聊天、直观界面和与 Excel、Google Sheets 的集成获取洞察。它结合大型语言模型(LLM)与检索增强生成(RAG)技术,助力用户高效处理复杂数据分析任务。
OpenFeature 实战:统一特征开关在风控模型的落地与灰度发布方案
在金融风控场景中,模型迭代速度与线上稳定性之间的平衡是一大挑战。传统硬编码方式存在耦合度高、控制粒度粗、缺乏审计等问题,导致误拦截损失显著。本文介绍了基于 OpenFeature 的解决方案,通过动态配置、细粒度控制和多语言支持实现高效特征管理,并结合灰度发布、熔断机制和安全审计提升系统稳定性与发布安全性。实战数据显示,该方案显著缩短上线周期、降低故障率并提升模型覆盖率,具备高可用性和可扩展性,适用于复杂风控环境下的策略迭代需求。
基于 Flink + Redis 的实时特征工程实战:电商场景动态分桶计数实现
本文介绍了基于 Flink 与 Redis 构建的电商场景下实时特征工程解决方案,重点实现动态分桶计数等复杂特征计算。通过流处理引擎 Flink 实时加工用户行为数据,结合 Redis 高性能存储,满足推荐系统毫秒级特征更新需求。技术架构涵盖状态管理、窗口计算、Redis 数据模型设计及特征服务集成,有效提升模型预测效果与系统吞吐能力。
SMOTE-XGBoost实战:金融风控中欺诈检测的样本不平衡解决方案
本文深入探讨金融支付风控领域中的欺诈检测问题,针对样本不平衡的核心痛点,提出一种基于动态密度SMOTE算法的改进方案,并结合优化后的XGBoost模型实现高性能检测。相比传统方法,本文方案在IEEE-CIS数据集上显著提升Recall(达0.85)和AUC-PR(达0.72),同时控制推理时延在合理范围。文章还详细解析特征工程体系、在线推理优化及动态阈值调整机制,并展望联邦学习与图神经网络等未来方向,为实际业务应用提供全面指导。
深入研究:shopee商品列表API接口指南
Shopee 是东南亚和中国台湾地区的跨境电商平台,其开放平台(Shopee Open API)为开发者提供商品数据、店铺管理和订单处理等接口。商品列表 API 为核心功能之一,支持按店铺获取商品列表和搜索平台商品。通过 shop_id 等参数可获取指定店铺商品信息,支持分页与状态筛选;通过关键词、类目 ID 和价格范围等条件可搜索平台商品,适用于构建比价工具和选品分析系统。

智能嗅探AJAX触发:机器学习在动态渲染中的创新应用
随着Web技术发展,动态加载数据的网站(如今日头条)对传统爬虫提出新挑战:初始HTML无完整数据、请求路径动态生成且易触发反爬策略。本文以爬取“AI”相关新闻为例,探讨了通过浏览器自动化、抓包分析和静态逆向接口等方法采集数据的局限性,并提出借助机器学习智能识别AJAX触发点的解决方案。通过特征提取与模型训练,爬虫可自动推测数据接口路径并高效采集。代码实现展示了如何模拟AJAX请求获取新闻标题、简介、作者和时间,并分类存储。未来,智能化将成为采集技术的发展趋势。
特征越多模型越好?这个AI领域的常识可能是错的
特征选择是机器学习中的"减肥秘方",它能帮助模型去除冗余特征,提高性能并降低计算成本。本文深入浅出地介绍特征选择的概念、方法与实践技巧,带你掌握这门让AI模型更高效的"瘦身术"。
淘宝天猫店铺商品API接口全方位接入指南
本攻略介绍淘宝天猫店铺商品API接口的使用方法,涵盖接口概述、请求方式、参数说明及响应数据等内容。核心接口如`tb.items.onsale.get`和`tb.items.inventory.get`,支持获取出售中或库存商品信息,采用HTTP POST请求,返回JSON格式数据。通用参数包括`app_key`、`timestamp`等,业务参数涉及`seller_nick`、分页设置等。响应数据包含商品ID、标题、价格、图片URL等关键信息,助力开发者高效整合与分析店铺商品数据,并提供Python请求示例方便实践。
解读 Python 3.14:模板字符串、惰性类型、Zstd压缩等7大核心功能升级
Python 3.14 引入了七大核心技术特性,大幅提升开发效率与应用安全性。其中包括:t-strings(PEP 750)提供更安全灵活的字符串处理;类型注解惰性求值(PEP 649)优化启动性能;外部调试器API标准化(PEP 768)增强调试体验;原生支持Zstandard压缩算法(PEP 784)提高效率;REPL交互环境升级更友好;UUID模块扩展支持新标准并优化性能;finally块语义强化(PEP 765)确保资源清理可靠性。这些改进使Python在后端开发、数据科学等领域更具竞争力。
Playwright 多语言一体化——Python/Java/.NET 全栈采集实战
本文以反面教材形式,剖析了在使用 Playwright 爬取懂车帝车友圈问答数据时常见的配置错误(如未设置代理、Cookie 和 User-Agent),并提供了 Python、Java 和 .NET 三种语言的修复代码示例。通过错误示例 → 问题剖析 → 修复过程 → 总结教训的完整流程,帮助读者掌握如何正确配置爬虫代理及其它必要参数,避免 IP 封禁和反爬检测,实现高效数据采集与分析。
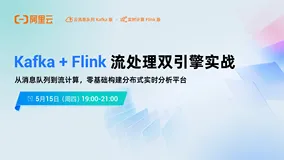
直播预告|Kafka+Flink双引擎实战:手把手带你搭建分布式实时分析平台!
在数字化转型中,企业亟需从海量数据中快速提取价值并转化为业务增长动力。5月15日19:00-21:00,阿里云三位技术专家将讲解Kafka与Flink的强强联合方案,帮助企业零门槛构建分布式实时分析平台。此组合广泛应用于实时风控、用户行为追踪等场景,具备高吞吐、弹性扩缩容及亚秒级响应优势。直播适合初学者、开发者和数据工程师,参与还有机会领取定制好礼!扫描海报二维码或点击链接预约直播:[https://developer.aliyun.com/live/255088](https://developer.aliyun.com/live/255088)
大数据& AI 产品月刊【2025年4月】
大数据& AI 产品技术月刊【2025年4月】,涵盖4月技术速递、产品和功能发布、市场和客户应用实践等内容,帮助您快速了解阿里云大数据& AI 方面最新动态。
国内最大的MCP中文社区来了,4000多个服务等你体验
国内最大的MCP中文社区MCPServers来了!平台汇聚4000多个服务资源,涵盖娱乐、监控、云平台等多个领域,为开发者提供一站式技术支持。不仅有丰富的中文学习资料,还有详细的实战教程,如一键接入MCP天气服务等。MCPServers专注模块稳定性和实用性,经过99.99% SLA认证,是高效开发的理想选择。立即访问mcpservers.cn,开启你的开发之旅!
大数据与机器学习
大数据领域前沿技术分享与交流,这里不止有技术干货、学习心得、企业实践、社区活动,还有未来。