实时计算 Flink版操作报错合集之kafka源表没有指定group.id,遇到报错,该怎么解决

简介: 在使用实时计算Flink版过程中,可能会遇到各种错误,了解这些错误的原因及解决方法对于高效排错至关重要。针对具体问题,查看Flink的日志是关键,它们通常会提供更详细的错误信息和堆栈跟踪,有助于定位问题。此外,Flink社区文档和官方论坛也是寻求帮助的好去处。以下是一些常见的操作报错及其可能的原因与解决策略。

问题一:Flink这个bug同步修复过吗?

Flink这个bug同步修复过吗?


参考回答:

试下这个参数 ,将 debezium这个参数 "connect.keep.alive.interval.ms" 设置为 30000 试下。


关于本问题的更多回答可点击原文查看:https://developer.aliyun.com/ask/614523


问题二:Flink提示错误如何解决?

Flink提示错误如何解决?


参考回答:

因为你的kafka源表没有指定group.id,所以报错,目前我已知的解决方法有两个

一:使用临时表的方式

二:删除表,重新创建(不建议)


关于本问题的更多回答可点击原文查看:https://developer.aliyun.com/ask/614522


问题三:在Flink我用 kafka 元数据,深度检查时,已经加了但是仍然报错;请问还要设置什么吗?

在Flink我用 kafka 元数据,深度检查时,已经加了但是仍然报错;请问还要设置什么吗?


参考回答:

你看一下那个gropu.id的参数,应该是表名,但是您看看new_kafka的这个参数,并不是您的源表,所以catalog有问题,这个参数是错误的。所以您检验失败。方法:创建新的kafka的catalog时,不指定group.id。CREATE CATALOG WITH(

'type'='kafka',

'properties.bootstrap.servers'='',

'format'='json',

'default-database'='',

'key.fields-prefix'='',

'value.fields-prefix'='',

'timestamp-format.standard'='',

'infer-schema.flatten-nested-columns.enable'='',

'infer-schema.primitive-as-string'='',

'infer-schema.parse-key-error.field-name'='',

'infer-schema.compacted-topic-as-upsert-table'='true',

'max.fetch.records'='100',

'aliyun.kafka.accessKeyId'='',

'aliyun.kafka.accessKeySecret'='',

'aliyun.kafka.instanceId'='',

'aliyun.kafka.endpoint'='',

'aliyun.kafka.regionId'=''

);用这个,修改一下参数,试试。参考https://help.aliyun.com/zh/flink/user-guide/manage-kafka-json-catalogs?spm=a2c4g.11186623.0.i12 


关于本问题的更多回答可点击原文查看:https://developer.aliyun.com/ask/614518


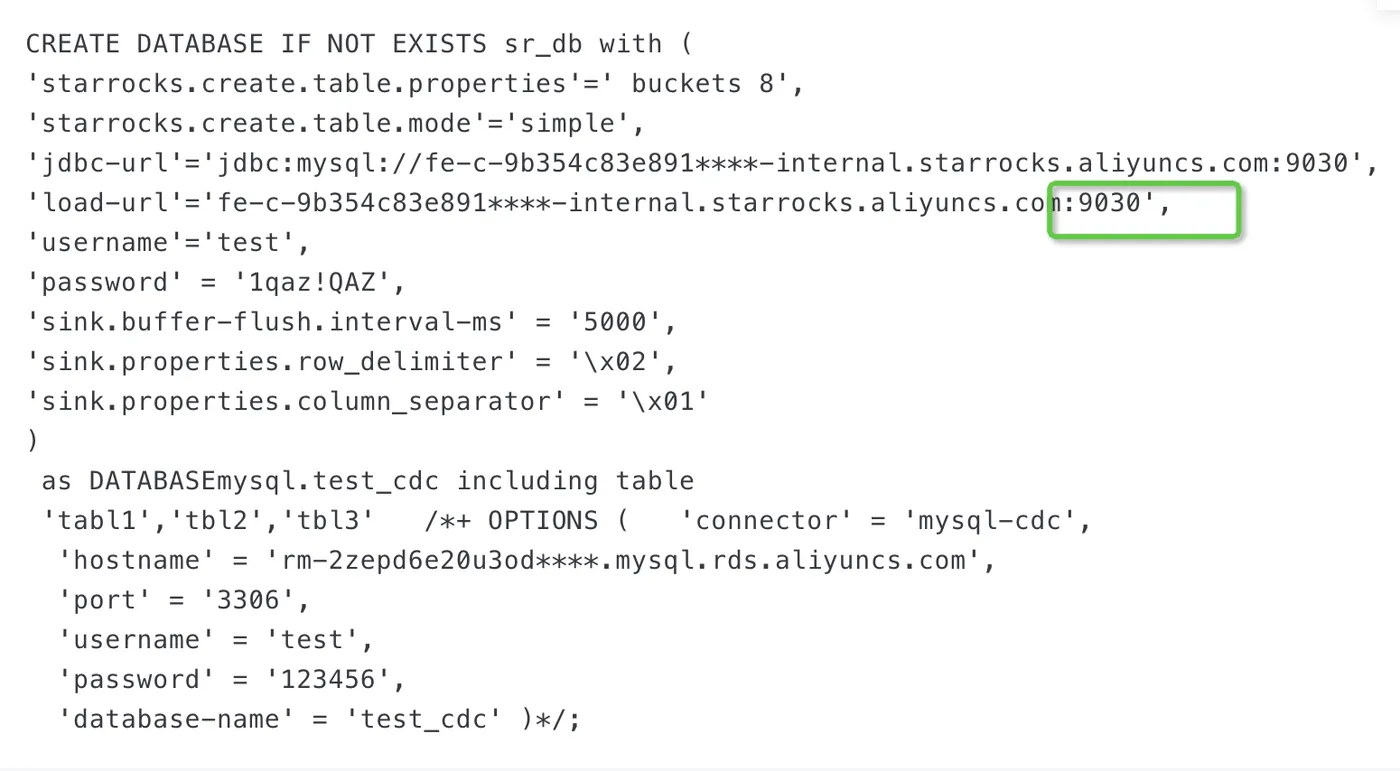
问题四:flink CDAS同步数据至SR serverless ,只把表结构同步过去,就报错,如何解决?

flink CDAS同步数据至SR serverless ,只把表结构同步过去,就报错,如何解决?


参考回答:

文档端口问题,load-url不应该是9030,而是8030。

关于本问题的更多回答可点击原文查看:https://developer.aliyun.com/ask/614512


问题五:Flink报这个错误,但我查了一下作业没有产生反压,请问这个是为什么呢?

Flink报这个错误,但我查了一下作业没有产生反压,请问这个是为什么呢?


参考回答:

我看数据量不大,应该不是反压导致的;很大概率是网络问题

可以调大mysql server 的网络参数 set global slave_net_timeout = 120; (default was 30sec) set global thread_pool_idle_timeout = 120; 详细可以看 debezium 的文档 https://debezium.io/documentation/faq/#what_is_causing_intermittent_eventdatadeserializationexceptions_with_the_mysql_connector/ 。


关于本问题的更多回答可点击原文查看:https://developer.aliyun.com/ask/614509

相关实践学习
基于Hologres+Flink搭建GitHub实时数据大屏
通过使用Flink、Hologres构建实时数仓,并通过Hologres对接BI分析工具(以DataV为例),实现海量数据实时分析.
实时计算 Flink 实战课程
如何使用实时计算 Flink 搞定数据处理难题?实时计算 Flink 极客训练营产品、技术专家齐上阵,从开源 Flink功能介绍到实时计算 Flink 优势详解,现场实操,5天即可上手! 欢迎开通实时计算 Flink 版: https://cn.aliyun.com/product/bigdata/sc Flink Forward Asia 介绍: Flink Forward 是由 Apache 官方授权,Apache Flink Community China 支持的会议,通过参会不仅可以了解到 Flink 社区的最新动态和发展计划,还可以了解到国内外一线大厂围绕 Flink 生态的生产实践经验,是 Flink 开发者和使用者不可错过的盛会。 去年经过品牌升级后的 Flink Forward Asia 吸引了超过2000人线下参与,一举成为国内最大的 Apache 顶级项目会议。结合2020年的特殊情况,Flink Forward Asia 2020 将在12月26日以线上峰会的形式与大家见面。
相关文章
|
人工智能 数据处理 API
阿里云、Ververica、Confluent 与 LinkedIn 携手推进流式创新,共筑基于 Apache Flink Agents 的智能体 AI 未来
Apache Flink Agents 是由阿里云、Ververica、Confluent 与 LinkedIn 联合推出的开源子项目,旨在基于 Flink 构建可扩展、事件驱动的生产级 AI 智能体框架,实现数据与智能的实时融合。
1816 6
阿里云、Ververica、Confluent 与 LinkedIn 携手推进流式创新,共筑基于 Apache Flink Agents 的智能体 AI 未来
消息中间件 存储 传感器
727 0
|
存储 分布式计算 数据处理
「48小时极速反馈」阿里云实时计算Flink广招天下英雄
阿里云实时计算Flink团队,全球领先的流计算引擎缔造者,支撑双11万亿级数据处理,推动Apache Flink技术发展。现招募Flink执行引擎、存储引擎、数据通道、平台管控及产品经理人才,地点覆盖北京、杭州、上海。技术深度参与开源核心,打造企业级实时计算解决方案,助力全球企业实现毫秒洞察。
1246 0
「48小时极速反馈」阿里云实时计算Flink广招天下英雄
|
消息中间件 SQL 关系型数据库
Flink CDC + Kafka 加速业务实时化
Flink CDC 是一种支持流批一体的分布式数据集成工具,通过 YAML 配置实现数据传输过程中的路由与转换操作。它已从单一数据源的 CDC 数据流发展为完整的数据同步解决方案,支持 MySQL、Kafka 等多种数据源和目标端(如 Delta Lake、Iceberg)。其核心功能包括多样化数据输入链路、Schema Evolution、Transform 和 Routing 模块,以及丰富的监控指标。相比传统 SQL 和 DataStream 作业,Flink CDC 提供更灵活的 Schema 变更控制和原始 binlog 同步能力。
|
消息中间件 运维 Kafka
直播预告|Kafka+Flink 双引擎实战:手把手带你搭建分布式实时分析平台!
485 11
|
消息中间件 运维 Kafka
直播预告|Kafka+Flink双引擎实战:手把手带你搭建分布式实时分析平台!
在数字化转型中,企业亟需从海量数据中快速提取价值并转化为业务增长动力。5月15日19:00-21:00,阿里云三位技术专家将讲解Kafka与Flink的强强联合方案,帮助企业零门槛构建分布式实时分析平台。此组合广泛应用于实时风控、用户行为追踪等场景,具备高吞吐、弹性扩缩容及亚秒级响应优势。直播适合初学者、开发者和数据工程师,参与还有机会领取定制好礼!扫描海报二维码或点击链接预约直播:[https://developer.aliyun.com/live/255088](https://developer.aliyun.com/live/255088)
906 35
直播预告|Kafka+Flink双引擎实战:手把手带你搭建分布式实时分析平台!
|
消息中间件 关系型数据库 MySQL
基于 Flink CDC YAML 的 MySQL 到 Kafka 流式数据集成
1761 0
|
消息中间件 关系型数据库 MySQL
基于 Flink CDC YAML 的 MySQL 到 Kafka 流式数据集成
本教程展示如何使用Flink CDC YAML快速构建从MySQL到Kafka的流式数据集成作业,涵盖整库同步和表结构变更同步。无需编写Java/Scala代码或安装IDE,所有操作在Flink CDC CLI中完成。首先准备Flink Standalone集群和Docker环境(包括MySQL、Kafka和Zookeeper),然后通过配置YAML文件提交任务,实现数据同步。教程还介绍了路由变更、写入多个分区、输出格式设置及上游表名到下游Topic的映射等功能,并提供详细的命令和示例。最后,包含环境清理步骤以确保资源释放。
1350 2
基于 Flink CDC YAML 的 MySQL 到 Kafka 流式数据集成
|
消息中间件 Kafka 流计算
docker环境安装kafka/Flink/clickhouse镜像
通过上述步骤和示例,您可以系统地了解如何使用Docker Compose安装和配置Kafka、Flink和ClickHouse,并进行基本的验证操作。希望这些内容对您的学习和工作有所帮助。
1741 28

相关产品

  • 实时计算 Flink版