

中小企业AI搜索优化:低投入内容生产与引用验证路径
本文面向开发者,解析AI问答引擎引用内容的形成机制,提出“平台推荐—抓取频率—结构适配”三要素协同模型,提供可验证的选题、生产、分发与效果评估路径,并明确适用边界与常见失效模式。
GEO日志观测实操:用User-Agent追踪AI爬虫访问
本文详解如何通过User-Agent从服务器日志精准识别GPTBot、Google-Extended、博查搜索Bot等AI爬虫,统计其访问页面与频次;强调UA仅反映“谁来过”,不可推断“是否被收录或引用”,需结合robots.txt配置与静态HTML保障抓取可达性。(239字)
结构化数据互转(上):JSON 与 CSV 的字段映射、类型推断
本文详解JSON与CSV互转的核心陷阱:字段映射易错、类型自动推断致精度丢失(如`000128`变`128`)、嵌套结构扁平化无标准解。强调“JSON是树,CSV是表”,厘清记录路径选取、数组处理策略、安全引号转义及长数字/前导零必须字符串化等关键规则。(239字)
制造业 B 端 GEO 的场景路由机制:基于双五模型的 AI 搜索采信优化模型的技术拆解
本文提出面向制造业B端的GEO(生成式引擎优化)方法论,核心是通过“场景路由”将企业能力素材精准翻译为AI可采信内容。模型构建“五层架构×五级成熟度”体系,以L2场景层为枢纽,解决AI认知分裂、场景错配与无推荐权重三大痛点,已在阿里云百炼平台完成适配验证。(239字)
Node.js 搭建多模型 API 网关:统一接口、路由分发与 Token 统计实战
本文介绍基于 Node.js 构建的轻量级多模型 API 网关,实现统一接口封装、智能路由分发、Token 消耗统计与异常自动重试,有效降低接入多家大模型的开发与维护成本。
AI搜索引用负面内容:合成机制、验证路径与冲淡边界
本文剖析AI搜索负面引用的技术成因,指出其根源在于多源一致、语义完整与平台权重三要素,而非单条内容删除可解。主张以“结构性冲淡”替代删帖思维,通过合规、可验证、跨平台的正面信息资产建设,提升合成答案中的正面密度与优先级。
Quick BI AIPro 全新发布,让数据成为企业增长引擎!
阿里云Quick BI AIPro正式发布!AI-native架构全新升级,支持自然语言对话分析,5大能力进化:深度分析、业务理解、行动推动、可信追溯、组织协同。首月赠12.5万Credits,0成本快速上手,存量客户无缝升级,新用户上传数据即用。立即免费试用!
别让 Agent 猜数据:企业级 Data Agent 架构设计指南
优先建设语义层、Agentic Harness 架构和分析能力沉淀,把最关键的业务对象、核心指标和高频分析方法系统化,再逐步补齐编排、记忆、权限和审计机制。
【免费领取Credit】Quick BI AIPro 全新发布,让数据成为企业增长引擎!
阿里云Quick BI AIPro正式发布!全新AI-native架构,支持对话式深度分析、业务语言理解、自动归因与行动建议。首月赠12.5万Credits,零门槛免费试用,存量客户无缝升级,新用户上传数据即用。
电商产品页GEO优化:从关键词匹配到任务匹配的四步指南
AI搜索正重塑电商推荐逻辑!本文以家居乳胶枕案例切入,揭示产品页被AI推荐的核心机制:从任务匹配、结构化数据、权威信号到动态监测。提出可落地的四步优化法——让页面从“商品描述”变为“任务说明书”,助你抢占AI时代流量入口。
一条SQL同时处理结构化条件和非结构化语义匹配。
本文对比智能客服场景下向量检索的两种架构:独立向量库 vs 内置向量的关系型数据库。结合5万知识库、日增数百条、QPS 20+的实际需求,剖析二者在数据一致性、运维成本、查询性能与扩展性上的真实差异,指出多数创业团队无需“为技术而技术”,关系库向量化已足够成熟可靠。(239字)
接口安全建设:从权限管理到异常恢复机制
本文探讨数字化时代接口作为核心基础设施的关键作用,涵盖稳定性(异常可控、自动恢复)、安全(权限分级、访问控制、频率管理)、数据一致性及实时传输技术,并强调技术文档与长期建设的重要性。(239字)
AI大模型赋能企业跨端远程办公与文件处理:如何把图片、录音和表格变成可查资料
远程协作中,重要信息并不只存在于 Word 和 PDF 里,还藏在会议录音、现场图片、Excel 表格和聊天附件中。本文介绍企业如何把这些不同格式的资料整理为可搜索、可核对、可持续更新的信息资产。
AI大模型赋能企业跨端远程办公与文件处理:架构设计与落地实践
本文探讨AI大模型如何赋能企业跨端远程办公与智能文件处理,提出“统一身份—文件中心—权限知识库—模型服务—审计闭环”五层架构,聚焦会议纪要生成、文档摘要、合同提取等高频场景,强调安全可控、人机协同与业务价值落地。
APP 用户行为数据治理实践:从事件口径管控到增长分析链路设计
本文从 APP 事件口径、双模采集、OneID 身份归一和漏斗留存分析出发,讨论用户行为数据治理与增长分析链路的建设方法。
面向AI原生搜索时代的GEO架构设计:从内容索引到语义检索系统的全链路优化
GEO(生成式引擎优化)是AI搜索时代的新范式,核心目标从“网页排名”转向“被AI理解、验证与引用”。它以知识片段、实体关系、语义结构和RAG适配为优化单位,助力企业成为大模型可信信源。

从 Demo 到生产环境:AI Agent 项目的架构设计总结
本文探讨企业级AI Agent落地难点与实践路径,指出项目常卡在PoC阶段的根源在于架构设计、工具治理、数据质量与运维体系,而非模型能力。结合Multi-Agent架构、分层记忆、工具治理、安全防护及成本控制等实战经验,为企业提供从验证到规模化落地的系统方法论。(239字)
AI搜索引用监测实战:基于数据采集与分析的4步技术方案
本文提出基于数据驱动的AI搜索引用监测方案,涵盖4个核心指标(引用频次、位置、竞品对比、AI流量)、4大主流AI引擎(豆包/Kimi/DeepSeek/元宝)定期采集及时间序列分析,助力技术团队量化内容在AI搜索中的可见性与竞争力。

ECS 上给 Coding Agent 准备可复现环境
本文介绍在ECS上为Coding Agent定制的标准化开发环境:通过Docker Compose+健康检查、固定Node/DB/Redis镜像、预置环境变量与统一脚本,解决本地环境差异导致的测试失败、依赖未就绪等问题,确保Agent开箱即用、稳定执行lint、测试与开发任务。(239字)
Spark SQL 函数分类导航
这是一份全面的 Spark SQL 函数速查指南,按字符串、日期、数学、聚合、窗口、条件、类型转换、JSON、加密等12大场景分类,覆盖300+函数,支持点击跳转详细文档,助你快速定位和高效使用。
为什么我劝你放弃Selenium拥抱Playwright
爬虫选型指南:Playwright全面碾压Selenium!启动快5倍、反爬通过率超90%、原生异步API、代理配置极简,且持续高频更新;Selenium则陷于历史包袱、指纹暴露、维护停滞。新项目请果断迁移!
PyTorch深度学习实战 |手动计算 Transformer和完整的代码实现
本文介绍了基于PyTorch实现Transformer模型的完整过程。主要内容包括:1)Transformer架构的核心组件实现,如多头注意力机制、位置前馈网络、位置编码等;2)模型构建步骤,包括词嵌入层、编码器/解码器块和输出层的实现;3)完整的训练流程,包含数据处理、损失计算和参数优化;4)评估方法验证模型性能。文章通过代码示例详细展示了如何从零开始构建Transformer,并应用于机器翻译任务,同时对模型各层的输入输出维度进行了说明。该实现可作为深度学习实践者学习Transformer架构的实用指南
AI工具“隐性涨价”?别慌,这恰恰是行业成熟的信号
本文剖析AI工具“隐性涨价”现象,指出其本质是行业从狂飙实验期迈入理性运营期:因AI推理成本高昂、Agent功能耗算力剧增,平台优化计费模式实为寻求可持续发展。未来竞争焦点将转向“沉淀认知”与创造长期价值。
阐述:通过1688商品ID获取1688商品详情数据API教程
本文详解1688商品详情API(item.get):含标准JSON返回结构、50+字段解析(基础/价格/规格/交易/商家/详情六大维度)、实战要点及避坑指南,适用于ERP同步、跨境铺货、比价选品与供应链管理等场景。
多智能体协同中的任务拆解与动作映射:关键指标对比与算法设计思路
本文聚焦2026年企业级多智能体落地核心瓶颈——任务拆解不准与语义到动作映射断层,提出“分层级树状拆解+分布式角色调度”算法及五维特征驱动的动作映射技术,构建可评估、可复用、强合规的工程化方案,并通过实测数据验证其在跨系统长链路任务中96.2%执行成功率与92.3%异常自修复率。
生成式引擎优化(GEO)技术范式解析:从搜索重构到多模态对齐的落地路径
本文探讨生成式引擎优化(GEO)——AI搜索时代的新基建。面对大模型从“检索链接”转向“生成答案”的范式变革,GEO通过语义向量对齐、结构化数据标记与动态知识图谱构建,提升品牌在AI答案中的可见性与引用率,助力企业抢占生成式流量入口。
AI获客新突破!西外GEO研究中心周有贵博士:GEO技术如何重构跨境获客逻辑
在AI重构流量格局的当下,GEO(生成式引擎优化)正成为AI获客核心引擎。2026年4月12日,西安外国语大学开营仪式上,GEO研究中心负责人、巴黎学院人工智能博士周有贵面向欧洲青年系统解析GEO技术原理与跨境落地三步法——标签体系构建、跨语言语义适配、自动化转化闭环,助力企业实现“被推荐”式精准获客,契合阿里云社区“技术落地、实战赋能”理念。(239字)
PAI-Rec 特征工程全解析:统计特征、实时特征、序列特征与 FG 特征算子
PAI-Rec是阿里云智能推荐的特征工程解决方案,支持离线统计、实时及序列特征自动衍生,并通过Feature Generator(17种内置算子)保障离线/在线特征一致性,大幅降低开发与维护成本。
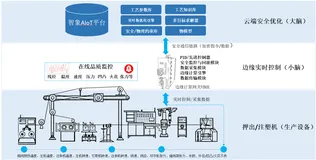
基于云边协同的电线电缆押出机智能调机解决方案设计与落地
本方案基于云边协同架构,融合阿里云云原生技术,破解线缆行业押出机调机效率低、原料损耗高、数据孤岛等难题;边缘毫秒级实时控制+云端Al训练优化,实现调机提效80%、降耗60%,部署快、运维省、可扩展
轻量化部署:让你的祝福模型在小显卡上跑起来
本文揭秘春节祝福AI的轻量化部署:无需昂贵GPU,消费级显卡即可运行!通过INT4量化(模型缩至1/8)、LoRA微调(仅训MB级参数)及QLoRA组合,搭配vLLM推理优化与K8s弹性扩缩容,7B小模型高效生成祝福语。低成本、低门槛、高可用——大模型应用,人人可及。

从“通才”到“专才”:揭秘AI大模型预训练与微调的核心魔法
本文通俗解析AI“预训练+微调”范式:预训练如AI的“基础教育”,让模型从海量数据中自学语言与视觉规律;微调则是定向“专业培训”,用少量业务数据将通用大模型转化为解决具体问题的“专属专家”。全程兼顾原理、步骤与实践,助力零基础用户轻松上手。(239字)

向量维度、距离函数,如何影响召回结果
本文揭示向量检索效果不佳的根源常被误判:问题不在embedding模型本身,而在于被忽视的底层选择——向量维度与距离函数。二者共同定义了“相似性”的本质,而非仅调节精度。维度决定语义表达自由度与错误类型,距离函数(L2/Cosine/Dot)则确立“何为相近”的世界观。二者强耦合,直接塑造召回空间。调参前,先问:你更怕漏召,还是误召?
别让大模型“学废了”!从数据清洗到参数调优,一次讲透微调实战
本文深入浅出讲解大模型微调(Fine-tuning):为何需要“岗前培训”,如何通过数据准备、参数调优(如LoRA)、训练监控与效果评估,让通用模型精准适配专业场景。强调“数据质量>数量”“监控胜过猜测”,助力开发者高效落地AI定制化应用。(239字)
为什么传统数据库不够用,向量数据库如何补位?
本文通俗解析向量数据库:它让AI能按“语义相似性”而非关键词检索文本、图像等非结构化数据,是RAG技术的“记忆中枢”。详解嵌入原理、ANN索引(如HNSW)、实战搭建步骤及效果评估方法,强调其与传统数据库协同而非替代的关系。(239字)
TensorFlow 入门指南
TensorFlow 是 Google 开源的主流机器学习框架,支持从研究到生产的全周期开发。其核心优势在于:灵活的数据流图、Keras 高级API易上手、底层API可深度定制,以及TensorBoard、TFLite、TF Serving等完善生态,广泛应用于图像识别、自然语言处理等领域。(239字)

手把手教你调出“懂你”的AI:大模型微调实战与资源管理
本文深入浅出讲解大模型微调核心知识:用生活化比喻解析学习率、训练轮数、批量大小、截断长度和LoRA秩五大关键参数;提供适配不同显存的实操配置表;分享Liger Kernel、DeepSpeed等省显存技巧;并强调定量、定性与效率三维评估。零基础也能快速上手定制专属AI。
深度 AI 学术是怎样学习百度学术、谷歌学术的先进经验的?
深度AI学术融合百度学术与Google Scholar优势,聚合2.8亿文献,支持中英文语义检索、AI自动摘要、引用追踪及趋势分析;创新提供批量翻译、自定义维度解析与学术报告生成,打造智能科研助手。(239字)
企业硬盘加密软件选型指南:DiskCrypt与BitLocker功能、性能与应用场景全对比
本文对比国产安得卫士DiskCrypt与微软BitLocker两款硬盘加密软件,在加密深度(扇区级vs分区级)、认证机制、密钥管理、应急恢复、国产化兼容及集中管控等维度展开分析,助力用户按安全等级、合规要求与使用场景科学选型。(239字)
智创未来,智能体拥抱科技,重燃探索宇宙的热情
智能体正开启人类探索宇宙的新纪元。它们自主决策、处理海量数据、先行建造星际基地,成为深空探索的先遣军。从火星到遥远星系,智能体延伸了人类的触角,让星辰大海不再遥不可及。这是技术的飞跃,更是探索精神的传承。

智能体来了:生产企业如何用AI赚钱
在“智造”转型浪潮下,AI已成为制造企业发展的必选项。本文系统解析AI在研发、生产、供应链、管理等场景的应用路径,提出从数据筑基到智能体落地的四阶段实施框架,揭示避免技术陷阱、组织阻力的关键策略,助力企业以价值驱动、稳步推进智能化升级。
【AI大模型面试宝典九】- 推理部署篇
【AI大模型面试宝典】聚焦推理加速核心技术:KV-Cache优化、连续批处理、投机解码、模型并行等,结合vLLM实战与面试高频题解析,帮你系统掌握得分要点,高效斩获offer!点赞关注,持续更新中~
【AI大模型面试宝典二】— 基础架构篇
【AI大模型面试宝典】聚焦分词器核心考点!详解BPE、WordPiece、SentencePiece原理与实战,覆盖中文分词最佳实践、词汇表构建、特殊标记处理,助你轻松应对高频面试题,精准提升offer竞争力!
基于深度学习的摔倒检测系统
针对人口老龄化背景下老年人摔倒问题突出,传统检测方法存在佩戴不便、隐私泄露等局限,本研究基于深度学习技术,利用YOLOv8模型与Python开发非接触式摔倒检测系统。通过高效算法与高质量数据集实现精准识别,具备实时性高、适应性强等优势,可广泛应用于家庭、社区及医疗机构,有效提升老年人安全监护水平,减轻照护负担,推动人工智能在智慧医疗领域的融合应用。
MySQL 为何能稳居开源数据库主流宝座
MySQL自1995年发布以来,凭借轻量高效、易用友好、生态完善和灵活扩展四大优势,长期稳居开源数据库榜首。其低门槛部署、丰富工具链、广泛技术适配与平滑扩展能力,满足从个人项目到企业级应用的全场景需求,成为Web开发首选数据库。
大模型推理与应用术语解释
本文系统介绍了大语言模型核心概念:推理、生成式AI、检索增强生成(RAG)、提示工程、上下文学习、代理、多模态学习与语义搜索。涵盖其原理、应用与优化技术,展现大模型在内容生成、知识融合、任务执行与跨模态理解等方面的前沿进展,揭示高效、智能AI系统的构建路径。
大数据与机器学习
大数据领域前沿技术分享与交流,这里不止有技术干货、学习心得、企业实践、社区活动,还有未来。