一、背景
电商搜索这些年走过三个阶段:关键词搜索、语义搜索、多模态搜索。今天用户的期待已经很直接——拍一张图就要找到同款,打一句"米白色宽松棉麻衬衫"就要出对的货。
这背后是两个高频场景。
- 图搜图:用户上传或拍摄一张商品图,系统找出同款与相似款,支撑拍照购物、比价购物、以图找店
- 文搜图:用户输入一句自然语言描述,系统直接匹配符合描述的商品主图,即使商品标题里根本没有"棉麻""宽松"这些词。
问题在于,这两件事传统上都很难落在同一套系统里。
- 商品主图有几千万张、存在 OSS;
- 向量要另建一套向量库;
- 搜索结果又必须和价格、库存、类目、评分这些业务属性联合过滤——"找相似款"没有意义,"找有货、300 元以内、评分 4 分以上的相似款"才有意义。
于是团队维护两套系统、写两套链路,向量库里没有业务字段,OLAP 库里没有向量,中间靠应用层来回捞数据拼结果。商品换了主图,向量更新延迟几小时,搜索出来还是旧款。
二、整体技术架构
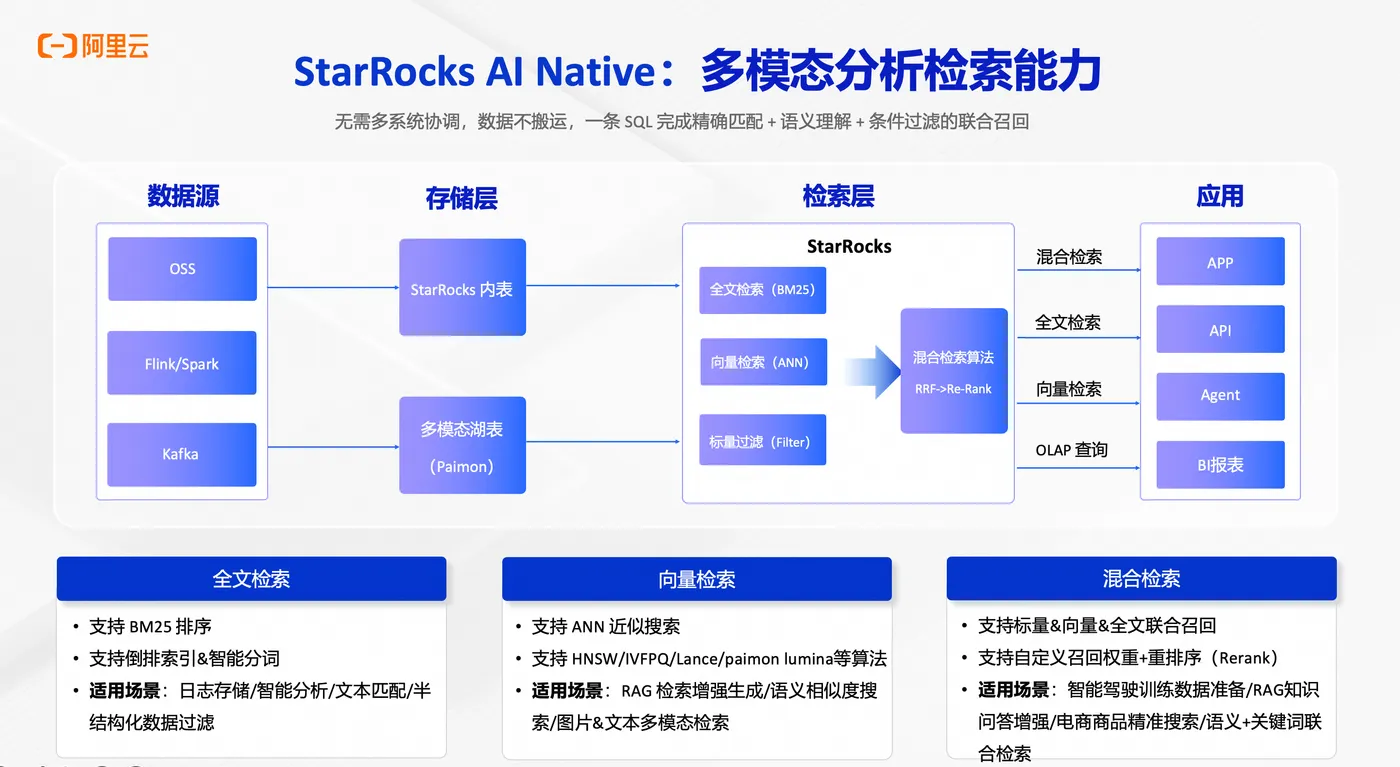
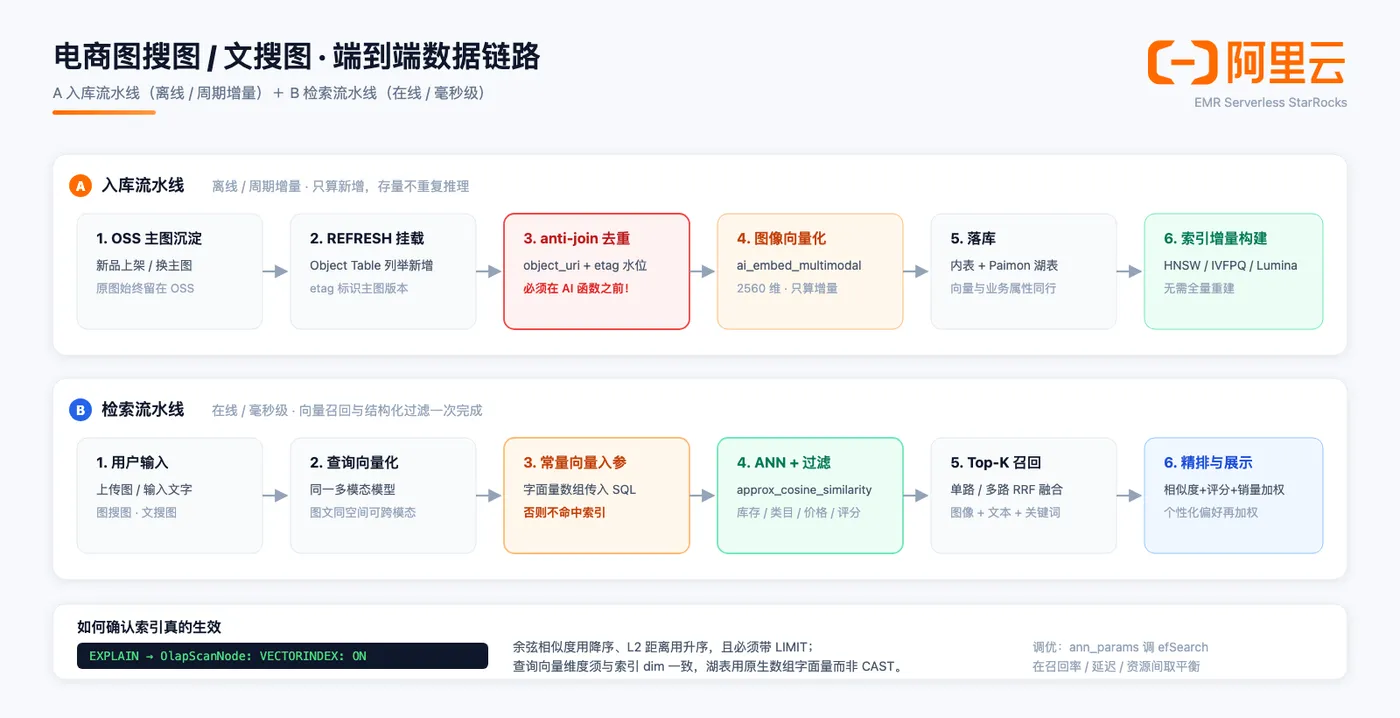
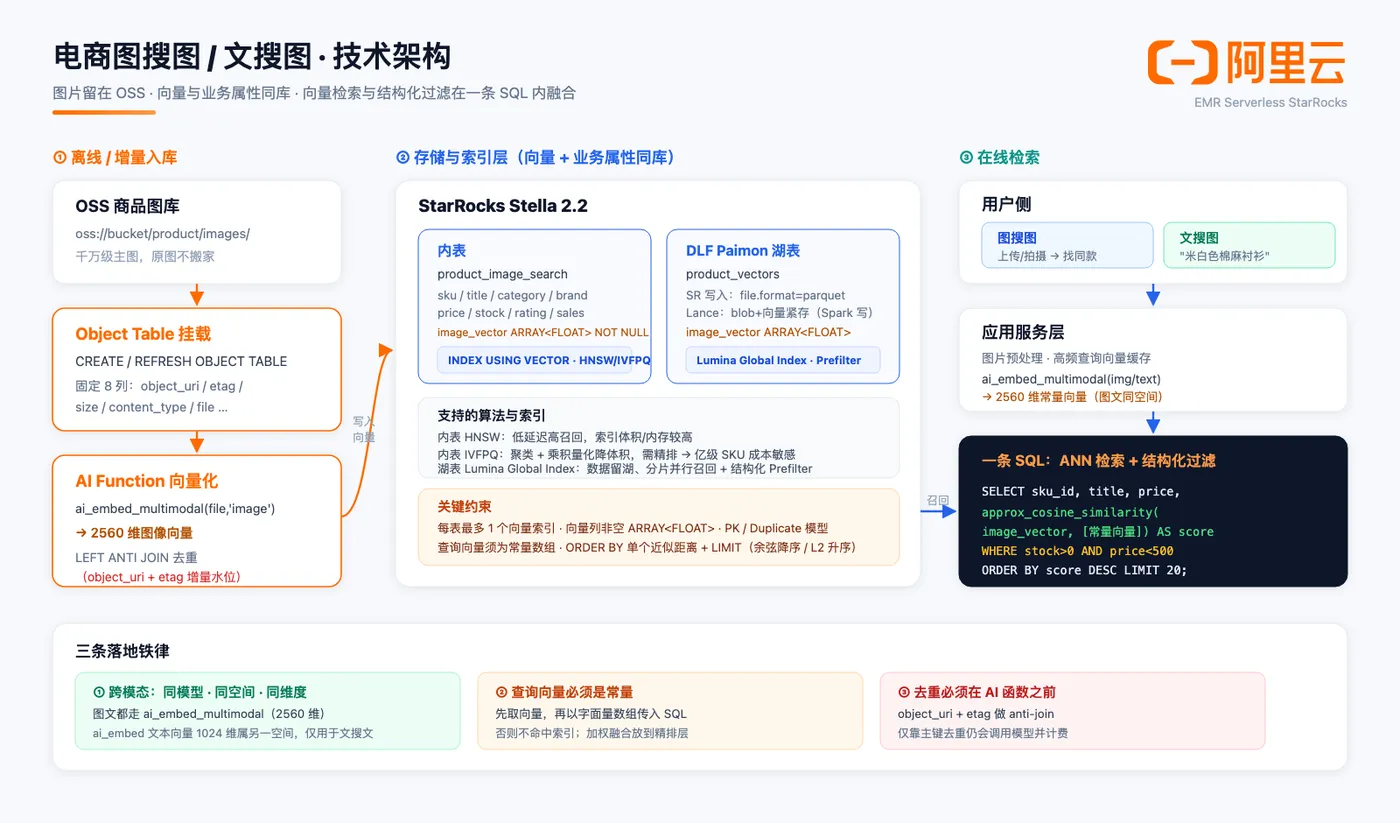
基于 EMR Serverless StarRocks,用 StarRocks AI Function 在库内直接调用多模态模型,把"OSS 图片 → 向量 → 混合检索 → 业务过滤与排序"整条链路收敛成标准 SQL。图片原图不出 OSS,用 Object Table 挂载增量文件;向量与商品业务属性同库存储,向量检索与结构化过滤在一条 SQL 里原生融合。
核心能力有:
ai_embed_multimodal(file, 'image')把商品主图编码成向量;ai_embed_multimodal(text, 'text')把用户的自然语言查询编码到同一向量空间——这是文搜图能跨模态命中图片向量的关键;approx_cosine_similarity在向量索引上做 ANN 检索,配合WHERE里的价格、库存、类目条件,一条 SQL 出最终结果。
支持的算法与索引选型
| 数据源 | 索引类型 | 距离度量 | 典型特点 | 推荐场景 |
|---|---|---|---|---|
| StarRocks 内表 | HNSW | L2、余弦相似度 | 低延迟、高召回;索引体积和内存占用相对较高 | 线上主搜、秒级响应的图搜图/文搜图 |
| StarRocks 内表 | IVFPQ | L2、余弦相似度 | 通过聚类和乘积量化降低索引体积;通常需要精排以提高最终精度 | 亿级 SKU、成本与内存敏感 |
| DLF Paimon 湖表 | Lumina Global Index | L2、余弦相似度、内积 | 数据保留在湖表;支持分片并行召回及结构化 Global Index 预过滤 | 全量商品资产留湖、多引擎共享、离线大批量召回 |
用户侧
  ├── 上传图片(图搜图)
  └── 输入文字描述(文搜图)
          │
          ▼
应用服务层
  ├── 图片预处理(裁剪 / 归一化)
  └── 调用 StarRocks AI Function 实时向量化
          │
          ▼
StarRocks Stella 2.2
  ├── 商品多模态表(SKU 信息 + 图像向量 + 文本向量)
  ├── ANN 向量索引(HNSW / IVF)
  └── AI Function:AI_EMBED(image / text, model)
          │
          ▼
结果处理层
  ├── Top-K 相似商品列表
  ├── 联合业务规则过滤(价格区间 / 库存 / 类目)
  └── 结果排序与展示
三、实践步骤
第一步,用 Object Table 挂载 OSS 商品图片。
主图按类目/年月目录沉淀在 OSS,建 Object Table 把对象映射进来,file 描述符直接交给 AI 函数、签名地址由系统自动生成,SQL 里不出现 AK/SK。
SET CATALOG default_catalog;
CREATE DATABASE IF NOT EXISTS ec_search;

CREATE OBJECT TABLE ec_search.obj_product_images PROPERTIES (
  "path" = "oss://<BUCKET>/product/images/",
  "aliyun.oss.endpoint" = "oss-cn-hangzhou-internal.aliyuncs.com",
  "aliyun.oss.public_endpoint" = "oss-cn-hangzhou.aliyuncs.com",
  "aliyun.oss.access_key" = "<AK>",
  "aliyun.oss.secret_key" = "<SK>",
  "recursive" = "true",
  "file_pattern" = ".*\\.(jpg|jpeg|png|webp)$"
);
REFRESH OBJECT TABLE ec_search.obj_product_images;
Object Table 固定 8 列(object_uri/etag/size/last_modified/content_type/storage_class/refresh_id/file),其中 etag 是做增量水位的关键——主图被替换后 etag 变化,会自动触发重新向量化。
第二步,建商品多模态表并规划向量索引。
线上主搜用内表,向量列必须是 NOT NULL 的 ARRAY<FLOAT>,表模型为 Primary Key 或 Duplicate Key;
CREATE TABLE ec_search.product_image_search (
  sku_id       BIGINT NOT NULL,
  spu_id       BIGINT,
  title        VARCHAR(1024),
  category     VARCHAR(64),
  brand        VARCHAR(64),
  price        DECIMAL(10,2),
  stock        INT,
  rating       FLOAT,
  sales_30d    BIGINT,
  object_uri   VARCHAR(1024),          -- 关联 OSS 主图
  etag         VARCHAR(256),           -- 主图版本,做增量幂等
  image_vector ARRAY<FLOAT> NOT NULL,  -- 多模态图像向量,2560 维
  updated_at   DATETIME,
  INDEX idx_image_vec (image_vector) USING VECTOR (
    "index_type"       = "hnsw",
    "dim"              = "2560",
    "metric_type"      = "cosine_similarity",
    "is_vector_normed" = "false",
    "M"                = "16",
    "efconstruction"   = "200"
  )
) PRIMARY KEY (sku_id)
DISTRIBUTED BY HASH(sku_id) BUCKETS 32;
按检索路径分表:product_image_search 承载图像向量(服务图搜图 + 文搜图,因为文本查询向量与图像同空间),另建 product_text_search 用 ai_embed 的 1024 维文本向量服务"文搜文"。
若全量商品向量要留在湖上供多引擎共享,则落 DLF Paimon 表。
-- StarRocks 可写:parquet + partial-update,便于只回写向量或业务列
CREATE TABLE dlf_catalog.`default`.product_vectors (
  sku_id BIGINT, object_uri STRING, etag STRING,
  category STRING, brand STRING, price DECIMAL(10,2), stock INT,
  image_vector ARRAY<FLOAT>, updated_at TIMESTAMP
) ENGINE = paimon
PROPERTIES ("file.format"="parquet","primary-key"="sku_id",
            "merge-engine"="partial-update","bucket"="4");
第三步,批量向量化入库,去重在 AI 函数之前。
把 Object Table 的 file 交给 ai_embed_multimodal,并用 object_uri + etag 做 LEFT ANTI JOIN 过滤已处理主图:
INSERT INTO ec_search.product_image_search
  (sku_id, spu_id, title, category, brand, price, stock, rating, sales_30d,
   object_uri, etag, image_vector, updated_at)
SELECT
  p.sku_id, p.spu_id, p.title, p.category, p.brand, p.price, p.stock, p.rating, p.sales_30d,
  o.object_uri, o.etag,
  ai_embed_multimodal(o.file, 'image') AS image_vector,
  now()
FROM ec_search.obj_product_images o
JOIN ec_search.dim_product p
  ON p.image_key = regexp_extract(o.object_uri, '.*/(.+)$', 1)
LEFT ANTI JOIN ec_search.product_image_search t
  ON t.object_uri = o.object_uri AND t.etag = o.etag
WHERE object_file_is_image(o.file);

-- 校验:向量非空、维度与索引 dim 一致
SELECT COUNT(*) AS total,
       SUM(IF(image_vector IS NOT NULL AND array_length(image_vector)=2560,1,0)) AS valid_vec
FROM ec_search.product_image_search;
第四步,图搜图。
关键点:要命中向量索引,查询向量必须是优化阶段可确定的常量数组。所以线上是两步——应用层先调一次向量化拿到数组,再作为字面量拼进检索 SQL:
-- ① 先取查询向量(用户上传图的公读或签名 URL)
SELECT ai_embed_multimodal('https://<BUCKET>.oss-cn-hangzhou.aliyuncs.com/upload/q.jpg', 'image');

-- ② 用常量向量做 ANN 检索 + 业务条件过滤(余弦降序 + LIMIT)
SELECT sku_id, title, category, price, rating, object_uri,
       approx_cosine_similarity(image_vector, [0.0131, -0.0247, /* …2560 维字面量… */]) AS score
FROM ec_search.product_image_search
WHERE stock > 0
  AND category = '女装'
  AND price BETWEEN 100 AND 500
  AND rating >= 4.0
ORDER BY score DESC
LIMIT 20;
第五步,文搜图(跨模态)。
用户输入的文字用同一个多模态模型编码成 2560 维向量,直接与商品的 image_vector 比相似度——这就是跨模态检索:
-- ① 文本编码到与图像同一空间(2560 维)
SELECT ai_embed_multimodal('米白色宽松棉麻衬衫', 'text');

-- ② 用文本向量检索图像向量(跨模态)+ 属性过滤
SELECT sku_id, title, brand, price, object_uri,
       approx_cosine_similarity(image_vector, [/* 上一步的 2560 维常量 */]) AS score
FROM ec_search.product_image_search
WHERE stock > 0
  AND category IN ('衬衫','女士衬衫')
  AND price < 2000
ORDER BY score DESC
LIMIT 20;
如果要做"文搜文"(按标题、属性描述做同模态语义搜索),用 ai_embed 的 1024 维向量、在独立的文本向量表上检索——不要与 2560 维图像向量混算。
高频查询词的查询向量建议在应用层缓存,避免重复调用模型。
第六步,融合排序与多路召回。
向量相似度只是排序信号之一,线上通常还要叠加评分、销量、活动权重:
SELECT sku_id, title, price, rating, sales_30d,
       0.7 * approx_cosine_similarity(image_vector, [/* qv */])
     + 0.2 * (rating / 5.0)
     + 0.1 * LOG(sales_30d + 1) / 10 AS final_score
FROM ec_search.product_image_search
WHERE stock > 0
ORDER BY final_score DESC
LIMIT 20;
注意:要命中 TopK 向量索引,ORDER BY 只能包含单个近似距离表达式。上面这种加权融合会使索引不生效,适合作为精排层——正确做法是先用纯 approx_cosine_similarity 索引召回 Top-200 到 CTE,再在 CTE 上做加权重排。
多路召回(图像向量召回 + 文本向量召回 + 关键词倒排召回)用 RRF 融合,各路各自 ROW_NUMBER() 出排名后按 SUM(1/(k+rank)) 打分;ORDER BY 用裸别名,不要带表前缀:
WITH img_recall AS (
  SELECT sku_id, ROW_NUMBER() OVER (ORDER BY approx_cosine_similarity(image_vector,[/* qv_img */]) DESC) AS r
  FROM ec_search.product_image_search WHERE stock>0 ORDER BY r LIMIT 200),
txt_recall AS (
  SELECT sku_id, ROW_NUMBER() OVER (ORDER BY approx_cosine_similarity(text_vector,[/* qv_txt */]) DESC) AS r
  FROM ec_search.product_text_search WHERE stock>0 ORDER BY r LIMIT 200),
fused AS (
  SELECT sku_id, SUM(1.0/(60+r)) AS rrf
  FROM (SELECT sku_id,r FROM img_recall UNION ALL SELECT sku_id,r FROM txt_recall) u
  GROUP BY sku_id)
SELECT f.sku_id, p.title, p.price, ROUND(f.rrf,5) AS rrf_score
FROM fused f JOIN ec_search.product_image_search p ON f.sku_id=p.sku_id
ORDER BY rrf_score DESC LIMIT 20;
第七步,湖表检索与增量更新。
在 DLF Paimon 湖表上检索时同样用近似函数与常量向量;查询向量要用原生数组字面量,具备兼容 Bitmap/BTree Global Index 的结构化条件会作为 Prefilter 下推,其余作为 Postfilter 执行:
SELECT sku_id, approx_cosine_similarity(image_vector, [/* 常量向量 */]) AS score
FROM dlf_catalog.`default`.product_vectors
WHERE category = '女装' AND stock > 0
ORDER BY score DESC LIMIT 20;
增量维护上,新品与换图都靠 object_uri + etag 的 anti-join 自动纳入,周期调度执行 REFRESH OBJECT TABLE → 向量化 INSERT 即可;ANN 索引支持增量构建,无需全量重建,大批量回填建议低峰执行。
四、实施成效
方案落地后,最直接的变化是商品图片第一次变成了可被语义检索的资产,而且检索天然带业务约束。
- 图搜图与文搜图共用同一份图像向量与同一条检索链路,不需要为跨模态单独建库;
- "有货 + 类目 + 价格区间 + 评分"这些条件在召回阶段就生效,不再出现召回 20 条过滤剩 3 条的空结果;商品换主图后靠 etag 自动触发重新向量化,搜索结果不再滞后;
- 向量与业务属性同库,运维从两套系统收敛为一套。
归纳起来四点收益。
- 架构上,向量库与 OLAP 库合一,减少一套系统的部署、同步与故障面。
- 效果上,向量检索与结构化过滤原生融合,搜索结果直接可用于展示与排序。
- 成本上,
object_uri + etag增量水位保证只对新增和换图的 SKU 调用模型,存量不重复推理。安全上,商品图片不导出到第三方,在库内完成加工与检索。
五、 总结
通过 StarRocks,把多模态模型能力以 SQL 函数的形式嵌入混合搜索链路,构建了"OSS 图片挂载 → 向量化入库 → ANN 索引 → 图搜图 / 文搜图 → 业务过滤与融合排序"的全链路闭环。
图片不出 OSS,向量与业务数据同库,推理即查询——用一套 SQL 同时支撑拍照购物与自然语言找货。
同一套模板还可平移到 UGC 图文匹配、以图找店、盗图与侵权检测、同款比价、素材去重等场景。对于同样面临"图片在对象存储、检索要带业务条件、还不想多维护一套向量库"的团队,StarRocks 提供了一条清晰的落地路径——会写 SQL,就能做多模态搜索。