「Flink 和 Spark 有什么区别?」这个问题,我在面试和选型会上被问过不下二十次。
前几年的标准答案是:Flink 是真流,来一条处理一条;Spark Streaming 是微批,攒一小批再算,所以 Flink 延迟更低。这个答案在 2018 年成立。
到了 2026 年,它至少有三处不准:Spark 的 Real-Time Mode 已经在 4.1 里 GA,把无状态链路压进了毫秒;Kafka Streams 的精确一次早就不是新闻;而真正在抢 Flink 场景的,已经不是 Spark,是一批把状态直接放进对象存储的流式数据库。
更麻烦的是,很多团队手里的对比表还是五六年前那张:Storm、Spark Streaming、Structured Streaming、Flink 四列,比模型、比 API、比 SQL 支持、比延迟。表本身没错,只是其中一半的格子已经过期了。
这篇想把这张表重做一遍。不用「八个维度打分」的方式,而是拆成三条分野——执行模型、状态归属、交付形态。三条问清楚,选型基本就定了。
一、先看牌桌上还剩谁
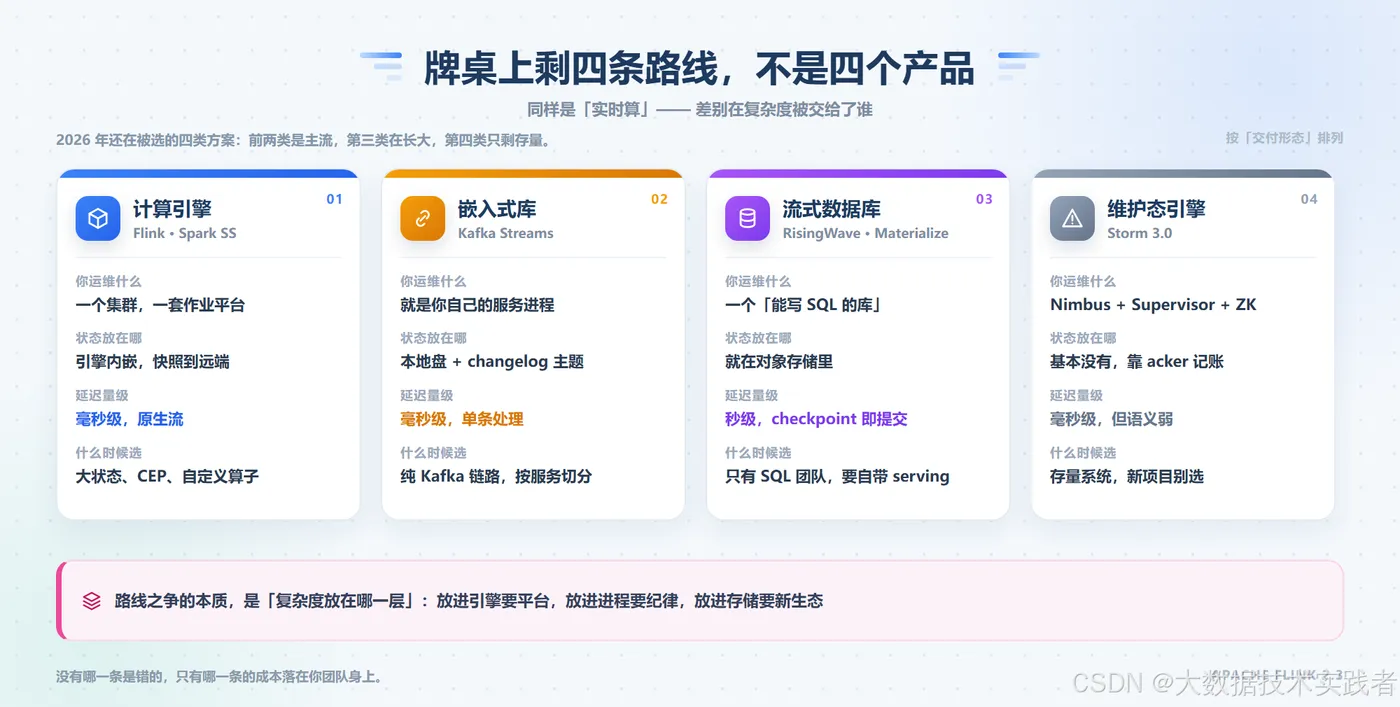
今天还在被选的方案,按交付形态能分成四类:
计算引擎是 Flink 和 Spark Structured Streaming。你运维一个集群、一套作业平台,作业是提交上去的长期进程。
嵌入式库只有 Kafka Streams 一个能打。它不是集群,是一个 jar 包,塞进你的 Spring Boot 服务里,服务启动就开始算。
流式数据库是 RisingWave、Materialize 这一批。对外它就是个 PostgreSQL,你连上去写 CREATE MATERIALIZED VIEW,它自己维护新鲜度。状态不在本地盘,在对象存储。
维护态引擎是 Storm。2026 年 7 月它发了 3.0.0,要求 Java 25,API 与 2.x 兼容,分了 lite 和 full 两个发行版——但 PMC 在给 ASF 董事会的报告里写得很直白:项目处于维护状态,活跃成员接近法定人数下限。新项目不必再考虑它,存量系统还得养着。
四条路线的差别,本质是复杂度放在了哪一层:放进引擎,你要养平台;放进你的进程,你要守纪律;放进存储,你要接受一个新生态。
顺带说一句 Storm 为什么退场。它的模型并不落后——record-at-a-time,延迟很低;问题出在容错。Storm 用 acker 给每条 tuple 记一本账:spout 发出去一个根 tuple,每派生一个子 tuple 就异或一次,全链路处理完账本归零才算成功,超时则重发。这套机制能做到 at-least-once,但不维护状态——中间结果得你自己塞进 Redis 或 HBase。后来 Trident 用微批补上了状态和 exactly-once,可那时 Flink 已经把「状态 + 快照」做成了引擎的内置能力。Storm 输的不是延迟,是它把最难的那部分留给了业务代码。
二、分野一:执行模型
这是最有共识、也最容易被说错的一格。
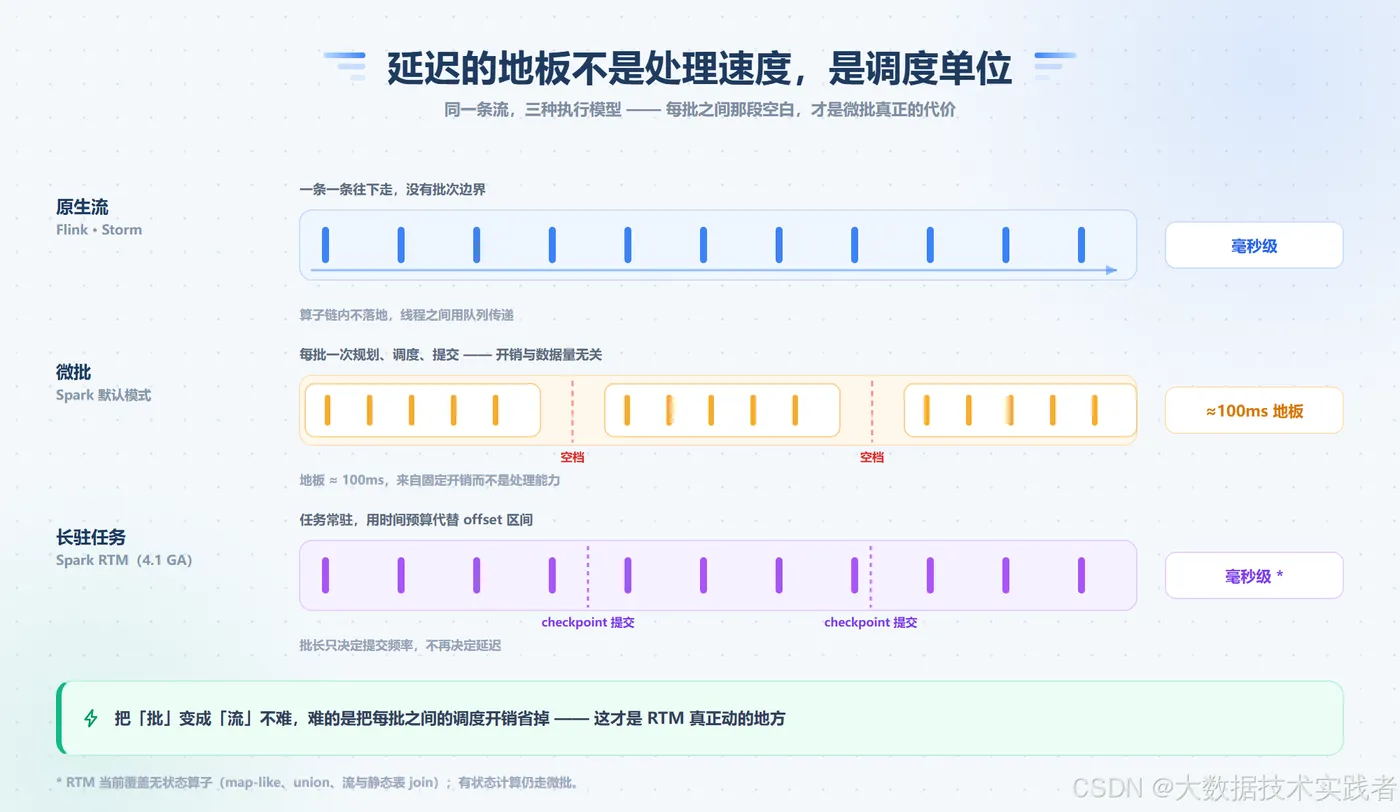
Flink 是原生流:记录一条一条穿过算子链,算子之间不落地,靠队列传递。Structured Streaming 默认是微批:把流切成一个个小批次,每批走一次「规划 → 调度 → 提交」。
关键在那个空档。每一批开始时,Driver 都要重新规划一次物理计划、向集群申请一次资源、把任务发下去,批结束时再提交一次 offset。这段开销和数据量无关——哪怕一批只有十条记录,它也得走完。所以微批的延迟地板大约是 100 毫秒,卡住它的不是处理能力,是调度单位。
Spark 4.x 的 Real-Time Mode 动的正是这里。它把「每批一组短命任务」换成「每个输入分区一个长驻任务」:任务不再随批次起停,记录到了就往下走;offset 也不在批开始前定好,而是任务运行时按时间预算读多少算多少,结束后再上报。批长于是变成了提交间隔,不再等于延迟。
// 微批:批长就是延迟
.trigger(Trigger.ProcessingTime("10 seconds"))

// Real-Time Mode:批长只是 checkpoint 间隔
.trigger(Trigger.RealTime("10 seconds"))
.outputMode("update")   // RTM 要求 update 模式
一行 trigger 的差别,背后是两套调度模型。但这里有个今天必须说清楚的边界:RTM 目前只覆盖无状态算子——map-like 变换、union、流与静态表的 join。带聚合、带状态、带流流 join 的查询,还是走微批。老版本的 Continuous Processing 延迟能到 1 毫秒,但只有 at-least-once,官方已把它归为遗留方案。
所以「Spark 也能做到毫秒」这句话,得补一个定语:无状态链路可以,有状态还不行。而这恰恰是 Flink 的地盘。
三、分野二:状态归属
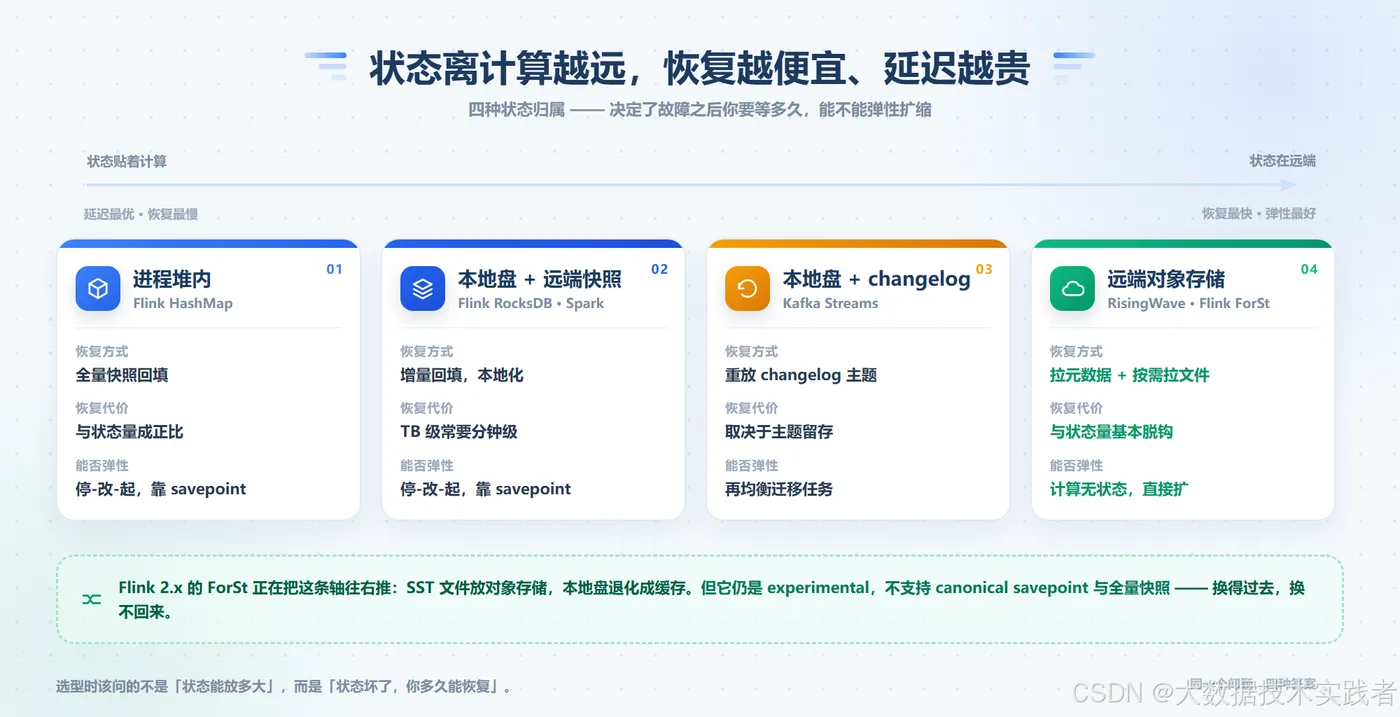
流处理真正的分水岭在这里。状态放哪儿,决定了三件事:能算多大、故障后多久恢复、能不能弹性扩缩。
| 方案 | 状态在哪 | 恢复要做什么 | 弹性 |
|---|---|---|---|
| 进程堆内 | JVM 堆 | 全量快照回填 | 停-改-起 |
| 本地盘 + 远端快照 | TM 本地盘 | 增量回填,与状态量成正比 | 停-改-起 |
| 本地盘 + changelog | 本地盘,变更写 Kafka | 重放 changelog 主题 | 再均衡迁移任务 |
| 远端对象存储 | 对象存储 | 拉元数据 + 按需拉文件 | 计算无状态,直接扩 |
Flink 的传统答案是第二行:状态在 TaskManager 本地,Checkpoint 定期快照到 HDFS 或 S3。这个模型很成熟,代价是恢复时间与状态量成正比——一个 2 TB 状态的作业冷启动,十分钟起步是常态,因为要把几个 T 搬回本地。
Kafka Streams 走的是第三行,思路很巧:本地 RocksDB 保证读取快,每次状态变更同时写一条到 changelog 主题,任务迁到别的实例就重放 changelog。它把「状态持久化」这件事外包给了 Kafka 自己的副本机制,所以一个 jar 包就能有容错。代价是绑死 Kafka,而且 join 前必须保证两边分区数一致、分区策略一致(co-partitioning),否则匹配不上。
RisingWave 这批走第四行:状态的 LSM 文件直接写对象存储,计算节点不存状态,checkpoint 做到 1 秒级,挂了就回滚到上一个 epoch 重放。计算节点无状态,扩缩容不需要 savepoint,直接加减副本。
Flink 2.x 的 ForSt 正在往第四行挪:SST 文件放对象存储,本地盘退化成缓存,Checkpoint 不再需要把全量状态推上去。方向是对的,但今天仍是 experimental——不支持 canonical savepoint,也不支持全量快照。这意味着一旦切过去,回退路径很窄。AWS 的托管 Flink 2.3 更是直接把它列进了「不支持」清单。
选型时该问的不是「状态能放多大」,而是「状态坏了,你多久能恢复」。这两个问题的答案,往往不在同一行。
四、分野三:交付形态
这条最容易被技术对比忽略,但它决定了你团队要养几个人。
Flink 是一个集群。哪怕是 Application 模式,你也要有 JobManager、TaskManager、Checkpoint 存储、指标监控、升级流程。它的好处是边界清晰:作业是作业,服务是服务,两边互不干扰,一个作业的 GC 不会拖垮另一个。
Kafka Streams 反过来,它是你服务的一部分。加副本就是加并行度,滚动发布就是升级,K8s 的探针、日志、链路追踪全都复用。代价是:你的业务服务里多了一块有状态的计算逻辑,一个分区卡住,整个 Pod 的健康检查都可能挂。
流式数据库则是第三种:你连一个 PostgreSQL,写 SQL,查物化视图。没有作业概念,没有 checkpoint 参数,也没有 DataStream API。它的边界是硬的——SQL 表达不了就是表达不了,没有 MATCH_RECOGNIZE,没有自定义算子,复杂状态机只能绕。
这三条没有优劣,只有「你的团队结构适配哪一种」。有平台组,选第一种;服务化彻底、Kafka 是中枢,选第二种;只有数据分析师,选第三种。
换成三个更具体的问题会更好判断:升级谁做、扩容谁做、凌晨三点出事谁看。 第一个问题筛掉没有平台组的团队,第三个问题筛掉没有 on-call 的团队。答不出来的,说明这套东西还没到能上生产的阶段,跟选哪个引擎无关。
五、同一个需求,四种写法
抽象讲完,落到一个具体需求上:统计每分钟各品类的 GMV 和去重订单数。
Flink SQL 是声明式的,窗口用 TVF:
SELECT window_start, window_end, category,
       COUNT(DISTINCT order_id) AS orders,
       SUM(amount) AS gmv
FROM TABLE(TUMBLE(TABLE orders, DESCRIPTOR(event_time), INTERVAL '1' MINUTE))
GROUP BY window_start, window_end, category;
Structured Streaming 写法几乎同构,只是多了个水位线:
orders
  .withWatermark("event_time", "30 seconds")
  .groupBy(window($"event_time", "1 minute"), $"category")
  .agg(countDistinct($"order_id").as("orders"), sum($"amount").as("gmv"))
  .writeStream.outputMode("update")
  .option("checkpointLocation", "s3://ck/gmv")
  .toTable("gmv_1m")
RisingWave 更短,因为它把「持续维护」做成了视图的默认语义:
CREATE MATERIALIZED VIEW gmv_1m AS
SELECT window_start, category,
       COUNT(DISTINCT order_id) AS orders, SUM(amount) AS gmv
FROM TUMBLE(orders, event_time, INTERVAL '1 minute')
GROUP BY window_start, category;
Kafka Streams 最长,因为 DSL 里没有 countDistinct:
orders.groupBy((k, v) -> v.getCategory())
      .windowedBy(TimeWindows.ofSizeAndGrace(
          Duration.ofMinutes(1), Duration.ofSeconds(30)))
      .aggregate(Gmv::new, (k, v, agg) -> agg.add(v), Materialized.as("gmv"))
      .toStream()
      .to("gmv_1m", Produced.with(timeWindowedSerdeFrom(String.class), jsonSerde));
注意最后一段:aggregate 只能累加,去重要么在 add 里维护一个订单 ID 集合(状态会涨),要么先按订单去重成一张 KTable 再聚合。这不是缺点,是库的边界——它假设你愿意自己拼装。
四段代码看下来,语法在趋同,真正的差别在后面那张表。
先看一个具体的坑:COUNT(DISTINCT)。Flink 在 upsert 流上要维护每个 key 的去重集合,状态随基数和窗口长度线性涨;Spark 的 countDistinct 在 update 模式下会往下游发 retract(撤回)消息,Sink 必须能处理「减一」;RisingWave 靠增量视图维护自己算 delta,用户看不见但代价在 join 的复杂度上;Kafka Streams 干脆不提供,让你自己拼。同一个函数名,四种状态代价。 这类细节不会出现在任何一张对比表的格子里,但它决定了你的作业三个月后会不会 OOM。
| 方案 | 正确性靠什么 | 出错之后你要做什么 |
|---|---|---|
| Flink | Checkpoint + Sink 两阶段提交 | 调间隔、调超时、盯反压 |
| Spark SS | Checkpoint + 幂等 Sink | 保证 Sink 可重放或幂等 |
| Kafka Streams | Kafka 事务(EOS v2) | 确认 transactional.id 与超时 |
| RisingWave | 秒级 barrier 快照 | 基本不管,等 epoch 回滚 |
这就是选型里最容易被跳过的一列。四种方案都能做到精确一次,但「做到」的成本不一样:Flink 把成本放在运维(你要懂 checkpoint 和事务超时的相互约束),Kafka Streams 放在事务配置(transaction.timeout.ms 与 broker 上限要对齐),RisingWave 放在表达力(SQL 写不出的就只能放弃)。
如果要做 POC,别比 TPS。同一份数据、同一个查询,量三个数:端到端 p99 延迟、状态占用、以及从 kill -9 到重新出数的秒数。第三个最容易被忽略,也最能拉开差距——它直接决定了故障时你敢不敢重启。
六、五个还在流传的误区
「Flink 一定比 Spark 快」。 快慢取决于负载形状。全链路无状态、要求毫秒,RTM 已经够用;一旦有窗口聚合和大状态,微批的调度开销反而被摊薄,差距缩小。拿一条 map-filter 链路去比,结论没有意义。
「微批就是秒级」。 地板约 100 毫秒,不是秒。真正的秒级来自「批长设成 10 秒」这种配置选择,不是模型限制。
「Kafka Streams 只能 at-least-once」。 EOS v2 早就有了,开 processing.guarantee=exactly_once_v2 即可。它的精确一次比 Flink 简单,因为事务边界就是 Kafka 自己的。
「流式数据库会取代 Flink」。 在 SQL 能表达的范围内,它确实更省事。但 CEP、自定义算子、复杂状态机、非 Kafka 的源,它接不住。RisingWave 官方博客给过一组 Nexmark 数据,27 个查询里赢 22 个——这是它自测口径,值得看,但要按自己的查询形状复测。
「开源能跑,托管就能用」。 这条最坑。AWS 托管 Flink 2.3 明确不支持物化表、ForSt、原生 S3、Java 21。你在本地验证过的 2.3 新特性,上云可能一个都用不了。选型时要问的不是「Flink 2.3 有什么」,而是「你打算用的那个托管版本,有哪些」。
七、四层筛:剩下的才是 Flink
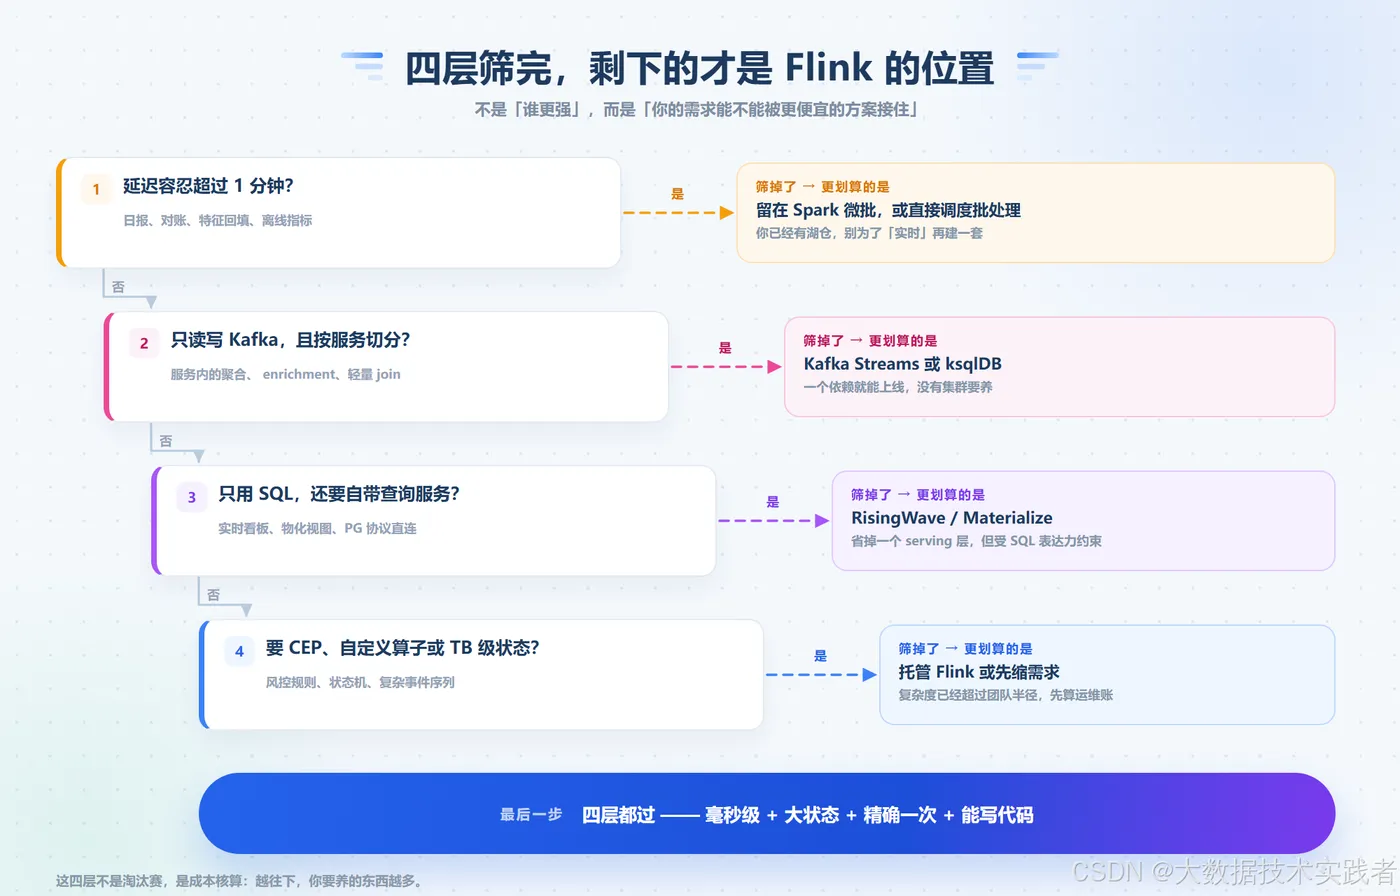
把前面的东西压成四道筛子,从上往下过:
- 延迟容忍超过 1 分钟? 日报、对账、特征回填,留在 Spark 微批或者直接调度批处理。你已经有湖仓,别为了「实时」再建一套。
- 只读写 Kafka,且按服务切分? 一个依赖就能上线,Kafka Streams 更划算,还没有集群要养。
- 只用 SQL,还要自带查询服务? RisingWave / Materialize,省掉一个 serving 层。
- 要 CEP、自定义算子或 TB 级状态? 到这一步,才轮到 Flink。此时要算的不是「它能不能做」,而是「你有没有人盯 checkpoint、水位线和反压」。
四层都过,Flink 才是那个划算的选项。它不是「更快」,而是少数能把毫秒延迟、大状态、精确一次同时兜住的引擎——这个组合,今天仍然没有第二个开源方案能完整覆盖。
还要承认一个现实:这套筛子选出来的往往不是一个引擎,是一张分工图。 多数中型以上公司最后是 Spark 管批、Flink 管流,或者 Flink 管核心链路、Kafka Streams 管服务内的轻量聚合。这不是妥协,是成本最优——把一个每天跑一次的离线任务硬搬到流引擎上,你付的是 24 小时常驻资源的钱。
八、最后
Flink 2.3 这半年做的事,其实是在把边界往外推:物化表支持 START_MODE,改一条定义不用重放两年历史;FROM_CHANGELOG / TO_CHANGELOG 让 SQL 层能自由转换追加流和变更流;原生 S3 甩掉 Hadoop 依赖,插件包从 30–93 MB 降到 13 MB 左右。这些都在吃掉流式数据库和轻量方案的地盘。
但推边界不等于消灭对手。只要「SQL 表达不了」和「团队没人运维」这两个前提还在,别的路线就永远有位置。
所以对比的终点从来不是排名,是你愿意维护哪一层抽象。三条分野问完,答案往往不是「谁更强」,而是「哪种代价我付得起」。
你们现在这套实时链路,最难维护的是哪一块——调度、状态,还是人?