
Clover-35B-A3B-Preview 是扩散智能(DiffuSpace)的第一款公开模型,10 月 28 日发布,Hugging Face 同步上了权重和模型卡。
访问原网站获得更好阅读体验
关于它的讨论大多停在「比自回归快」。但快是结果,不是设计。真正值得注意的是三个数字和一处结构改动:
block_size = 32threshold = 0.95- 128K 上下文
- Gated DeltaNet(GDN)被围绕块扩散重写
这篇不评价它好不好用,只拆它在工程上做了什么、为什么这么做、以及这么做的账怎么算。文中凡是从机制推出来但没有官方原话支撑的,我都会标出来。
一、先把 decode 的账算清楚
自回归 decode 的每一步,只产出一个 token,但要跑一遍完整前向:所有层的权重读一遍,KV cache 读一遍。
用算术强度看(每从 HBM 读 1 字节,能做多少次浮点运算):
$$ \text{AI}_{\text{decode}} = \frac{2N_{\text{activated}}}{2N_{\text{activated}} + \text{KV bytes}} \approx 1\ \text{FLOP/Byte} $$
H800 的 BF16 机器平衡点:
$$ \frac{989\ \text{TFLOPS}}{3.35\ \text{TB/s}} \approx 295\ \text{FLOP/Byte} $$
差三百倍。也就是说 decode 阶段 Tensor Core 基本在等内存,这是所有推理优化的起点。
换成具体数字。Clover 每 token 激活约 3B 参数,BF16 下每步要读约 6 GB:
$$ t_{\text{step}} = \frac{6\ \text{GB}}{3.35\ \text{TB/s}} \approx 1.8\ \text{ms} $$
单请求的理论上限就是 555 tokens/s。实际按 50%–60% 的效率打折,落在 300 tokens/s 上下——和这一代消费级 MoE 的实测值量级一致,说明这套估算没跑偏。
要提高吞吐,只有两条路:
| 路径 | 做法 | 代价 |
|---|---|---|
| 加 batch | 一次前向塞多条请求 | 需要并发,Agent 单任务串行时用不上 |
| 加每步 token 数 | 一次前向落定多个 token(非自回归) | 要改训练目标,且 token 之间不能互相依赖 |
自回归天生走第一条。Clover 走第二条。
这个选择很关键,因为它决定了 Clover 的甜点区:低并发、长上下文、单请求串行——恰好是 Agent 的样子。
二、块扩散:不是「去掉自回归」,是把单位换成块
掩码扩散语言模型的基本动作是:把序列的某些位置打上 mask,让模型从上下文恢复它们。因为恢复顺序不固定,一次前向可以同时预测很多位置,这就是并行性的来源。
朴素的全序列扩散有两个问题:
- 丢掉因果结构。语言的长程依赖是有方向的,全序列同时去噪很难利用它。
- 长序列上质量掉得厉害。序列越长,一次要同时决定的依赖越多。
块扩散(block diffusion)是这两极之间的插值:
- 块与块之间保持自回归:前一块解完才解下一块;
- 块内部允许并行:32 个位置在一次前向里一起预测,互相可见。
块大小就是这根插值杆:block_size = 1 退化成自回归,block_size = 序列长度 退化成全序列扩散。32 是中间某个点。

图 1 · 两种方式每步都要跑一遍完整前向。自回归一步落定 1 个 token,块扩散一步最多落定一整块。
算术上,这等价于把「每字节权重能做多少浮点运算」乘以每步落定的 token 数。一步产出 10 个 token,同一份被读出的权重就被用了 10 次。这是块扩散能快起来的全部力学原因,没有更玄的东西。
三、解码循环:32 个 token 一块,阈值 0.95
块扩散的推理循环有一个绕不开的问题:块内 32 个位置一起预测,谁的答案可信?
Clover 用的是 LowConfidence 解码。规则很短:
- 当前块的所有位置先全部置为 mask;
- 每轮跑一次前向,拿到每个位置的 argmax 及其概率(置信度);
- 置信度 ≥ 0.95 的位置一次性写死;
- 剩下的位置保持 mask,进入下一轮;
- 如果一轮下来一个位置都没过阈值,强制写死置信度最高的那一个,保证块能推进;
- 块内全部落定后,整块成为下一块的前缀。
写成伪代码:
def block_decode(model, prefix, block_size=32, threshold=0.95, max_steps=32):
    out = []
    while True:
        # 历史已经在持续更新的循环状态里,这里不重建 KV
        state = model.history_state(prefix)
        block = [MASK] * block_size

        for step in range(max_steps):
            logits = model(block, state)        # 一次前向,32 个位置并行
            prob = softmax(logits, dim=-1)
            conf = prob.max(dim=-1).value       # 每个位置 argmax 的概率
            choice = prob.argmax(dim=-1)

            accept = conf >= threshold
            if accept.any():
                block[accept] = choice[accept]  # 写死,后面不再改
            else:
                i = conf.argmax()
                block[i] = choice[i]            # 兜底:强制推进一格

            if all_resolved(block):
                break

        out.extend(block)
        prefix = prefix + block                 # 整块成为下一块前缀
        if block[-1] == EOS_TOKEN:
            break
    return out
伪代码把 history_state 写在循环里是为了表达「每块只依赖状态」,真实实现不会每一步重建它。
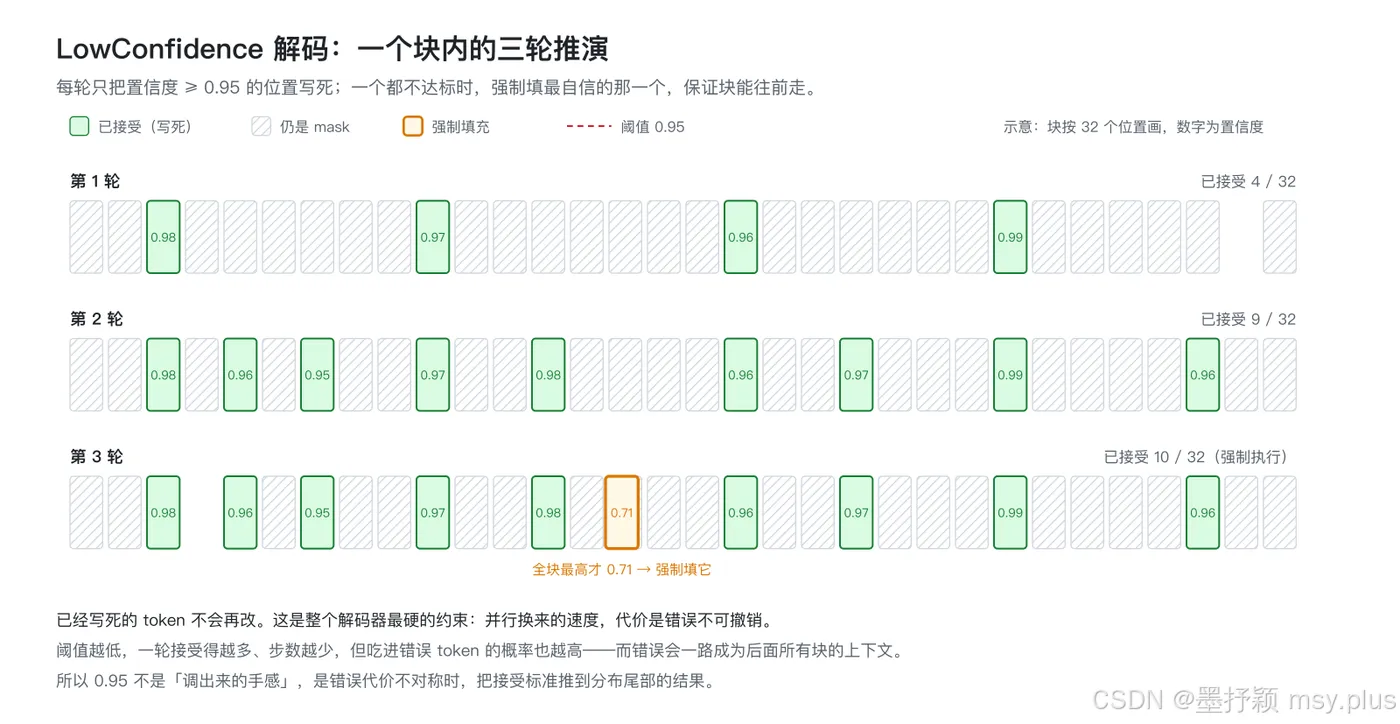
图 2 · 绿色写死、斜线保持 mask、橙色是「一个都没过线」时的强制填充。已写死的 token 不会被回改。
三种状态的后果完全不同
| 状态 | 条件 | 后果 |
|---|---|---|
| 接受 | conf ≥ 0.95 |
写死,不可撤销,后续所有块都拿它当前缀 |
| 保持 mask | conf < 0.95 |
下一轮带着更多已知位置重算,通常更容易过线 |
| 强制填充 | 全块都 < 0.95 |
取全场最高,牺牲这一格的正确性换整块的推进 |
第二列是这套解码器最硬的约束:并行换来的速度,代价是错误不可撤销。
对比一下投机解码:草稿 token 被拒绝可以丢掉重来,因为验证是并行的、决策是事后的。块扩散里,一次接受就等于一次沉默的提交,没有回溯。
0.95 是怎么来的
先看兜底分支有多常触发。用一个玩具模型估算:假设块内 32 个位置互相独立,每个位置单轮达标的概率为 $p$,那么「一轮全都不达标」的概率是 $(1-p)^{32}$。
| 单轮达标率 $p$ | 期望每轮接受 | 粗略轮数 | 触发强制填充的概率 |
|---|---|---|---|
| 0.10 | 3.2 | 10+ | 3.4% |
| 0.20 | 6.4 | 5 | 0.08% |
| 0.30 | 9.6 | 3.3 | 0.0011% |
| 0.40 | 12.8 | 2.5 | 0.0000079% |
(玩具模型,忽略位置之间的相关性,只用来判断量级。)
这张表说明一件事:只要单轮达标率不低于 0.2,强制填充就是罕见的兜底路径,不是常规路径。它的存在意义是防止死循环,而不是提吞吐。这也解释了为什么要专门设计这条分支——一旦整块持续不收敛,没有它,循环会退化成无限重算。
那为什么阈值定在 0.95 而不是 0.8 或 0.99?
因为错误代价是不对称的。接受一个错 token 的损失,远大于少接受一个对 token 的损失:
- 少接受一个 → 下一轮还能看到它,最多多迭代一轮,代价是一次前向;
- 多接受一个错的 → 它进入前缀,后面所有块的上下文都被污染,而且没有机制能把它撤回来。
当错误不可撤销时,最优决策不是「接受期望收益最高的一批」,而是「只接受分布尾部」。0.95 正好落在这个位置上:它把接受范围压到相当靠右的尾部,同时又不至于让每轮的接受数掉到个位数以下。
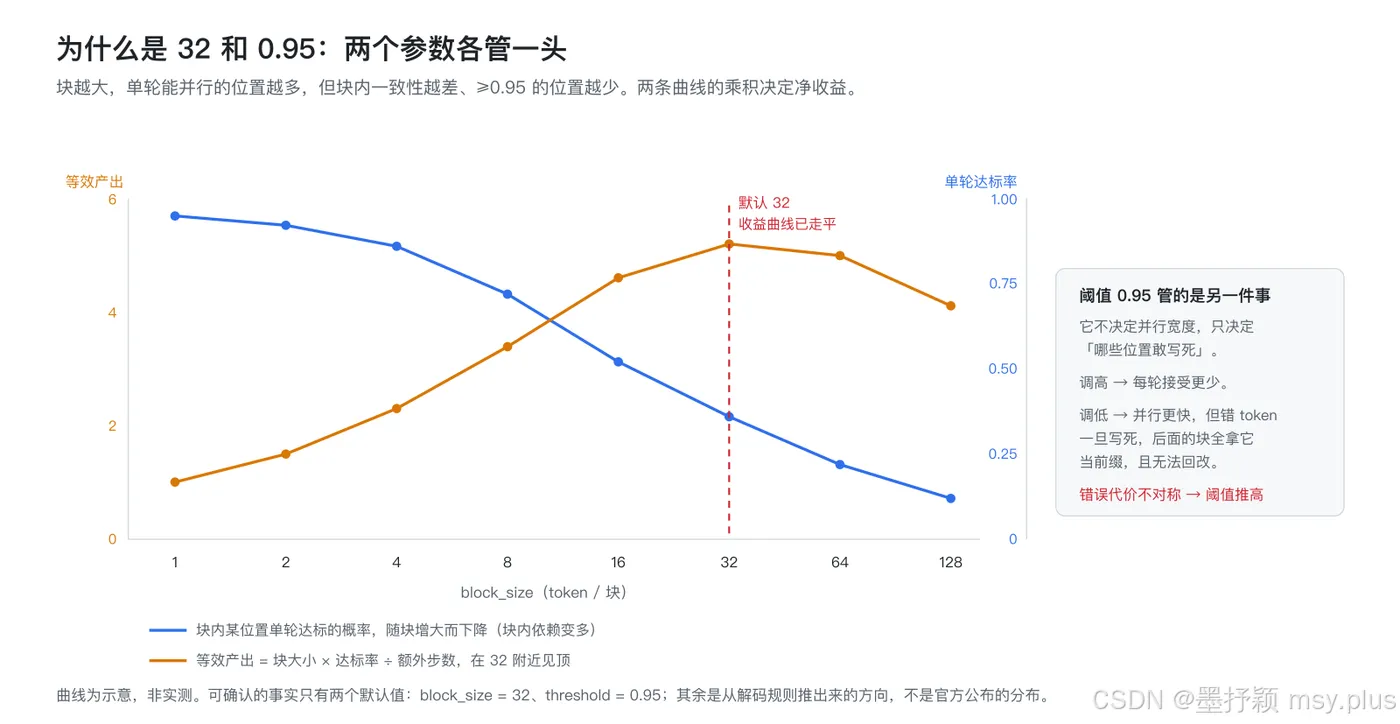
图 3 · block_size 决定并行宽度,threshold 决定敢不敢写死。两者作用在完全不同的地方,不能互相替代。
32 又卡在哪
块大小是另一个方向的权衡:
- 块太小 → 并行度低,退化成自回归,每次前向只换一两个 token;
- 块太大 → 块内依赖变多,靠前的 token 要在缺少后面信息的情况下决定,达标率下降,迭代轮数上升。
净收益大致是「块大小 × 单轮达标率 ÷ 额外步数」,形状上会先升后平。32 看起来是这条曲线的平台区起点:再往上加,收益增长明显放缓,而块内一致性损失还在继续付。
这里补一句免责:官方只公布了两个默认值,没有公布达标率随块大小变化的曲线。上面这条曲线是从解码规则推出来的方向判断,不是实测数据。
四、GDN 改造:三处补丁,补的是「没有左边」
模型卡说 Clover 保留了基座的混合骨干:Gated DeltaNet / 全注意力,40 层,256 个路由专家,top-8,每层 1 个共享专家,总参数 35B,每 token 激活约 3B。
麻烦在于,GDN 这套东西天生是因果的。
GDN 属于线性注意力族,用固定大小的循环状态承载历史。标准更新形式大致是:
$$ S_t = \alpha_t \cdot \bigl( S_{t-1} - \beta_t\, k_t (k_t^\top S_{t-1}) \bigr) + \beta_t\, v_t k_t^\top $$
读法:先把「当前 key 在旧状态里的响应」擦掉(减号那项,delta rule),再写入新的键值对;$\alpha_t$ 是整体衰减门。整个过程严格按 token 顺序推进,第 $t$ 步只能看到第 $t-1$ 步的状态——因果关系是内建在递推结构里的。
块扩散把这个前提打掉了:32 个位置同时生成,谁都不是谁的「左边」。
Clover 的做法是三处改动(这部分有官方披露):
其一,历史不进注意力,进状态。 已解出的块被压缩进持续更新的循环状态,不再以 KV 的形式参与后续计算。128K 上下文的记忆占用因此是一个常数,不随长度线性增长。
其二,当前块走双向注意力。 块内 32 个位置互相可见,不设因果掩码。代价是 $O(B^2)$,但 $B = 32$ 是常数,与上下文长度无关。
其三,历史记忆的读出单独成为一路。 从状态里读出的记忆不是拼进 K/V,而是作为一个独立信息单元参与注意力计算,前文与当前块的权重分配交给模型自己学。
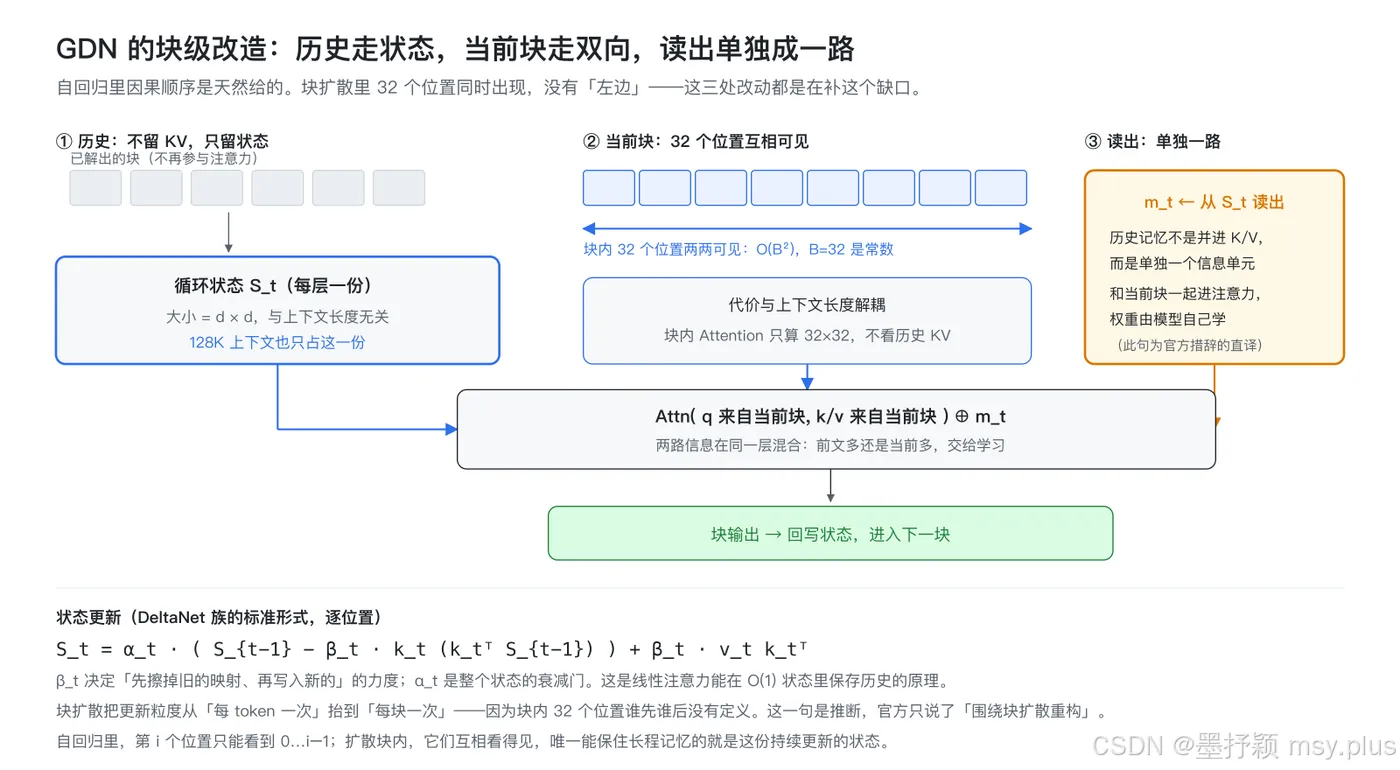
图 4 · 历史走常数大小的状态,当前块走双向注意力,两者在同一层混合。
成本结构对比
| 方案 | 历史表示 | 每块的主要开销 | 128K 时的增长 |
|---|---|---|---|
| 双向全注意力 | 完整 KV | 读全部历史 KV | 线性,最贵 |
| 因果全注意力 | 完整 KV | 读全部历史 KV | 线性 |
| 纯状态(标准 GDN) | $d \times d$ | 逐 token 更新状态 | 常数 |
| 混合(本文描述) | 状态 + 块内 | 块内 $O(B^2)$ + 状态更新 | 常数(块内项与 L 无关) |
最后一行是我按披露内容推的成本量级,不是官方给的复杂度分析。但方向上没有疑问:只要历史以状态形式保存,长上下文的 decode 成本就和长度脱钩。这条性质在最近的线性注意力架构里是共通的,Clover 的特殊之处在于它要为「块内无因果序」额外付一次 $O(B^2)$。
为什么读出要单独成一路
这一条官方只给了结论,我给一个机制上的解释(推断):
如果把从状态读出的记忆直接当作额外的 K/V 拼进注意力,模型对「历史」和「当前」两路信息的相对权重就被张量形状锁死了。单独成一路之后,混合权重变成一个可以学的量——模型自己决定这一步该多看前文还是多看块内。
对 Agent 场景这是有价值的。工具返回的长文本需要「按需回看」,而当前这一步的动作往往只需要局部上下文。固定的拼接比例会让这两件事互相干扰。
五、MoE 的账:块扩散把专家命中率放大了
这里有个容易被忽略的成本。MoE 在自回归 decode 里非常省:一步只触发 top-8 个专家,读的权重很少。
但块扩散一步要过 32 个位置。这 32 个位置会路由到不同专家,一步之内触达的专家并集远大于 8 个。
粗算一下(全部是测算,假设见下):
| 口径 | 每步读取 | 每步耗时 @3.35 TB/s | 每步产出 | 折算吞吐 |
|---|---|---|---|---|
| 自回归,1 token | 6.0 GB | 1.8 ms | 1 个 | 约 555 tok/s |
| 块扩散,32 位置 | 8.5 GB | 2.5 ms | 约 10 个 | 约 4000 tok/s |
假设:总参数 35B、激活 3B、BF16、HBM 3.35 TB/s;块内 32 个位置路由到不同专家但集合高度重叠,唯一专家数约为单 token 的 4 倍,权重读取放大到 1.4 倍;每步实际落定约 10 个 token(按第三节的达标率量级估)。
关键在于两个数的量级差:读取字节只涨了 1.4 倍,产出涨了 10 倍。净收益约 7 倍。
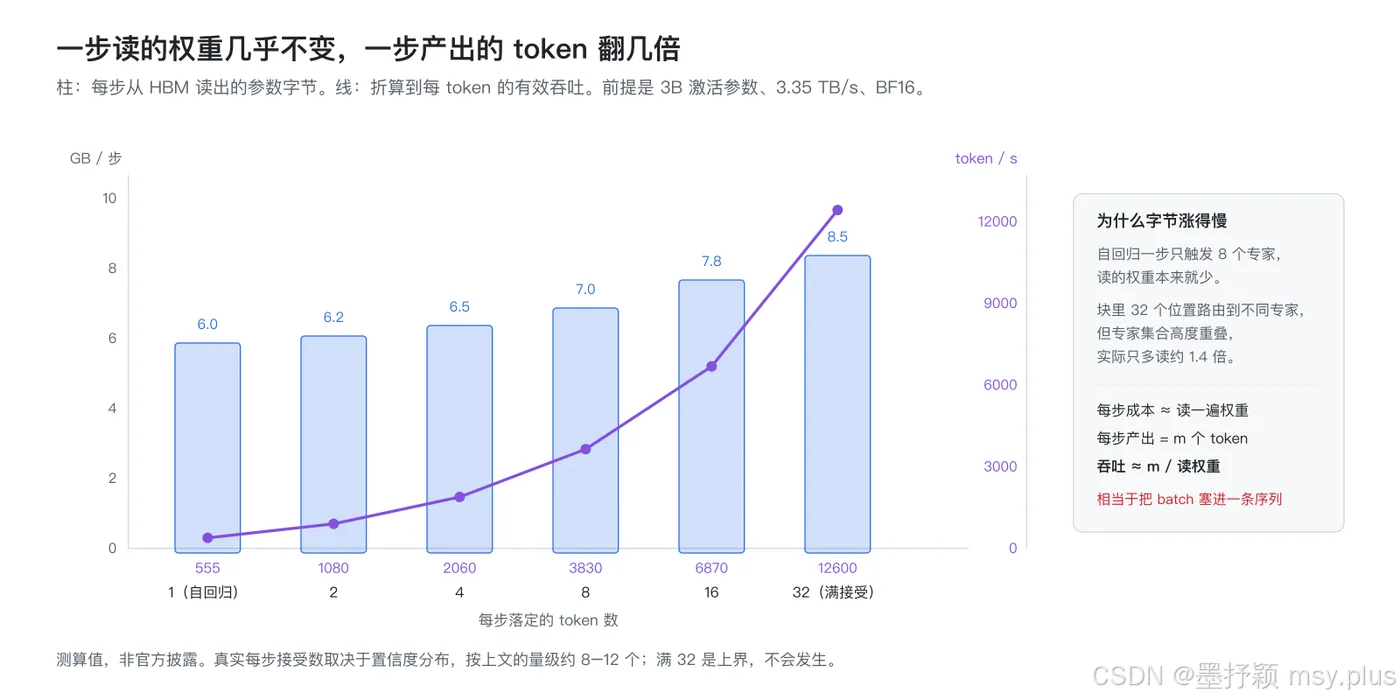
图 5 · 柱是每步读出的字节,线是折算吞吐。收益的来源是「同一份权重被更多 token 共用」。
这组数字要配一句边界说明:它在单请求口径下成立。
如果并发足够高,自回归的 batch 本来就已经把算术强度推上去了,块扩散的边际收益会缩小——那时候 GPU 已经接近算力受限,多产出 token 不再免费。所以块扩散不是通用加速器,它的价值集中在「并发上不去」的场景。Agent 恰好就是:一条任务链,一次一个请求,中间还要等工具返回。
六、为什么从 Qwen3.6-35B-A3B 的权重出发
模型卡写得很清楚:Clover 不是从头训练的扩散模型,而是以 Qwen3.6-35B-A3B 的自回归权重为起点做的适配。
这条路团队不是第一次走。2025 年 4 月的 Dream 7B 就是从 Qwen2.5 7B 初始化,据称累计下载超过 250 万次。
好处很实在:省掉从零预训练的成本,直接继承一个成熟基座的语言能力和世界知识。代价同样明确——能力上限在相当程度上仍由基座决定,扩散带来的增量集中在解码侧:
- 并行生成带来的速度;
- 块内双向注意力带来的局部交互灵活性。
它不是一个独立于自回归体系的新能力维度。这个判断很重要,因为它决定了该怎么读那些基准数字:Clover 拿到 73.6 的 SWE-bench Verified,这里面有多少来自 Qwen3.6 基座、有多少来自扩散改造,从公开信息里分不开。
适配本身也有技术难度。自回归权重是在因果掩码下训练出来的,改成块内双向之后,模型要重新学会在「看得见右边」的条件下分配注意力。这不是改个 mask 就完事,需要足够的继续训练让权重适应新的可见性。
七、纸面成绩,和它的三个边界
官方公布、并被量子位引述的基准:
| 基准 | 结果 | 口径 |
|---|---|---|
| WindTunnel Agent(49 任务 ×3) | 中位执行 1.52 s | 对手组合 Jev + Mercury 2.5 为 3.21 s |
| WindTunnel 尝试成功率 | 98.6% | 对手 95.9% |
| τ³ Overall(工具使用) | 65.3 | — |
| BFCL-v4(函数调用) | 67.9 | — |
| SWE-bench Verified | 73.6 | 真实仓库问题修复 |
| Terminal-Bench 2.1 | 51.7 | 终端任务执行 |
这些数字在纸面上有说服力,但读的时候要带上三个边界。
第一,全部是自报,没有独立复现。 发布当日,知乎、Reddit、Hacker News 上都还没形成可检索的第三方评测规模。模型和报道同日上线,社区消化需要时间。
第二,「中位执行时间」这个指标混合了两件事。 1.52 s 对 3.21 s,既包含每步并行产出带来的速度,也包含「连续任务里少犯错、少重试」带来的路径缩短。后者对结果的影响可能更大,但很难从单一数字里拆出来。
第三,模型卡自己承认了退化。 原文写的是「我们观察到非常长的生成有时会变得重复」,为此内置了重复控制和渐进偏向结束的控制项。
这句话值得单独拎出来。它意味着长程生成中的输出退化仍然需要工程手段对冲,不是被架构解决掉的。对 Agent 这种动辄连续几十轮的任务来说,这是一个明确的待验证项,而不是已被跨越的障碍。
还有一层更微妙的:量子位的体验里提到,在连续六项 WebMCP 任务中 Clover 的稳定性是「关键进步」,速度上「彻底甩开」了 Gemini 3.6 Flash。这是发布当日的一手体验,属于主观判断加少量对照,不是可复现的基准。它提供的价值是给出方向,不是给出结论。
八、128K 上下文里,什么被加速了,什么没有
128K 是明确规格,但「支持 128K」和「128K 下都快」是两件事。分开看:
| 环节 | 是否受益 | 原因 |
|---|---|---|
| decode 每步的权重读取 | 是 | 一步产出多 token,权重复用率上升 |
| decode 的历史读取 | 是 | 历史压缩进常数状态,不再随长度线性增长 |
| decode 的块内注意力 | 轻微变贵 | $O(B^2)$,但 $B$ 固定,与 128K 无关 |
| prefill | 否 | 输入侧仍要完整跑一遍,长度线性 |
| 混合骨干里的全注意力层 | 部分 | 这些层的长 KV 仍是成本大头,未被消除 |
| 块内一致性 | 变差 | 块越大、上下文越长,块内位置可参考的信息越不完整 |
最后一行是这套设计的结构性代价,需要说清楚。
自回归生成时,第 $n$ 个 token 能看到前 $n-1$ 个。块扩散里,块内第 $k$ 个位置在决定自己时,块内第 $k+1$ 到 $32$ 个位置还是 mask——它必须在一个「后面还不知道」的状态下做判断。块越大,这个信息缺口越大。
LowConfidence 的标准 0.95 就是在给这个缺口定价:只有足够确定的才敢写。这也部分解释了为什么块大小停在 32 而不是 128。
对 Agent 来说,这个代价的实际形态是:工具调用的参数里,越靠块后部的位置,越可能因为看不到块内前文而写错。而这一类的错误在 JSON 参数里是致命的。社区复现如果要做,这是我建议优先压测的地方。
九、这套设计里能搬走的三件事
第一,提高算术强度的路径不止「加并发」。
主流推理优化都在往 batch 上堆,但 batch 需要流量支撑。块扩散提供的是另一条路:让单条序列的一步产出多个 token,用同样的算力换更高的权重复用率。凡是并发上不去的场景(单机 Agent、端侧、长任务链),这条路的性价比都会被重新评估。
第二,压缩历史 + 局部全可见,是把非因果生成塞进长上下文的一般解法。
只要生成不是严格从左到右的,你就必须回答一个问题:块内互相看不见的地方,靠什么补?Clover 的答案是「历史走常数状态,块内走双向,读出单独成一路」。这套三段式不依赖扩散,任何需要并行输出的结构(并行解码、多候选生成、结构化输出)都能借鉴。
第三,置信度阈值不是超参,是错误代价的函数。
0.95 这个数不好看,也不整数,但它直接对应「错误不可撤销」这个约束。如果换了可以回溯的机制,同一个任务的最优阈值会低得多。调参时先问「错了能不能改」,再定阈值。
如果熟悉前端,有个类比还算贴切:自回归 decode 像串行的 rAF 循环,每帧只算一个增量;块扩散像把一批更新合成一次 diff 提交——提交前可以反复重算(保持 mask),提交后就是事实(写死不可回改)。GDN 的状态则像是增量缓存,只保留「当前视图」而不是整棵旧树。
十、想自己验,从这几处下手
模型卡和权重都在 Hugging Face 上,可以直接跑。建议按这个顺序看:
- 观察块边界。 固定随机种子,输出长文本,找重复段落和语法断裂的位置。如果断点呈现 32 的倍数的周期性分布,说明块边界确实在影响生成质量——这是最直接的架构指纹。
- 压测块后部的位置。 构造必须长距离引用前文的任务(比如让模型在 JSON 末尾重复第 3 个字段的值),观察错误是否集中在块内偏后的位置。这是第八节那个信息缺口的可测形态。
- 扫阈值。
threshold从 0.8 到 0.99,记录「每步接受数」和「输出正确率」两条曲线。官方没公布这条曲线的形状,这可能是社区最容易产出的独立数据。 - 扫块大小。
block_size从 8 到 64,看第三节那条「先升后平」的曲线在真实模型上到底在哪见顶。32 是不是平台区起点,一测就知道。 - 长任务退化。 模型卡已经承认长生成会重复。跑一个连续 50 轮的工具调用链,观察重复控制被触发的频率,以及渐进结束控制会不会导致提前截断。
前三项是架构层面的观察,后两项是工程层面的观察。前者更学术,后者更接近能不能上生产。
十一、数字速查
| 项目 | 数值 | 来源 |
|---|---|---|
| 块大小默认值 | 32 token | 模型卡 |
| 置信度阈值默认值 | 0.95 | 模型卡 |
| 上下文规格 | 128K | 官方规格 |
| 总参数 / 每 token 激活 | 35B / 3B | 模型卡 |
| 层数 | 40 | 模型卡 |
| 路由专家 / top-k / 共享专家 | 256 / 8 / 每层 1 个 | 模型卡 |
| 基座 | Qwen3.6-35B-A3B | 模型卡 |
| WindTunnel 中位执行时间 | 1.52 s(对手 3.21 s) | 官方,自报 |
| WindTunnel 尝试成功率 | 98.6%(对手 95.9%) | 官方,自报 |
| τ³ Overall | 65.3 | 官方,自报 |
| BFCL-v4 | 67.9 | 官方,自报 |
| SWE-bench Verified | 73.6 | 官方,自报 |
| Terminal-Bench 2.1 | 51.7 | 官方,自报 |
| 单请求 decode 理论上限 | 约 555 tok/s | 本文测算(3B 激活,3.35 TB/s) |
| 块扩散折算吞吐 | 约 4000 tok/s | 本文测算,非官方 |
| 一轮全不达标的概率(p=0.2) | 0.08% | 本文玩具模型 |
我自己的判断
Clover 不是「扩散取代自回归」的证明。它是从 Qwen3.6 权重出发做的适配,能力上限受基座约束,那条「架构替代」的融资叙事和工程现实之间有张力。
但它确实把一件具体的事做扎实了:在并发上不去、上下文又很长的场景里,让一步前向产出多个 token。这个思路不新(块扩散、置信度并行解码在学术上都有人做过),把它和 GDN 的块级改造拼到一起、做成一个 35B 的 Agent 模型,是工程上的推进。
值不值得关注?值得。但它现在的位置是「一条有明确工程路径的候选路线」,不是结论。纸面数字要等社区复现,长程稳定性要等压力测试,而那两件事都需要时间。
参考:
- 量子位:Clover-35B-A3B-Preview 发布报道(2026-10-28) — 一手体验、Agent 任务实测、团队背景
- Hugging Face 模型卡:Clover-35B-A3B-Preview — 架构细节、解码参数、基座、局限自述
- 雷峰网·鲸犀(2026-09-17):35B 模型发布预告与团队融资背景
- 融资报道(2026-10-09 至 10-21):近 5 亿元两轮融资,经纬创投、顺为资本、君联资本领投,华为哈勃、地平线等跟投
- 扩散智能 Dream 7B(2025-04):同路径先例,从 Qwen2.5 7B 权重初始化
文中图 1–图 5 为本文自绘。标注「测算」的数字均为公开参数下的推算,不代表官方性能数据;标注「推断」的结构描述属于机制解释,官方原文仅给出结论。


