在2017年神经信息处理系统大会(NIPS)中的一篇论文里,我和我的团队提出了一个叫做Net-Trim的AI优化框架,其使用逐层凸体系(layer-wise convex scheme)来精简预训练深度神经网络。
深度学习对许多AI应用来说已经成为了最佳选择,它的范围从影像识别到语言翻译。多亏了算法和计算能力的发展,我们现在可以通过训练更大型和更深层次的神经网络来提高AI的精确度。然而,由于资源消耗和存储使用量的增加,在硬件资源和功耗受限的嵌入式设备中配置这种模型是不切实际的。
克服这个挑战的一种可行性方法是,在不牺牲精确度的前提下降低模型的复杂度。该方案涉及到去除潜在的冗余数量,以达到使网络稀疏化。众所周知的L1正则法已经被广泛的用于高效的发现浅层网络稀化的解决方案,比如线性回归和逻辑回归。然而,这些技术在深度学习的应用中无用武之地,部分原因是与深度学习相关的损失函数是高度非凸性的,而优化算法无法找到一个既能保持稀化又能提供高精准度的有效方法。
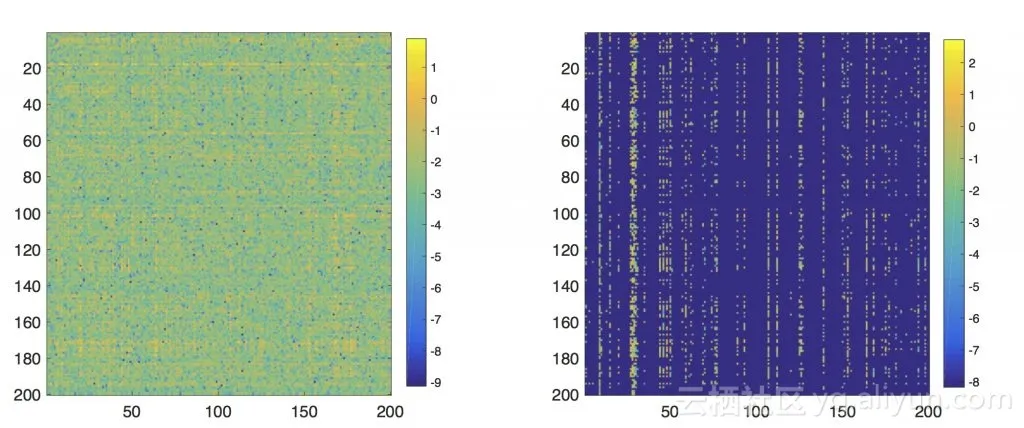
在训练前后与隐藏层相关的加权邻接矩阵图,对整体网络响应只有微不足道的变化,Net-Trim能够精简掉神经网络中93%的无用神经元,并对问题带来了显著的简化模型。
由前IBM研究员、现乔治亚州立大学(Georgia State University)助理教授阿加西(Alireza Aghasi)、乔治亚理工学院(Georgia Tech)的阿夫申·阿布迪(Afshin Abdi)和乔治亚理工学院(Georgia Tech)的副教授贾斯汀·罗姆伯格(Justin Romberg)和我组成这支团队来应对这个挑战。论文中讲述了我们的成果“Net-Trim:无性能损失的深度神经网络凸精简”。当Net-trim被应用到预训练网络中时,它会找到每层最稀疏的一组权重,以保证输出响应与初始训练的响应一致。对稀疏性使用标准的L1松弛(L1 relaxation)时,由于校正线性单元激活是分段线性的,因此允许我们通过解决凸化程序来执行检索。
更具体的来说,训练数据是通过训练的网络逐层传送的,在每一层里,我们提出了一种优化方案,该方案不仅能够提高权重稀化,同时确保得到的响应与预先训练的网络响应保持一致。从某种意义上来说,如果我们考虑把每层传输数据的响应作为一个检查点,那么Net-Trim能确保检查点基本保持不变,同时它能发现检查点之间更简单的路径。Net-Trim其中一项优点便是能使用凸化公式(Convex formulation),能够适用各种标准凸优化。
我们的成果与最近本领域的工作有很大的不同,差异点在于:首先,我们的方法在数学上是可证明的,并且已经证明了被Net-Trim精简前后的网络能够保持类似的执行效果。另外,与其他使用阀值精简的最近的技术相比,Net-Trim在第一次修剪完后,不再需要更多其它那些浪费时间的重复训练步骤。而且由于我们的方法具有后处理的特性,Net-Trim可以很方便的搭配各种最新的类神经网路,不管用在训练模型的原始过程什么样,Net-Trim可以作为一个增加的后处理步骤来看待,除了缩小模型大小,还能提高模型的稳定性以及提高预测的精准度。
需要注意的是,除了使计算更加易于处理外,Net-Trim的凸化公式还能让我们可以得到再训练模型与初始模型之间差距的理论保障,并对再训练一个推测的稀疏层所需随机样本有一些关于样本复杂度的争论。net-trim是第一个能保证性能无损的精简方案。通过增加额外的惩罚条款或引入额外的凸约束,它也可以很容易地修改和适应涉及权重的其他结构上的约束。
使用MNIST数据,我们的成果在不损失分类精度的同时,可以裁减掉超过95%的权重。另外,用更复杂的SVHN数据集可以去除掉90%的权重。当比较模型大小时,Net-Trim能够将数据模型的大小从100MB缩减到5MB,这使得它可以高效的应用在移动设备上。
有趣的是,人类大脑的发展遵循类似的模式,即“精简”神经元突触是学习过程的一个重要组成部分。著名的神经学家Peter Richard Huttenlocher (1931 - 2013)通过突破性的研究表明,婴儿在出生后的最初几个月里,大脑皮层会形成了数十亿个神经元突触。然而,在随后的几年里,很多突触因为很少使用被精简掉了,但同时还保持了具有重要功能的突触。
本文由北邮@爱可可-爱生活 老师推荐,阿里云云栖社区组织翻译。
文章原标题《Pruning AI networks without performance loss》
作者:Nam Nguyen
译者:奥特曼,审校:袁虎。
文章为简译,更为详细的内容,请查看原文