



数字孪生核心技术揭秘(一):渲染引擎
从2017年“数字孪生城市”概念走红开始,全国各地“数字孪生城市”如雨后春笋般涌现,迅速推动了整个行业快速发展。与此同时,整个“数字孪生城市”产业链路上的技术瓶颈开始显现,尤其是数字孪生城市构建的核心环节之一的三维渲染引擎已经成为制约数字孪生城市项目正真实战落地的核心痛点。

【DSW Gallery】基于EasyNLP的BERT英文机器阅读理解
EasyNLP提供多种模型的训练及预测功能,旨在帮助自然语言开发者方便快捷地构建模型并应用于生产。本文以机器阅读理解为例,为您介绍如何在PAI-DSW中基于EasyNLP快速使用BERT进行英文机器阅读理解模型的训练、推理。
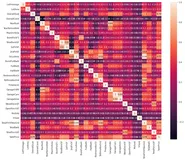
【DSW Gallery】数据分析经典案例:Kaggle竞赛之房价预测
Python是目前当之无愧的数据分析第一语言,大量的数据科学家使用Python来完成各种各样的数据科学任务。本文以Kaggle竞赛中的房价预测为例,结合JupyterLab Notebook,完成数据加载、数据探索、数据可视化、数据清洗、特征分析、特征处理、机器学习、回归预测等步骤,主要Python工具是Pandas和SKLearn。本文中仅仅使用了线性回归这一最基本的机器学习模型,读者可以自行尝试其他更加复杂模型,比如随机森林、支持向量机、XGBoost等。

十大行业经典案例!Apache Flink 的 40 个最佳实践
如今,Apache Flink 行业应用几何?在降本增效的需求驱动下,企业如何实现数据与算力价值最大化?本文整理了 Flink 社区近一年的社区案例,并按照行业进行分类,供大家参考!


持续定义Saas模式云数据仓库+实时搜索
本文由阿里云计算平台事业部 MaxCompute 产品经理孟硕为大家带来《持续定义Saas模式云数据仓库+实时搜索》的相关分享。以下是视频内容精华整理,主要包括以下三个部分:1.Why:概述与价值;2.What:应用场景;3.How:最佳实践。

重新定义性能测试: Apache Flink 重磅开源流计算基准测试框架
每一种引擎有其优势的地方,如何选择适合自己业务的流计算引擎成了一个由来已久的话题。除了比较各个引擎提供的不同的功能矩阵之外,性能是一个无法绕开的评估因素。基准测试(benchmark)就是用来评估系统性能的一个重要和常见的过程。

滴滴基于 Flink 的实时数仓建设实践
随着滴滴业务的高速发展,业务对于数据时效性的需求越来越高,而伴随着实时技术的不断发展和成熟,滴滴也对实时建设做了大量的尝试和实践。本文主要以顺风车这个业务为引子,从引擎侧、平台侧和业务侧各个不同方面,来阐述滴滴所做的工作,分享在建设过程中的经验。

免费下载 | 阿里云实时计算整体解决方案白皮书重磅发布!
为更好的助力各行各业实现企业数字化转型,为企业的创新、重构核心竞争力提供坚实支撑;阿里云实时计算重磅推出金融、物流、IoT、广告等行业整体解决方案白皮书。

为什么说 Flink + AI 值得期待?
近年来 AI 持续火热,各种计算框架、模型和算法层出不穷,从某种角度上来说,这个赛道已经有些拥挤了。在这种情况下, Flink 将怎样拥抱 AI,又会为用户带来什么新的价值?Flink AI 的优劣势分别在哪里?本文将通过对这些问题的讨论来分析 Flink AI 的发展方向。

首月99元,3分钟入门DataWorks(标准版)强大功能!
DataWorks作为飞天大数据平台操作系统,对接各种大数据计算引擎,以all in one box的方式提供专业高效、安全可靠的全域智能大数据平台,高效率完成数据全链路研发流程,建设企业数据治理体系。 从2009年飞天大数据平台写下第一行代码开始,DataWorks历经10年发展,形成一套成熟的产品功能体系,满足企业数据中台搭建需求。在阿里巴巴内部,每天有数万数据/算法开发工程师正在使用DataWorks,现在仅需99元你就可以体验到DataWorks标准版的强大功能!

Apache Flink 零基础入门(八): SQL 编程实践
本文是 Apache Flink 零基础入门系列文章第八篇,将通过五个实例讲解 Flink SQL 的编程实践。
阿里小二的日常工作要被TA们“接管”了!
昨天有人偷偷告诉我说 阿里巴巴其实是一家科技公司! 我想了整整一夜 究竟是谁走漏了风声 那么重点来了,阿里到底是如何在内部的办公、生活中,玩转“黑科技”的呢? AI取名:给你专属的“武侠”花名 花名是阿里巴巴独特的文化,也是阿里员工独一无二的“身份”。
使用 MaxCompute Studio 开发大数据应用
MaxCompute(原ODPS)是阿里云自主研发的分布式大数据处理平台。MaxCompute Studio 为开发者提供了良好的开发体验,本文将展开进行介绍。
微店商品列表 API 接口解析(附 JSON 样例)
本文介绍微店官方商品列表接口micro.item_search(v2.0),支持按店铺/类目批量获取SPU/SKU基础信息(标题、价格、销量、主图等),适用于私域ERP同步、店铺搬家、分销选品及多店统一管理,安全合规、免维护,替代高风险网页爬虫方案。(239字)
StarRocks 迁移至 Apache Doris 完整指南:三步完成结构、数据与业务平滑切换
StarRocks 怎么迁移到 Apache Doris?SR 迁移 Doris 是否需要重新建表?几亿、几十亿数据怎么搬?DataX、Flink、Parquet 应该怎么选?全量迁移之后又如何保证增量数据不丢?
GEO策略与引用思维:从争网页排名到争AI答案席位
GEO策略聚焦AI答案席位争夺,超越传统SEO排名思维,强调可追溯引用与实体准确性。涵盖七层体系:目标转向答案席位、引用思维替代排名、AI爬虫可访问性、Schema结构化表达、多平台采样观测、时效与质量平衡、电商本地化适配,全程以实证验证为根基。(239字)
告别爬虫采集1688商品数据:1688拍立淘图片API接入实践方案
1688.item_search_img是B端专属图片搜索API,支持POST(Base64)/GET(URL)方式,基于深度学习匹配同款/相似批发商品,返回起订量、阶梯价、工厂标识等产业带字段,适用于选品、竞品监控与供应链采购。(239字)
企业官网GEO优化实战:可见性诊断、结构化评分与引用追踪的完整闭环
GEO优化最大的难题是无法度量效果。本文从实际项目出发,搭建一套可落地的AI搜索可见性诊断与度量体系:多引擎关键词覆盖检测与可见性评分模型、内容结构化六维评分表、FAQ Schema配置、AI引用追踪与优化优先级排序,并给出效果验证周期和5个常见踩坑。
瓴羊 AgentOne 深度解析:四大 AI 员工上岗,营销、客服、运营、销售一次配齐
瓴羊AgentOne推出四大AI员工(销售、客服、运营、营销),深度融合企业数据、场景与业务系统,实现从“能聊”到“能干”的跃迁。依托“大模型×好数据×强场景”公式,构建“能信、能干、能打”三角能力,端到端交付GMV、解决率等真实业务结果。
AI引用源集中度机制解析:平台策略与内容锚点布局的2027年演化路径
本文基于多引擎实测,揭示AI搜索引用机制新趋势:豆包高度集中(CSDN占34%),秘塔呈长尾分布;2027年起,可信度审核升级,内容锚点质量与跨平台交叉印证成入选关键,并提供可复现的平台地图绘制与锚点审计方法。
高并发下 AI Agent 策略:分布式 Agent 系统的架构设计
本文探讨AI Agent在高并发场景下的系统架构挑战与设计策略,涵盖事件驱动架构、消息队列调度、Agent池化、模型服务独立部署、Continuous Batching、RAG优化、上下文管理及成本控制等核心要点,助力构建稳定高效的生产级智能体系统。
跨境代购中小卖家生存法则 + 淘宝代购系统降本增效完整方案
本方案为跨境代购中小卖家量身打造,提炼五大生存法则:轻资产纯代采、数字化服务突围、严控成本、合规风控、垂直深耕。配套淘宝代购系统,实现采购、集运、仓储、财务、营销全链路自动化,降本增效,助力稳定盈利。(239字)
让 Agent 越用越准、成本越来越低:AgentLoop 的 Agent 经验自进化闭环
企业 Agent 上线后,如何在不重新训练模型的情况下提升准确率、稳定性并优化单位成功成本?本文介绍 AgentLoop 如何基于真实运行轨迹自动生成可复用经验,通过 Skill 和 CLI 按需召回,并给出控制台接入步骤及与 Memory、RAG、微调、RL 的差异。
为什么爬虫并发拉到几百,吞吐反而掉了?记一次高并发爬虫性能瓶颈排查与实战
本文探讨了高并发环境下数据采集和爬虫扩容的挑战,强调了提高并发量可能不会提升吞吐量,反而可能导致系统变慢。文章介绍了排查单机资源瓶颈的方法,并讨论了代理隧道的瓶颈。提供了一个Python asyncio + aiohttp的生产级爬虫代码示例,整合了连接池控制、隧道代理接入等,以解决高并发下的吞吐抖动和429报错。最后,总结了爬虫调优的分层治理法则,强调了在遇到问题时,应遵循迭代路径,找准真正的瓶颈层进行优化。
数学周刊第25期(2026年07月06日-07月12日)韦东奕获奖中科院发布全流程数学研究智能体MMAT
数学周刊第25期(2026年07月06日-07月12日)韦东奕获奖中科院发布全流程数学研究智能体MMAT
那些年我们踩过的坑:如何处理网页爬取中的中文字符集乱码(GBK/UTF-8)?
文章讨论了网页乱码问题,分析了编码不一致的原因,详解HTTP头、Meta标签、chardet检测冲突,结合隧道代理(如爬虫代理)给出智能编码识别方案,支持GBK/UTF-8自动判别与降级解码,并提供了使用高质量代理和智能编码检测的解决方案及排查清单。
GEO 技术赋能传统媒体数字化转型:广电场景下的 AI 获客与内容创新实践
生成式引擎优化(GEO)作为 AI 时代全域增长的关键技术,正推动传统媒体与前沿技术的深度融合。本文以湖南广电金鹰卡通与 GEO 技术专家周有贵团队的合作为案例,从技术原理、场景落地、价值共创三个维度,解析 GEO 技术在广电客户精准运营、品牌全域建设、内容生态创新中的应用路径,为传媒行业数字化转型提供可复用的技术实践参考。
别再手写低效的代理池了,试试这3个开箱即用的调度框架!
本文详解3种实战级代理调度框架:ProxyPool+API(中大型)、轻量轮询队列(中小项目)、Scrapy隧道中间件(快速升级),含核心代码、避坑要点与选型建议,助爬虫稳定高效运行。
AI+数字孪生:从实时映射到智能决策的技术架构与实践路径
当数字孪生遇上AI,物理世界拥有了“预演未来”的能力。2026年,“可执行数字孪生”兴起——凡拓数创自研AI 3D引擎支持多物理场仿真与千万次并行训练,已在机器人Sim2Real迁移、工业预测性维护等场景落地见效。
AI获客新突破!西外GEO研究中心周有贵博士:GEO技术如何重构跨境获客逻辑
在AI重构流量格局的当下,GEO(生成式引擎优化)正成为AI获客核心引擎。2026年4月12日,西安外国语大学开营仪式上,GEO研究中心负责人、巴黎学院人工智能博士周有贵面向欧洲青年系统解析GEO技术原理与跨境落地三步法——标签体系构建、跨语言语义适配、自动化转化闭环,助力企业实现“被推荐”式精准获客,契合阿里云社区“技术落地、实战赋能”理念。(239字)
鹰角网络:EMR Serverless Spark 在《明日方舟》游戏业务的应用
鹰角网络为应对游戏业务高频活动带来的数据潮汐、资源弹性及稳定性需求,采用阿里云 EMR Serverless Spark 构建云原生大数据架构,迁移后实现计算加速50%,核心链路产出时间提前1.5h,研发效率和稳定性显著提升!
EMR Serverless Spark 携手 PAI/百炼,开启“SQL 即 AI”的新篇章
EMR Serverless Spark 深度集成 AI Function 能力,并无缝对接 阿里云百炼与 阿里云人工智能平台 PAI 模型在线服务 PAI-EAS,定义了“SQL 即 AI”的新解决思路,数据分析师只需一行 SQL,即可直接调用世界顶尖的大模型。

Flink CDC 3.6.0:支持 Flink 1.20/2.2, MySQL/PostgreSQL入湖入流支持Schema Evolution
Apache Flink CDC 3.6.0 正式发布!支持 Flink 1.20.x/2.2.x 与 JDK 11,增强端到端 Schema Evolution(MySQL/PostgreSQL 入湖入流),新增 Oracle Source 与 Hudi Sink 连接器,全面覆盖主流数据湖生态,并优化 Transform 框架、YAML 路由及多连接器能力。(239字)
2026年各大厂商OpenClaw中文生态分析调研汇报
OpenClaw(原Moltbot)是开源AI助手框架,ClaudeCowork为Anthropic官方企业协作工具;生态涵盖轻量版(Pico/NanoClaw)、高性能版(MaxClaw)、行业定制版(MedClaw、ClawWork等)及社区衍生项目(LobsterAI、RedClaw等),以Obsidian为知识库,OpenFang为交互协议。
我学GEO第10天:被豆包引用了,还被千问、元宝认识了
我是二二得四,专注GEO优化第10天。零基础起步,坚持每日图文输出、多平台分发、AI友好写作,已实现豆包/千问/元宝识别“二二得四”(置信度50%-65%),首篇文章被豆包引用。边学边测、边做边迭代,用真实过程记录普通人可复制的AI时代品牌可见性增长路径。
京东商品评论内容获取指南
京东商品评论API(jd.item.review)提供结构化评论数据,支持按ID批量获取、好评/差评筛选、图文视频过滤、分页排序及追评、商家回复等维度,JSON格式返回,免申请一键调用,适用于口碑分析与舆情监控。(239字)

数据智能体技术路线深度对比:本体神经网络 vs 预制指标平台
本文剖析数据智能体四大技术路径:RAG(简单但精度低)、NL2SQL(单表准、多表差)、预制指标(高维护成本、扩展性差)、本体神经网络(UINO首创,95%+准确率,维护成本线性增长)。推荐企业优先选择本体论路线,实现高精准、低成本、强扩展的AI原生问数。
OpenClaw:当 AI 开始 “做事”,我们该如何选择
OpenClaw是开源、本地优先的AI任务执行引擎,可听懂指令并自动完成文件处理、API调用等实操任务。支持本地/云端/混合部署,适配多类模型与交互入口(WebUI/CLI/IM),严守隐私与安全底线,兼顾可控性、成本与效率。(239字)

基于 Rokid 灵珠与 UXR 3.0 的 AR 智能卡路里识别系统实战
本项目为“AR智能卡路里计算器”,基于Rokid灵珠(AR Lite/Studio)与UXR 3.0 SDK开发。用户佩戴眼镜直视食物,系统通过空间计算实时识别并弹出热量数据,支持水果/正餐双模式切换。采用程序化3D建模、零美术资源依赖、多模态交互(键鼠→手柄→手势捏合),实现“空间即看即得”的沉浸式健康饮食辅助体验。(239字)
DLM在RAG中的最佳实践
ChatDLM是面向RAG的扩散语言模型,首创将Diffusion范式与MoE架构引入文本生成。通过区块扩散实现线性复杂度长文本处理,结合动态检索-生成协同、多文档深度合成与交互式可控生成,显著突破自回归模型在效率、一致性与可解释性上的瓶颈。
RAG 为什么总是“看起来能用,实际不好用”?
RAG效果不佳?问题往往不在模型,而在于文档切分。错误的切分会导致语义断裂、关键信息丢失,使召回内容“看似相关却无用”。本文深入剖析切分误区:固定长度切割、过度依赖overlap、忽视文档结构等,并提出核心原则——保障语义完整性。不同文档需定制切分策略,FAQ按问答切,技术文档依章节分,流程类保完整上下文。切分是RAG的地基,而非细节,唯有夯实,才能让检索与生成真正生效。
大数据与机器学习
大数据领域前沿技术分享与交流,这里不止有技术干货、学习心得、企业实践、社区活动,还有未来。