

AI 十大论文精讲(六):拆解 LLM 智能体的 “通用密码”
本文解读复旦NLP团队2023年重磅综述《The Rise and Potential of Large Language Model Based Agents》,系统剖析LLM智能体“大脑-感知-行动”三大核心模块,涵盖单智能体、多智能体、人机协作与智能体社群四大应用场景,提炼工具SKMA体系、安全护栏、结果检查三大落地要点,并提出AGI路径、虚拟到物理迁移等开放问题,为构建通用智能体提供统一范式,被誉为该领域“入门圣经”。
阿里云服务器多少钱一年?整理阿里云最新爆款服务器配置排行榜;2核4G/4核8G/8核16G、可选实例区别与选型指南参考
阿里云服务器多少钱一年?阿里云最新价格表CPU内存带宽系统盘,购买阿里云服务器多少钱一年?阿里云轻量应用服务器200M峰值带宽68元1年(秒杀38元),ECS云服务器2核2G3M带宽99元一年、2核4G、5M带宽、80G系统盘优惠价格199元一年,4核16G服务器10M带宽89元1个月,8核32G服务器10M固定带宽160元一个月,阿里云香港轻量服务器200M带宽25元个月起。

Delta Join:为超大规模流处理实现计算与历史数据解耦
Delta Join(FLIP-486)是Flink流式Join的范式革新,通过将历史数据存储与计算解耦,实现按需查询外部存储(如Fluss、Paimon),避免状态无限增长。它解决了传统Join在高基数场景下的状态爆炸问题,显著降低资源消耗:状态减少50TB,成本降10倍,Checkpoint从小时级缩短至秒级,恢复速度提升87%。兼容标准SQL,自动优化转换,适用于海量数据实时关联场景,推动流处理迈向高效、稳定、可扩展的新阶段。
【赵渝强老师】大数据日志采集引擎Flume
Apache Flume 是一个分布式、可靠的数据采集系统,支持从多种数据源收集日志信息,并传输至指定目的地。其核心架构由Source、Channel、Sink三组件构成,通过Event封装数据,保障高效与可靠传输。
亚马逊商品列表API秘籍!轻松获取商品列表数据
亚马逊商品列表API(SP-API)提供标准化接口,支持通过关键词、分类、价格等条件搜索商品,获取ASIN、价格、销量等信息。采用OAuth 2.0认证与AWS签名,保障安全。数据以JSON格式传输,便于开发者批量获取与分析。
LlamaIndex检索调优实战:分块、HyDE、压缩等8个提效方法快速改善答案质量
本文总结提升RAG检索质量的八大实用技巧:语义分块、混合检索、重排序、HyDE查询生成、上下文压缩、元数据过滤、自适应k值等,结合LlamaIndex实践,有效解决幻觉、上下文错位等问题,显著提升准确率与可引用性。

AI智能体框架怎么选?7个主流工具详细对比解析
大语言模型需借助AI智能体实现“理解”到“行动”的跨越。本文解析主流智能体框架,从RelevanceAI、smolagents到LangGraph,涵盖技术门槛、任务复杂度、社区生态等选型关键因素,助你根据项目需求选择最合适的开发工具,构建高效、可扩展的智能系统。

Flink基于Paimon的实时湖仓解决方案的演进
本文源自Apache CommunityOverCode Asia 2025,阿里云专家苏轩楠分享Flink与Paimon构建实时湖仓的演进实践。深度解析Variant数据类型、Lookup Join优化等关键技术,提升半结构化数据处理效率与系统可扩展性,推动实时湖仓在生产环境的高效落地。
Dify部署全栈指南:AI从Ubuntu配置到HTTPS自动化的10倍秘籍
本文档介绍如何部署Dify后端服务及前端界面,涵盖系统环境要求、依赖安装、代码拉取、环境变量配置、服务启动、数据库管理及常见问题解决方案,适用于开发与生产环境部署。
小红书笔记评论API数据解析(附代码)
本资源介绍如何通过小红书官方API获取笔记评论数据,包含评论内容、用户信息、点赞数等关键字段。支持分页请求,适用于舆情分析、用户研究及市场调研。提供完整Python调用示例,涵盖请求签名、响应解析等核心流程,助力高效获取结构化评论数据。

RAG系统文本检索优化:Cross-Encoder与Bi-Encoder架构技术对比与选择指南
本文将深入分析这两种编码架构的技术原理、数学基础、实现流程以及各自的优势与局限性,并探讨混合架构的应用策略。

Dots.ocr:告别复杂多模块架构,1.7B参数单一模型统一处理所有OCR任务22
Dots.ocr 是一款仅1.7B参数的视觉语言模型,正在重塑文档处理技术。它将布局检测、文本识别、阅读顺序理解和数学公式解析等任务统一于单一架构,突破传统OCR多模块流水线的限制。在多项基准测试中,其表现超越大参数模型,展现出“小而精”的实用价值,标志着OCR技术向高效、统一、灵活方向演进。
Java 大视界 -- Java 大数据机器学习模型在生物信息学基因功能预测中的优化与应用(223)
本文探讨了Java大数据与机器学习模型在生物信息学中基因功能预测的优化与应用。通过高效的数据处理能力和智能算法,提升基因功能预测的准确性与效率,助力医学与农业发展。
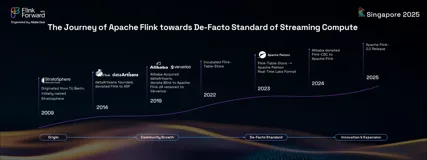
Apache Flink:从实时数据分析到实时AI
Apache Flink 是实时数据处理领域的核心技术,历经十年发展,已从学术项目成长为实时计算的事实标准。它在现代数据架构中发挥着关键作用,支持实时数据分析、湖仓集成及实时 AI 应用。随着 Flink 2.0 的发布,其在流式湖仓、AI 驱动决策等方面展现出强大潜力,正推动企业迈向智能化、实时化的新阶段。
训练效率提升100%!阿里云后训练全栈解决方案发布实录
阿里云大数据AI平台推出大模型后训练解决方案,通过全栈AI能力提供从算力到平台的一体化支撑,提升训练效率100%,适配多行业需求,打通大模型落地“最后一公里”。
Java 大视界 -- Java 大数据在智能家居能源消耗模式分析与节能策略制定中的应用(198)
简介:本文探讨Java大数据技术在智能家居能源消耗分析与节能策略中的应用。通过数据采集、存储与智能分析,构建能耗模型,挖掘用电模式,制定设备调度策略,实现节能目标。结合实际案例,展示Java大数据在智能家居节能中的关键作用。
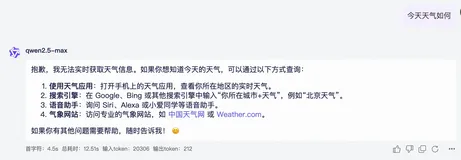
AI 搜索 MCP 最佳实践
本文介绍了如何通过 MCP 协议,快速调用阿里云 OpenSearch 、ElasticSearch 等工具,帮助企业快速集成工具链、降低开发复杂度、提升业务效率。
阿里云连续6年入选 Gartner®ABI 魔力象限报告,中国唯一!
近日,Gartner发布2025年《分析与商业智能平台魔力象限》报告,阿里云Quick BI第六年入选“挑战者”象限。报告肯定其在可视化、报表及自然语言查询(NLQ)方面的竞争力,并认可其融合AI与BI能力、推动数据分析民主化的创新成果。Quick BI已在零售、金融、制造等多个行业落地应用,助力企业实现高效数据驱动决策。
深入研究:shopee商品详情API接口Python攻略
Shopee 商品详情 API 是用于获取 Shopee 平台商品详细信息的接口,支持开发者提取商品标题、价格、库存、描述和图片等多维度数据。该接口适用于电商数据分析、比价工具开发及商品监控等场景。请求方式为 GET,需提供 itemid(商品 ID)和 shopid(店铺 ID),返回格式为 JSON。部分功能可能需要 API 密钥或访问令牌认证。以马来西亚站点为例,URL 为 shopee.com.myapi/v4/item/get,不同国家站点域名可能有所不同。

Qwen3 全尺寸模型支持通过阿里云PAI-ModelGallery 一键部署
Qwen3 是 Qwen 系列最新一代的大语言模型,提供了一系列密集(Dense)和混合专家(MOE)模型。目前,PAI 已经支持 Qwen3 全系列模型一键部署,用户可以通过 PAI-Model Gallery 快速开箱!
2025年大模型就业:核心技术趋势、技能要求与职业发展全景解析
随着大语言模型(Large Language Models, LLMs)的技术飞速迭代,人工智能领域正经历从通用对话工具向高度智能化、任务导向的智能体(Agent)系统的深刻转型。到2025年4月,企业对掌握LLM相关技术的专业人才需求持续高涨,核心能力聚焦于检索增强生成(RAG)、智能体任务自动化、模型对齐优化以及多模态融合。本文将全面剖析2025年大模型就业市场的技术演进路径、核心技能要求、行业应用场景、推荐实践项目以及职业发展建议,旨在为从业者提供详尽的职业规划指南,帮助其精准把握行业机遇。
PyTorch CUDA内存管理优化:深度理解GPU资源分配与缓存机制
本文深入探讨了PyTorch中GPU内存管理的核心机制,特别是CUDA缓存分配器的作用与优化策略。文章分析了常见的“CUDA out of memory”问题及其成因,并通过实际案例(如Llama 1B模型训练)展示了内存分配模式。PyTorch的缓存分配器通过内存池化、延迟释放和碎片化优化等技术,显著提升了内存使用效率,减少了系统调用开销。此外,文章还介绍了高级优化方法,包括混合精度训练、梯度检查点技术及自定义内存分配器配置。这些策略有助于开发者在有限硬件资源下实现更高性能的深度学习模型训练与推理。
Hologres实时湖仓能力入门实践
本文由武润雪(栩染)撰写,介绍Hologres 3.0版本作为一体化实时湖仓平台的升级特性。其核心能力包括湖仓存储一体、多模式计算一体、分析服务一体及Data+AI一体,极大提升数据开发效率。文章详细解析了两种湖仓架构:MaxCompute + Hologres实现离线实时一体化,以及Hologres + DLF + OSS构建开放湖仓架构,并深入探讨元数据抽象、权限互通等重点功能,同时提供具体使用说明与Demo演示。
Linux下搭建本地deepseek(附文档下载)
本文介绍了在Linux上搭建本地DeepSeek的步骤。主要涉及安装ollama、下载deepseek模型(1.5b参数版本)和配置ChatboxAI客户端。通过命令行安装ollama后,使用`ollama run deepseek-r1:1.5b`下载模型,并配置环境变量以确保服务正常运行。最后,通过ChatboxAI与模型进行交互。整个过程适合初学者,服务器配置为4核CPU和8GB内存,无GPU,响应速度稍有延迟但可接受。相关资源链接已提供。

DeepSeek 背后的技术:GRPO,基于群组采样的高效大语言模型强化学习训练方法详解
强化学习(RL)是提升大型语言模型(LLM)推理能力的重要手段,尤其在复杂推理任务中表现突出。DeepSeek团队通过群组相对策略优化(GRPO)方法,在DeepSeek-Math和DeepSeek-R1模型中取得了突破性成果,显著增强了数学推理和问题解决能力。GRPO无需价值网络,采用群组采样和相对优势估计,有效解决了传统RL应用于语言模型时的挑战,提升了训练效率和稳定性。实际应用中,DeepSeek-Math和DeepSeek-R1分别在数学推理和复杂推理任务中展现了卓越性能。未来研究将聚焦于改进优势估计、自适应超参数调整及理论分析,进一步拓展语言模型的能力边界。
ollama+openwebui本地部署deepseek 7b
Ollama是一个开源平台,用于本地部署和管理大型语言模型(LLMs),简化了模型的训练、部署与监控过程,并支持多种机器学习框架。用户可以通过简单的命令行操作完成模型的安装与运行,如下载指定模型并启动交互式会话。对于环境配置,Ollama提供了灵活的环境变量设置,以适应不同的服务器需求。结合Open WebUI,一个自托管且功能丰富的Web界面,用户可以更便捷地管理和使用这些大模型,即使在完全离线的环境中也能顺利操作。此外,通过配置特定环境变量,解决了国内访问限制的问题,例如使用镜像站来替代无法直接访问的服务。

人工智能的三大主义--——行为主义(actionism),连接主义 (connectionism)
这段内容涵盖了人工智能领域的重要概念和历史节点。首先介绍了布鲁克斯的六足行走机器人及Spot机器狗,被视为新一代“控制论动物”。接着解释了感知机作为最简单的人工神经网络,通过特征向量进行二分类。1974年,沃伯斯提出误差反向传播(BP)算法,利用梯度调整权重以优化模型。最后,阐述了符号主义、连接主义和行为主义三大学派的发展与融合,强调它们在持续学习中共同推动人工智能的进步。

Coconut:基于连续潜在空间推理,提升大语言模型推理能力的新方法
Coconut提出了一种新的大语言模型推理范式,通过在潜在空间中运算,利用隐藏层生成的连续思维状态取代传统文本推理。该方法采用广度优先搜索探索多条路径,避免单一路径局限,显著提升逻辑任务性能并减少token消耗。 Coconut结合“语言模式”和“潜在模式”动态切换,通过多阶段课程学习优化推理能力,在复杂规划任务中表现卓越,尤其在GSM8k和ProsQA等任务中优于传统模型。实验表明,Coconut能有效捕获中间变量,减少幻觉错误,具备更强的推理规划能力。
AI for Network Ops
网络运维工作涵盖从规划设计到日常维护的多个方面,随着网络规模扩大,人工运维难以应对。自动化运维系统应运而生,通过批量配置变更和监控工具提升效率。大模型(LLM)具备推理、学习和泛化能力,可作为网工的智能助手,优化故障定位等任务。团队通过多轮信息摘要和微调模型,实现了高效准确的故障定位,单个故障定位耗时小于1.5分钟,准确率超过80%。未来,大模型还将应用于智能答疑机器人和意图驱动网络等领域,全面提升网络运维效率。
CDP与Selenium相结合——玩转网页端自动化数据采集/爬取程序
本文介绍了Selenium、Chrome DevTools及Chrome DevTools Protocol (CDP) 的基本功能与应用。Selenium是一款开源自动化测试工具,适用于网页端应用程序测试和数据采集,具备跨平台特性。Chrome DevTools内置浏览器中,提供调试、分析Web应用程序的功能,包括元素、控制台、源代码和网络选项卡等。CDP是一套用于与Chromium内核浏览器通信的API,支持自动化测试和性能分析。文中还展示了Selenium与CDP结合使用的示例,如捕获网络请求数据和打印网页内容,并推荐了相关书籍和资源以供深入学习。
阿里巴巴商品详情数据接口(alibaba.item_get) 丨阿里巴巴 API 实时接口指南
阿里巴巴商品详情数据接口(alibaba.item_get)允许商家通过API获取商品的详细信息,包括标题、描述、价格、销量、评价等。主要参数为商品ID(num_iid),支持多种返回数据格式,如json、xml等,便于开发者根据需求选择。使用前需注册并获得App Key与App Secret,注意遵守使用规范。
实时获取小红书详情 API 数据
小红书详情API数据获取指南:注册开发者账号,创建应用并申请接口权限,构建请求获取笔记详情,使用Python等语言处理响应数据。需遵守使用规则,注意调用频率和数据安全。
DataWorks:新一代 Data+AI 数据开发与数据治理平台演进
本文介绍了阿里云 DataWorks 在 DA 数智大会 2024 上的最新进展,包括新一代智能数据开发平台 DataWorks Data Studio、全新升级的 DataWorks Copilot 智能助手、数据资产治理、全面云原生转型以及更开放的开发者体验。这些更新旨在提升数据开发和治理的效率,助力企业实现数据价值最大化和智能化转型。

【10月更文挑战第1天】「Mac上学Python 1」入门篇1 - 安装Typora与Markdown编辑技巧
本篇将详细介绍如何在Mac系统上安装Typora这款简洁高效的Markdown编辑器,并学习Markdown常用语法。通过本篇,用户能够准备好记录学习笔记的工具,并掌握基本的文档编辑与排版技巧,为后续学习提供便利。
前端大模型入门:Transformer.js 和 Xenova-引领浏览器端的机器学习变革
除了调用API接口使用Transformer技术,你是否想过在浏览器中运行大模型?Xenova团队推出的Transformer.js,基于JavaScript,让开发者能在浏览器中本地加载和执行预训练模型,无需依赖服务器。该库利用WebAssembly和WebGPU技术,大幅提升性能,尤其适合隐私保护、离线应用和低延迟交互场景。无论是NLP任务还是实时文本生成,Transformer.js都提供了强大支持,成为构建浏览器AI应用的核心工具。
Text-to-SQL技术演进 - 阿里云OpenSearch-SQL在BIRD榜单夺冠方法剖析
本文介绍了Text-to-SQL的技术演进,并对OpenSearch-SQL方法进行剖析。
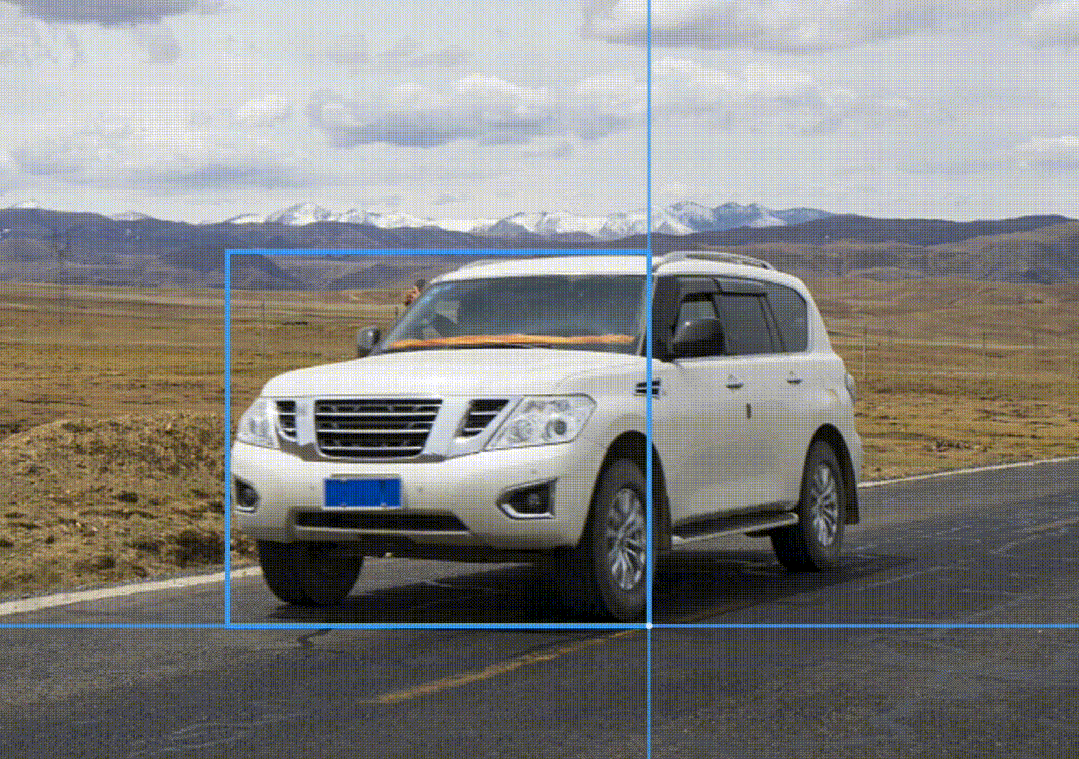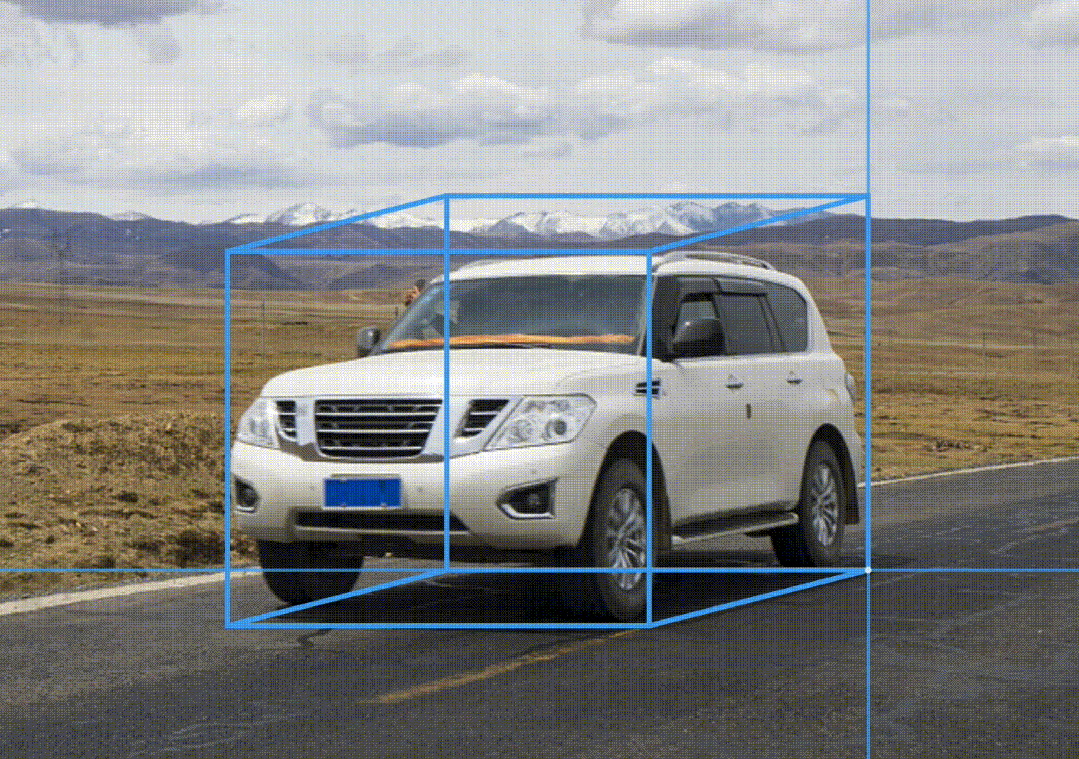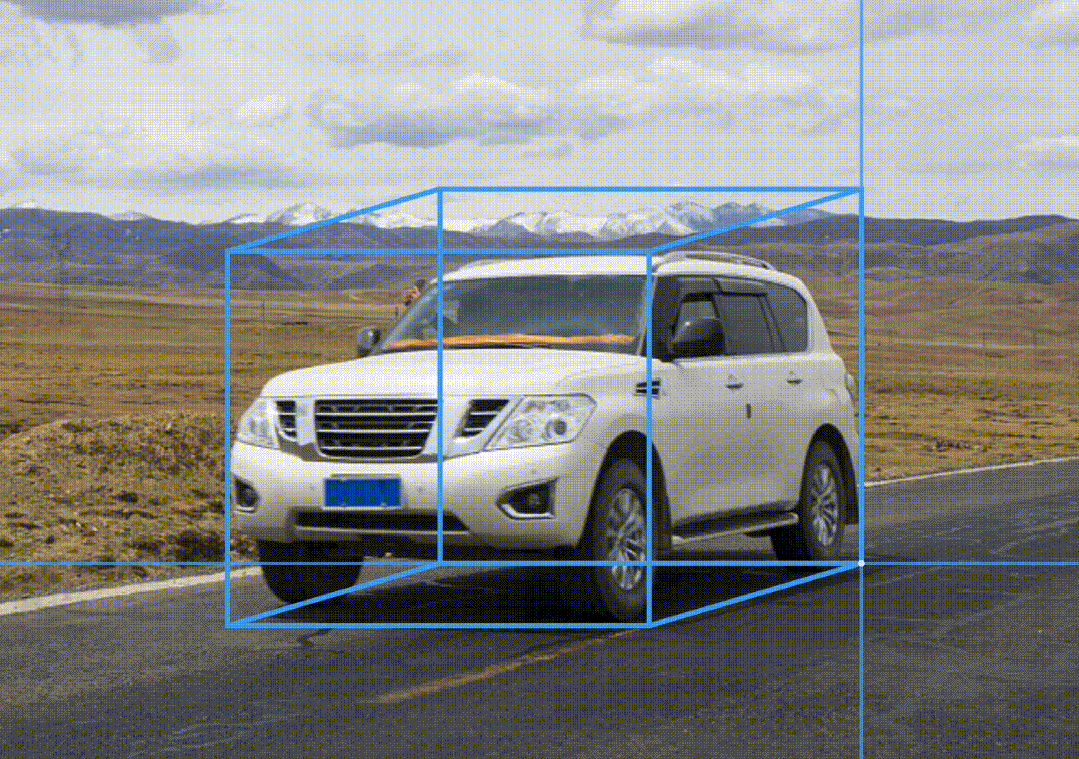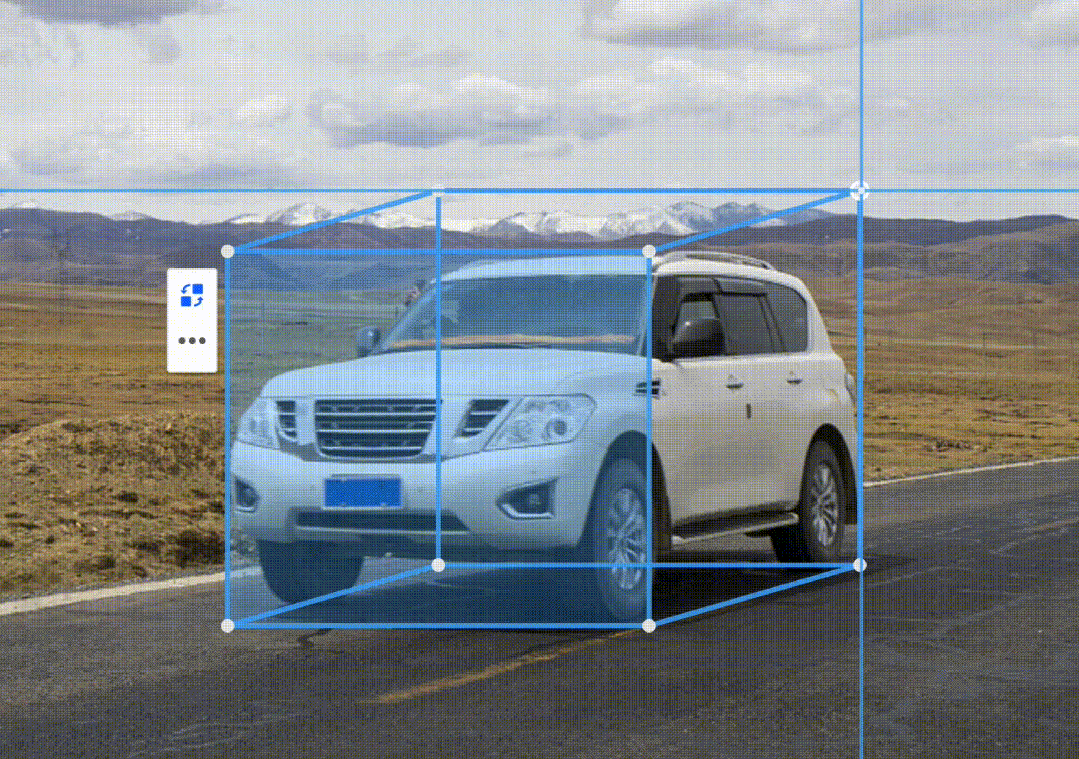
不是吧?这么好用的开源标注工具,竟然还有人不知道…
LabelU是一款专为AI项目设计的强大多模态数据标注工具,支持图像、视频、音频等多样化数据类型。它提供灵活的标注工具与自定义配置选项,让用户根据需求定制高效标注流程。特色功能包括一键载入预标注结果以简化修正工作,以及支持JSON、COCO等多种格式的导出选项。LabelU既可本地部署确保数据安全,也提供在线版本方便快速上手。此外,OpenDataLab还开源了Label-LLM对话标注工具和MinerU文档处理工具,进一步丰富了数据准备的工作流。欢迎访问[LabelU](https://github.com/opendatalab/labelU)了解更多详情,并为这些优秀工具点赞支持!
动手实践:高效构建企业级AI搜索
本文介绍了基于阿里云 Elasticsearch的AI搜索产品能力、业务价值、场景应用,以及搭建演示等。
使用Selenium调试Edge浏览器的常见问题与解决方案
在互联网数据采集领域,Selenium常用于自动化网页爬取。针对使用Edge浏览器时遇到的启动远程调试失败、访问受限及代理IP设置等问题,本文提供了解决方案。通过特定命令启动Edge的远程调试模式,并利用Python脚本配合Selenium库,可实现代理IP、User-Agent的设定及Cookie管理等高级功能,有效提升爬虫稳定性和隐蔽性。遵循步骤配置后,即可顺畅执行自动化测试任务。
《经典图论算法》迪杰斯特拉算法(Dijkstra)
这个是求最短路径的迪杰斯特拉算法,另外我还写了50多种《经典图论算法》,每种都使用C++和Java两种语言实现,熟练掌握之后无论是参加蓝桥杯,信奥赛,还是其他比赛,或者是面试,都能轻松应对。
Python实现循环神经网络RNN-LSTM回归模型项目实战(股票价格预测)
Python实现循环神经网络RNN-LSTM回归模型项目实战(股票价格预测)
大数据与机器学习
大数据领域前沿技术分享与交流,这里不止有技术干货、学习心得、企业实践、社区活动,还有未来。