









从RAG检索链路看GEO:企业如何构建一套可被大模型理解的可信信息体系
本文剖析GEO(生成式引擎优化)本质,指出其并非简单“批量发稿”,而是面向大模型的信息工程:需构建结构化企业知识库、打造机器可理解的官网、分层建设可信信源,并建立覆盖发现—理解—引用—推荐—稳定—业务结果的六维监测闭环。
四大AI引擎引用偏好实测:招聘行业内容分发平台选择与信息块构建指南
本文基于2026年初对豆包、DeepSeek、Kimi、秘塔四大AI引擎的引用来源实测,揭示招聘行业内容建设新路径:针对各引擎偏好差异(如豆包重CSDN/头条,秘塔偏垂直长尾),定制平台专属内容公式,并构建可直接引用的数据化信息块。提供90天可落地执行框架,助力中小机构提升AI搜索可见度。
大模型企业本地化部署与数据安全实践:提示词版本管理与质量回归
企业把大模型部署到本地后,常见的问题并不只在模型和算力:一次看似简单的提示词改动,也可能让回答变长、引用缺失、格式失控,甚至影响既有业务流程。本文从提示词版本、测试集、灰度发布和回滚机制出发,说明如何建立可追溯、可验证的大模型应用发布流程。
EMR Serverless Daft 如何简化多模态数据处理:视频抽帧、清洗、标注全流程与具身智能实践
阿里云 EMR Serverless Spark 引入 Ray 分布式计算框架与 Daft 高性能数据引擎,为用户提供了一套开箱即用、免运维且极致高效的多模态数据处理基础设施。
大模型长文本处理实践:基于分段提取与结果合并生成结构化摘要
本文提出一种高效、稳定的长文本处理方案:通过智能分段(支持句子级切分与上下文重叠)、并行结构化提取(JSON格式事实抽取)、多级去重(精确匹配+语义相似度)、冲突识别与溯源校验,最终生成可追溯、低成本、高可控的摘要。适用于录音转写、会议纪要等场景,显著提升准确性与可解释性。(
淘宝商品详情 API 实战全解:项目落地、接口详解、踩坑血泪总结
本文总结淘宝商品数据采集三大方式:官方TOP接口(合规但限流严)、第三方封装接口(字段全、接入易)及网页爬虫(高风险、不可商用)。结合实战经验,剖析签名失败、SKU嵌套、脏数据过滤等高频坑点,助力高效合规开发。(239字)

代理地址≠协议!HTTPS使用误区拆解
跨境运营、爬虫从业者必看!99%人混淆的代理误区:代理地址带https≠HTTPS代理。关键看目标网站协议!目标为HTTPS时,即使代理是http,仍为HTTPS代理。掌握核心:目标URL决定代理类型,代理前缀仅影响传输加密。三步避坑指南,提升效率与隐私安全。
3 个真实 GEO 成功案例 + 3 步关键词排名秘籍!开发者 / 企业快速落地 GEO,流量 & 转化双提升
本文聚焦 GEO 真实获客案例与实操技巧,通过教培机构、工业设备商、小众茶叶品牌三个实测案例,展现 GEO 落地成效:教培机构靠升学数据咨询量暴增 210%,工业设备商盯准技术痛点让单笔订单翻 5 倍,茶叶品牌借产地溯源实现客单价从 200 元飙至 500 元。核心分享三步零门槛关键词法:列客户痛点、加场景限定、数据筛词,还拆解了不同平台关键词偏好。提醒效果需 1-3 个月积累,内容需真实且持续优化。新手可直接对照案例思路,结合自身行业调整,快速抢占搜索流量,精准获客。
Flink on Kubernetes 部署架构:一个 Deployment 与一群 Pod
本文深入解析Flink 2.3在Kubernetes上的部署架构,聚焦“对象所有权”这一核心逻辑:JobManager为Deployment,TaskManager由其动态创建的裸Pod组成,HA ConfigMap则刻意不设ownerReference以持久化元数据。厘清Standalone、Native与Operator三种模式的责任边界,并详解资源生命周期、扩缩容机制、配置注入及高频排障要点。
Python 的 0.1 + 0.2 为什么不等于 0.3?拆开 IEEE 754 与那串死循环小数
list 能装下任何类型,是因为它存的是 PyObject* 指针数组:类型信息挂在对象自己头上。代价是每元素 8 字节指针加完整对象头——实测 100 万个整数,list 总内存约 34.3MB,是 array 的 9 倍。本文用 sys.getsizeof 一格格量给你看,并给出什么时候该换 array/numpy 的判断标准
如何监控品牌在不同 AI 平台的提及率变化?8 个平台 26 天回答记录的 SQL 统计方法
监控品牌在 AI 回答里的提及率变化,先要确认题目产出名单,再按周汇总。用 39 道题在 8 个国内 AI 平台连续 26 天的 8,026 条回答,演示用 SQLite 建表,算出名单率和联网率,用 Jaccard 量隔天波动,按天、按周对比同一品牌的提及率。附建表脚本和三段 SQL。
AI办公的暗战:2026年主流生产力工具能力对比,谁能真正省下时间?
2026年AI办公工具爆发,但“省时间”效果因任务而异。本文聚焦五类典型办公场景(通用问答、数据分析、文档PPT、编程、项目协作),以任务完成度、人工介入度、成果可用性为标尺,揭示AI真正节省的是哪层时间——从浅层打字排版,到深层决策验证。
亿级向量检索月费最高省约76%!阿里云 Milvus EAGLE 磁盘索引对比实测
阿里云Milvus EAGLE内核采用磁盘索引优化,1亿向量仅需单机32CU容量型实例(6752元/月),Laion 100M测试中每万元月成本达2183 QPS,为竞品的3.4~34倍,且召回率98.56%更高,兼顾高性能与低成本。
EMR Serverless StarRocks 湖仓多模态检索:One SQL on One Data,实现全文 + 标量 + 向量三路混合检索
阿里云EMR Serverless StarRocks实现全文、标量、向量三路原生融合检索,支持在Paimon/Iceberg/Lance等开放湖格式上通过一条SQL完成关键词匹配、条件过滤与语义相似联合召回,并内置RRF重排、In-Filter深度优化及列级回写能力,显著提升召回率与执行效率;相比传统多系统架构,成本降低60%,数据全程不出湖,适用于自动驾驶Corner Case挖掘、RAG增强、电商搜索等多模态场景。
0.8MB 跑通 Qwen|第 17-1 篇:safetensors → VQF——推理引擎的 vqf_write 一次成型
本系列《0.8MB跑通Qwen》聚焦ARM端零依赖纯C推理引擎,适配Qwen3-VL多模态模型(2B/8B/30B),在RK3588平台实测通过。核心突破:safetensors→VQF转换与推理共用同一量化路径,实现位级可复现,体积压缩至2.2–4.2GB,真机重转SHA256完全一致。(239字)
单机万级并发:利用Python asyncio与aiohttp打造极致性能的异步爬虫
文章介绍了使用asyncio和aiohttp实现高并发新闻数据采集的方法。它指出了传统多线程的局限性,并强调了异步编程的优势。文章还讨论了环境配置和关键参数设置,并提供了一个实现示例。
别只盯着HTML了!教你高效抓取并解析PDF/Excel隐藏附件?
本文聚焦网页附件(PDF/Excel)爬取痛点,系统讲解隐藏链接识别、二进制文件下载、pdfplumber/pandas精准解析及代理IP轮换反爬策略,并附完整实战代码,助你高效获取高价值结构化数据。(239字)
阿里云PAI-EAS共享GPU,一卡部署多个模型(EasyRec/TorchEasyRec Processor)
本文介绍在阿里云PAI-EAS平台单GPU卡(如A10/gu30/L20)上部署多个模型实例的实践方案:需购买GPU专有资源组,通过显存划分(如24G卡分3×7G)、配置`gpu_memory`参数实现共享,禁用`gpu_core_percentage`防RT毛刺,并合理设置BatchCount提升吞吐。
B2B- 1688 商品详情 API 接口全解析调用
1688商品详情API(alibaba.item.get)是获取批发商品结构化数据的官方接口,涵盖商品基础信息、SKU、供应商、价格、起批量等核心字段。本文详解接口调用前提、签名规则、Python实战代码、限流处理及高频异常解决方案,助开发者快速落地批量选品、价格监控等场景。(239字)
数仓入门篇-维度模型与第三范式
第三范式(3NF)是关系数据库规范化核心标准,要求消除传递依赖,确保数据无冗余、“一事一地”。维度模型则面向分析优化,采用星型结构与反规范化设计,以牺牲存储换查询性能与业务可读性。二者各适其用:3NF用于OLTP系统保一致性,维度模型用于OLAP场景提分析效率。(239字)
给AI模型“加外挂”:LoRA技术详解,让小白也能定制自己的大模型
LoRA是一种高效轻量的大模型微调技术,如同为万能咖啡机加装“智能香料盒”——不改动原模型(冻结参数),仅训练少量低秩矩阵(参数量降千倍),显著降低成本、保留通用能力,并支持插件式灵活部署。现已成为AI定制化普惠落地的核心方案。(239字)
美股(纳斯达克/纽交所)数据 API 对接实战(含实时行情与 IPO 功能)
本文介绍如何通过StockTV API快速对接美股数据,支持纳斯达克、纽交所实时行情、IPO日历、K线图及公司基本面信息。仅需配置`countryId=5`,即可高效集成专业级金融数据,适用于量化交易与行情应用开发。
询盘跟进分档实务:等决定、只问价、没回音三档跟进法
外贸客户聊过后没回复怎么跟进?先看对方停在哪一步,分等决定、只问价、没回音三档再排跟进;每档给一个具体的跟进动作与间隔,AI 只出跟进草稿、人工确认后才发。
用阿里云跑通一部 闽南语竖屏短剧《等你平安归来》:台青廖昌威从剧本 JSON 到成片管线的落地 SOP
本文以闽南语竖屏短剧《等你平安归来》为真实案例,详解如何基于阿里云FC、百炼、OSS与ComfyUI构建可复用的AIGC短剧工程化管线,聚焦剧本结构化、角色一致性、方言TTS精准合成、GPU成本治理及资产版本管理五大落地关键点。(239字)
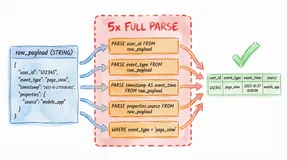
EMR Serverless Spark 推出 Spark 4.0,加速湖仓架构下的数据处理升级
Spark 4.0 通过引入 VARIANT 半结构化数据类型、原生 SQL UDF 和增强的 PySpark 生态,显著提升了湖仓一体架构下的查询性能、SQL 表达能力与 Python 工程效率;阿里云 EMR Serverless Spark 已全面支持该版本,企业可开箱即用这些能力,无需运维集群或处理兼容性问题,加速数据处理升级。
面向大模型 RAG 的企业知识库工程化:Schema、信源与效果监测
本文提出面向大模型RAG的企业知识库工程化五层架构(GEO):L1 Schema结构化锚定实体,L2场景化FAQ提升召回,L3四级信源加权增强采信,L4全域信息一致性治理,L5可量化效果监测。聚焦“让大模型准确识别、优先采信、交叉验证”,提供可落地的技术方案与配置示例。(239字)
GEO文章发布后为什么仍可能失效?
GEO文章发布后失效,常因内容无法长期存活。本文提出“六层验证模型”:Survive(存活)→Retrieve→Read→Use→Cite→Recommend,强调内容须先稳定公开、可访问、可验证,方能成为AI可信信源。官网为原始事实源,第三方平台仅作传播放大器。(239字)
2026年顶会异常检测突破盘点
2026年CVPR/ECCV四大顶会工作聚焦工业异常检测痛点:新品换线快、缺陷样本少、边缘算力弱。SubspaceAD(免训练)、VisualAD(纯视觉)、ArcAD(3%异常样本)、LiZAD(20ms/1.01GB)共同引领“极简、轻量、免训”低代码新范式,助力产线快速落地。
2026 GEO实战指南:让AI搜索引擎正确引用你的技术文章
GEO(生成式引擎优化)是面向LLM检索-推理-生成链路的信息组织工程,聚焦语义分块、结构化数据(Schema)、引用可信度与实体关系构建,提升内容在AI搜索引擎中的召回率与引用率,非SEO替代品,而是机器可读性的新基础设施。
Java 基础数据类型完全指南
本文详解Java 8种基本数据类型(byte/short/int/long/float/double/char/boolean)的取值范围、默认值、使用场景及注意事项,涵盖字面量规范、自动/强制类型转换、包装类与装箱拆箱机制,并强调金额计算须用BigDecimal、内存优化等最佳实践。

哪些政策要求企业开展漏洞扫描?
在网络安全法等法规要求下,企业须定期开展漏洞扫描。具备CNAS/CMA/CCRC资质的第三方机构,依据GB/T 30279、34943等标准,通过专业工具对网络、系统、应用及容器镜像等进行全面扫描,出具权威《漏洞扫描报告》,助力企业合规整改、筑牢安全防线。(239字)
Flink SQL 之 Table API 原理及代码实现:从表达式体系到内部执行流程与实战最佳实践
本文深入解析Flink Table API——SQL的类型安全替代方案。涵盖本质定义、八大操作分类、六步执行流程、Expression表达式体系,并通过完整代码演示其优势:编译期校验、IDE友好、动态构建能力强。附六大坑点与八条最佳实践,助Java团队高效开发。
Flink Time 之乱序问题处理深度剖析:从产生原因到五种方案与生产实战
本文深入剖析Flink乱序问题:定义本质、六大成因、对窗口计算的三大影响,并系统讲解五种处理方案(有界乱序WM、allowedLateness、侧输出、自定义WM、Source排序),结合监控方法、选型决策树、三大实战案例及六大高频坑,助你一次搞懂乱序处理。
EMR Daft × Qoder:一句话生成并运行智驾数据处理 Pipeline
本文介绍了阿里云EMR Daft与Qoder协同实现智驾数据处理Pipeline的一站式解决方案,通过自然语言描述需求即可自动生成并运行分布式多模态作业,覆盖OSS视频读取、场景切分、关键帧提取、多维度标签生成、Embedding计算及结果写入Paimon数据湖的完整链路,显著降低工程复杂度,提升数据资产构建效率。
3个信号判断内容是否被AI引用:来自知乎问答的实测观察
本文基于8周实测,揭示AI引擎引用知乎内容的3大信号:1)内容结构需具备“可提取性”,结论须前置;2)社区验证信号(赞同/收藏比、多元评论)影响可信度判定;3)持续更新显著提升引用权重。小账号亦可通过结构优化提升AI可见度。
更快、更稳、更省:揭秘阿里云 Elasticsearch 存算分离与弹性扩缩
从存算一体到存算分离,Elasticsearch 如何做到变更更快、迁移更稳、资源更省?本文解析阿里云 Elasticsearch 的存算分离与弹性架构,并以一个综合成本下降约 35% 的真实客户案例拆解计算、存储与弹性三重降本。 关键词: 存算分离、热点预热、智能多级缓存、弹性扩缩、三重降本
阿里云 EMR Serverless StarRocks(Stella 2.2.0)发布:多模态处理与分析闭环,内表与湖表统一检索
Stella 2.2 面向 AI 时代的数据基础设施,打通“多模态数据处理—向量化与理解—多路检索—分析消费”的完整闭环。无论数据沉淀在 Paimon 湖表,还是 StarRocks 存算分离内表,都可以在统一 SQL 入口下组合结构化分析、全文检索、向量检索与 AI Function,服务智能驾驶、具身智能、内容与商品理解、企业知识库和 RAG 等场景。
Markdown是什么?——AI时代最值得掌握的文档语言
在AI处理信息成为常态的今天,文档格式的竞争已从“人类看着美”转向“机器读着快”。Markdown凭借极致的Token效率、清晰的语义结构和与AI训练数据的高度契合,成为连接人与大模型的“默认语言”。本文用最简洁的方式解释:为什么Markdown既是AI的“母语”,也是你与AI高效协作的必备工具。
语雀如何导出别人的知识库!超实用教程!支持导出markdown/html/word/pdf等超多格式!一键解析,批量下载!保留大纲的层级结构!一键克隆!原格式
语雀重度用户亲测推荐:「语雀文档批量下载克隆助手」浏览器插件。一键备份知识库、小记、表格、白板等全类型内容,完美保留目录结构与图片附件;支持导出MD/HTML/Word/PDF,并可克隆公开库至个人账号。100%本地运行,不传数据、无需Token或超级会员,安全可靠。(239字)
Vue高效学习指南:从入门到实战的科学路径
本文系统梳理Vue学习路径:从入门筑基、核心深化到项目实战与生态拓展,结合实践方法与避坑指南,帮助初学者打破碎片化学习困境,科学构建知识体系,高效成长为能独立开发的Vue开发者。
DeepSeek 没做的功能,网友们都给它实现了
文章介绍了社区开发者围绕 DeepSeek 开源 AI 工作台 Harness 制作的各类插件与主题,包括复刻 QQ 2008 粉色皮肤的开源项目、基于官方扩展接口的配色主题、壁纸与透明度调节工具、输入框旁余额显示插件,以及将 RSS 资讯产品嵌入侧栏的案例,展示了 Harness 插件化与创造模式带来的可定制空间。
AI端到端提效工程落地新范式:从模型中心到系统效率的范式迁移
《AI端到端提效工程落地新范式》由AI专家肖加森撰写,提出以“意图定义—规格驱动—智能体编排—状态复用—闭环评估”为核心的全新工程范式,突破传统AI项目“模型强、落地难”瓶颈,推动AI从单点能力走向全链路可测、可控、可进化。
企业级 AI Agent 的安全防护实践:防止提示注入与数据泄露
AI Agent正重塑企业安全边界:其自主调用API、数据库、知识库等能力,在提升自动化效率的同时,也引入提示注入、工具滥用、记忆污染等新型风险。本文系统剖析十大威胁与防护策略,提出“模型管推理、系统管安全”的多层防御架构,涵盖输入检测、Prompt隔离、工具白名单、RAG权限治理及全链路审计,助力企业构建可信AI智能体。
基于阿里云 OpenSearch 行业算法版的海外电商智能搜索实践
本文档详述东南亚电商巨头GoTerra从自建Elasticsearch迁移至阿里云OpenSearch行业算法版的全链路实践,涵盖多语言语义理解、向量检索、低延迟优化(P99延迟降幅超70%)、弹性成本控制与安全加固,提供可复用的企业级智能搜索升级范式。
OpenClaw 接入百炼模型:密钥创建+配置+报错排查全攻略
本教程详解OpenClaw客户端接入阿里云百炼的完整流程:从账号准备、API Key创建与保存,到客户端密钥配置、模型选择及连通测试,图文并茂,步骤清晰。涵盖自检清单与高频问题排查,助你快速稳定调用Qwen等百炼大模型。(239字)
taocarts深度解析|反向海淘系统+淘宝/1688一键采,核心代码实战(附避坑指南)
在反向海淘风口下,反向海淘系统的核心竞争力在于“货源对接”与“流程自动化”,而淘宝/1688一键采则是提升代购效率的关键。taocarts作为聚焦反向海淘的代购系统,不仅实现了淘宝、1688的无缝对接,更解决了传统代购系统“商品采集混乱、库存不同步、订单卡顿”等痛点,今天就深度解析taocarts的反向海淘系统 + 淘宝/1688一键采核心功能,附上实战代码和避坑指南,助力开发者快速落地反向海淘独立站、1688代采平台。
AI质检+MES如何重构智能制造质量闭环
AI质检与MES深-度融合,构建“感知-分析-决策-执行”质量闭环:实现100%全检、自动拦截、一物一档、工艺自优化及缺-陷预-测;通过OPC UA/MQTT/边缘网关打通设备数据,支撑全流程精-准质量追溯。
不会选数据,别说你会AI:一份给新手的极简数据集实战手册
数据集是AI模型的“基石”,决定其性能上限。本文以通俗语言解析数据集的核心概念、获取途径、质量评估与实战步骤,手把手教你打造高质量数据,助力AI项目成功,堪称新手入门与实践的必备指南。
1688商品详情API接口使用指南
1688商品详情API(1688.item_get)是阿里1688开放平台核心接口,支持通过商品ID获取50+字段的全量信息,涵盖标题、价格、SKU、库存、图文、批发规则及商家资质等,适用于ERP同步、比价、跨境铺货等B2B场景。需实名认证并创建应用获取app_key与app_secret,接口仅返回JSON格式数据,是对接1688生态的关键技术通道。(239字)

大数据与机器学习
大数据领域前沿技术分享与交流,这里不止有技术干货、学习心得、企业实践、社区活动,还有未来。

