ChatPPT+魔搭社区:MCP 2.0全面升级!
ChatPPT MCP2.0正式发布,联合魔搭ModelScope推出云端智能体服务,支持生成、编辑、演讲、动画等全链路功能,开放Streamable HTTP协议与本地Stdio双模式,已接入20+平台,服务300+开发者。

用Macbook微调Qwen3!手把手教你用微调给Qwen起一个新名字
本文介绍如何在MacBook上使用苹果MLX框架高效微调Qwen3大模型。借助MLX的高性能计算与统一内存架构,仅需2分钟即可完成训练,内存占用低至2GB,推理速度达400 Token/s,并支持快速部署为本地API服务,展现Mac轻薄本的强大AI生产力潜力。
AR数字孪生如何重构工业巡检:从被动维修到预测性维护的实战指南
在工业4.0与智能制造深度融合的背景下,传统工业巡检模式正面临严峻挑战。依赖纸质记录、人工经验判断以及“故障后维修”的被动模式,不仅效率低下,且难以应对日益复杂的设备系统。随着增强现实(AR)与数字孪生技术的成熟,一种基于实时数据驱动、虚实融合的新型运维体系正在形成。本文将深入探讨基于云端的AR数字孪生解决方案架构,解析其如何通过可视化监控、智能巡检及远程协作,实现从被动响应向预测性维护的根本性转变。

Claude Code 实战:Agent Skills
面向已用 Claude Code 写代码的开发者,讲清 Skills 三层结构与完整实操路径,帮你把重复工作流封装成可复用、可 Review 的技能包。

五分钟配好向日葵 MCP,让 AI 替你远程安装 OpenClaw!
本文详解向日葵MCP的实战配置与应用:将远程控制能力接入AI,实现“一句话操作另一台电脑”。支持截图查看桌面、自动打开浏览器搜索、远程执行命令等,无需写脚本,配置简单,即刻上手。
MiniCPM-o 4.5 CookBook:9B 参数玩转多模态全双工交互
MiniCPM-o 4.5是9B参数多模态大模型,支持图像、视频、音频、文本输入与高质量文/语音输出。具备领先视觉理解(OpenCompass平均77.6分)、实时中英双语语音对话、全双工流式交互、高精度OCR及30+语言能力,适配CPU/GPU/国产芯片,支持本地部署与微调。(239字)

蚂蚁百灵全模态 Ming-flash-omni-2.0 开源!视觉百科+可控语音生成+全能型图像编辑,打破全模态“博而不精”
2月11日,蚂蚁百灵团队开源全模态大模型Ming-flash-omni-2.0(基于Ling-2.0 MoE架构),在视觉理解、语音交互与图像编辑三大领域实现代际跃迁,达开源领先水平。支持多模态统一生成与深度编辑,模型权重与代码已开放。
Linux 高效学习指南:从入门到运维的科学路径
本文介绍Linux运维学习的科学路径,主张“场景驱动”替代死记硬背。涵盖四大阶段:一周掌握核心命令,两周理解系统原理与故障排查,两周实战部署LNMP服务,长期进阶自动化运维。强调动手实操、问题驱动与循序渐进,提供各阶段目标、任务与资源推荐,助你高效构建完整知识体系,成为实战型运维人才。
Z-Image Turbo LoRA训练魔法:如何保持加速生图能力
ModelScope DiffSynth团队推出Z-Image-Turbo-DistillPatch,解决LoRA训练后丢失Turbo加速问题。支持8步高质量生成,兼容标准SFT流程,即插即用,无需重训。开源地址:modelscope.cn/models/DiffSynth-Studio/Z-Image-Turbo-DistillPatch
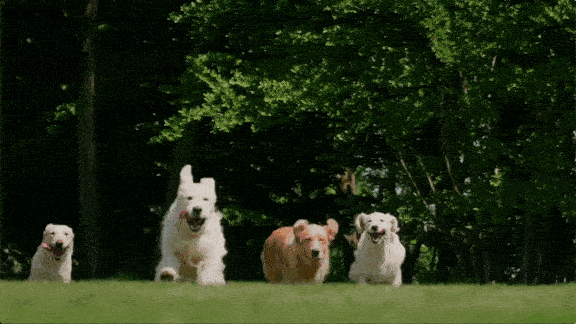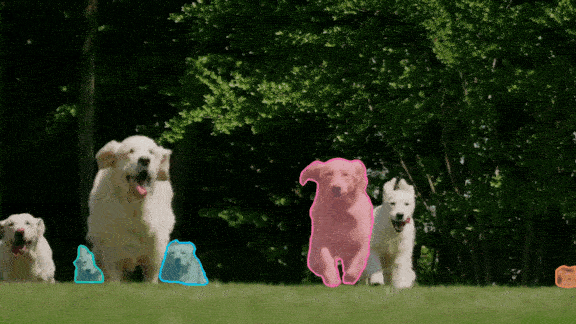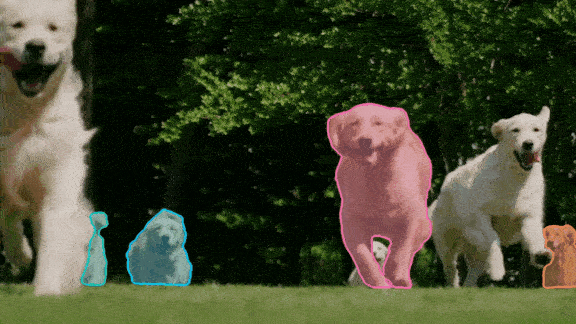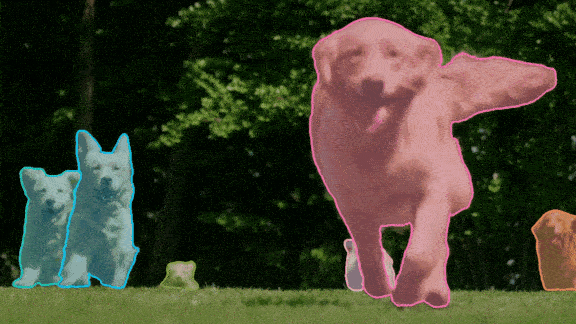
Meta SAM3开源:让图像分割,听懂你的话
Meta发布并开源SAM 3,首个支持文本或视觉提示的统一图像视频分割模型,可精准分割“红色条纹伞”等开放词汇概念,覆盖400万独特概念,性能达人类水平75%–80%,推动视觉分割新突破。
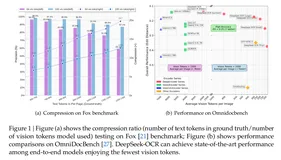
【Github热门项目】DeepSeek-OCR项目上线即突破7k+星!突破10倍无损压缩,重新定义文本-视觉信息处理
DeepSeek-OCR开源即获7k+星,首创“上下文光学压缩”技术,仅用100视觉token超越传统OCR模型256token性能,压缩比达10-20倍,精度仍超97%。30亿参数实现单卡日处理20万页,显著降低大模型长文本输入成本,重新定义高效文档理解新范式。
Thinking Machines Lab最新研究结果如何复现?On-Policy Distillation让训练成本直降10倍
Thinking Machines Lab提出On-Policy Distillation技术,让小模型高效继承大模型能力。相比传统强化学习,训练成本降低90%,效率提升十倍,支持本地部署、降低成本与延迟。结合vLLM加速与独立DeepSpeed配置,MS-SWIFT框架实现开箱即用的高效蒸馏训练,助力轻量模型具备“会思考、能纠错、可进化”的智能。
井云 DSH 三个 Modal 触发逻辑:升级/充值/卡密弹窗在客户端的完整流程
井云DSH客户端预设4个商业化Modal(登录、升级、充值、卡密激活),按需单层弹出,无缝协同。每个Modal直连SaaS后台,覆盖鉴权、支付、核销全链路,支持A/B测试与品牌定制,是转化关键触点。(239字)
编译通过 ≠ 能用:试试 UseIO,把前端验收还给 AI 自己
AI写代码只需3分钟,但人工验收常耗一整个下午。本文揭示瓶颈不在“生成”,而在“验收”——弹窗遮挡、点击无响应、接口500等前端顽疾,typecheck和单测均难覆盖。文章提出将验收拆解为视觉、交互、网络、控制台四层,让AI自主截屏分析、模拟点击、抓取请求、检查日志,实现闭环自验,真正释放开发者心流。(239字)
虚实共生:AR数字孪生如何重塑工业巡检新范式
随着工业4.0浪潮的深入,传统制造业正经历从“自动化”向“智能化”转型的关键阶段。在这一进程中,设备巡检作为保障生产安全与效率的核心环节,长期面临着数据孤岛、响应滞后、经验依赖性强等痛点。增强现实(AR)技术与数字孪生(Digital Twin)的深度融合,正在构建一种全新的“虚实共生”工业巡检范式。本文将深入探讨基于云边端协同架构的AR数字孪生系统在工业巡检中的技术实现、架构设计及最佳实践。
AI Agent开发平台的技术架构探索与功能设计
2026年,企业级AI Agent市场规模预计达449亿元,但仍有60%的企业停留在试点阶段——规模化落地的核心障碍并非模型能力,而是可观测性、管控粒度与层级治理的缺失。 本文从技术架构视角出发,对比分析了Dify、Coze、LangChain及主流云厂商平台在监控深度、管控粒度、编排耦合、层级抽象和声明式管理五个维度的共性不足。 在此基础上,我们提出并实践了一套七层递进式治理架构(工具库→Skill→工作流→Agent→编排→项目→安全策略),实现了六层穿透式监控能力——成本可从项目逐级下钻到单次工具调用,解决了“钱花在哪、谁花的、值不值”的核心问题。同时支持可视化拖拽与声明式YAML双

戴盟联合数十家头部机构,发布全球最大规模含触觉全模态物理世界数据集
4月15日,戴盟机器人发布全球最大含触觉全模态具身数据集Daimon-Infinity,年内规模将达数百万小时、近十亿条数据。首批10000小时高质量开源数据已上线魔搭社区,覆盖80+真实场景、2000+任务,显著提升模型训练效率10倍。

DeepSeek 双百万 token 窗口对话数据的量化对比分析
本文基于第一个百万 token 窗口(以下简称 窗口 1)与第二个百万 token 窗口(以下简称 窗口 2)的完整对话数据,采用量化对比的方法,系统揭示两套对话在轮次、文本长度、语种构成以及估算 token 消耗方面的显著差异。研究发现,尽管窗口 2 的轮次和总字数均低于窗口 1,但其每轮对话的文本密度与估算 token 消耗显著更高。结合窗口 2 在生成 5 篇深度分析文章过程中的实际经验,本文提出“长文本生成的隐性 token 消耗”假说,并引用近期相关研究提供理论支撑。该假说为理解大模型在真实工程环境中的行为提供了新视角,也为用户在设计跨窗口连续工程时的指标控制与迁移提供了可操作的参考
基于YOLO11的交通违规检测系统(Python源码+数据集+Pyside6界面)
本文基于YOLO11构建交通违规检测系统,涵盖23类目标(车辆、信号灯、标志等),详解数据制作(ROI裁剪优化尺度)、模型改进(C3k2、C2PSA、轻量Detect头)及训练可视化全过程,并集成PySide6实现GUI应用,助力工业落地。
C语言深度解析:内存对齐与结构体填充的底层逻辑
C语言中,内存对齐是CPU硬件强制要求的底层规则,直接影响结构体大小、访问性能与硬件兼容性。合理排列成员可减少填充、节省内存;滥用`#pragma pack`则易致崩溃或性能暴跌。嵌入式、网络协议与跨平台开发必备核心知识。(239字)
基于 AgentScope x AI Agent A2Z部署平台的生产级别Agent上线Live实战分享
本文分享如何用AgentScope框架+AI Agent A2Z平台,一键完成AI Agent生产级部署:解决“开发易、上线难”痛点,快速生成标准/chat接口(如https://agentscope.aiagenta2z.com/deep_research_agent/chat),支持高并发、实时监控与冷启动。
微调与推理:解锁大模型定制化能力的核心密钥
本文深入浅出讲解大模型微调与推理的核心原理与实践:微调(如LoRA)让通用模型适配垂直场景,推理则实现价值落地。以LLaMA为例,手把手演示数据准备、平台微调、在线测试与效果评估,零代码门槛,助初学者快速打造专属AI模型。(239字)
RAG 文档切分攻略:做好这步,检索精度提升 50%
本文深度解析RAG系统中易被忽视却至关重要的文档切分环节,系统拆解固定长度、语义结构化、混合切分三大方法,结合片段长度、重叠率、元数据标注等5大实操技巧与典型场景案例,助你避开常见陷阱,显著提升检索精度与大模型回答质量。
百度文心开源0.9B参数 PaddleOCR-VL-1.5,全球首个支持异形框定位的文档解析模型!
百度文心开源新一代文档解析模型PaddleOCR-VL-1.5:仅0.9B参数,在OmniDocBench v1.5达94.5%精度,全球首个支持异形框定位,精准识别倾斜、弯折、反光等“歪文档”,集成印章识别、多语种(含藏语/孟加拉语)及古籍解析能力,推理速度超MinerU2.5达43%。(239字)
工程师思维看透人心?这个“集成框架”可能颠覆了个人成长领域
《内生力量智慧集成系统》是一套专为技术人设计的“自我认知操作系统”,以系统工程思维重构个人成长:用“七力光谱”扫描内在配置,以“阻滞系数”“一致性指数”等指标动态诊断,支持从调优(1.0–2.0)到重构(3.0)、集成(4.0)乃至超越工具(5.0)的全周期演进。它不贴标签,只提供可测量、可干预、可迭代的元认知框架,助你在AI时代成为自身意识系统的架构师。(239字)
向量数据库优势和劣势 —— 全方位解析适用场景与使用边界
本文理性剖析向量数据库:突出其在非结构化数据检索、RAG支撑、毫秒相似匹配等AI场景的核心优势,也直面结构化处理弱、精度效率权衡、成本高、信息损失及生态不成熟等短板,明确适用场景(如智能客服、推荐、多模态检索)与四大使用边界,倡导按需选型、协同传统数据库,实现价值最大化。
你的错题本里藏着金矿,但你却只把它当成了回收站——用AI给大脑做一次深度Debug
把学习比作软件开发,错题就是Bug。大多数人只改答案(打补丁),却忽略了底层的逻辑漏洞。本文分享一套"错题分析AI指令",利用Root Cause Analysis(根因分析)思维,帮助你用AI深度Debug大脑,将每一个错误转化为认知的核心资产。
九坤量化开源IQuest-Coder-V1,代码大模型进入“流式”训练时代
2026年首日,九坤创始团队成立的至知创新研究院开源IQuest-Coder-V1系列代码大模型,涵盖7B至40B参数,支持128K上下文与GQA架构,提供Base、Instruct、Thinking及Loop版本。采用创新Code-Flow训练范式,模拟代码演化全过程,提升复杂任务推理能力,在SWE-Bench、LiveCodeBench等基准领先。全阶段checkpoint开放,支持本地部署与微调,助力研究与应用落地。

NeurlPS 2025!多伦多大学TIRE助力3D/4D 生成精准保留主体身份
TIRE提出“追踪-补全-重投影”三阶段方法,实现主体驱动的3D/4D生成。通过视频跟踪识别缺失区域,定制2D模型补全纹理,并重投影至3D空间,提升生成一致性与质量,推动动态场景生成新进展。
阶跃星辰发布首个开源 LLM 级音频编辑大模型 Step-Audio-EditX
阶跃星辰发布全球首个开源LLM级音频编辑大模型Step-Audio-EditX,支持零样本TTS、多语言方言及情感、风格、副语言特征精准控制,采用统一LLM框架,实现文本驱动音频创作。
AR眼镜隐私泄露危机:企业级安全方案全解析
随着增强现实(AR)技术在工业运维、远程协作及现场培训等领域的深入应用,AR智能穿戴设备已从概念验证走向规模化部署。然而,AR眼镜作为集成了高清摄像头、麦克风、空间传感器及实时音视频传输能力的“第一视角”数据采集终端,其引发的隐私泄露风险已成为企业数字化转型中的重大隐患。如何在保障业务效率的同时,构建端到端的企业级安全防护体系,是当前技术架构设计的核心挑战。
AR数字孪生:让工厂设备“开口说话”的维修革命
在工业4.0与智能制造深入发展的背景下,传统制造业正面临从“被动响应”向“主动预测”转型的关键节点。物理世界与数字世界的边界日益模糊,增强现实(AR)技术与数字孪生(Digital Twin)的深度融合,正在重构工业运维的逻辑。这种融合不仅实现了设备状态的可视化映射,更通过实时数据流与交互界面,赋予了静止的工业设备以“表达能力”,从而引发了一场深刻的维修与管理革命。
告别图纸:AR装配系统如何让新手秒变老师傅
在工业4.0与智能制造的浪潮下,传统制造业正面临着技能断层与效率瓶颈的双重挑战。资深技工的退休导致隐性知识流失,而新员工面对复杂的装配图纸和厚重的操作手册往往无从下手。增强现实(Augmented Reality, AR)技术的引入,特别是基于云边协同架构的AR装配系统,正在重构人机交互模式,将“经验”数字化、可视化,使新手能够以接近专家的水平执行复杂任务。
企业AI中台为什么要把AI工作助理放在第一优先级!
因为员工真正接触到的不是架构图,而是入口;组织真正积累下来的也不是功能清单,而是入口背后的使用数据、路由逻辑、能力目录和持续反馈。这些东西,才决定平台能不能从技术项目变成组织能力。
Claw-Eval开源:300个真实任务,端到端评测AI智能体的完成度、安全性与鲁棒性
Claw-Eval是面向自主Agent的端到端评测框架,突破“只看结果”局限,聚焦任务执行全过程——可追溯、合规、容错。基于300个人工验证的真实任务,从完成度、安全性、鲁棒性三维度评估14个前沿模型,开源数据集、排行榜及代码。

OpAgent开源:登顶 WebArena,蚂蚁集团开源全模态网页智能体
蚂蚁集团推出Web智能体OpAgent,仅凭自然语言指令即可在真实网站(如亚马逊)自主完成搜索、识别、加购等复杂操作。其采用视觉驱动理解、在线强化学习与模块化协作架构,在WebArena基准达71.6%任务成功率,刷新SOTA。已开源OpAgent-32B-INT4量化模型,显著降低推理门槛。
tiktoken 对中文长文本的压缩率实证研究——基于百万 token 对话的三层量化框架验证
随着大模型长上下文能力的普及,tiktoken 及其他 BPE based 分词器已成为评估文本 token 数的标准工具。然而,其在中英文混合长文本中的实际压缩规律仍缺乏实证验证,业界普遍使用的经验公式(如中文字符 × 1.6)尚未在大规模语料上得到检验。本文基于 DeepSeek 百万 token项目中提纯后的对话数据(.jsonl,1 077 046 tokens,3 673 轮)采用反向推算方法,首次在真实中文长文本上量化了tiktoken 的压缩系数。主要发现: 1️⃣ 中文实际系数约为 1.16,远低于经验公式的 1.6,导致整体 token 估算高出20.9 %; 2️⃣ 对话呈
小红书开源FireRed-OCR,2B 参数登顶文档解析榜单
小红书FireRed团队开源的FireRed-OCR(仅20亿参数),在OmniDocBench v1.5端到端评测中以92.94%综合得分登顶,超越Gemini 3.0 Pro等大模型。专注解决文档解析中的“结构幻觉”问题,通过三阶段训练+格式约束强化学习,精准还原表格、公式、多栏等复杂结构。Apache 2.0协议,ModelScope开源,支持本地商用部署。(239字)
别再用 LangChain 搭 RAG 了:Dify 和 n8n 哪个才是你真正需要的
本文对比LangChain、Dify与n8n在AI工作流构建中的定位差异:LangChain是高自由度但调试成本高的代码框架;Dify专注RAG与对话,开箱即用;n8n擅长跨系统AI自动化。附七牛云模型接入指南与避坑提示。
《基于 DeepSeek 百万token上下文的实证研究:全窗口真实工程压力测试与统计分析》
本项目基于 DeepSeek 于 2026 年 2 月推出的 “新长文本模型”(上下文窗口扩展至1,000,000 tokens,API 端仍保持 V3.2 版本),通过构建非AI/IT领域的完整项目流程,进行了全程、全负载实证工程测试。在单一连续上下文中实现了端到端的闭环。
投稿 | Zvec: 开箱即用、高性能的嵌入式向量数据库
Zvec 是一款开源(Apache 2.0)轻量级嵌入式向量数据库,专为终端侧设计,具备开箱即用、资源可控、极致性能与完整向量能力四大优势,支持标量-向量混合查询、CRUD、崩溃恢复等生产级特性,让端侧RAG如SQLite般简单可靠。(239字)
基于Qwen-3B-Raw的本地化SD Prompt生成器研究
本项目用NLP技术把人类的模糊美学意图,蒸馏成可重复、可微调、可部署的图像生成指令引擎。
大模型微调实战:从原理到落地的完整指南
本文系统讲解大模型微调的原理与实战,涵盖LoRA等高效方法,手把手教你用少量数据定制专属模型,结合数据准备、训练策略与效果评估,助力开发者低成本实现AI应用落地。
重塑虚实边界:智元机器人发布首个大语言模型驱动的开源仿真平台Genie Sim 3.0
智元机器人发布全球首个大语言模型驱动的开源仿真平台Genie Sim 3.0,基于NVIDIA Isaac Sim,实现高保真数字孪生环境,支持自然语言生成万级场景,分钟级构建与泛化。平台开源上万小时真实机器人作业数据集,覆盖200+任务,构建10万+场景评估体系,推动具身智能从研发到落地的全链路创新,助力开发者零硬件部署、高效训练与评测。
Python 学习资源精选:从入门到精通的高效清单
本文系统梳理Python从入门到精通的学习路径,分阶段推荐优质资源:入门夯实语法,进阶掌握核心特性,场景定向深耕Web、数据或AI方向,最终提升工程化能力。涵盖视频、书籍、项目与工具,助力高效构建完整知识体系。