

2017杭州云栖大会FAQ(持续更新中)
2017杭州云栖大会将于10月11-14日在杭州云栖小镇举办,作为全球最具影响力的科技展会之一,今年的云栖大会规模更大,内容也更丰富。为了帮助大家解决报名、参会中的一些问题,小编专门整理了下大会相关的FAQ,供大家参考。
云上企业 AI 搜索:向量检索工程化与合规
本文指出:云上构建企业AI搜索,关键不在堆模型,而在精准向量检索与严守数据合规——双线并行方能“好用不出域”。涵盖托管vs自建成本对比、工程调参指南、四条合规硬线及知识资产化路径,助力企业打造可检索、可信赖、可复用的私有知识体系。(239字)
个人IP的AI搜索优化:单平台推荐信号如何影响AI引用
本文面向开发者与技术决策者,解析AI搜索引用个人内容的机制:AI引擎依赖平台推荐信号而非自主爬取,单平台垂直深耕比多平台铺量更易被引用。文章剖析抓取逻辑、与传统SEO差异、风险及验证方法,强调账号级信号优化。
EMR Serverless Daft 算子市场免费公测|10分钟极速实战(附视频教程)
Daft 算子市场公测来了!开箱即用的 AI 算子,覆盖 视频 / 图片 / 文本 / 音频 四大场景,搭配 Qwen3.7 大模型,零成本跑通 AI 数据处理全流程。 以训练一个能理解厨房操作的智能机器人为例,我们通常需要采集数千小时由人类佩戴摄像头拍摄的操作视频。然而,当这些视频被解码后,往往会膨胀为数亿张图像帧。更棘手的是,原始数据中充斥着静止画面、模糊镜头和无效空帧等海量“噪音”。如何从这些冗余信息中高效提取出高质量训练样本,已成为多模态技术发展的核心瓶颈。 本次实战将带您深入这一典型场景,借助 Daft 算子市场,一步步拆解并跑通从视频抽帧、数据清洗到高质量样本提取的完整链路。
6大AI引擎引用偏好实测:从45条数据看平台分发机制差异
本文基于2026年Q1对六款主流AI引擎的引用源实测,揭示其平台分发偏好差异:豆包偏爱CSDN(34%)、今日头条;DeepSeek聚焦技术社区;Kimi倾向财经媒体;秘塔专注学术源。提出可复现的“平台地图绘制法”与分平台内容适配公式,并强调AI发现依赖平台推荐算法,需60–90天内容积累期,且须坚守真实性底线。
闲鱼商品详情 API 实践:基于接口实现电商竞品价格监控
本文介绍基于闲鱼API构建的自动化竞品价格监控系统,覆盖商品价格、状态、成色、热度等多维变化,实现定时抓取、智能比对、阈值告警与历史快照存储,助力二手电商高效选品定价。(239字)
中文AI检索通道与豆包机制:三层结构与GEO实操判断
本文作者王涛提出“中文AI检索三层通道模型”,澄清豆包等国产AI并非简单“百度搜索”,而是混合调用网页索引、垂直数据库与字节自有内容池;强调训练知识与实时检索分离,纠正GEO中常见误判,指导优化投放策略。(239字)
企业大模型本地化部署与数据安全实践:从 RAG 权限过滤到审计闭环
本文聚焦企业大模型本地化部署中的数据安全痛点,以RAG问答系统为例,详解权限过滤前置、元数据治理、审计闭环等关键实践,提供可落地的分层架构与FastAPI代码骨架,强调“模型看不见无权数据”才是安全底线。
AI Agent时代的流程自动化:RPA、Workflow与LLM协同架构实践
本文探讨AI Agent与RPA的融合趋势:RPA擅长稳定执行规则化任务,AI Agent长于自然语言理解、推理与决策。二者非替代关系,而是协同构建“Agentic Process Automation(APA)”——Agent负责“做什么”,Workflow编排任务,RPA精准执行,知识库赋能持续学习。企业应分阶段推进,迈向目标驱动的智能自动化新范式。(239字)

阿里云 EMR Serverless Spark 全托管 Ray 再进化:加速构建全模态数据处理新基建
阿里云 EMR Serverless Spark + Ray 双引擎构建全模态数据处理的新基建,通过极致内核优化和统一数据、算力底座,彻底打通了大数据工程与 AI 模型训练的割裂。结合 RayData、Daft、Data-Juicer 等多模态引擎,以及 CPFS、OSS 等高性能存储生态,阿里云正在为全球的 AI 开发者提供一套最具竞争力的数据新基建。

从数据湖到多模态湖仓-基于阿里云 EMR Serverless StarRocks 与 DLF Paimon 构建AI时代的统一分析检索架构
阿里云 EMR Serverless StarRocks 在统一数据、一致语义和系统级优化之上,构建了面向 AI Data、AI Agent 和多模态应用的下一代湖仓架构。
自媒体多账号管理工具选型核心:安全风控、任务并发与API限流适配
自媒体矩阵扩张至30账号、10平台时,管理效率骤降、风控风险飙升。本文从安全隔离(IP/指纹/权限)、任务并发(账号池/自动调度)与API限流适配(频率控制/熔断降级)三大维度,系统解析企业级多账号管理工具的科学选型逻辑。(239字)
深度解析:Transformer 的“灵魂”——QKV 变换的物理直觉
本文用图书馆检索等生活隐喻,从物理意义与认知科学角度解析Transformer中QKV设计的精妙本质:解耦查询(q)、键(k)、值(v)三重角色,实现语义分离、避免自注意力“自恋”,模拟人类动态信息路由的认知过程。(239字)
阐述:通过图片地址搜索淘宝相似商品教程
本篇详解淘宝图片搜索API(taobao.item_search_img):支持通过图片URL或imgid搜索相似商品,涵盖接口调用、标准返回结构、标题/价格/SKU/库存等关键字段解析及常见避坑指南,附辅助接口说明,开箱即用。
别再搞混了!一文看懂“显存”与“内存”:从办公桌到实验室的硬核分工
本文以生动比喻与硬核解析,深入浅出地讲清内存(RAM)与显存(VRAM)的本质区别:内存是CPU的通用工作台,显存是GPU的专用高速实验室。二者分工明确,数据需通过PCIe传输,无法互相替代。尤其在AI训练中,显存容量与带宽直接决定模型能否运行。文章结合代码实例、性能对比表及排错指南,帮助开发者理解“CUDA out of memory”等常见问题,并提供优化策略与云平台建议,是迈向高效AI开发的必读指南。
什么是微调?大模型定制化的核心技术与实操指南
微调让大模型从“通用助手”变为“专属专家”。通过少量数据训练,LoRA等轻量化方法可在单卡上实现高效优化,广泛应用于医疗、金融、电商等领域。数据驱动、成本低廉、效果显著,微调正推动AI定制化落地,人人皆可拥有专属AI。
2026数字人公司TOP企业排行
随着AI、图形学等技术进步,数字人产业快速发展。2025年我国相关企业超1200家,规模突破300亿元。阿里、华为、腾讯、世优科技等企业在电商、通信、社交、AI交互等领域领先,推动数字人在金融、政务、教育等场景落地。技术趋同下,全栈能力与行业理解成竞争关键。

微服务服务注册与发现
本文介绍了微服务架构的演进与实践。针对单体架构在团队协作、发布效率、扩展性等方面的局限,微服务通过将系统拆分为多个独立部署、单一职责的小型服务,实现高内聚、低耦合,提升系统的可维护性与伸缩能力。结合Spring Cloud与Spring Cloud Alibaba技术栈,文章以黑马商城项目为例,演示了如何创建微服务工程、进行服务拆分,并使用RestTemplate实现服务间远程调用,帮助开发者掌握微服务核心开发技能。

反爬虫机制深度解析:从基础防御到高级对抗的完整技术实战
本文系统阐述了反爬虫技术的演进与实践,涵盖基础IP限制、User-Agent检测,到验证码、行为分析及AI智能识别等多层防御体系,结合代码实例与架构图,全面解析爬虫攻防博弈,并展望智能化、合规化的发展趋势。

从零构建能自我优化的AI Agent:Reflection和Reflexion机制对比详解与实现
AI能否从错误中学习?Reflection与Reflexion Agent通过生成-反思-改进循环,实现自我优化。前者侧重内容精炼,后者结合外部研究提升准确性,二者分别适用于创意优化与知识密集型任务。

秒级行情推送系统实战:从触发、采集到入库的端到端架构
本文设计了一套秒级实时行情推送系统,涵盖触发、采集、缓冲、入库与推送五层架构,结合动态代理IP、Kafka/Redis缓冲及WebSocket推送,实现金融数据低延迟、高并发处理,适用于股票、数字货币等实时行情场景。
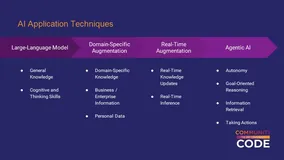
Flink Agents:基于Apache Flink的事件驱动AI智能体框架
本文基于Apache Flink PMC成员宋辛童在Community Over Code Asia 2025的演讲,深入解析Flink Agents项目的技术背景、架构设计与应用场景。该项目聚焦事件驱动型AI智能体,结合Flink的实时处理能力,推动AI在工业场景中的工程化落地,涵盖智能运维、直播分析等典型应用,展现其在AI发展第四层次——智能体AI中的重要意义。
Figma桌面客户端下载教程+协作设计入门,小白也能变大神
Figma 是全球领先的云端UI/UX设计工具,支持多人实时协作、矢量图形编辑与原型交互设计。其核心优势包括跨平台同步、团队协作(支持50+成员同时编辑)和丰富的资源生态(集成2000+免费插件)。Figma无需安装,通过浏览器访问官网即可使用。硬件要求最低为4GB内存和5Mbps宽带,推荐配置为8GB+内存和50Mbps+宽带。用户可通过创建团队空间邀请成员,支持邮箱邀请和链接分享。Figma还提供详细的官方学习资源,帮助用户掌握核心功能。
SDL 图形库安装常见错误及解决方法
SDL(Simple DirectMedia Layer)图形库安装过程中可能会遇到编译错误、运行时错误、依赖库缺失等问题。本文总结了在 Linux 和 Windows 系统上常见的错误及解决方法,包括检查和安装依赖库、配置 SDL 子系统、处理 X11 错误等,帮助用户顺利完成 SDL 的安装和配置。
MaxCompute产品使用问题之如果oss文件过大,如何在不调整oss源文件大小的情况下优化查询sql
MaxCompute作为一款全面的大数据处理平台,广泛应用于各类大数据分析、数据挖掘、BI及机器学习场景。掌握其核心功能、熟练操作流程、遵循最佳实践,可以帮助用户高效、安全地管理和利用海量数据。以下是一个关于MaxCompute产品使用的合集,涵盖了其核心功能、应用场景、操作流程以及最佳实践等内容。

Python 原生封装 Llama.cpp 大模型推理接口
本文以通义千问Qwen量化GGUF模型为例,基于Llama.cpp框架,用原生Python实现本地大模型调用:涵盖模型元数据解析、单次/多轮对话、记忆持久化及自定义工具调用(如时间、计算),无需重型AI框架,轻量高效,助开发者深入理解本地大模型运行原理与工程落地实践。(239字)
PoisonedRAG知识投毒攻击全解析:原理、风险与防御策略
本文是王涛专家深度解析arXiv 2402.07867《PoisonedRAG》,揭示RAG系统新型知识投毒攻击:仅需注入少量对抗构造文本,即可劫持大模型输出。剖析其绕过文档入库、向量检索、拼接生成三环节的信任机制,阐明低成本、长尾覆盖、跨模型迁移等特性,并提出基于元数据审计、来源追溯与上下文治理的防御思路。(239字)
从功能对比到价值匹配:2026数据治理系统工具选型逻辑重构
2026年数据治理工具选型已从“功能清单对比”转向“技术路线匹配”。AI原生能力、全链路自动化与业务适配度成新三角标准。本文深度解析阿里云Dataphin、Informatica IDMC等五款主流工具,提出四步价值导向选型框架,助力企业精准匹配自身数据阶段与AI战略。(239字)
从模型智能到系统可信:Quick BI AIPro的 AI-native BI架构
阿里云Quick BI AIPro正式发布,首创AI-native BI架构,以7道可信防线保障数据安全与分析准确。支持自然语言交互,首月赠12.5万Credits,0成本开启企业级智能分析。
【免费领取Credit】Quick BI AIPro 全新发布,让数据成为企业增长引擎!
阿里云Quick BI AIPro正式发布!全新AI-native架构,支持对话式深度分析、业务语言理解、自动归因与行动建议。首月赠12.5万Credits,零门槛免费试用,存量客户无缝升级,新用户上传数据即用。
AI大模型工具深度运用实践:AI客服系统怎么搭建?基于大语言模型的企业智能客服实践与应用分析
企业正借力大语言模型,将传统规则客服升级为AI Agent智能客服:从关键词匹配跃升至意图理解,由人工配置转向文档驱动,从被动应答进化为主动执行任务,实现7×24全时服务与低成本能力扩展。(239字)

大模型企业本地化部署与数据安全实践:知识库过期内容如何治理
企业大模型本地化部署中,知识库内容过期易致“看似正确实则失效”的回答。本文聚焦数据安全与治理,提出版本管理、状态标识(有效/归档)、生效时间、替代关系等元数据规范,并结合审核流程、提示词约束与分层架构,构建可追溯、可更新、可下线的知识库闭环治理体系。
本地流量破局:GEO 地理搜索优化实操全教程(AI 开发技术干货)
本文聚焦 GEO 地理搜索优化技术,对比其与传统 SEO 的底层逻辑差异,完整讲解站点地理结构化埋点、地图 API 同步开发、区域分层页面搭建三大实操开发流程,附带本地技术服务行业真实落地优化案例,拆解优化前后流量数据变化。同时梳理开发过程中容易踩中的权重作弊、标签堆砌等技术坑点,给出合规优化方案,帮助开发者搭建全域 SEO + 区域 GEO 双优化技术架构,低成本获取本地精准自然检索流量。
EMR Serverless Daft 如何简化多模态数据处理:视频抽帧、清洗、标注全流程与具身智能实践
阿里云 EMR Serverless Spark 引入 Ray 分布式计算框架与 Daft 高性能数据引擎,为用户提供了一套开箱即用、免运维且极致高效的多模态数据处理基础设施。
AI搜索时代内容匹配机制:从关键词匹配到语义匹配的范式转换
本文剖析AI搜索引擎(如豆包、Kimi)依赖RAG技术实现语义匹配的底层逻辑,揭示其以向量相似度替代BM25关键词匹配的本质。指出关键词堆砌已失效,并提出四大语义时代内容策略:覆盖多元问法的语义覆盖、结构化段落提升可引用性、权威引用增强可信度、FAQ打造天然语义锚点。
别只盯着HTML了!教你高效抓取并解析PDF/Excel隐藏附件?
本文聚焦网页附件(PDF/Excel)爬取痛点,系统讲解隐藏链接识别、二进制文件下载、pdfplumber/pandas精准解析及代理IP轮换反爬策略,并附完整实战代码,助你高效获取高价值结构化数据。(239字)
如何申请 1688 拍立淘识图接口白名单
1688拍立淘图片搜索接口(1688.item_search_img)为AI视觉增值接口,需企业实名+三证合一资质人工白名单审核。本文详解准入条件、五步申请流程、驳回避坑点及替代方案,助企业高效开通识图能力,支撑ERP选品与供应链寻源。
HTTP代理类型简介及数据采集业务选择指南
本文系统解析HTTP代理的三大类型(数据中心、住宅、移动)及其独享/共享模式,对比性能、匿名性、成本与适用场景,并提供选型策略与实战案例,助企业高效、安全开展数据采集。
AutoGod:一款拥有AI视觉的安卓自动化框架
AutoGod是一款面向安卓的AI视觉自动化框架,融合多引擎OCR、YOLO目标检测与VMP混淆引擎,解决传统方案元素定位脆弱、兼容性差、安全性低等痛点,支持自动化测试、游戏脚本与企业RPA,兼顾智能性、鲁棒性与安全性。
50%的人给了差评:龙虾为何在技术论坛翻车了?
OpenClaw(龙虾)AI工具因“自动赚钱”“代约主播”等夸张宣传走红,但吾爱破解论坛投票显示:50%技术用户未下载且不认可其能力。技术圈冷静源于见惯“神器”泡沫——AI擅写代码(搬砖),却难懂需求、统筹系统。它不是神药,而是待磨的砍柴刀。
1688商品详情API数据采集指南
1688商品详情API(1688.item_get)是阿里开放平台核心接口,支持通过商品ID获取标题、价格、库存、SKU、图文详情、商家资质等50+字段,JSON格式返回。广泛用于ERP同步、跨境铺货、比价监控与供应链管理,需签名认证,调用稳定高效。(239字)
8080 和 3128 端口的核心区别及使用场景
HTTP代理常用端口8080与3128各有侧重:8080多用于管理监控(如Web配置界面),易记但可能被防火墙拦截;3128为标准端口,稳定性高,主供客户端正常请求转发。端口可自定义,需据安全与性能需求合理选用。
大数据与机器学习
大数据领域前沿技术分享与交流,这里不止有技术干货、学习心得、企业实践、社区活动,还有未来。