









为什么你的监控总是“事后诸葛亮”?聊聊 InfluxDB、Prometheus 与可视化的正确打开方式
为什么你的监控总是“事后诸葛亮”?聊聊 InfluxDB、Prometheus 与可视化的正确打开方式
2026架构前沿:将Declarative Crawler(声明式爬虫)引入你的技术栈
这篇文档强调了2026年数据工程领域声明式爬虫架构的重要性。它通过分离业务意图和执行细节,降低跨部门协作门槛。关键挑战在于底层IP设施。文档介绍了爬虫代理技术,并通过Python代码示例展示了如何实现声明式会话组。最后,提出了渐进式迁移策略,以实现声明式爬虫架构

淘宝商品详情API实战总结(数据模型项目复盘)
本文复盘淘宝商品详情API(taobao.item.get)实战项目,聚焦结构化采集、标准化清洗与统一建模。攻克签名验签、限流风控、多价核算、字段脱敏等难点,构建含基础/价格/SKU/素材/口碑/店铺六大维度的标准化数据模型,支撑分析中台高效复用。(239字)
1688商品详情API 实战总结(技术复盘)
本文为1688商品详情API(1688.item.get)实战复盘:采用官方合规接口,攻克签名校验、限流、阶梯价解析等难点,稳定采集B2B专属数据(批发价、起订量、供应商资质等),替代高风险爬虫,已支撑供应链、铺货与竞品监控业务。
代购系统的可扩展通知机制:从硬编码到观察者模式,借鉴taocarts的事件总线
本文分享代购系统通知模块的演进之路:从硬编码通知到基于Spring事件总线的解耦设计。通过抽象订单事件、注解式监听器、异步执行与Webhook动态订阅,实现高可扩展、易维护的通知体系,彻底告别“改一处崩全局”的困境。
2026 年,我码了将近 20 万字,吃透 GEO 底层逻辑,我是怎么做到的?
人这一生,走到最后,拼的从来不是小聪明与快节奏,而是长期主义的定力,是深度拆解的思考力,是一套独属于自己的底层认知框架。
业务实战:基于 Ruby Mechanize 与隧道代理构建工业级数据采集器
本文探讨了在爬虫开发中如何平衡效率,并介绍了Ruby的Mechanize库的优势。它自动管理会话,处理复杂表单,适合社交平台。文章还讨论了IP封禁和代理策略,并提供了代码模板,包括代理配置和错误处理。最后总结了运维经验,帮助爬虫工程师专注于数据解析。
唯品会图片搜索API:通过图片地址获取唯品会相似商品
本资料详解唯品会图片搜索API(vip.item_search_img),涵盖接口调用、标准返回结构、关键字段(标题/价格/SKU/库存等)解析及常见避坑指南,支持图片URL直搜与upload_img预处理,助力高效开发与数据入库。(239字)
反向海淘爆发下,多平台铺货效率决定规模|taocarts 打通 Shopify/Coupang 自动化链路
反向海淘风口下,多渠道铺货已成为跨境创业者规模化运营的核心路径,但传统代购系统源码普遍存在多平台对接缺失、订单与采购割裂、人工操作效率低下等痛点。本文从技术适配与效率提升角度,解析taocarts跨境独立站系统如何通过一键铺货、订单同步、自动采购全链路闭环,打通Shopify、Coupang等海外主流电商平台,结合多语言多货币、运费估算、海外仓备货等能力,帮助反向海淘独立站从业者降本增效,快速抢占多渠道红利,同时规避技术对接与合规风险。
天猫商品详情API数据解析
天猫商品详情API解析方案,涵盖taobao/tmall.item.get接口字段说明、JSON结构、解析代码及SKU/详情图/规格提取。支持价格库存、竞品监测、舆情预警等场景,AI智能清洗、卖点解析与爆款预测,助力中小卖家高效用数。(239字)
告别403和429:如何搭建24小时不间断的本地数据采集系统
本文分享本地知识库自动化采集的高可用架构实践,直击“假死”痛点:数据停滞、频繁403/429报错。提出三层分离设计(代理层、调度层、业务层),详解代理池精细化运营、指数退避重试及systemd/PM2守护方案,助你构建稳定、可维护的24小时采集系统。
基于CefSharp内核与动态隧道的金融海量行情抓取架构方案
本文详解CefSharp在金融高频数据抓取中的两大代理难题:一是代理认证头(Proxy-Authorization)因跨进程失效导致直连暴露IP;二是HTTPS Keep-Alive锁定出口IP,无法动态轮换。提出通过自定义RequestHandler手动注入认证头与Proxy-Tunnel隧道标识的双重方案,实现稳定代理穿透与毫秒级IP切换,助力高效获取海外行情数据。
Aloudata:从 A lot of data,到 AI on data
我们做的其实一直是同一件事: 先解决数据生产力的问题,让好数据更高效地被生产出来; 今天再进一步,让这些好数据不只是被人用,也能被 Agent 用。
TorchEasyRec中INPUT_TILE 环境变量的三个模式
`NPUT_TILE` 是 tzrec 推荐系统在模型导出与在线推理阶段的优化策略,针对“1 用户 → N 商品”场景,避免用户特征重复计算。支持三种模式:`INPUT_TILE=1`(无优化)、`=2`(Embedding前tile)、`=3`(Embedding后tile,计算最优但需拆分Embedding表、依赖FG模式及torchrec,不支持macOS)。
AIGC数据引擎的基石:图库抓取架构从单机到云原生的演进与实战
AIGC领域优化数据采集策略,提升大模型竞争力。初期使用Python脚本搭建单机爬虫,后转向分布式设计,引入代理技术。云原生部署实现弹性伸缩,全链路监控。构建高可用数据采集引擎是关键。
洞察电商数据:京东商品详情API 数据模型
该JD商品数据接口提供jd.item_get(基础)与jd.item_get_pro(全量)两大核心服务,支持POST/GET调用,返回JSON格式。无需申请密钥,传入item_id/sku_id及timestamp即可一键获取含图文、价格、库存、规格、销量、售后等7大模块的标准化商品数据,适配批量查询与中小卖家需求。(239字)
当业务口径频繁变化时,预制指标、宽表、SQL 和本体ABC 谁最不容易失控?
本文对比四种智能问数路径:预制指标、宽表、人工SQL与本体ABC。指出在业务稳定时前三者高效,但面对口径频繁变更、跨部门协同等高变化场景,语义维护成本远超查询性能问题。本体ABC虽前期投入大,却将变化管理聚焦于对象、关系、属性与逻辑层面,实现长期可控的语义治理。
自动化工具泛滥的当下,我为什么坚持用1949自动化做个人工作流?
本文反思自动化工具泛滥带来的新负担,主张回归“轻量、本地、无感”的自动化理念:拒绝复杂配置与云端依赖,选择事件驱动、隐私安全、可视化编排的桌面工具,让自动化真正服务于人——不是取代思考,而是释放创造力。
从提取式API到隧道代理:提升爬虫稳定性的5个核心秘籍
本文讨论了五个关键细节以优化爬虫代理使用:使用隧道代理、合理设置超时、利用连接池、引入重试机制、伪装请求头。通过隧道代理的实战代码示例,展示了如何实现这些优化,以提高爬虫的稳定性和效率。

AI 新范式,从对话走向行动,奥尔特云全面接入OpenClaw,直接通过IM对话框下指令给AI完成工作任务
人机交互可能正迈向第三次变革:迈入自然语言指令时代。OortBot与OpenClaw等本地AI Agent兴起,支持私有部署、多智能体协同、深度系统集成,数据不出本地,成本可控、自由可定制——AI正加速从云端走向端侧。
基于API的印度股市数据对接指南
本文为开发者提供印度股市(NSE/BSE)API对接完整指南,涵盖环境配置、实时行情、历史K线、基本面数据获取,支持HTTP/WS双协议,内置重试、缓存、时区处理与技术分析功能,助力快速构建量化工具与行情应用。(239字)
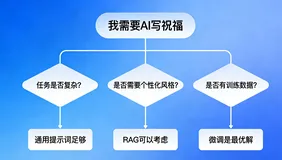
别再群发拜年消息了!三步微调AI,让它学会你的“独家语气”
每逢春节,通用AI祝福总显生硬空洞。本文探讨如何通过微调(LoRA),将“人情世故”转化为结构化数据(称呼/关系/细节/风格等),让AI真正学会你的语气与记忆,生成有温度、带梗、专属的个性化祝福——技术不是替代表达,而是帮你把来不及说的情意,说得恰到好处。(239字)
从踩坑到高效落地:微店商品详情API的实操心得
本文分享电商数据服务商对接微店商品详情API的实战经验:详解OAuth2.0授权、多类型商品字段兼容、滑动窗口限流三大典型坑及解决方案,助力私域电商实现商品/库存/价格实时同步,提升数据准确率至99.5%+。
轻量化部署:让你的祝福模型在小显卡上跑起来
本文揭秘春节祝福AI的轻量化部署:无需昂贵GPU,消费级显卡即可运行!通过INT4量化(模型缩至1/8)、LoRA微调(仅训MB级参数)及QLoRA组合,搭配vLLM推理优化与K8s弹性扩缩容,7B小模型高效生成祝福语。低成本、低门槛、高可用——大模型应用,人人可及。
chunk size 变大,模型为什么更容易胡说
本文揭示RAG中最隐蔽的风险:增大chunk size看似提升回答完整性,实则削弱模型对不确定性的识别能力。它不增加真实知识,反掩盖证据缺口、混淆适用条件、抑制合理拒答,将“答不出”悄然转为“答得像却错”。警惕“自信幻觉”,回归证据单元设计本质。
模型能不能训练出来是技术问题,敢不敢上线是评估问题
大模型工程中,训练失败显性易察,评估失败却隐匿致命:指标好看、demo流畅,却可能放行高风险错误。评估本质是定义“何为成功”,需权衡技术、业务与责任,直面尾部风险而非平均表现。它难自动化、缺共识、重判断——真正决定能否上线的,不是模型多强,而是我们敢为哪些错误担责。
评估不是算分数,是在问:我们扛不扛得住
本文揭示评估会议的本质:它并非单纯检验模型性能,而是暴露团队对不确定性的应对能力。指标选择、bad case争论、流程复杂化,实则是组织风险认知、责任归属与心理成熟的映射。评估的终点,不是模型“完美”,而是团队达成对不完美的共识与担当。
智能体来了:领航员的使命与智创未来的蓝图
蓝图宏大却易忽略现实复杂性。领航员不否定蓝图,而是以务实之问——“条件不足时如何?偏差谁来纠?连锁反应有无预案?”——弥合理想与落地的鸿沟。他们为智能体构建边界、节奏与责任机制,让愿景真正成为可持续的路线图。(239字)
自主智能体:重塑传统行业的隐形革命
在AI从概念走向应用的时代,自主智能体正悄然重塑传统行业。它非单一模型,而是具备感知、决策、执行与优化能力的“数字员工”,已在制造、供应链、农业、医疗、建筑等领域实现深度赋能,推动人机协同新范式。
一个项目开始失控时,通常不是从代码开始的
本文揭示项目失控的深层规律:代码只是最晚显现的“结果层”,而非病因。真正失控始于早期——问题定义模糊、评估妥协、边界不清、复杂度累积、用解释替代约束、盲目依赖“再调一版”。六条路径环环相扣,每步看似合理,却悄然瓦解可控性。止损关键在决策层,而非代码层。
数据工程指南:指标平台选型避坑与 NoETL 语义编织技术解析
可有效减少 70% 以上的指标开发维护成本,整体基础设施成本(TCO)节约可达 50%,并释放超过 1/3 的服务器资源。
指标平台选型必看:Aloudata CAN 虚拟业务事实网络破解复杂多表关联难题
为 NL2MQL2SQL、数据分析智能体(Agent)等 AI 应用提供了高质量、可理解、高性能的数据基础,是迈向智能决策的关键一步。
为什么 TopK 越大,模型反而越爱胡说
本文揭示RAG中TopK参数的致命误区:增大TopK并非提升召回,而是扩大模型决策空间,导致证据冲突加剧、关键信息稀释、模型被迫“自圆其说”。实证表明,TopK=3–5才是稳定安全区间;盲目调大只会用不确定性换表面流畅,本质是为切分、检索等深层问题背锅。
当西南传统产业遇上智能体来了时代:一场效率与韧性的深度变革
智能体以“感知-决策-执行”闭环能力,正驱动西南传统产业系统性升级:从川渝汽车制造到云南普洱茶、贵州白酒、重庆火锅等场景,实现动态感知、自主优化与闭环执行,突破经验依赖与规则局限,推动单点优化迈向生态重构。

大数据与机器学习
大数据领域前沿技术分享与交流,这里不止有技术干货、学习心得、企业实践、社区活动,还有未来。

