智能冰箱食材识别

简介: 本案例设计了一个囤菜系统原型,主要方法是利用冰箱内安装的摄像头,通过目标检测算法识别食材类别,判断存取动作,增加或者减少相应的食材的数量,并记录存取时间等相关数据,设计出了具备提示清理和补货等功能的智能化囤菜系统原型。

智能冰箱食材识别

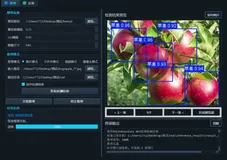
【导读】本案例设计了一个囤菜系统原型,主要方法是利用冰箱内安装的摄像头,通过目标检测算法识别食材类别,判断存取动作,增加或者减少相应的食材的数量,并记录存取时间等相关数据,设计出了具备提示清理和补货等功能的智能化囤菜系统原型,对于智能冰箱的发展提出了一个新的解决方法。首先,由于在冰箱上进行边缘计算的实时性要求比较高,选用了参数量比较少,计算速度比较快的YOLOX-Nano算法作为食材识别的算法;为了提升识别时候的推理速度,使用了OpenVINO工具库,对模型进行优化和加速。本案例可以实现对冰箱里食材种类和数量的增减,并在食材数量少于设定值的情况下,提示补充。

1问题分析
随着时代的进步,人工智能已渗透到各个行业,其中家电的智能化已成为该产业发展的重要趋势。冰箱,作为家庭日常生活中不可或缺的一部分,其智能化应用却尚未得到广泛推广。尽管市面上智能家电层出不穷,但冰箱在日常生活中的智能化应用场景仍显不足。每年因冰箱内食物管理不当而造成的浪费数额惊人,传统的手动记录食物放入日期和保质期的方式既繁琐又耗费人力,且不同家庭成员对冰箱内存货的需求各异。
在智能冰箱领域,食材的精准管理成为其发展的核心议题,而准确识别食材种类则是实现这一目标的首要前提和技术挑战。当前,目标检测分类算法的快速发展为基于图像的食材识别提供了坚实的技术支持。同时,这种基于图像的识别方式无需改变用户的存取习惯,实现了近乎无感的操作体验,相较于条码、RFID等方式具有明显优势。因此,它已成为智能冰箱研究的热点,对智能冰箱的发展具有重大意义。
针对上述需求和挑战,本案例旨在设计一款智能冰箱原型,它不仅能自动记录食材信息,还不改变用户的使用习惯。这款智能冰箱可以作为软硬件一体化产品进行销售,同时也可与电商、广告、数据等厂商展开合作,既解决了用户的实际问题,又展现了广泛的商业应用前景。
为实现这一目标,本案例提供了一套软硬件一体化解决方案:智能冰箱内置摄像头进行视频采集,通过目标检测系统对食材进行分析和统计,并通过微信小程序将库存信息实时推送给用户。对于新增的蔬菜或水果类别,采用了“迁移学习”的方法。考虑到这些食材的训练数据相对较少,利用预训练模型,并结合少量样本进行迁移学习,从而得到针对新类别的识别模型。
此外,通过使用OpenVINO优化目标检测模型,成功提升了约50%的推理速度,实现了实时检测效果,为用户带来了更加流畅的使用体验。

2数据预处理
2.1数据探索
原始数据为冰箱上方摄像头拍摄的20种食材图像,图像共计11,983张,按类别存放在不同的文件夹中。将下载后的数据存储在文件夹fridge,并放在yolox\data文件夹下:
data_dir=os.path.join(get_yolox_datadir(), "fridge")
抽取少量原始图像,所有图像均为测试人员手持不同食材在存取食材时的图像。

2、标注信息
标注信息为图像中的食材类别和位置框,标注信息格式为json文件,每段标注信息由name、image_height、image_width、category和bbox组成,如下图所示:

2.2 数据集转换
将原始数据按照VOC格式进行转换,首先将包含原始文件标注信息的json文件转换为XML文件,每张图片对应一个XML文件,并将所有XML存放于Annotations文件夹中。选取20类食材,根据其类别代码,从60类的标注文件(train_annos_1-60.json)中筛选20类的标注,记录到anno_20.json中:python gen_anno_json.py;将20类食材图像合并到JPEGImages文件夹中,由于这一步可能会遇到图片文件名重复,注意在更改重复文件名的同时更改json标注文件;将20类的json文件转换为XML文件:python gen_XML.py;将所有图像名称记录在all.txt中,并分割为训练集和测试集。

然后将所有图像合并到JPEGImages文件夹中。最后将所有图像名称记录在all.txt中,存放在ImageSets/Main中,用于后续数据集分割。

2.3数据集分割
将原数据集11,983张图片按8:2的比例随机进行分割,分为训练集和测试集:python gen_dataset_txt.py。分割后的训练集共计9586张图片,测试集共计2397张图片。训练集的图片名称存放于trainval.txt文件中,测试集的图片名称存放于test.txt文件中。

完整案例可以参考新书:
赵卫东编著.深度学习实战案例.北京:人民邮电出版社,2024

目录
相关文章
|
7月前
|
人工智能 弹性计算 运维
|
1月前
|
存储 人工智能 监控
预览下一代Qwen4架构,解析Qwen3.8‑Flash的Coding、Agent与成本优势
2026年,Qwen团队正式对外推出Qwen3.8‑Flash‑Next开源权重模型,对应的线上生产服务版本命名为Qwen3.8‑Flash。这套模型不只是一次常规版本迭代,更是下一代Qwen4整套架构思路的提前对外预览,在稀疏激活架构、超长上下文、代码工程能力、智能体工具调用以及推理成本层面都带来了非常关键的变化。总参数规模125B,采用稀疏MoE设计,每一个Token推理阶段仅激活约6B参数;开源版本原生支持262144 Token上下文窗口,借助YaRN技术可扩展至100万Token;线上云服务版本Qwen3.8‑Flash默认直接开启100万Token上下文能力,同时大幅强化代码处理、
970 0
|
机器学习/深度学习 人工智能 监控
基于YOLOv8的多种水果种类识别项目|完整源码数据集+PyQt5界面+完整训练流程+开箱即用!
本项目基于YOLOv8与PyQt5开发,实现多种水果种类的高效识别。支持图像、视频及摄像头输入,具备批量检测、实时识别与高精度标注功能,模型轻量且部署简便,适用于边缘设备。配套完整源码、数据集与训练教程,开箱即用,适合学习与产业应用。
基于YOLOv8的多种水果种类识别项目|完整源码数据集+PyQt5界面+完整训练流程+开箱即用!
|
7月前
|
机器学习/深度学习 人工智能 算法
草莓成熟度目标检测数据集(2000张图片已标注)| YOLO训练数据集 AI视觉检测
本文介绍的 草莓成熟度目标检测数据集(2000张已标注图像),基于多类别草莓成熟度样本构建,覆盖未成熟、成熟和过熟三类典型状态,并采用标准 YOLO标注格式,可直接用于深度学习模型训练,为智慧农业视觉研究和果蔬自动检测系统提供重要的数据支持。
|
人工智能 监控 前端开发
AI工具:前端与后端的终极对决?谁将成为新时代的宠儿?
深入探讨AI工具对前端和后端开发的具体影响、各自的机遇与挑战,并分析未来开发者如何驾驭AI,实现能力跃迁。
911 0
|
存储 域名解析 缓存
DNS解析过程
DNS(域名系统)解析是将域名转换为IP地址的过程,对互联网运行至关重要。解析方式主要包括递归查询和迭代查询。递归查询由本地DNS服务器代为完成,简化客户端操作;迭代查询则需客户端逐级向根DNS服务器、TLD服务器和权威DNS服务器请求。过程中涉及缓存机制以提高效率,如客户端与本地DNS服务器缓存及TTL值管理。示例中,解析www.example.com需依次通过本地、根、TLD和权威DNS服务器获取IP地址。
1520 18
|
机器学习/深度学习 测试技术 PyTorch
轻量级网络——MobileNetV3
轻量级网络——MobileNetV3
3421 0
轻量级网络——MobileNetV3
|
机器学习/深度学习 人工智能 编解码
阿里开源AI视频生成大模型 Wan2.1:14B性能超越Sora、Luma等模型,一键生成复杂运动视频
Wan2.1是阿里云开源的一款AI视频生成大模型,支持文生视频和图生视频任务,具备强大的视觉生成能力,性能超越Sora、Luma等国内外模型。
9510 2
阿里开源AI视频生成大模型 Wan2.1:14B性能超越Sora、Luma等模型,一键生成复杂运动视频
|
存储 人工智能 API
OWL:告别繁琐任务!开源多智能体系统实现自动化协作,效率提升10倍
OWL 是基于 CAMEL-AI 框架开发的多智能体协作系统,通过智能体之间的动态交互实现高效的任务自动化,支持角色分配、任务分解和记忆功能,适用于代码生成、文档撰写、数据分析等多种场景。
2445 13
OWL:告别繁琐任务!开源多智能体系统实现自动化协作,效率提升10倍
|
人工智能 安全 物联网
释放终端潜能----端侧AI模型
端侧AI将智能直接部署于终端设备,实现毫秒级响应、极致隐私保护与显著成本优化。其核心优势包括极速响应(告别网络延迟)、隐私安全(数据不出本地)及成本优化(减少云端依赖)。通过模型小型化、硬件感知优化、高效推理引擎和端云协同等关键技术,端侧AI在有限资源下保持高性能,
2339 0
释放终端潜能----端侧AI模型