









给 Agent 选模型:先别问哪个聪明,问哪个你敢用
很多人在给 Agent 选模型时只看跑分和榜单,但对生产环境来说,更关键的问题是"哪个模型你敢用"。本文从工具调用正确率、拒答能力、长任务稳定性三个指标出发,讲怎么建自己的评估集、分阶段选型,以及选模型时容易忽略的 API 通道稳定性问题。
个人IP的AI搜索优化:单平台推荐信号如何影响AI引用
本文面向开发者与技术决策者,解析AI搜索引用个人内容的机制:AI引擎依赖平台推荐信号而非自主爬取,单平台垂直深耕比多平台铺量更易被引用。文章剖析抓取逻辑、与传统SEO差异、风险及验证方法,强调账号级信号优化。
DataWorks AI助理实践:Flink作业健康度巡检
DataWorks AI助理(DataClaw)深度打通Flink等引擎层监控,支持Flink自动巡检作业失败事件、27项核心指标及2类系统事件,智能分级(P0-P3)并推送钉钉告警,实现任务全生命周期统一观测与异常闭环。
爬完别忘了存:社交媒体快照上 OSS/S3 的 4 个必做优化
本文分享网页快照低成本存储实战:针对大数据快照存储场景,通过HTML压缩(gzip)、内容哈希去重、Key分区防热点、冷热分层(标准→低频→归档)四大优化,将月存储成本从¥79降至¥4,降幅达95%,综合节省至原方案1/20。
6大海外AI搜索场景:出海企业内容策略的GEO实战指南
2024年AI搜索(ChatGPT、Perplexity、Google SGE等)月活破亿,传统SEO失效。本文提出GEO(生成式引擎优化),拆解6大海外AI搜索场景的引文逻辑,提供“认知对齐→场景拆解→分层优化→效果度量”四步实战框架,助力出海企业从“被搜索引擎理解”升级为“被AI模型信任”。
AI驱动 DevOps:智能 CI/CD 管道构建与自动故障恢复
DevOps正迈入AI原生时代:AI不再仅辅助开发,而是深度融入CI/CD全流程——智能代码审查、动态测试选择、风险感知发布、多维异常检测与自动根因修复,构建具备自主决策能力的智能化软件交付体系。
EMR Serverless Spark PB级文本语义去重4倍加速的技术方案解读
针对大模型语料清洗中文本去重面临的性能瓶颈,某企业迁移至阿里云emr serverless spark后实现突破。新方案通过minhash-lsh内置函数将算法下沉引擎层,减少40%代码量;结合fusion engine向量化加速与shuffle优化,消除python udf跨进程开销并解决数据倾斜问题。实测去重性能提升4倍,任务耗时从天级降至小时级,且实现零shuffle失败与免运维。该实践验证了serverless架构在pb级数据预处理中的高效性与稳定性,显著加速模型迭代并降低计算成本。
AI Search × ES Agent Builder 最佳实践:企业智能助手落地指南
ES Agent Builder 是面向 Elasticsearch 的企业级 AI Agent 平台,让员工用自然语言对话式查询日志、指标、文档等数据,自动生成分析结论与行动建议,无需写 SQL 或依赖专家经验,真正实现“对话数据、理解数据、驱动决策”。
为什么爬虫并发拉到几百,吞吐反而掉了?记一次高并发爬虫性能瓶颈排查与实战
本文探讨了高并发环境下数据采集和爬虫扩容的挑战,强调了提高并发量可能不会提升吞吐量,反而可能导致系统变慢。文章介绍了排查单机资源瓶颈的方法,并讨论了代理隧道的瓶颈。提供了一个Python asyncio + aiohttp的生产级爬虫代码示例,整合了连接池控制、隧道代理接入等,以解决高并发下的吞吐抖动和429报错。最后,总结了爬虫调优的分层治理法则,强调了在遇到问题时,应遵循迭代路径,找准真正的瓶颈层进行优化。
taobao.item.search.img(拍立淘图片搜索 API)全业务场景手册
拍立淘按图搜商品(taobao.item.search.img)是阿里视觉AI接口,支持图片URL或Base64输入,精准返回同款/相似商品ID、标题、价格、销量等结构化数据,广泛应用于跨境铺货、比价导购、竞品监控、品牌维权、智能选品等六大场景。(239字)
全棉时代 x Quick BI:助力全棉时代高价值会员精益运营,实现双十一到店转化率提效150%+
全棉时代借助阿里云瓴羊数据智能,实现会员精细化运营:双十一到店转化率提升150%+,母婴与家清品类交叉渗透率增50%+。Quick BI支持对话式分析,助品牌从“流量”转向“留量”经营。
人工智能|大白话YOLOv2
YOLOv2采用轻量高效的Darknet-19骨干网络(仅19层卷积),全用1×1和3×3小卷积核,配BatchNorm与LeakyReLU;引入Anchor Boxes、Passthrough层融合多尺度特征,并支持多尺寸输入,显著提升精度与小目标检测能力。(238字)
鹰角网络:EMR Serverless Spark 在《明日方舟》游戏业务的应用
鹰角网络为应对游戏业务高频活动带来的数据潮汐、资源弹性及稳定性需求,采用阿里云 EMR Serverless Spark 构建云原生大数据架构,迁移后实现计算加速50%,核心链路产出时间提前1.5h,研发效率和稳定性显著提升!
一文读懂云服务器:工作原理与核心作用
云服务器通过虚拟化与分布式技术,将物理服务器集群转化为按需分配的弹性计算资源,解决资源浪费、降低部署门槛。支撑个人开发、企业运维及AI、直播、政务等千行百业,是数字经济的核心基础设施。
别让大模型“学废了”!从数据清洗到参数调优,一次讲透微调实战
本文深入浅出讲解大模型微调(Fine-tuning):为何需要“岗前培训”,如何通过数据准备、参数调优(如LoRA)、训练监控与效果评估,让通用模型精准适配专业场景。强调“数据质量>数量”“监控胜过猜测”,助力开发者高效落地AI定制化应用。(239字)
想让大模型更懂你?从原理到实践,详解高效微调的全流程
本文深入解析大模型微调中的核心参数调优与显存优化策略,涵盖学习率、训练轮数、批量大小、截断长度、LoRA秩五大关键参数的原理、调参技巧及显存影响,并结合LLaMA-Factory实战演示高效微调全流程,助你低成本、高质地打造专属AI助手。(239字)
传统数据库与向量数据库:一个管“是什么”,一个管“像什么”
向量数据库是AI时代的语义检索引擎,将文本、图片等非结构化数据转化为“语义向量”,支持基于相似性的毫秒级搜索。它不替代MySQL等传统数据库,而是作为大模型的“海马体”,赋能RAG、智能问答与多模态应用,实现从“关键词匹配”到“理解含义”的跃迁。(239字)
Pandas 入门指南
Pandas是Python最核心的数据分析库,基于NumPy构建,提供高效、直观的结构化数据处理能力。其核心数据结构DataFrame(二维表格)和Series(一维序列)支持混合类型、自动索引对齐、缺失值处理与向量化运算,轻松完成清洗、筛选、分组、聚合等任务,是数据获取、分析到建模准备的全流程基石。(239字)
2026 AI Agent 搭建师职业全景指南:从技术基石到商业闭环
2026年,AI职业迎来范式变革,“AI Agent搭建师”取代提示词工程师,成为集架构设计、系统集成与智能协同于一体的“数字流程总设计师”。他们构建具备感知-思考-行动闭环的智能体,推动企业从“聊天机器人”迈向“行动中心”与“数字员工团队”。通过异构模型路由、多智能体编排、MCP工具协议与GraphRAG记忆系统等核心技术,实现业务流程自动化与决策智能化。该职业融合技术、业务与战略,人才缺口巨大,薪酬领先,被誉为AI时代的“黄金职业”,并持续向AI架构师与伦理治理等方向演进。
十、HQL:排序、联合与 CTE 高级查询
Hive 查询不仅能查,还能查得漂亮、高效。我们这次聚焦 HQL 中的高级技巧——从 ORDER BY 到 SORT BY、DISTRIBUTE BY 与 CLUSTER BY,带你理解排序在分布式环境中的执行逻辑;再深入讲解 UNION 与 CTE 等查询组织方式,帮你将复杂 SQL 拆解得更清晰。我还特意写了丰富示例与实战练习,适合正在提升 Hive 查询能力的你阅读、收藏和练习。
Apache Doris + Vane:让多模态数据进入业务分析
客户反馈散落于录音、文字等非结构化数据中,难以关联订单、工单与生产批次。Apache Doris 联合 Vane,将多模态内容智能转为文本、分类与向量,并无缝接入业务数据库,实现“语义检索+业务追溯+批次分析”一站式闭环。(239字)
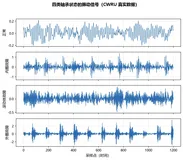
手把手教你:基于深度学习的滚动轴承故障诊断(2026 修订版)
本文是《滚动轴承故障诊断》系列首篇,基于CWRU公开数据集,用Python实现深度学习故障诊断系统,支持正常、内圈、滚动体、外圈四类识别。对比随机森林(73%)、1D-CNN(83%)与CNN+ResNet(95%+),预处理与代码开源,配套公众号“大雾的小屋”免费领取。
阿里云技术栈落地实战:60集方言短剧《等你平安归来》的工程化管线搭建与交付
本文是面向开发团队的AIGC短剧生产SOP,以获奖闽南语短剧《等你平安归来》为案例,详解如何基于阿里云函数计算、百炼大模型、ComfyUI与OSS,构建60集方言短剧管线,攻克角色漂移、声调失准、算力调度三大难题,输出可复用资产标准与商业闭环。(239字)
交流持平律——学科与学说只能持平·拥圣与贬低皆致命膜拜高姿态
BSD Step 325 提出“交流持平律”:交流天然具持平性(位)、对等性(向)、平等性(格),ΔP=0(位格差为零)是其本真条件;学科与学说仅可平等交流,最多持平;膜拜或矮化皆破坏交流、扼杀范式涌现——唯姿态持平、双向对等,方能“平等相撞”催生新范式。(239字)
GEO 服务商技术底座怎么看:自研、监测与可信语料的工程判据
和 GEO 服务商打交道,先要过的不是报价,而是"技术底座是不是真的"。本文从开发者视角给出三条工程判据——算法/模型自研的现场核验、监测数据的真实性、可信语料的实现方式,并附一段可直接运行的语料分级与跨语种一致性校验代码,把"技术强"从一句宣传语变成可核验的清单。本文只谈技术判据,不构成对任何服务商的推荐或评价。
AI 资讯太杂?用 InBrief 固定一个入口
InBrief 是一个固定的 AI 资讯入口:追踪 370+ 个信源,覆盖 RSS、Hacker News、Reddit、X、YouTube 字幕、GitHub Trending 和 Hugging Face 论文榜,每 2 小时更新。它用 SimHash 加 pgvector 做两级去重,减少同一件事被多家媒体反复复述;每条内容配中英双语摘要和重要性评分,分别降低“打开才知道值不值”的成本、决定从哪条开始读。作者还按一手动态、社区讨论等类型说明不同读法,并交代工具边界。
换台电脑、换个 AI它都记得我我总算给 AI 装上了记性
rsrs(Respire)是一款本地优先、端到端加密的AI记忆工具:数据存本地、加密后同步,换设备/换AI仍记得你;支持语义检索、智能去重、因果链整理与一键注入主流AI。三分钟命令行安装,隐私与便利兼得。
LangChain深度解析:模型、链、Agent三大核心,解锁大模型落地的正确姿势
本文系统解析LangChain——大模型应用开发的事实标准框架。从核心架构、Model I/O、RAG检索、Chains编排、Agents智能体到LCEL表达式语言,结合Java/大数据工程师视角,拆解其模块化设计、模型无关性与生产级能力(流式、异步、可观测性),助力高效构建RAG、AI Agent等落地应用。(239字)
Apache Doris 基于 Lance 的向量检索深度解析
Apache Doris 5.0 多模湖仓预告(7)|技术解析篇:随着自动驾驶等多模态应用的发展,大规模数据查询需要同时满足向量检索、条件过滤和业务分析需求。Apache Doris 集成 Lance,支持直接查询 Lance 数据集,并通过并行检索、提前过滤、按需读列和缓存优化提升查询效率。本轮测试中,在 10 亿规模智能驾驶数据的四条件向量检索场景下,Doris + Lance 用时 2.32 秒,相比 Ray + pylance 提升约 10.87 倍。本文将介绍 Doris 与 Lance 的集成机制、查询能力及性能表现。
SensorFlow vs GrowingIO:2026 年如何选择事件分析方案
客观比较 GrowingIO 与 SensorFlow 的产品分析范围、SDK 迁移成本和 ClickHouse 数据所有权,并给出可执行的验证步骤与适用边界。
六大AI引擎引用偏好实测:展会内容如何被豆包与DeepSeek摘录
本文基于2026年5月对豆包、DeepSeek等六大AI引擎的实测,揭示其引用偏好:豆包71%引用国内平台,CSDN独占34%。提出展会行业AI可见性三步法——信息块拆解(数据+结论自洽)、平台公式适配(CSDN重干货、头条重情绪)、月度覆盖检验,助力展会内容进入AI引用库。
开发无货源店群自动化工具:聊聊1688商品详情API核心价值
本文详解1688官方商品详情API如何成为无货源店群ERP的核心数据底座:解决爬虫合规与稳定性难题,提供标准化结构化数据;支撑多平台批量铺货、实时库存价格同步、一件代发履约闭环及智能选品分析,显著降低开发运维成本,保障系统长期稳定运行。(239字)
AI大模型赋能企业跨端远程办公与文件处理:基于 RAG 的权限检索与会议纪要任务化实践
本文探讨AI大模型如何赋能企业跨端远程办公,聚焦RAG技术实现带权限过滤的智能文件检索与会议纪要任务化。强调权限前置过滤、结构化元数据管理及可溯源回答,助力员工“自然语言提问—精准获取—自动转办”,提升知识利用效率与数据安全合规性。
图解强化学习 |手算DQN
摘要:本文系统介绍了深度Q网络(DQN)算法及其改进方案。DQN通过神经网络替代Q表解决高维状态问题,采用经验回放和目标网络提升稳定性,但仍存在Q值高估等局限性。文章详细解析了DQN网络结构(4维输入→2维动作Q值输出)、基于时序差分的更新流程(含经验回放采样与双网络协同机制),并通过矩阵示例演示MSELoss计算过程。进一步探讨两种改进算法:DoubleDQN通过解耦动作选择与价值评估缓解过估计问题;DuelingDQN则创新性地拆分状态价值V与动作优势A分支,提升学习效率。二者均保持DQN基础框架,分别
从理论突破到全面应用——迈向通用智能的深度观察
本报告由灵砚智能发布,系统梳理AI从深度学习到通用智能的技术演进,剖析大模型、多模态、智能体等突破;评估其在医疗、金融、制造等行业的深度应用;并直面算力、数据、伦理与全球治理挑战,提供前瞻性的社会适应路径。(239字)
深度回顾 | 阿里云携手 Elastic 定义 Agent 时代搜索新范式,解锁 Search AI 核心生产力
阿里云Elasticsearch升级为Agent Native搜索底座,推出Agentic Search、知识记忆湖、FalconSeek引擎及Hybrid Retrieval 2.0,实现面向AI智能体的毫秒级上下文检索,支持千亿级数据降本40%-70%,助力企业构建稳定、智能、低成本的下一代AI搜索基础设施。
演化计算与抽样方法构造新算法流程:从 AlphaEvolve 看 LLM × EA 融合范式
本文系统解析AlphaEvolve——Google DeepMind提出的LLM×EA融合新范式:以语义引导的抽样机制、双模型协同进化(Gemini Flash+Pro)、自动评估闭环,实现算法的自主发现与优化,已突破矩阵乘法纪录并提升训练效率。(239字)
1949AI轻量化AI自动化:定时任务浏览器自动化+数据分发代码实战
基于1949AI轻量化理念,本工具以Python实现浏览器自动化采集、本地存储与飞书/邮箱双通道通知,全程无云依赖、低资源占用、安全合规,适配个人开发者及小型团队的轻量工程化需求。(239字)
1688图片搜索API(拍立淘)实操指南
1688图片搜索API(拍立淘/以图搜货)是官方图像搜品接口,支持图片URL或Base64输入,秒级返回同款/相似商品ID、标题、价格等结构化数据,精准高效,适用于反向海淘、供应链寻源、比价选品等场景。

AI 术语满天飞?90% 的人只懂名词,不懂为什么!
本文不堆砌概念,只讲前因后果:从大模型底层逻辑,到 Context、RAG、Function Calling、MCP、Skills 的核心关联,拆解所有面试高频考点,让你告别 “名词解释”,吃透原理,面试直接碾压面试官!
MySQL 项目实战入门:从 0 到 1 搭建电商数据库
本文以电商系统为实战场景,从环境搭建、需求分析入手,详解MySQL数据库的表结构设计、SQL编写、关联查询及性能优化,帮助初学者掌握从零构建完整数据库项目的全流程,提升实操能力。
详解RAG五种分块策略,技术原理、优劣对比与场景选型之道
RAG通过检索与生成结合,提升大模型在企业场景的准确性与安全性。分块策略是其核心,直接影响检索效果与生成质量。本文系统解析五种主流分块方法:固定大小、语义、递归、基于结构和基于LLM的分块,对比其优缺点及适用场景,助力构建高效、可信的RAG系统,尤其适用于金融、医疗等高精度领域。(239字)

在 OpenAI 打造流处理平台:超大规模实时计算的实践与思考
本文介绍OpenAI构建流处理平台的实践与挑战。面对Kafka高可用、Python生态兼容、云环境限制等问题,团队基于PyFlink打造跨区域流处理架构,集成Kafka HA组、自研代理与控制平面,支撑实时Embedding生成、特征计算等场景,并推动开源协作与平台自动化演进。
打破 IK 分词“架构陷阱”——阿里云 ES Serverless 索引级词典的完美热更新实践
本文将通过一个真实事故的复盘,解析开源 IK 分词器架构设计中的不足,并介绍阿里云 ES Serverless 如何通过“索引级词典”能力,彻底解决热更新引发的搜索错配问题。

活动报名 | Apache Spark Meetup · 上海站,助力企业构建高效数据平台
2025年12月20日,上海 · 阿里巴巴徐汇滨江园区,Apache Spark Meetup 助力企业构建高效数据平台,欢迎报名!

大数据与机器学习
大数据领域前沿技术分享与交流,这里不止有技术干货、学习心得、企业实践、社区活动,还有未来。

