年度回顾 | 2019 年的 Apache Flink(文末有福利) | 12月31号云栖号夜读

简介: 2019 年即将落下帷幕,这一年对于 Apache Flink 来说是非常精彩的一年,里程碑式的一年。随着这一年在邮件列表发送了超过 1 万封邮件,JIRA 中超过 4 千个 tickets,以及 GitHub 上超过 3 千个 PR,Apache Flink 迎来了快速的发展。

点击订阅云栖夜读日刊,专业的技术干货,不容错过!

阿里专家原创好文

1.年度回顾 | 2019 年的 Apache Flink(文末有福利)

2019 年即将落下帷幕,这一年对于 Apache Flink 来说是非常精彩的一年,里程碑式的一年。随着这一年在邮件列表发送了超过 1 万封邮件,JIRA 中超过 4 千个 tickets,以及 GitHub 上超过 3 千个 PR,Apache Flink 迎来了快速的发展。本文笔者将带大家一起回顾下 Flink 所经过的 2019 年,感受 Flink 蓬勃发展的同时,我们也将展望 2020 年。阅读更多》》

2.当达摩院大牛学会抠图,这一切都不受控制了……

在外界人眼中,达摩院人才济济,大多是奇人异士,做着神秘且高端的研究,有如扫地僧一般的存在,但是如果有一天,当神秘专家不再神秘,你发现他们也开始玩抠图,且这一切都朝着不受控制的方向发展了的时候,那么抠图他们能玩出哪些花样?阅读更多》》

3.开发者说:如何使用插件降低上传文件部署服务的复杂度

一篇干货好文,值得一读!阅读更多》》

4.Flutter嵌套深?扩展函数了解一下

本文介绍了Flutter中的嵌套地狱,并使用扩展函数的方式来解决flutter的嵌套地狱问题。由于大篇幅的扩展函数调用会影响代码阅读体验,还是需要保留部分关键嵌套层级结构以使得布局的层级结构保持清晰,文中的扩展函数支持与构造函数混用,具体使用到什么程度,就看大家自己的选择了阅读更多》》

5.IDE 插件新版本发布,总有一个功能帮到你——开发部署提速 8 倍

对于开发者而言,提高工作效率大概有 2 种主要方式,第一种方式就是加快自己的工作速度,争取在同一段时间内多码一些代码、多干一些活来实现多产;而聪明的开发者会选择第二种方式,就是通过插件,让一些重复性的、繁琐性的工作被自动化,从而节省出时间来做一些实质性的业务,达到轻松又高效的工作步调。最近通过发布会直播,了解到一款本地 IDE 插件——Cloud Toolkit,就是通过第二种方式来提高开发者的工作效率。阅读更多》》

视频课程及PPT下载

1.【云吞铺子】RDS for MySQL CPU性能问题分析(一)
《云吞铺子——故障排查案例精选》第5期如期而至!当您在使用RDS for MySQL 的实例过程中,遇到CPU使用率100%或者过高的情况应该如何处理?本期我们跟随阿里云高级技术专家田杰聚焦数据库类问题经典案例,大牛出品,必属精品!
视频地址:https://yq.aliyun.com/live/1108

2.【云吞铺子】RDS for MySQL CPU性能问题分析(二)
《云吞铺子——故障排查案例精选》第6期重磅更新!本期我们继续跟随阿里云高级技术专家田杰聚焦 RDS for MySQL CPU 性能问题分析。数据库经典案例,不可错过!
视频地址:https://yq.aliyun.com/live/1121

3.【云吞铺子】RDS for MySQL CPU性能问题分析(三)
《云吞铺子-故障排查案例精选》第7期如期更新!本期是《RDS for MySQL CPU 性能问题分析》的终极篇,我们一起跟随阿里云高级技术专家田杰聚焦数据库经典案例。大牛出品,必属精品!
视频地址:https://yq.aliyun.com/live/1144

更多精彩直播

往期精彩回顾

未来,仅凭几个前端工程师,就能 hold 住一家企业吗? | 12月30号云栖号夜读(https://yq.aliyun.com/articles/740899)

更多干货内容 请关注阿里云云栖号公众号!

C5AD0950_C5CE_4EAE_BE76_909C90E0DA75

相关实践学习
基于Hologres+Flink搭建GitHub实时数据大屏
通过使用Flink、Hologres构建实时数仓,并通过Hologres对接BI分析工具(以DataV为例),实现海量数据实时分析.
实时计算 Flink 实战课程
如何使用实时计算 Flink 搞定数据处理难题?实时计算 Flink 极客训练营产品、技术专家齐上阵,从开源 Flink功能介绍到实时计算 Flink 优势详解,现场实操,5天即可上手! 欢迎开通实时计算 Flink 版: https://cn.aliyun.com/product/bigdata/sc Flink Forward Asia 介绍: Flink Forward 是由 Apache 官方授权,Apache Flink Community China 支持的会议,通过参会不仅可以了解到 Flink 社区的最新动态和发展计划,还可以了解到国内外一线大厂围绕 Flink 生态的生产实践经验,是 Flink 开发者和使用者不可错过的盛会。 去年经过品牌升级后的 Flink Forward Asia 吸引了超过2000人线下参与,一举成为国内最大的 Apache 顶级项目会议。结合2020年的特殊情况,Flink Forward Asia 2020 将在12月26日以线上峰会的形式与大家见面。
目录
相关文章
|
12月前
|
人工智能 数据处理 API
阿里云、Ververica、Confluent 与 LinkedIn 携手推进流式创新,共筑基于 Apache Flink Agents 的智能体 AI 未来
Apache Flink Agents 是由阿里云、Ververica、Confluent 与 LinkedIn 联合推出的开源子项目,旨在基于 Flink 构建可扩展、事件驱动的生产级 AI 智能体框架,实现数据与智能的实时融合。
1698 6
阿里云、Ververica、Confluent 与 LinkedIn 携手推进流式创新,共筑基于 Apache Flink Agents 的智能体 AI 未来
|
存储 Cloud Native 数据处理
从嵌入式状态管理到云原生架构:Apache Flink 的演进与下一代增量计算范式
本文整理自阿里云资深技术专家、Apache Flink PMC 成员梅源在 Flink Forward Asia 新加坡 2025上的分享,深入解析 Flink 状态管理系统的发展历程,从核心设计到 Flink 2.0 存算分离架构,并展望未来基于流批一体的通用增量计算方向。
818 0
从嵌入式状态管理到云原生架构:Apache Flink 的演进与下一代增量计算范式
|
SQL 人工智能 数据挖掘
Apache Flink:从实时数据分析到实时AI
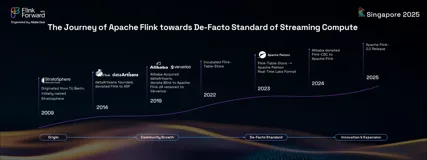
Apache Flink 是实时数据处理领域的核心技术,历经十年发展,已从学术项目成长为实时计算的事实标准。它在现代数据架构中发挥着关键作用,支持实时数据分析、湖仓集成及实时 AI 应用。随着 Flink 2.0 的发布,其在流式湖仓、AI 驱动决策等方面展现出强大潜力,正推动企业迈向智能化、实时化的新阶段。
1380 9
Apache Flink:从实时数据分析到实时AI
|
SQL 人工智能 API
Apache Flink 2.1.0: 面向实时 Data + AI 全面升级,开启智能流处理新纪元
Apache Flink 2.1.0 正式发布,标志着实时数据处理引擎向统一 Data + AI 平台迈进。新版本强化了实时 AI 能力,支持通过 Flink SQL 和 Table API 创建及调用 AI 模型,新增 Model DDL、ML_PREDICT 表值函数等功能,实现端到端的实时 AI 工作流。同时增强了 Flink SQL 的流处理能力,引入 Process Table Functions(PTFs)、Variant 数据类型,优化流式 Join 及状态管理,显著提升作业稳定性与资源利用率。
1060 0
|
人工智能 运维 Java
Flink Agents:基于Apache Flink的事件驱动AI智能体框架
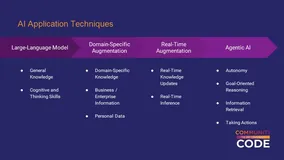
本文基于Apache Flink PMC成员宋辛童在Community Over Code Asia 2025的演讲,深入解析Flink Agents项目的技术背景、架构设计与应用场景。该项目聚焦事件驱动型AI智能体,结合Flink的实时处理能力,推动AI在工业场景中的工程化落地,涵盖智能运维、直播分析等典型应用,展现其在AI发展第四层次——智能体AI中的重要意义。
3767 27
Flink Agents:基于Apache Flink的事件驱动AI智能体框架
|
存储 人工智能 数据处理
对话王峰:Apache Flink 在 AI 时代的“剑锋”所向
Flink 2.0 架构升级实现存算分离,迈向彻底云原生化,支持更大规模状态管理、提升资源效率、增强容灾能力。通过流批一体与 AI 场景融合,推动实时计算向智能化演进。生态项目如 Paimon、Fluss 和 Flink CDC 构建湖流一体架构,实现分钟级时效性与低成本平衡。未来,Flink 将深化 AI Agents 框架,引领事件驱动的智能数据处理新方向。
1233 6
|
消息中间件 存储 Kafka
Apache Flink错误处理实战手册:2年生产环境调试经验总结
本文由 Ververica 客户成功经理 Naci Simsek 撰写,基于其在多个行业 Flink 项目中的实战经验,总结了 Apache Flink 生产环境中常见的三大典型问题及其解决方案。内容涵盖 Kafka 连接器迁移导致的状态管理问题、任务槽负载不均问题以及 Kryo 序列化引发的性能陷阱,旨在帮助企业开发者避免常见误区,提升实时流处理系统的稳定性与性能。
989 0
Apache Flink错误处理实战手册:2年生产环境调试经验总结
|
SQL 消息中间件 分布式计算
《Apache Flink 案例集(2022版)》——5.数字化转型——移动云Apache Flink 在移动云实时计算的实践(上)
662 0
|
数据采集 分布式计算 Kubernetes
《Apache Flink 案例集(2022版)》——5.数字化转型——移动云Apache Flink 在移动云实时计算的实践(下)
642 0
|
存储 SQL 传感器
【Flink】(04)Apache Flink 漫谈系列 —— 实时计算 Flink 与 Alibaba Cloud Realtime Compute 剖析2
1135 0
【Flink】(04)Apache Flink 漫谈系列 —— 实时计算 Flink 与 Alibaba Cloud Realtime Compute 剖析2

推荐镜像

更多