Spark入门到精通视频学习资料--第二章:Spark生态系统介绍,Spark整体概述与Spark编程模型(2讲)

简介: 概述什么是Spark◆ Spark是UC Berkeley AMP lab所开源的类Hadoop MapReduce的通用的并行计算框架,Spark基于map reduce算法实现的分布式计算,拥有Hadoop MapReduce所具有的优点;但不同于MapReduce的是Job中间输出和结果可以保存在内存中,从而不再需要读写HDFS,因此Spark能更好地适用于数据挖掘与机器学习等需要迭代的map reduce的算法。

概述

什么是Spark

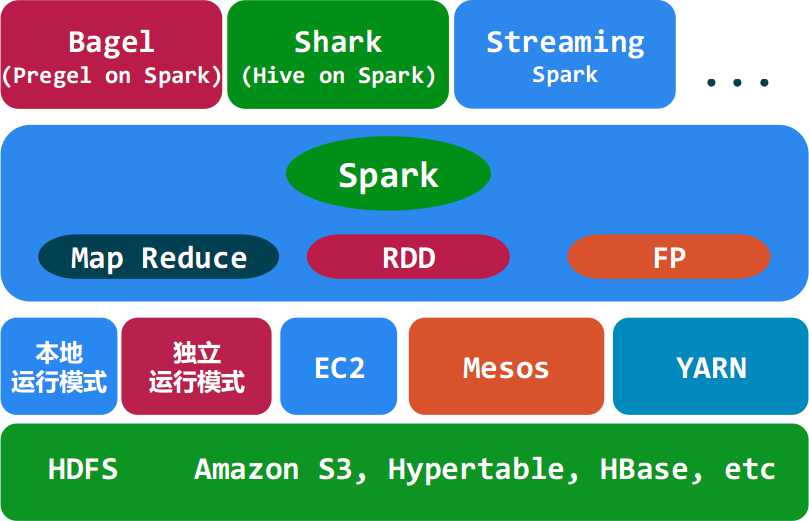
◆ Spark是UC Berkeley AMP lab所开源的类Hadoop MapReduce的通用的并行计算框架,Spark基于map reduce算法实现的分布式计算,拥有Hadoop MapReduce所具有的优点;但不同于MapReduce的是Job中间输出和结果可以保存在内存中,从而不再需要读写HDFS,因此Spark能更好地适用于数据挖掘与机器学习等需要迭代的map reduce的算法。其架构如下图所示:
 

Spark的适用场景

◆ Spark是基于内存的迭代计算框架,适用于需要多次操作特定数据集的应用场合。需要反复操作的次数越多,所需读取的数据量越大,受益越大,数据量小但是计算密集度较大的场合,受益就相对较小

◆ 由于RDD的特性,Spark不适用那种异步细粒度更新状态的应用,例如web服务的存储或者是增量的web爬虫和索引。就是对于那种增量修改的应用模型不适合。

◆ 总的来说Spark的适用面比较广泛且比较通用。


详细内容请参考视频:

Spark概述与编程模型(上)      http://pan.baidu.com/s/1kT9okBl

Spark概述与编程模型(下)      http://pan.baidu.com/s/16OEjc


另外给个相关的PDF文件供参考:

Spark概述与编程模型.pdf                http://pan.baidu.com/s/1mg64rMw


==========================================================

申明:视频资料已过期,建议不要再下载了。

==========================================================


目录
相关文章
|
分布式计算 运维 搜索推荐
立马耀:通过阿里云 Serverless Spark 和 Milvus 构建高效向量检索系统,驱动个性化推荐业务
蝉妈妈旗下蝉选通过迁移到阿里云 Serverless Spark 及 Milvus,解决传统架构性能瓶颈与运维复杂性问题。新方案实现离线任务耗时减少40%、失败率降80%,Milvus 向量检索成本降低75%,支持更大规模数据处理,查询响应提速。
860 57
|
分布式计算 大数据 Java
大数据-87 Spark 集群 案例学习 Spark Scala 案例 手写计算圆周率、计算共同好友
361 5
|
存储 缓存 分布式计算
大数据-83 Spark 集群 RDD编程简介 RDD特点 Spark编程模型介绍
387 4
|
分布式计算 关系型数据库 MySQL
大数据-88 Spark 集群 案例学习 Spark Scala 案例 SuperWordCount 计算结果数据写入MySQL
291 3
|
12月前
|
分布式计算 Kubernetes 调度
Kubeflow-Spark-Operator-架构学习指南
本指南系统解析 Spark Operator 架构,涵盖 Kubebuilder 开发、控制器设计与云原生集成。通过四阶段学习路径,助你从部署到贡献,掌握 Kubernetes Operator 核心原理与实战技能。
668 0
|
机器学习/深度学习 人工智能 自然语言处理
3 秒音频也能克隆?拆解 Spark-TTS 架构的极致小样本学习
本文深入解析了 Spark-TTS 模型的架构与原理,该模型仅需 3 秒语音样本即可实现高质量的零样本语音克隆。其核心创新在于 BiCodec 单流语音编码架构,将语音信号分解为语义 Token 和全局 Token,实现内容与音色解耦。结合大型语言模型(如 Qwen 2.5),Spark-TTS 能直接生成语义 Token 并还原波形,简化推理流程。实验表明,它不仅能克隆音色、语速和语调,还支持跨语言朗读及情感调整。尽管面临相似度提升、样本鲁棒性等挑战,但其技术突破为定制化 AI 声音提供了全新可能。
1204 35
|
存储 分布式计算 算法
大数据-106 Spark Graph X 计算学习 案例:1图的基本计算、2连通图算法、3寻找相同的用户
542 0
|
分布式计算 Java 开发工具
阿里云MaxCompute-XGBoost on Spark 极限梯度提升算法的分布式训练与模型持久化oss的实现与代码浅析
本文介绍了XGBoost在MaxCompute+OSS架构下模型持久化遇到的问题及其解决方案。首先简要介绍了XGBoost的特点和应用场景,随后详细描述了客户在将XGBoost on Spark任务从HDFS迁移到OSS时遇到的异常情况。通过分析异常堆栈和源代码,发现使用的`nativeBooster.saveModel`方法不支持OSS路径,而使用`write.overwrite().save`方法则能成功保存模型。最后提供了完整的Scala代码示例、Maven配置和提交命令,帮助用户顺利迁移模型存储路径。
1058 1
|
分布式计算 算法 Spark
spark学习之 GraphX—预测社交圈子
572 0
|
分布式计算 Scala Spark
educoder的spark算子学习
educoder的spark算子学习
371 0