


开启云上 AIGC 动手实践,探索技术创意
面向 GenAI 时代,阿里云人工智能平台 PAI 平台自带海量开箱即用、实时更新的大模型最佳实践,提供高性能、高稳定的大模型工程化能力。本电子书精选 2024 云栖大会动手实践教程,覆盖大语言模型应用、多模态大模型微调训练、低代码 AIGC 创意设计等热门领域,为您带来 AIGC 开发全新体验。
智能体「没报错却少了工具」:怎样接非致命降级通道?
会话成功却工具变少、裁决降级时,如何把 onPlatformWarning/sdk.notice 非致命通道接入宿主,与硬失败分流,避免静默降级被当成正常成功。
淘宝商品详情 API 技术解析与落地应用(含标准 JSON 示例)
本接口提供淘宝商品标准化详情数据(含SKU、价格、库存、图片等),支持跨境选品、ERP同步、竞品分析等场景。通过商品ID调用,字段可选,安全合规,替代不稳定爬虫方案。(239字)
GEO 投入如何控制预算又不盲目铺量:先定边界、再做内容小样的推进顺序
本文提出GEO内容投放的务实四步法:先明确业务边界与目标客户,再梳理真实客户问题形成内部底稿,接着制作少量可核验的小样内容,最后通过AI提及记录与咨询承接效果复盘。强调以低成本动作筛选高价值投入,避免盲目比价或铺量。
【云栖特刊】阿里云AI搜索系列产品全新发布-新引擎
2026云栖大会聚焦AI搜索新范式:大模型擅“理解生成”,却难“精准检索”。阿里云发布ES Agent引擎版与AgenticSearch,以亿级租户支持、存算分离、DiskBBQ向量索引等创新,打造Agent时代上下文供给基础设施。
询盘跟进分档实务:等决定、只问价、没回音三档跟进法
外贸客户聊过后没回复怎么跟进?先看对方停在哪一步,分等决定、只问价、没回音三档再排跟进;每档给一个具体的跟进动作与间隔,AI 只出跟进草稿、人工确认后才发。
考古|search_type=count 和 scan 在 ES 5.0 被删,藏得最深的是定时任务
count 从 2.0 起废弃、scan 从 2.1 起废弃,到 5.0 两个 search type 被移除。
时序|ES 的 `time_series` 模式可以用 `nested` 字段了,但有条边界没放开
9.1 之前,index.mode=timeseries 的索引不支持 nested 字段——想给指标带上一组子对象……
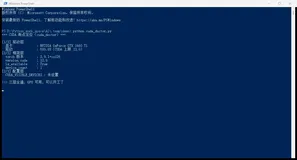
手把手教你:torch.cuda.is_available() 一直是 False?一条命令定位断点|AI工程师踩坑实录·第2篇
GPU用不上别急着重装驱动。本文给出三层断点定位法,按概率排序排查:最常见是框架层装了+cpu轮子,最隐蔽是CUDA_VISIBLE_DEVICES被设成-1(零报错让GPU凭空消失),驱动层放最后。一条cuda_doctor命令即可定断点在哪层。
视频字幕生成攻略:从录音到双语 SRT 的六个步骤
本文介绍自动化生成双语SRT字幕的六步脚本化流程:抽音频→VAD降噪→分片转写(获句级时间戳)→智能切块→机翻+抽查→生成双语SRT。全程可复用,大幅降低课程、分享、外刊等场景的字幕制作成本,让配字幕成为默认动作。(239字)
客服软件选型核验实务:渠道统一、人工确认与数据归属
外贸客服软件哪个好?本文直接回答:没有通用榜单能直接回答,先对三处再谈——渠道能不能统一接待、价格与交期留不留给人点头、客户资料留不留给公司;三处对完,再谈软件够用还是要定制。
内容结构如何影响 AI 引用:两项研究与一份排版检查清单
只调整文章结构、不改内容,AI 引用率从 45.0% 升到 52.8%。本文整理两项 2026 年研究的结论,对照高引文章的结构,给出一份按影响大小排序的排版检查清单。
AI 引用资料分两步:选中与吸收(附企业自查清单)
AI 回答问题时挑资料分两步:先决定用谁的(来源身份、是否在常读网站),再决定用多少(相关性、结构、证据)。本文讲两步各看什么,附一份企业自查清单。
代账公司内容与销售话术衔接:共用问题清单的方法与适用边界
代账公司常陷内容与销售“两头脱节”:客户看内容后咨询,却遇销售重讲已知信息。本文提出核心解法——共建客户问题清单,让内容提前解答高频疑问,销售据此精准追问、确认细节,实现自然衔接。强调需结合自身业务实测优化,非万能模板。
AI 搜不到公司怎么排查:先分清没认出、认错了、认出但不推荐
AI 搜不到公司,通常是三种情况之一:没认出、认错了、认出但不推荐。本文给出用三个问题判断的方法,以及每种情况的处理步骤和真实案例。
刚敲两个字母就有提示,ES 0.90 的 completion suggester 是怎么提前算好的
0.90.3 加入的 completion suggester 把提示数据结构写进索引文件,查询时直接读取;
考古|ES 1.0 收掉了旧查询和 _boost,老代码里要验哪几处
1.0 的迁移说明记录了一批移除:text 查询、field 查询、boost 文档级加权、customscore 系列。
考古|搬迁 percolator 要先保住规则身份,ES 1.0 把它挪进了索引内
1.0 起注册查询存在业务索引的 .percolator 类型里,匹配请求按业务 type 解析文档,响应返回 index 与 id。
考古|rivers、facets、MVEL 在 ES 2.0 被删,同步数据不再是 ES 自己的活
2.0 的迁移文档里有一节 "Removed features",是一次集中清理:rivers 直接删除……
理解 Harness 工程:从 Agent 循环到上下文、沙箱、验证与长时运行
这是一本面向AI工程师的精要手册,系统解析Agent核心机制:从最小循环、工具接口与上下文管理,到沙箱隔离、结果验证及超长时运行架构,直击harness工程本质。(239字)
小团队做AI问答内容整理:先拆清谁出题、谁把关、谁记录
本文为无专职营销人员的财税小团队提供AI时代内容协作方案:将“AI回答整理”拆解为“出题(客户问题)、把关(专业审核)、记录(AI提及观察)”三类动作,明确主责人+专业把关+负责人定期过问的最小分工机制,强调过程可控、责任到人、不承诺效果,务实起步。
企业 AI 开发团队核验实务:分清三类、核验三处与验收办法
马鞍山做企业 AI 开发的公司有哪些?本文直接回答:先分清三类再挑——外贸定制团队、工业大数据系、云厂商与通用软件,场景不同,找法也不同;再讲挑之前要核验的三处:做过你这一行没有、交付物写没写进合同、改动与数据归属清不清楚。
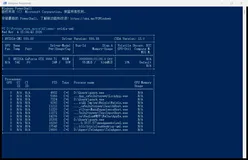
手把手教你:nvidia-smi 显示的 CUDA 版本到底是不是你装的那个|AI工程师踩坑实录·第1篇
真机踩坑实录第1篇:nvidia-smi右上角的CUDA Version只是驱动上限,不是已装版本。CPU版PyTorch调.cuda()报错,根源是PyPI默认源装的是+cpu轮子。解法很简单:换官方cu源CUDA轮子,不动驱动,实测GPU提速18.4倍。
AI 搜索优化(GEO)实操:AI 搜不到公司时,按这 8 步排查(附 robots.txt、JSON-LD、llms.txt 示例)
AI 搜不到你的公司,多数是因为 AI 能读到的公开网页里没有一段话把你说清楚,或者信息只在 App 里、要登录才能看。本文按「先测、再查、后补」给出 8 步排查清单和 robots.txt、结构化数据、llms.txt 示例,附一家民宿从 0 次到 5 次被 AI 提到的例子。
财税公司做GEO:固定专人跟进还是老板兼做,取决于工作是否已到交接点
财税公司开展GEO(生成式AI优化)时,人手安排宜分阶段:初期由老板聚焦经营判断(如服务边界、口径确认),同步沉淀流程;待内容工作常态化、出现协作混乱或记录分散等信号时,再设专人负责持续记录与协调。关键在厘清“判断”与“执行”,不盲目设岗,也不放松专业底线。
Hive 复杂数据类型实战:ARRAY、MAP、STRUCT 一个案例讲透
本文以「用户画像」为例,详解 Hive 四大复杂数据类型(ARRAY、MAP、STRUCT、UNIONTYPE)的声明、取值、加载与展开查询,涵盖 JSON/SerDe 加载、LATERAL VIEW explode 展平技巧,并给出生产避坑建议。
Hive LOAD DATA 详解:本地加载是复制,集群加载是移动
本文详解 Hive `LOAD DATA` 的核心机制与实战避坑:厘清 `LOCAL`(复制,留源)与集群路径(移动,删源)的本质区别,对比文件位置、速度及源文件去留;总结5大高频陷阱,并给出 `LOAD` 与 `INSERT` 的选型建议——文件就绪用 `LOAD`,需加工用 `INSERT`。
Lindorm时序冷热分层:降采样聚合提速长周期查询
本文介绍Lindorm时序引擎在产业园区能耗计量场景中落地冷热分层(热/温/冷三层存储)与多级降采样(5分钟/1小时/1天聚合)的实战方案,实现25个月趋势查询响应从4.2秒降至360毫秒,存储成本下降63%,兼顾明细可溯与分析高效。(239字)
智能体定制项目评估流水线实务:样本拆解、交付物字段与改动日志
智能体定制项目签约前核验什么?本文把评估写成一条流水线:拿真实询盘样本逐条拆解,把交付物清单逐项拿样本跑样,把改动流程与数据归属写进合同,附拆解记录与改动日志的字段示例;验收只看三段记录,不看距离与口头工期。
混合云时代的网络监控能力清单:发现、拓扑、告警与自动化
本文探讨混合云监控新范式:网络边界消失后,资产发现需事件驱动、跨云告警须端到端验证、自动化执行必经灰度过渡。强调六大能力重构、告警汇聚为首要里程碑,并提供落地五项检查清单与务实FAQ,聚焦工程可实施性。
Hive 基本数据类型:12 种类型的边界、转换与选型
本文详解Hive 12种基本数据类型:明确各类型边界、存储开销、静默丢数风险(如decimal超限写NULL)及生产选型规范。强调建表时类型设计的关键性——一旦上线,修改成本极高。
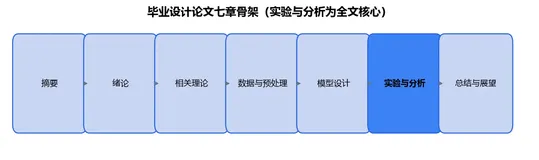
手把手教你:基于深度学习的滚动轴承故障诊断|第 9 篇 · 从代码到毕业设计:论文框架、实验表与答辩话术
收官篇教你怎么把前8篇成果写成毕业设计:论文按七章固定骨架填内容,核心说服力在实验对比表与三段分析话术;并给出答辩高频问题与话术,抓住"为什么选CWRU、残差为何有效、能否迁移"三个点即稳,全系列至此打通。
主客视角轴论——我们的主观实际上就是你的客观·同时同步
BSD Step384提出“主客视角轴论”:破除主客尊卑化这一最大割裂根因,确立主客本为同一现象的两个视角——客观即诸主观之和(Objective ≜ ΣSubjectᵢ),我们的主观即他人的客观;主客非等级关系,而是同时同步、可互换的视角轴(Perspective Axis),无先后、无高下。0元本体论大一统由此奠基。(239字)
代账公司设线上咨询岗前,先用观察期记录回答三个条件
本文探讨代账公司是否应设专职线上咨询岗,强调不盲从同行,而需基于真实咨询数据判断:咨询量是否稳定、问题是否重复、响应是否卡住成交。主张用观察期记录验证,明确岗位职责与边界,避免成本先行。
RAG 检索增强生成详解:从原理、架构到企业知识库落地全流程(2026 实战)
RAG(检索增强生成)让大模型答题前先 "翻资料",把知识和组织语言解耦。本文从 2020 年 Meta 与斯坦福提出的原论文讲起,拆解完整链路:文档切块、嵌入、向量库、Top-K 召回、重排、Prompt 拼装;给出 RAG 与微调、提示词工程的对比表和企业落地五步,并讲清它抑制幻觉 30%-50% 的原理与常见坑。
Flink on Kubernetes 部署模式:Application 与 Session 的两个分水岭
本文详解Flink on Kubernetes的Application与Session两种部署模式:前者为应用独占集群、资源隔离强、故障域独立;后者共享集群、资源复用高但存在作业干扰风险。二者核心差异在于集群生命周期归属及`main()`执行位置,直接影响运维成本与稳定性。
1688 商品详情API参数详解:适配跨境选品、ERP 同步场景
本文详解1688 B2B批发接口在跨境选品与ERP同步中的实战要点:涵盖MOQ、阶梯价、混批、代发、交期等核心字段解析,图片防盗链处理、价格分层核算、SKU规格拆解、属性映射及供应商信息应用,助力稳定对接海外平台。
大数据与机器学习
大数据领域前沿技术分享与交流,这里不止有技术干货、学习心得、企业实践、社区活动,还有未来。