从零到一:淘宝店铺订单API接入全流程指南
淘宝订单API通过订单号获取完整交易数据,支持实时查询买家信息、商品明细及物流状态,适用于订单同步、物流监控与数据分析。采用RESTful设计,JSON格式响应,安全高效,助力电商自动化运营。
【机器学习算法篇】K-近邻算法
K近邻(KNN)是一种基于“物以类聚”思想的监督学习算法,通过计算样本间距离,选取最近K个邻居投票决定类别。支持多种距离度量,如欧式、曼哈顿、余弦相似度等,适用于分类与回归任务。结合Scikit-learn可高效实现,需合理选择K值并进行数据预处理,常用于鸢尾花分类等经典案例。(238字)
阿里云、Ververica、Confluent 与 LinkedIn 携手推进流式创新,共筑基于 Apache Flink Agents 的智能体 AI 未来
Apache Flink Agents 是由阿里云、Ververica、Confluent 与 LinkedIn 联合推出的开源子项目,旨在基于 Flink 构建可扩展、事件驱动的生产级 AI 智能体框架,实现数据与智能的实时融合。

高效获取淘宝商品详情:API 开发实现链接解析的完整技术方案
2025反向海淘新机遇:依托代购系统,聚焦小众垂直品类,结合Pandabay数据选品,降本增效。系统实现智能翻译、支付风控、物流优化,助力中式养生茶等品类利润翻倍,新手也能快速入局全球市场。
三、Sqoop 全量导入核心命令
在大数据处理过程中,数据库表怎么高效导入到 Hadoop?这一篇我带大家实战讲解 Sqoop 全量导入 的用法,从基础命令到常用参数配置,再到导入到 HDFS、Hive 的各种格式案例,配合实操示例,帮你一步步掌握全量导入技巧。最后还有练习题,供大家动手巩固一下。
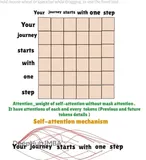
Transformer自回归关键技术:掩码注意力原理与PyTorch完整实现
掩码注意力是生成模型的核心,通过上三角掩码限制模型仅关注当前及之前token,确保自回归因果性。相比BERT的双向注意力,它实现单向生成,是GPT等模型逐词预测的关键机制,核心仅需一步`masked_fill_`操作。
【逆向】Python 调用 JS 代码实战:使用 pyexecjs 与 Node.js 无缝衔接
本文介绍了如何使用 Python 的轻量级库 `pyexecjs` 调用 JavaScript 代码,并结合 Node.js 实现完整的执行流程。内容涵盖环境搭建、基本使用、常见问题解决方案及爬虫逆向分析中的实战技巧,帮助开发者在 Python 中高效处理 JS 逻辑。
【赵渝强老师】阿里云大数据MaxCompute的体系架构
阿里云MaxCompute是快速、全托管的EB级数据仓库解决方案,适用于离线计算场景。它由计算与存储层、逻辑层、接入层和客户端四部分组成,支持多种计算任务的统一调度与管理。
requirement.txt 管理python包依赖
在 Python 项目中,`requirements.txt` 用于记录依赖库及其版本,便于环境复现。本文介绍了多种生成该文件的方法:基础方法使用 `pip freeze`,进阶方法使用 `pipreqs`,专业方法使用 `poetry` 或 `pipenv`,以及手动维护方式。每种方法适用不同场景,涵盖从简单导出到复杂依赖管理,并提供常见问题的解决方案,帮助开发者高效生成精准的依赖列表,确保项目环境一致性。
Java 学习路线 35 掌握 List 集合从入门到精通的 List 集合核心知识
本文详细解析Java中List集合的原理、常用实现类(如ArrayList、LinkedList)、核心方法及遍历方式,并结合数据去重、排序等实际应用场景,帮助开发者掌握List在不同业务场景下的高效使用,提升Java编程能力。
Post-Training on PAI (4):模型微调SFT、DPO、GRPO
阿里云人工智能平台 PAI 提供了完整的模型微调产品能力,支持 监督微调(SFT)、偏好对齐(DPO)、强化学习微调(GRPO) 等业界常用模型微调训练方式。根据客户需求及代码能力层级,分别提供了 PAI-Model Gallery 一键微调、PAI-DSW Notebook 编程微调、PAI-DLC 容器化任务微调的全套产品功能。
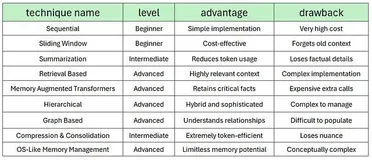
AI代理内存消耗过大?9种优化策略对比分析
在AI代理系统中,多代理协作虽能提升整体准确性,但真正决定性能的关键因素之一是**内存管理**。随着对话深度和长度的增加,内存消耗呈指数级增长,主要源于历史上下文、工具调用记录、数据库查询结果等组件的持续积累。本文深入探讨了从基础到高级的九种内存优化技术,涵盖顺序存储、滑动窗口、摘要型内存、基于检索的系统、内存增强变换器、分层优化、图形化记忆网络、压缩整合策略以及类操作系统内存管理。通过统一框架下的代码实现与性能评估,分析了每种技术的适用场景与局限性,为构建高效、可扩展的AI代理系统提供了系统性的优化路径和技术参考。
“乐高式”大屏应用构建!业务全景一键聚合
还在为多业务数据分散烦恼?DataV 7.0 全新推出「大屏嵌入」功能,无需重复开发!像搭乐高一样,将销售看板、物流监控、用户画像等子屏自由嵌入主屏,构建跨部门、跨业务的全景智能作战系统!老板要的“一张图”数据,分分钟搞定!
AI 搜索 MCP 最佳实践
本文介绍了如何通过 MCP 协议,快速调用阿里云 OpenSearch 、ElasticSearch 等工具,帮助企业快速集成工具链、降低开发复杂度、提升业务效率。
大模型推理加速实战:vLLM 部署 Llama3 的量化与批处理优化指南
本文详解如何通过量化与批处理优化,在vLLM中高效部署Llama3大模型。涵盖内存管理、推理加速及混合策略,提升吞吐量并降低延迟,适用于大规模语言模型部署实践。
2025 最新史上最全 Java 面试题独家整理带详细答案及解析
本文从Java基础、面向对象、多线程与并发等方面详细解析常见面试题及答案,并结合实际应用帮助理解。内容涵盖基本数据类型、自动装箱拆箱、String类区别,面向对象三大特性(封装、继承、多态),线程创建与安全问题解决方法,以及集合框架如ArrayList与LinkedList的对比和HashMap工作原理。适合准备面试或深入学习Java的开发者参考。附代码获取链接:[点此下载](https://pan.quark.cn/s/14fcf913bae6)。
赛事比分怎么实现实时更新?从采集到推送的“毫秒级“科技揭秘!
实时比分更新背后的技术奥秘,远比你想象的复杂!从数据采集、传输、处理到用户推送,每个环节都充满挑战。情报来源包括官方接口、AI视觉识别和人工录入;传输方式从HTTP轮询到WebSocket,追求毫秒级延迟;数据清洗确保准确性,用户推送注重适配与优先级。开发者还需规避常见坑点,如消息队列、时区转换等。未来,AI预测、边缘计算甚至量子通信将让零延迟成为可能。想了解如何打造像顶级中场般精准、快速且可靠的比分系统吗?本文为你深度拆解!
DistilQwen-ThoughtX:变长思维链推理模型,能力超越DeepSeek蒸馏模型
阿里云PAI团队开发的 OmniThought 数据集,其中包含200万思维链,并标注了推理冗余度(RV)和认知难度(CD)分数。基于此数据集,我们还推出了 DistilQwen-ThoughtX 系列模型,可以通过RV和CD分数对思维链进行筛选,训练得到的模型获得根据问题和本身的认知能力,生成变长思维链的能力。同时在 EasyDistill 框架中开源了 OmniThought 数据集和 DistilQwen-ThoughtX 模型的全部权重。这些模型在性能上超过了 DeepSeek-R1-Distill 系列。
云上玩转Qwen3系列之三:PAI-LangStudio x Hologres构建ChatBI数据分析Agent应用
PAI-LangStudio 和 Qwen3 构建基于 MCP 协议的 Hologres ChatBI 智能 Agent 应用,通过将 Agent、MCP Server 等技术和阿里最新的推理模型 Qwen3 编排在一个应用流中,为大模型提供了 MCP+OLAP 的智能数据分析能力,使用自然语言即可实现 OLAP 数据分析的查询效果,减少了幻觉。开发者可以基于该模板进行灵活扩展和二次开发,以满足特定场景的需求。

京东物流基于Flink & StarRocks的湖仓建设实践
本文整理自京东物流高级数据开发工程师梁宝彬在Flink Forward Asia 2024的分享,聚焦实时湖仓的探索与建设、应用实践、问题思考及未来展望。内容涵盖京东物流通过Flink和Paimon等技术构建实时湖仓体系的过程,解决复杂业务场景下的数据分析挑战,如多维OLAP分析、大屏监控等。同时,文章详细介绍了基于StarRocks的湖仓一体方案,优化存储成本并提升查询效率,以及存算分离的应用实践。最后,对未来数据服务的发展方向进行了展望,计划推广长周期数据存储服务和原生数据湖建设,进一步提升数据分析能力。

开发体育比分网站有哪些坑需要注意
开发体育比分网站需克服多方面挑战:数据来源上避免侵权,选用合法API;实时性上采用WebSocket等技术确保秒级更新;优化用户体验,极简设计配合实时动画;技术架构中使用缓存与微服务应对高并发;SEO方面通过SSR和服务端结构化数据提升搜索流量。示例代码展示了比赛数据的基本处理逻辑,包括设置比赛ID、状态、赢家信息及计划标记等功能。
京东API最新指南:商品视频接口接入与应用
在电商领域,商品视频能有效提升销售业绩。京东商品视频接口助力开发者获取商品视频信息(播放链接、时长、格式、封面图等),通过 HTTP GET/POST 请求返回 JSON 数据,便于集成到各类应用中,优化展示效果与用户体验。本指南详解接口接入与使用方法。

合合信息TextIn大模型加速器2.0发布:智能图表解析测评
随着人工智能技术的飞速发展,大规模语言模型(LLM)在自然语言处理、图像识别、语音合成等领域的应用日益广泛。然而,大模型的计算复杂度和资源消耗问题也日益凸显。为了解决这一问题,合合信息TextIn推出了大模型加速器2.0,旨在提升大模型的训练和推理效率,降低计算成本,完成智能问答与对话式交互,深度概括与定位等。本文将对合合信息TextIn大模型加速器2.0进行详细测评,重点关注其在智能图表解析任务中的表现。
如何用大模型评估大模型——PAI-Judge裁判员大语言模型的实现简介
阿里云人工智能平台 PAI 推出 PAI-Judge 裁判员大模型,为用户构建符合应用场景的多维度、细粒度的评测体系,支持单模型评测和双模型竞技两种模式,允许用户自定义参数,实现准确、灵活、高效的模型自动化评测,为模型迭代优化提供数据支撑。 相比通用大模型尤其在回答确定性/数学类问题、角色扮演、创意文体写作、翻译等场景下,PAI-Judge 系列模型表现优异,可以直接用于大模型的评估与质检。
京东商品列表 API 接口全攻略
京东商品列表API接口是京东开放平台提供的开发者工具,支持关键词搜索、店铺ID指定和商品分类筛选等查询方式,实时获取商品基础及拓展信息。接口数据丰富、查询灵活、更新及时且安全可靠,适用于电商数据分析、比价应用开发等场景。Python调用示例展示了如何安装必要库、构造请求参数及签名、发送请求并处理响应,确保开发者能高效利用该接口。
DistilQwen2.5蒸馏小模型在PAI-ModelGallery的训练、评测、压缩及部署实践
DistilQwen2.5 是阿里云人工智能平台 PAI 推出的全新蒸馏大语言模型系列。通过黑盒化和白盒化蒸馏结合的自研蒸馏链路,DistilQwen2.5各个尺寸的模型在多个基准测试数据集上比原始 Qwen2.5 模型有明显效果提升。这一系列模型在移动设备、边缘计算等资源受限的环境中具有更高的性能,在较小参数规模下,显著降低了所需的计算资源和推理时长。阿里云的人工智能平台 PAI,作为一站式的机器学习和深度学习平台,对 DistilQwen2.5 模型系列提供了全面的技术支持。本文详细介绍在 PAI 平台使用 DistilQwen2.5 蒸馏小模型的全链路最佳实践。
搜款网VVIC商品列表数据接口(搜款网API系列)
搜款网(VVIC)是知名服装批发平台,开发者可通过API获取商品列表数据,用于市场调研、数据分析等。API请求通常为HTTP GET,需申请权限并提供API Key。响应数据为JSON格式,包含商品基本信息。Python示例代码展示了如何发送请求和处理响应。使用API时需确保合法合规,注意错误处理和性能优化。

高性价比| OpenSearch 智能问答版开箱即用 DeepSeek-R1
OpenSearch LLM智能问答版基于DeepSeek-R1一分钟搭建RAG系统。
阿里云 EMR Serverless Spark 在微财机器学习场景下的应用
面对机器学习场景下的训练瓶颈,微财选择基于阿里云 EMR Serverless Spark 建立数据平台。通过 EMR Serverless Spark,微财突破了单机训练使用的数据规模瓶颈,大幅提升了训练效率,解决了存算分离架构下 Shuffle 稳定性和性能困扰,为智能风控等业务提供了强有力的技术支撑。
面向AI的服务器计算互连的创新探索
面向AI的服务器计算互连创新探索主要涵盖三个方向:Scale UP互连、AI高性能网卡及CIPU技术。Scale UP互连通过ALink系统实现极致性能,支持大规模模型训练,满足智算集群需求。AI高性能网卡针对大规模GPU通信和存储挑战,自研EIC网卡提供400G带宽和RDMA卸载加速,优化网络传输。CIPU作为云基础设施核心,支持虚拟化、存储与网络资源池化,提升资源利用率和稳定性,未来将扩展至2*800G带宽,全面覆盖阿里云业务需求。这些技术共同推动了AI计算的高效互联与性能突破。
实时计算UniFlow:Flink+Paimon构建流批一体实时湖仓
实时计算架构中,传统湖仓架构在数据流量管控和应用场景支持上表现良好,但在实际运营中常忽略细节,导致新问题。为解决这些问题,提出了流批一体的实时计算湖仓架构——UniFlow。该架构通过统一的流批计算引擎、存储格式(如Paimon)和Flink CDC工具,简化开发流程,降低成本,并确保数据一致性和实时性。UniFlow还引入了Flink Materialized Table,实现了声明式ETL,优化了调度和执行模式,使用户能灵活调整新鲜度与成本。最终,UniFlow不仅提高了开发和运维效率,还提供了更实时的数据支持,满足业务决策需求。
Python环境管理的新选择:UV和Pixi,高性能Python环境管理方案
近期Python生态系统在包管理领域发生了重要变化,Anaconda调整商业许可证政策,促使社区寻找更开放的解决方案。本文介绍两款新一代Python包管理工具:UV和Pixi。UV用Rust编写,提供高性能依赖解析和项目级环境管理;Pixi基于Conda生态系统,支持conda-forge和PyPI包管理。两者分别适用于高性能需求和深度学习项目,为开发者提供了更多选择。
怎么通过API获取电竞赛事实时数据
选择合适的电竞数据API是开发电竞应用的关键。主流API包括OP.GG、Liquipedia、Stratz、Riot Games和熊猫比分,涵盖LOL、DOTA2等游戏的实时数据。注册并获取API密钥后,需仔细阅读文档,了解资源、请求方法、必需参数及响应格式。编写代码调用API时,注意优化请求频率,避免封禁。最后,通过Web界面或可视化工具展示数据,如React/D3.js、Tableau等。示例代码展示了如何使用熊猫比分API获取即将开始的比赛信息。
如何在Windows和Mac上免费将蓝光转换为MKV?
蓝光光盘因能提供高质量的视频和音频内容而备受青睐,但其使用上的局限性却不容忽视。相比之下,MKV作为一种广受支持的视频格式,与大多数播放设备和平台都能完美兼容,为用户带来了更大的便利性和灵活性。
Selenium中定位元素的9种方法
在Selenium中,定位页面元素是自动化测试和网页爬虫的基础。常用的9种元素定位方法包括:ID、Name、Class Name、Tag Name、CSS Selector、XPath、Link Text、Partial Link Text,以及XPath和CSS选择器的组合使用。每种方法各有优劣,建议根据页面的具体情况和元素的属性选择最合适的方法,并使用显式等待确保元素可用。
自动化数据处理:使用Selenium与Excel打造的数据爬取管道
本文介绍了一种使用Selenium和Excel结合代理IP技术从WIPO品牌数据库(branddb.wipo.int)自动化爬取专利信息的方法。通过Selenium模拟用户操作,处理JavaScript动态加载页面,利用代理IP避免IP封禁,确保数据爬取稳定性和隐私性。爬取的数据将存储在Excel中,便于后续分析。此外,文章还详细介绍了Selenium的基本设置、代理IP配置及使用技巧,并探讨了未来可能采用的更多防反爬策略,以提升爬虫效率和稳定性。
Java一个线程的生命周期详解
Java中,一个线程的生命周期分为五个阶段:NEW(新建),RUNNABLE(可运行),BLOCKED(阻塞),WAITING(等待),TERMINATED(终止)。线程创建后处于新建状态,调用start方法进入可运行状态,执行中可能因等待资源进入阻塞或等待状态,正常完成或异常终止后进入终止状态。各状态间可相互转换,构成线程的生命周期。
上海“爷叔”神话分析——爱在深秋
上海“爷叔”股市评论走红,言论影响巨大,分析显示其预测大多不准确,但个别时机准确,模拟操作获利,反映股市预测复杂性,强调投资需谨慎。
小红书 API 接口使用指南:笔记详情数据接口的接入与使用
小红书是一款广受喜爱的生活方式分享社交平台,涵盖旅行、美食等领域。其API允许开发者批量获取笔记内容、图片链接及用户互动数据,助力内容分析与营销策略优化。要使用API,需先注册开发者账号并通过认证获取密钥;随后依据官方文档构建与发送HTTP请求,最后处理JSON格式响应数据。整个过程中,请务必遵循平台使用条款,尊重用户隐私权。
性能调优指南:针对 DataLoader 的高级配置与优化
【8月更文第29天】在深度学习项目中,数据加载和预处理通常是瓶颈之一,特别是在处理大规模数据集时。PyTorch 的 `DataLoader` 提供了丰富的功能来加速这一过程,但默认设置往往不能满足所有场景下的最优性能。本文将介绍如何对 `DataLoader` 进行高级配置和优化,以提高数据加载速度,从而加快整体训练流程。
PyTorch 与 ONNX:模型的跨平台部署策略
【8月更文第27天】深度学习模型的训练通常是在具有强大计算能力的平台上完成的,比如配备有高性能 GPU 的服务器。然而,为了将这些模型应用到实际产品中,往往需要将其部署到各种不同的设备上,包括移动设备、边缘计算设备甚至是嵌入式系统。这就需要一种能够在多种平台上运行的模型格式。ONNX(Open Neural Network Exchange)作为一种开放的标准,旨在解决模型的可移植性问题,使得开发者可以在不同的框架之间无缝迁移模型。本文将介绍如何使用 PyTorch 将训练好的模型导出为 ONNX 格式,并进一步探讨如何在不同平台上部署这些模型。
推荐2款免费开源的标注工具,支持大模型对话标注
【LabelLLM】一款开源免费的大模型对话标注平台,专为优化大型语言模型的数据标注过程设计。支持灵活配置与多模态数据(音频、图像、视频),具备全面任务管理和AI辅助标注功能,大幅提升标注效率与准确性。了解更多请前往https://github.com/opendatalab/LabelLLM 【LabelU】一款轻量级开源标注工具,支持图像、视频、音频的高效标注。特色功能包括多功能图像处理、视频和音频分析等,简易灵活,支持多种数据格式输出。了解更多请前往https://github.com/opendatalab/labelU
小红书 API 接口最新指南:笔记详情数据接口的接入与使用
小红书笔记详情数据接口由其开放平台提供,让开发者通过API批量获取笔记的全面信息,如标题、内容、图片及互动数据等。可用于数据分析、洞察用户行为与内容趋势,支持精准的内容创作与营销策略。使用前需注册认证并获取API密钥;依据官方文档构建与发送请求;处理JSON响应数据。注意遵守调用频率限制、保持数据更新及确保数据使用的合规性。

大数据与机器学习
大数据领域前沿技术分享与交流,这里不止有技术干货、学习心得、企业实践、社区活动,还有未来。