

EMR AI助手开启公测:用AI重塑大数据运维,更简单、更智能
EMR AI 助手开启公测,通过合理利用 EMR AI 助手的各项功能,可以快速查询资源信息、唤起相关操作、诊断组件异常、获取技术支持等,能帮您提升运维效率和操作体验。
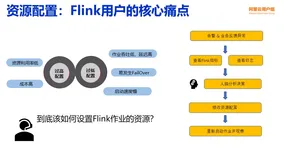
Flink 智能调优:从人工运维到自动化的实践之路
本文由阿里云Flink产品专家黄睿撰写,基于平台实践经验,深入解析流计算作业资源调优难题。针对人工调优效率低、业务波动影响大等挑战,介绍Flink自动调优架构设计,涵盖监控、定时、智能三种模式,并融合混合计费实现成本优化。展望未来AI化方向,推动运维智能化升级。
氛围编程陷阱:为什么AI生成代码正在制造大量"伪开发者"
AI兴起催生“氛围编程”——用自然语言生成代码,看似高效实则陷阱。它让人跳过编程基本功,沦为只会提示、不懂原理的“中间商”。真实案例显示,此类项目易崩溃、难维护,安全漏洞频出。AI是技能倍增器,非替代品;真正强大的开发者,永远是那些基础扎实、能独立解决问题的人。
基于MVO多元宇宙优化的DBSCAN聚类算法matlab仿真
本程序基于MATLAB实现MVO优化的DBSCAN聚类算法,通过多元宇宙优化自动搜索最优参数Eps与MinPts,提升聚类精度。对比传统DBSCAN,MVO-DBSCAN有效克服参数依赖问题,适应复杂数据分布,增强鲁棒性,适用于非均匀密度数据集的高效聚类分析。
京东商品 SKU 信息接口(jingdong.ware.sku.get)技术干货:数据拉取、规格解析与字段治理(附踩坑总结 + 可运行代码)
本文详解京东商品SKU接口对接技术,涵盖核心参数、权限申请、签名生成、规格解析及常见坑点解决方案,结合可运行代码与实战经验,助力开发者高效集成SKU数据,实现库存、价格等关键信息精准获取。
AI智能体开发实战:17种核心架构模式详解与Python代码实现
本文系统解析了17种AI智能体设计模式,涵盖反思、工具调用、多智能体协作、思维树、规划执行、集成决策等核心架构,结合LangGraph实现与代码演示,揭示如何通过模式组合构建高效、可靠的大规模AI系统。
速卖通开放平台接口实战:跨境电商商品检索与详情解析全方案(附多语言处理 + 签名避坑代码)
本文基于30+店铺实战经验,详解速卖通接口开发核心:从签名认证、多语言字段处理到商品检索与详情解析,提供可复用代码及避坑指南,助你快速实现选品工具、多平台同步等跨境场景,新手也能少走两天弯路。
【逆向】Python 调用 JS 代码实战:使用 pyexecjs 与 Node.js 无缝衔接
本文介绍了如何使用 Python 的轻量级库 `pyexecjs` 调用 JavaScript 代码,并结合 Node.js 实现完整的执行流程。内容涵盖环境搭建、基本使用、常见问题解决方案及爬虫逆向分析中的实战技巧,帮助开发者在 Python 中高效处理 JS 逻辑。

新闻网站的数据采集与更新思路
该方案设计了一个跨站点的增量更新引擎,用于高效采集央视新闻、中国新闻网和环球网等多源新闻数据。通过代理IP和内容哈希签名技术,实现新闻的新增与更新检测,大幅降低冗余抓取和带宽消耗。实验表明,该方法在多源新闻采集中具备高效性和实用性,可拓展为行业级舆情雷达系统,支持事件追踪与趋势分析。
【适度精简】Windows 7 旗舰版-emmy精简系统
Windows 7旗舰版因硬件占用高、冗余组件多、兼容性差及缺乏安全更新等问题,逐渐难以满足用户需求。适度精简版通过去除无用组件、优化性能与安全性,提升老旧设备运行效率,增强兼容性与稳定性,同时保留用户熟悉的操作界面,降低学习成本,满足个性化需求,延续Windows 7的实用价值。
2025 年 Java 开发者必知的最新技术实操指南全览
本指南涵盖Java 21+核心实操,详解虚拟线程、Spring Boot 3.3+GraalVM、Jakarta EE 10+MicroProfile 6微服务开发,并提供现代Java开发最佳实践,助力开发者高效构建高性能应用。
孔夫子旧书网 API 实战:古籍与二手书数据获取及接口调用方案
孔夫子旧书网作为国内知名古籍与二手书交易平台,其数据对图书收藏、学术研究及电商系统具有重要价值。本文详解其API调用方法,涵盖认证机制、搜索参数、数据解析及反爬策略,并提供可直接使用的Python代码,助力开发者合规获取数据。
抖音视频列表API秘籍!轻松获取视频列表数据
抖音视频列表API是抖音开放平台提供的核心接口,支持按关键词、分类、排序方式筛选视频,适用于内容推荐、趋势分析等场景。接口返回含视频ID、标题、播放量等50+字段,支持分页获取,通过HTTP GET请求调用,返回JSON格式数据,便于开发者快速集成与处理。需注册平台账号获取访问权限。
抖音商品列表API秘籍!轻松获取商品列表页面数据
抖音商品列表API是抖音开放平台的核心电商接口,支持按分类、关键词、销量等条件筛选商品,具备分页、排序、数据过滤等功能,适用于电商整合、竞品分析等场景。接口返回JSON格式数据,包含商品列表、总数及分页信息,提供Python请求示例,便于开发者快速接入。

数据量暴涨时,抓取架构该如何应对?——豆瓣电影案例调研
本案例讲述了在豆瓣电影数据采集过程中,面对数据量激增和限制机制带来的挑战,如何通过引入爬虫代理、分布式架构与异步IO等技术手段,实现采集系统的优化与扩展,最终支撑起百万级请求的稳定抓取。
三种常见网站结构的解析方式对比—信息结构与处理路径图谱
页面结构对信息提取方式有重要影响,本文分析三种主流结构类型及应对策略,结合代码实例对比静态页面、动态页面与接口型页面的处理方法,帮助开发者快速选择合适方案,提升数据采集效率。
【ICML2025】大模型后训练性能4倍提升!阿里云PAI团队研究成果ChunkFlow中选
近日,阿里云 PAI 团队、通义实验室与中国科学院大学前沿交叉科学学院合作在机器学习顶级会议 ICML 2025 上发表论文 Efficient Long Context Fine-tuning with Chunk Flow。ChunkFlow 作为阿里云在变长和超长序列数据集上高效训练解决方案,针对处理变长和超长序列数据的性能问题,提出了以 Chunk 为中心的训练机制,支撑 Qwen 全系列模型的长序列续训练和微调任务,在阿里云内部的大量的业务上带来2倍以上的端到端性能收益,大大降低了训练消耗的 GPU 卡时。
【ICML2025】大模型后训练性能4倍提升!阿里云PAI团队研究成果ChunkFlow中选
阿里云 PAI 团队、通义实验室联合中国科学院大学在 ICML 2025 发表论文,提出 ChunkFlow 方案,实现变长及超长序列数据的高效训练。该方案显著提升 Qwen 模型训练性能,端到端性能最高提升 4.53 倍,大幅降低 GPU 成本。
通过阿里云 Milvus 和 Dify 平台构建RAG系统
本文介绍了如何结合阿里云 Milvus 向量数据库与低代码 AI 平台 Dify,快速构建企业级检索增强生成(RAG)应用。通过该方案,可有效解决大语言模型的知识局限与“幻觉”问题,提升 AI 应用的回答准确性与可靠性。
性能提升 10 倍, DIFY 模式迁移至 Spring AI Alibaba 模式 零改造实现
将 Dify 应用迁移至 Spring AI Alibaba,可兼顾可视化开发效率与代码工程灵活性,显著提升系统性能与扩展能力,适用于复杂 AI 业务场景。
MaxCompute x 聚水潭:基于近实时数仓解决方案构建统一增全量一体化数据链路
聚水潭作为中国领先的电商SaaS ERP服务商,致力于为88,400+客户提供全链路数字化解决方案。其核心ERP产品助力企业实现数据驱动的智能决策。为应对业务扩展带来的数据处理挑战,聚水潭采用MaxCompute近实时数仓Delta Table方案,有效提升数据新鲜度和计算效率,提效比例超200%,资源消耗显著降低。未来,聚水潭将进一步优化数据链路,结合MaxQA实现实时分析,赋能商家快速响应市场变化。
革新智能驾驶数据挖掘检索效率!某国内新能源汽车未来出行领导者选择阿里云Milvus构建多模态检索引擎
在智能驾驶技术快速发展中,数据成为驱动算法进步的核心。某新能源汽车领军企业基于阿里云Milvus向量数据库构建智能驾驶数据挖掘平台,利用其高性能、可扩展的相似性检索服务,解决了大规模向量数据检索瓶颈问题,显著降低20%以上成本,缩短模型迭代周期,实现从数据采集到场景挖掘的智能化闭环,加速智能驾驶落地应用。
“乐高式”大屏应用构建!业务全景一键聚合
还在为多业务数据分散烦恼?DataV 7.0 全新推出「大屏嵌入」功能,无需重复开发!像搭乐高一样,将销售看板、物流监控、用户画像等子屏自由嵌入主屏,构建跨部门、跨业务的全景智能作战系统!老板要的“一张图”数据,分分钟搞定!
1688工厂信息接口指南
1688工厂信息接口用于获取供应商基础信息、生产能力及交易信用数据,支持供应链分析与评估。核心功能包括企业信息、生产能力、交易勋章、认证资料等。调用需申请接口权限,配置商品ID与返回字段。
OpenFeature 实战:统一特征开关在风控模型的落地与灰度发布方案
在金融风控场景中,模型迭代速度与线上稳定性之间的平衡是一大挑战。传统硬编码方式存在耦合度高、控制粒度粗、缺乏审计等问题,导致误拦截损失显著。本文介绍了基于 OpenFeature 的解决方案,通过动态配置、细粒度控制和多语言支持实现高效特征管理,并结合灰度发布、熔断机制和安全审计提升系统稳定性与发布安全性。实战数据显示,该方案显著缩短上线周期、降低故障率并提升模型覆盖率,具备高可用性和可扩展性,适用于复杂风控环境下的策略迭代需求。
2025年颠覆闭源大模型?MonkeyOCR:这款开源AI文档解析模型,精度更高,速度更快!
还在依赖昂贵且慢的闭源OCR工具?华中科技大学开源的MonkeyOCR文档解析模型,以其超越GPT4o的精度和更快的推理速度,在单机单卡(3090)上即可部署,正颠覆业界认知。本文将深入解析其设计哲学、核心突破——大规模自建数据集,并分享实测体验与避坑指南。
深入研究:shopee商品详情API接口Python攻略
Shopee 商品详情 API 是用于获取 Shopee 平台商品详细信息的接口,支持开发者提取商品标题、价格、库存、描述和图片等多维度数据。该接口适用于电商数据分析、比价工具开发及商品监控等场景。请求方式为 GET,需提供 itemid(商品 ID)和 shopid(店铺 ID),返回格式为 JSON。部分功能可能需要 API 密钥或访问令牌认证。以马来西亚站点为例,URL 为 shopee.com.myapi/v4/item/get,不同国家站点域名可能有所不同。
Apache Spark详解
Apache Spark 是一个开源、分布式计算引擎,专为大规模数据处理设计。它以高速、易用和通用为核心目标。通过内存计算、DAG 执行引擎和惰性求值等特性,大幅提升数据处理效率。其核心组件包括 Spark Core、Spark SQL、Spark Streaming、MLlib 和 GraphX,支持批处理、实时流处理、机器学习和图计算。Spark 提供统一编程模型,支持多语言(Scala/Java/Python/R),并拥有强大的 Catalyst 优化器和类型安全的 Dataset API,广泛应用于大数据分析和处理场景。

VIN码查询_标准版API:帮助解锁车辆的“身份证”详细信息的实战指南
VIN码(车辆识别号码)是由17位字母和数字组成的全球唯一编码,相当于汽车的“身份证”。通过解析VIN码,可获取品牌、车系、生产年份等关键信息。探数API平台的VIN码查询API(标准版),只需输入VIN码即可返回完整车辆配置信息。 该API适用于多种场景:电商平台可自动填充商品详情,提升准确性;维修行业能精准匹配零件与诊断需求;二手车市场则增强交易透明度与安全性。其调用流程简单,包括准备VIN码、构造请求、处理响应及异常处理。 VIN码不仅是查询工具,更是连接制造、销售、维修、保险等环节的纽带。

智能嗅探AJAX触发:机器学习在动态渲染中的创新应用
随着Web技术发展,动态加载数据的网站(如今日头条)对传统爬虫提出新挑战:初始HTML无完整数据、请求路径动态生成且易触发反爬策略。本文以爬取“AI”相关新闻为例,探讨了通过浏览器自动化、抓包分析和静态逆向接口等方法采集数据的局限性,并提出借助机器学习智能识别AJAX触发点的解决方案。通过特征提取与模型训练,爬虫可自动推测数据接口路径并高效采集。代码实现展示了如何模拟AJAX请求获取新闻标题、简介、作者和时间,并分类存储。未来,智能化将成为采集技术的发展趋势。
大数据新视界 --大数据大厂之Hive与大数据融合:构建强大数据仓库实战指南
本文深入介绍 Hive 与大数据融合构建强大数据仓库的实战指南。涵盖 Hive 简介、优势、安装配置、数据处理、性能优化及安全管理等内容,并通过互联网广告和物流行业案例分析,展示其实际应用。具有专业性、可操作性和参考价值。
立马耀:通过阿里云 Serverless Spark 和 Milvus 构建高效向量检索系统,驱动个性化推荐业务
蝉妈妈旗下蝉选通过迁移到阿里云 Serverless Spark 及 Milvus,解决传统架构性能瓶颈与运维复杂性问题。新方案实现离线任务耗时减少40%、失败率降80%,Milvus 向量检索成本降低75%,支持更大规模数据处理,查询响应提速。
通过阿里云Milvus与通义千问VL大模型,快速实现多模态搜索
阿里云向量检索服务Milvus版是一款全托管向量检索引擎,并确保与开源Milvus的完全兼容性,支持无缝迁移。它在开源版本的基础上增强了可扩展性,能提供大规模AI向量数据的相似性检索服务。凭借其开箱即用的特性、灵活的扩展能力和全链路监控告警,Milvus云服务成为多样化AI应用场景的理想选择,包括多模态搜索、检索增强生成(RAG)、搜索推荐、内容风险识别等。您还可以利用开源的Attu工具进行可视化操作,进一步促进应用的快速开发和部署。
通过Milvus和Langchain快速构建基于百炼大模型的LLM问答系统
阿里云向量检索服务Milvus版是一款全托管向量检索引擎,并确保与开源Milvus的完全兼容性,支持无缝迁移。它在开源版本的基础上增强了可扩展性,能提供大规模AI向量数据的相似性检索服务。凭借其开箱即用的特性、灵活的扩展能力和全链路监控告警,Milvus云服务成为多样化AI应用场景的理想选择,包括多模态搜索、检索增强生成(RAG)、搜索推荐、内容风险识别等。您还可以利用开源的Attu工具进行可视化操作,进一步促进应用的快速开发和部署。

Flink Forward Asia 2025 新加坡站议题征集开启|The future of AI is Real-Time
Flink Forward Asia 2025 将于7月3日在新加坡盛大召开!作为Apache Flink社区顶级会议,大会聚焦实时AI、实时湖仓、实时分析等前沿方向,汇聚全球顶尖技术实践。即日起开放议题征集,诚邀开发者与数据专家分享创新经验。席位有限,立即行动!扫码或访问官网报名参与这场年度技术盛宴,共话实时计算未来。
Quick BI产品测评:从数据连接到智能分析的全流程体验
瓴羊智能商业分析-Quick BI是阿里云旗下的云端智能BI平台,连续五年入选Gartner ABI魔力象限。它提供从数据接入到决策的全链路服务,支持零代码操作、40+可视化组件与OLAP分析,实现跨终端呈现。其创新点包括云原生架构、企业级安全体系及智能决策引擎,适用于零售、金融等行业。评测中,通过免费试用与官方文档,体验了数据准备、仪表板搭建及智能小Q功能,发现智能化能力强大但部分文档需更新优化。

计算机视觉五大技术——深度学习在图像处理中的应用
深度学习利用多层神经网络实现人工智能,计算机视觉是其重要应用之一。图像分类通过卷积神经网络(CNN)判断图片类别,如“猫”或“狗”。目标检测不仅识别物体,还确定其位置,R-CNN系列模型逐步优化检测速度与精度。语义分割对图像每个像素分类,FCN开创像素级分类范式,DeepLab等进一步提升细节表现。实例分割结合目标检测与语义分割,Mask R-CNN实现精准实例区分。关键点检测用于人体姿态估计、人脸特征识别等,OpenPose和HRNet等技术推动该领域发展。这些方法在效率与准确性上不断进步,广泛应用于实际场景。
京东API最新指南:商品视频接口接入与应用
在电商领域,商品视频能有效提升销售业绩。京东商品视频接口助力开发者获取商品视频信息(播放链接、时长、格式、封面图等),通过 HTTP GET/POST 请求返回 JSON 数据,便于集成到各类应用中,优化展示效果与用户体验。本指南详解接口接入与使用方法。

分位数回归+共形预测:Conformalized Quantile Regression实现更可靠的预测区间
预测不确定性量化在数据驱动决策中至关重要,分位数回归(QR)虽能生成自适应预测区间,但缺乏严格覆盖保证;共形预测(CP)则提供覆盖保证但缺乏强自适应性。Conformalized Quantile Regression (CQR)融合两者优势,通过校准分位数回归模型,生成既适应数据特性又具备统计保证的预测区间。本文深入探讨CQR理论、实现与应用,展示其在医疗、金融等领域提升预测可靠性的潜力,为高风险决策提供更精确和可信的支持。
广义优势估计(GAE):端策略优化PPO中偏差与方差平衡的关键技术
广义优势估计(GAE)由Schulman等人于2016年提出,是近端策略优化(PPO)算法的核心理论基础。它通过平衡偏差与方差,解决了强化学习中的信用分配问题,即如何准确判定历史动作对延迟奖励的贡献。GAE基于资格迹和TD-λ思想,采用n步优势的指数加权平均方法,将优势函数有效集成到损失函数中,为策略优化提供稳定梯度信号。相比TD-λ,GAE更适用于现代策略梯度方法,推动了高效强化学习算法的发展。
大数据与机器学习
大数据领域前沿技术分享与交流,这里不止有技术干货、学习心得、企业实践、社区活动,还有未来。