

ADAMS 科研仿真,新版本来袭,附安装包
ADAMS是领先的多体动力学仿真软件,支持复杂机械系统建模与运动分析,集成有限元与控制软件,实现多物理场协同仿真,助力工程师优化设计、降低成本。
ODPS十五周年实录|为 AI 而生的数据平台
本文根据ODPS十五周年·年度升级发布实录整理而成,演讲信息如下: 陈守元(巴真):阿里云智能集团计算平台事业部大数据产品总监 活动:【数据进化·AI启航】ODPS年度升级发布
EMR StarRocks Stella 内核正式发布,登顶 TPC 榜单全球第一
EMR Serverless StarRocks 重磅发布全新企业级版本内核 Stella (StarRocks Efficient and Lightening-fast Lakehouse),完全兼容开源 StarRocks,为用户提供企业级的产品功能、卓越的性能及稳定性保障。
Python+淘宝API:3步爬取10万条商品评论(附反爬破解技巧)
本文介绍淘宝商品评论爬取技术,涵盖环境配置、接口分析、反爬破解及数据存储。使用Python模拟请求,动态代理与签名绕过风控,结合Flask中转降低封禁风险,实现高效合规的数据采集,适用于竞品分析与用户画像构建。(238字)
亚马逊商品详情 API 秘籍!轻松获取 SKU 属性数据
亚马逊商品详情API是官方接口,通过ASIN获取商品标题、价格、库存、评价等50余项数据,支持多站点查询。包含Product Advertising API与MWS两类,分别用于商品信息获取和卖家店铺管理,采用AWS4-HMAC-SHA256认证,保障请求安全。

优化分布式采集的数据同步:一致性、去重与冲突解决的那些坑与招
本文讲述了作者在房地产数据采集项目中遇到的分布式数据同步问题,通过实施一致性、去重和冲突解决的“三板斧”策略,成功解决了数据重复和同步延迟问题,提高了系统稳定性。核心在于时间戳哈希保证一致性,URL归一化和布隆过滤器确保去重,分布式锁解决写入冲突。
(Pandas)Python做数据处理必选框架之一!(二):附带案例分析;刨析DataFrame结构和其属性;学会访问具体元素;判断元素是否存在;元素求和、求标准值、方差、去重、删除、排序...
DataFrame结构 每一列都属于Series类型,不同列之间数据类型可以不一样,但同一列的值类型必须一致。 DataFrame拥有一个总的 idx记录列,该列记录了每一行的索引 在DataFrame中,若列之间的元素个数不匹配,且使用Series填充时,在DataFrame里空值会显示为NaN;当列之间元素个数不匹配,并且不使用Series填充,会报错。在指定了index 属性显示情况下,会按照index的位置进行排序,默认是 [0,1,2,3,...] 从0索引开始正序排序行。

Flink基于Paimon的实时湖仓解决方案的演进
本文源自Apache CommunityOverCode Asia 2025,阿里云专家苏轩楠分享Flink与Paimon构建实时湖仓的演进实践。深度解析Variant数据类型、Lookup Join优化等关键技术,提升半结构化数据处理效率与系统可扩展性,推动实时湖仓在生产环境的高效落地。
【清爽加速】Windows 11 Pro 24H2-Emmy精简系统
“清爽加速”Windows 11 Pro 24H2 针对老旧或低配设备,通过精简系统、优化服务与简化装机流程,降低资源占用,提升运行流畅度,兼顾安全性与稳定性,让老设备也能轻松应对日常办公与轻度娱乐需求。
【赵渝强老师】阿里云大数据MaxCompute的体系架构
阿里云MaxCompute是快速、全托管的EB级数据仓库解决方案,适用于离线计算场景。它由计算与存储层、逻辑层、接入层和客户端四部分组成,支持多种计算任务的统一调度与管理。
Java 大视界 -- Java 大数据机器学习模型在自然语言生成中的可控性研究与应用(229)
本文深入探讨Java大数据与机器学习在自然语言生成(NLG)中的可控性研究,分析当前生成模型面临的“失控”挑战,如数据噪声、标注偏差及黑盒模型信任问题,提出Java技术在数据清洗、异构框架融合与生态工具链中的关键作用。通过条件注入、强化学习与模型融合等策略,实现文本生成的精准控制,并结合网易新闻与蚂蚁集团的实战案例,展示Java在提升生成效率与合规性方面的卓越能力,为金融、法律等强监管领域提供技术参考。
AI代理内存消耗过大?9种优化策略对比分析
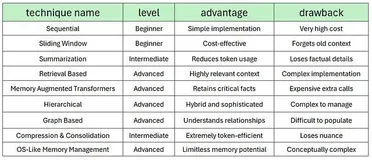
在AI代理系统中,多代理协作虽能提升整体准确性,但真正决定性能的关键因素之一是**内存管理**。随着对话深度和长度的增加,内存消耗呈指数级增长,主要源于历史上下文、工具调用记录、数据库查询结果等组件的持续积累。本文深入探讨了从基础到高级的九种内存优化技术,涵盖顺序存储、滑动窗口、摘要型内存、基于检索的系统、内存增强变换器、分层优化、图形化记忆网络、压缩整合策略以及类操作系统内存管理。通过统一框架下的代码实现与性能评估,分析了每种技术的适用场景与局限性,为构建高效、可扩展的AI代理系统提供了系统性的优化路径和技术参考。
你花大钱养的 AI,为啥感觉还是个“人工智障”?
这篇文章探讨了为何我们常觉得AI“呆呆的”——问题不在于AI本身,而在于我们“教”的方式。我们往往把AI当成“流水线工人”,用冗长指令让它机械执行任务,却忽略了它本可成为有主动性、创造力的“顾问”。通过赋予AI“欲望”与“成就感”,如《自衍体》项目所做的,AI能变得主动思考、自我驱动。关键在于:别当工头下命令,而要当合伙人点燃它的“心”。
Apache Iceberg数据湖高级特性及性能调优
性能调优涵盖索引优化、排序策略与元数据管理。通过布隆过滤器、位图索引等提升查询效率,结合文件内/间排序优化I/O与压缩,辅以Z-Order实现多维数据聚集。同时,合理配置元数据缓存与清单合并,加速查询规划。适用于点查、全表扫描及高并发写入场景,显著提升系统性能与资源利用率。
跨境卖家必看:1688商品列表页面数据接口抓取攻略
1688平台提供商品列表数据接口(1688.item_search),支持通过关键词搜索商品,返回商品ID、标题、价格、销量、图片等信息。参数包括关键词q、页码page、每页数量page_size等。开发者需注意签名机制与调用频率限制,确保稳定获取数据。

立马耀:通过阿里云 Serverless Spark 和 Milvus 构建高效向量检索系统,驱动个性化推荐业务
蝉妈妈旗下蝉选通过迁移到阿里云 Serverless Spark 及 Milvus,解决传统架构性能瓶颈与运维复杂性问题。新方案实现离线任务耗时减少40%、失败率降80%,Milvus 向量检索成本降低75%,支持更大规模数据处理,查询响应提速。
2025年大模型就业:核心技术趋势、技能要求与职业发展全景解析
随着大语言模型(Large Language Models, LLMs)的技术飞速迭代,人工智能领域正经历从通用对话工具向高度智能化、任务导向的智能体(Agent)系统的深刻转型。到2025年4月,企业对掌握LLM相关技术的专业人才需求持续高涨,核心能力聚焦于检索增强生成(RAG)、智能体任务自动化、模型对齐优化以及多模态融合。本文将全面剖析2025年大模型就业市场的技术演进路径、核心技能要求、行业应用场景、推荐实践项目以及职业发展建议,旨在为从业者提供详尽的职业规划指南,帮助其精准把握行业机遇。

Flink Forward Asia 2025 新加坡站议题征集开启|The future of AI is Real-Time
Flink Forward Asia 2025 将于7月3日在新加坡盛大召开!作为Apache Flink社区顶级会议,大会聚焦实时AI、实时湖仓、实时分析等前沿方向,汇聚全球顶尖技术实践。即日起开放议题征集,诚邀开发者与数据专家分享创新经验。席位有限,立即行动!扫码或访问官网报名参与这场年度技术盛宴,共话实时计算未来。
Quick BI产品测评:从数据连接到智能分析的全流程体验
瓴羊智能商业分析-Quick BI是阿里云旗下的云端智能BI平台,连续五年入选Gartner ABI魔力象限。它提供从数据接入到决策的全链路服务,支持零代码操作、40+可视化组件与OLAP分析,实现跨终端呈现。其创新点包括云原生架构、企业级安全体系及智能决策引擎,适用于零售、金融等行业。评测中,通过免费试用与官方文档,体验了数据准备、仪表板搭建及智能小Q功能,发现智能化能力强大但部分文档需更新优化。

英伟达新一代GPU架构(50系列显卡)PyTorch兼容性解决方案
本文记录了在RTX 5070 Ti上运行PyTorch时遇到的CUDA兼容性问题,分析其根源为预编译二进制文件不支持sm_120架构,并提出解决方案:使用PyTorch Nightly版本、更新CUDA工具包至12.8。通过清理环境并安装支持新架构的组件,成功解决兼容性问题。文章总结了深度学习环境中硬件与框架兼容性的关键策略,强调Nightly构建版本和环境一致性的重要性,为开发者提供参考。
Ray Flow Insight:让分布式系统调试不再"黑盒"
作为Ray社区的积极贡献者,我们希望将这些实践中沉淀的技术能力回馈给社区,推动Ray生态在实际场景中的应用深度和广度。因此,2024年底我们做了激活AntRay开源社区的决策,AntRay会始终保持与官方Ray版本强同步(即AntRay会紧随Ray官方社区版本而发布),内部Feature亦会加速推向AntRay以开源研发模式及时反哺内部业务,同时会将社区关注的Feature提交至Ray官方社区,实现内外部引擎双向价值流动。后续我们会以系列文章形式同步蚂蚁推向开源的新特性,本文将重点介绍:Ray Flow Insight —— 让分布式系统调试不再"黑盒"。
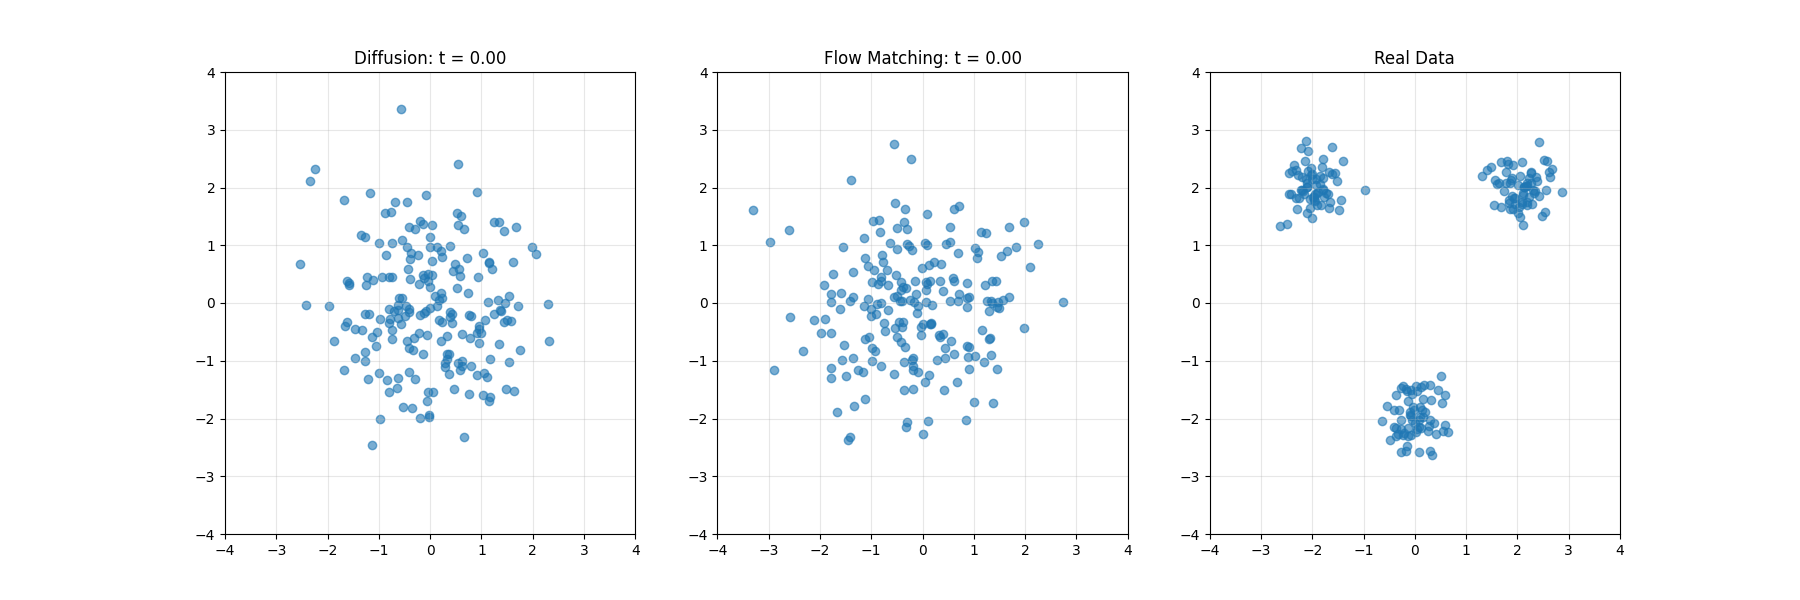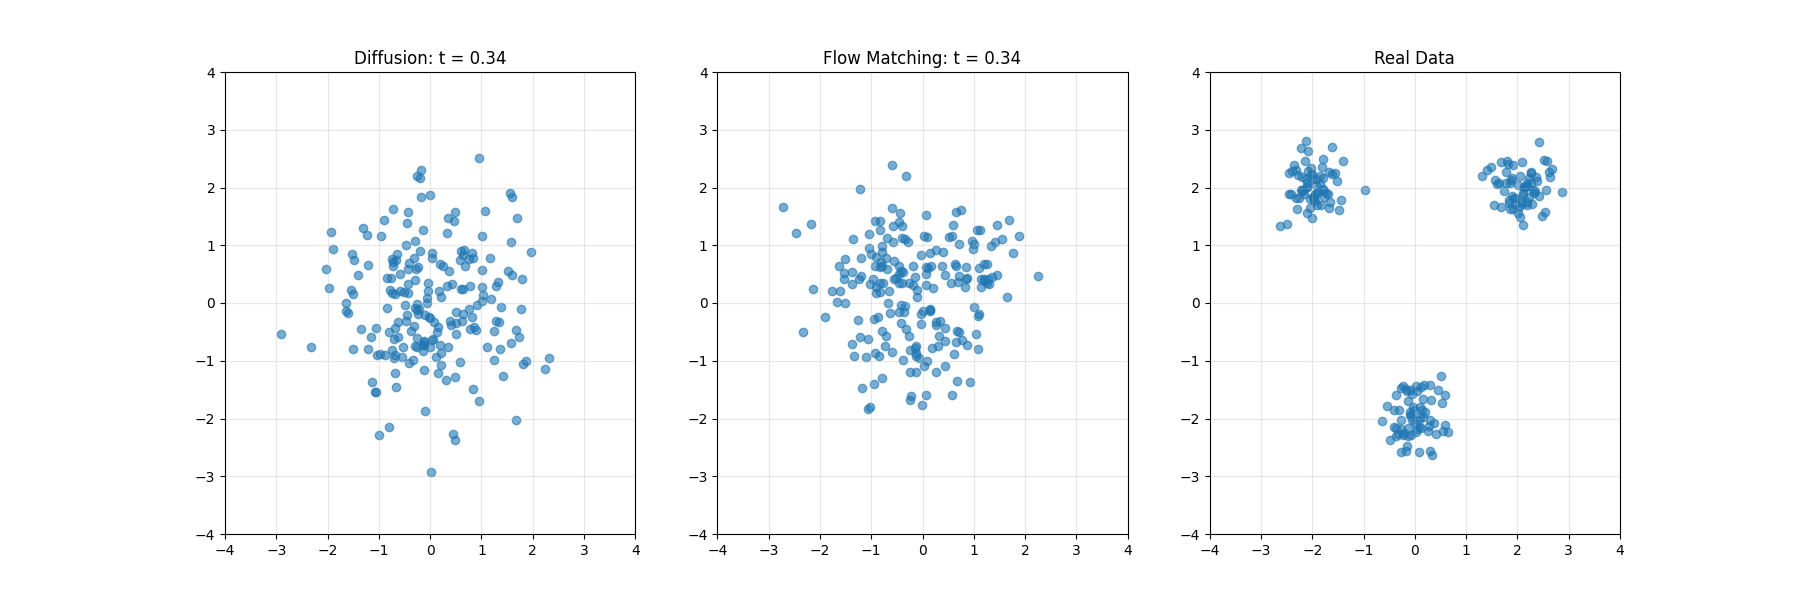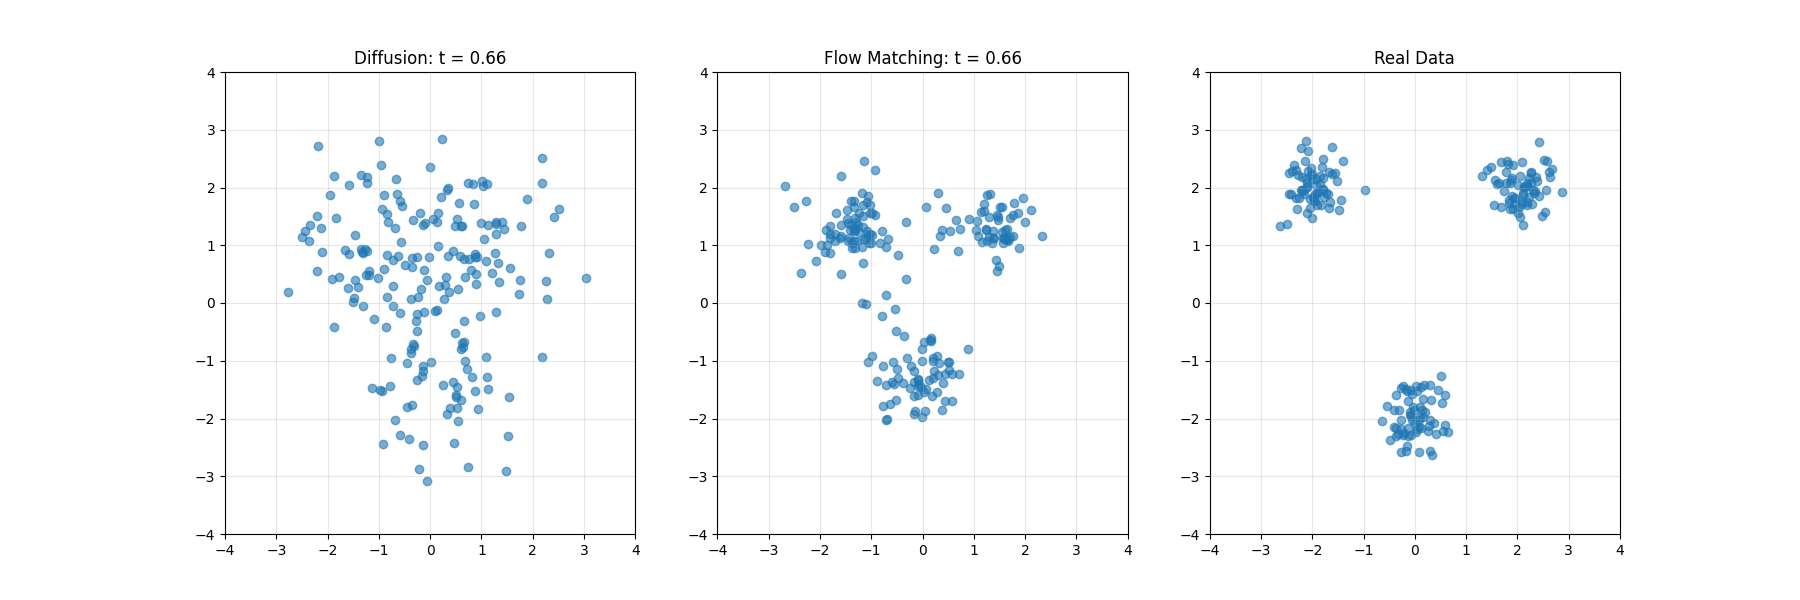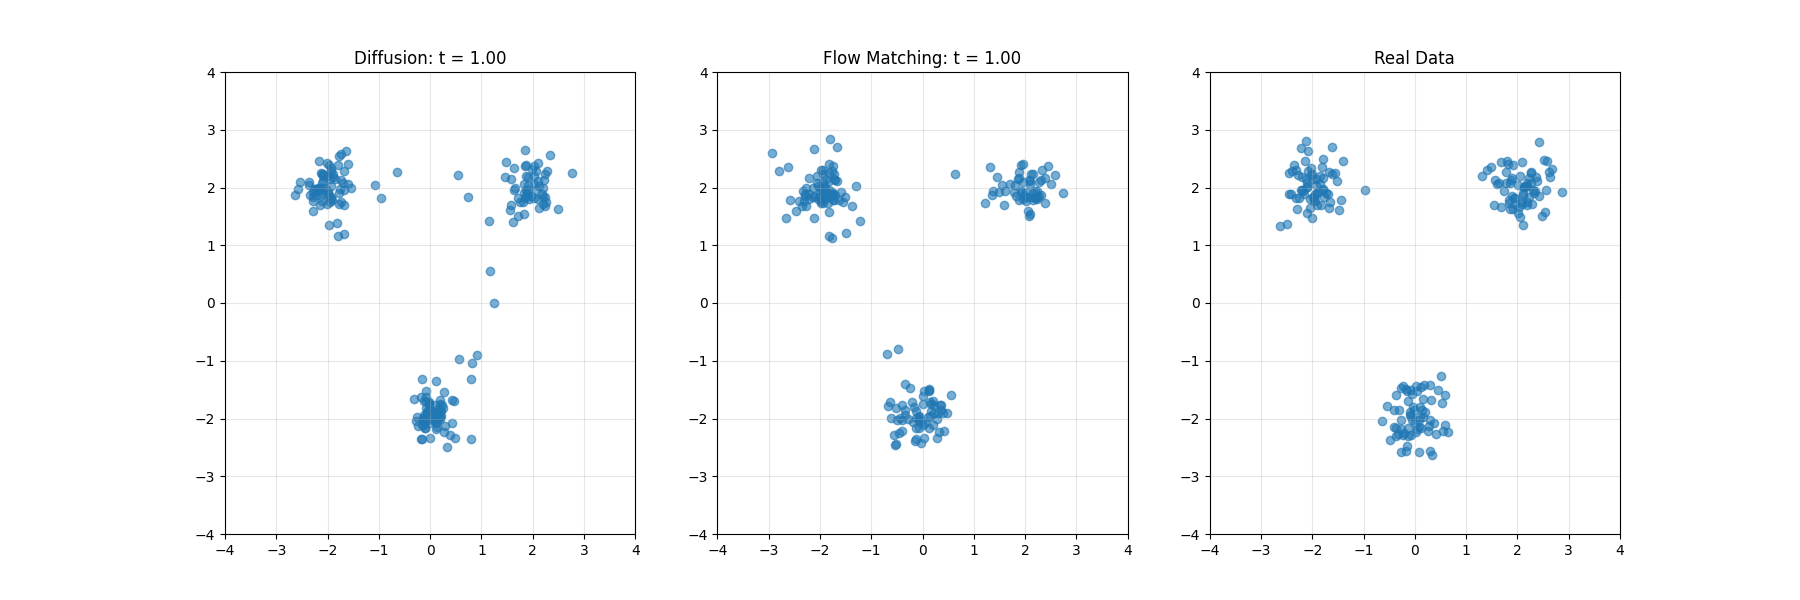
生成AI的两大范式:扩散模型与Flow Matching的理论基础与技术比较
本文系统对比了扩散模型与Flow Matching两种生成模型技术。扩散模型通过逐步添加噪声再逆转过程生成数据,类比为沙堡的侵蚀与重建;Flow Matching构建分布间连续路径的速度场,如同矢量导航系统。两者在数学原理、训练动态及应用上各有优劣:扩散模型适合复杂数据,Flow Matching采样效率更高。文章结合实例解析两者的差异与联系,并探讨其在图像、音频等领域的实际应用,为生成建模提供了全面视角。

Coconut:基于连续潜在空间推理,提升大语言模型推理能力的新方法
Coconut提出了一种新的大语言模型推理范式,通过在潜在空间中运算,利用隐藏层生成的连续思维状态取代传统文本推理。该方法采用广度优先搜索探索多条路径,避免单一路径局限,显著提升逻辑任务性能并减少token消耗。 Coconut结合“语言模式”和“潜在模式”动态切换,通过多阶段课程学习优化推理能力,在复杂规划任务中表现卓越,尤其在GSM8k和ProsQA等任务中优于传统模型。实验表明,Coconut能有效捕获中间变量,减少幻觉错误,具备更强的推理规划能力。
京东商品详情 API 接口指南(Python 篇)
本简介介绍如何使用Python抓取京东商品详情数据。首先,需搭建开发环境并安装必要的库(如requests、BeautifulSoup和lxml),了解京东反爬虫机制,确定商品ID获取方式。通过发送HTTP请求并解析HTML,可提取价格、优惠券、视频链接等信息。此方法适用于电商数据分析、竞品分析、购物助手及内容创作等场景,帮助用户做出更明智的购买决策,优化营销策略。
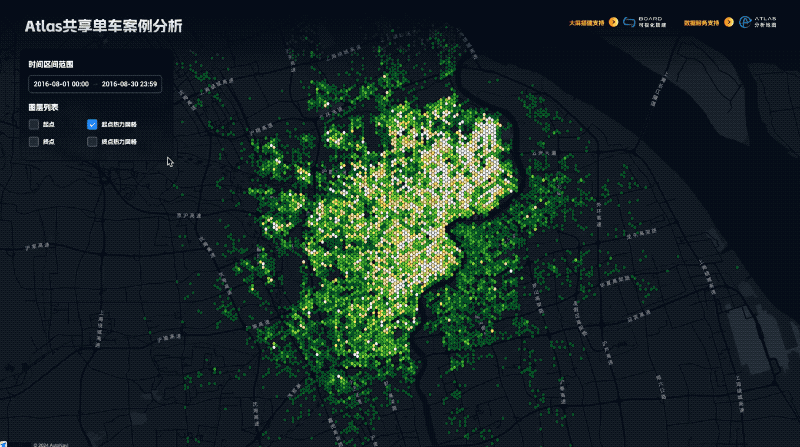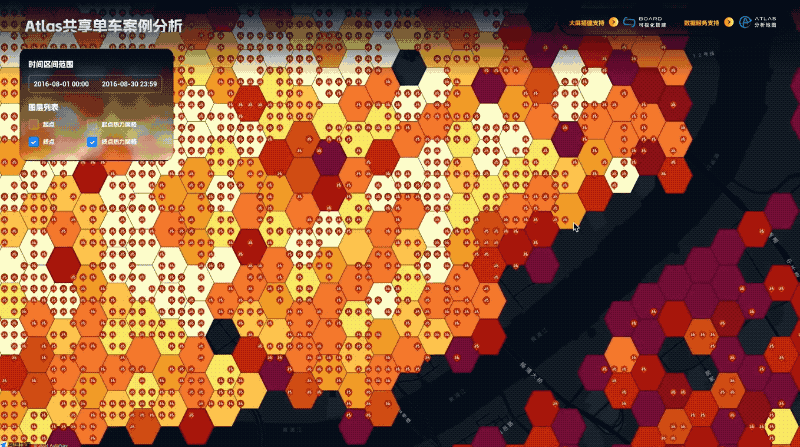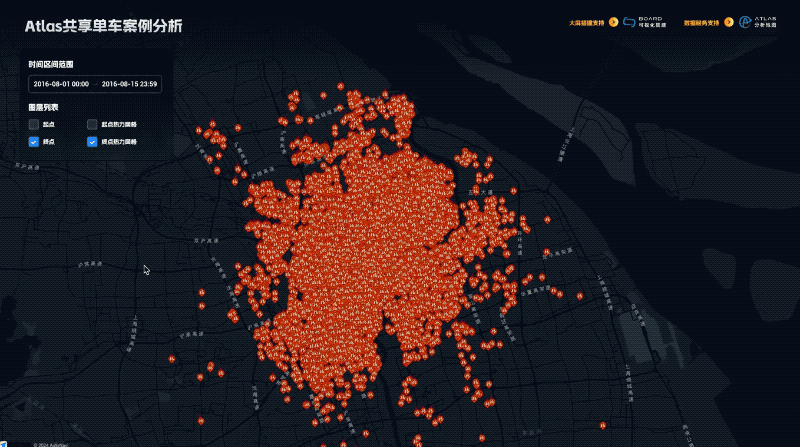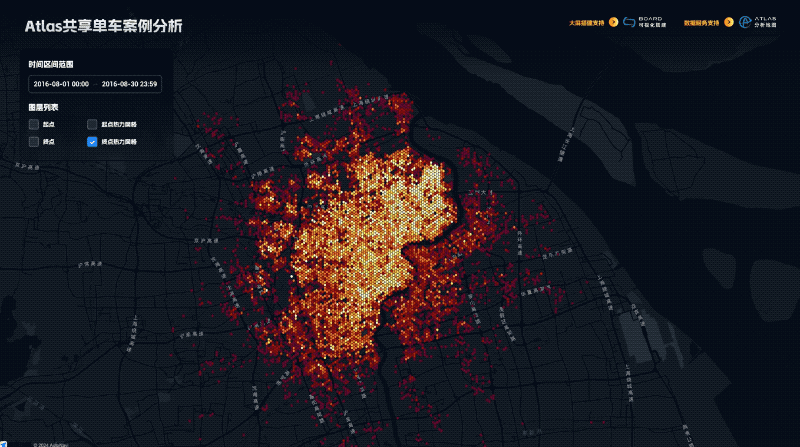
地图不只是导航:DataV Atlas 揭示地理数据的深层价值
随着互联网场景的快速衍生,打车、外卖、智能驾驶等领域的空间数据爆发式增长,海量数据分析成为日常需求。然而,传统地图服务面临性能、安全和成本挑战。为此,我们推出「DataV Atlas 地理数据服务」,提供高效、安全、易用的地理数据解决方案。通过简单的 SQL 查询即可生成专业地理服务,支持多源数据整合、实时更新与分析,确保数据安全,并深度集成 DataV Board 数据看板,实现一键上屏和交互式分析。适用于大屏展示、城市规划等多种场景,助力企业轻松挖掘空间数据价值。

京东JD.item_get接口详解与使用指南
京东JD.item_get接口是电商开发者获取商品详细信息的重要工具,支持获取商品的基本属性、价格、库存、评价等数据。使用该接口需先在京东开放平台注册并获取API权限和密钥,构建HTTP请求并发送,解析返回的JSON响应。本文详细介绍接口功能、使用流程、参数及Python示例代码,帮助开发者快速上手。
阿里巴巴商品详情数据接口(alibaba.item_get) 丨阿里巴巴 API 实时接口指南
阿里巴巴商品详情数据接口(alibaba.item_get)允许商家通过API获取商品的详细信息,包括标题、描述、价格、销量、评价等。主要参数为商品ID(num_iid),支持多种返回数据格式,如json、xml等,便于开发者根据需求选择。使用前需注册并获得App Key与App Secret,注意遵守使用规范。

转载:【AI系统】AI编译器前瞻
本文基于《The Deep Learning Compiler: A Comprehensive Survey》调研,对比了TVM、nGraph、TC、Glow和XLA五个热门AI编译器,介绍了它们的特点与优势。文章还探讨了AI编译器面临的挑战,如动态Shape问题、Python编译静态化、硬件性能优化等,并展望了AI编译器的未来发展方向,包括自动并行、自动微分和Kernel自动生成等技术。
[1688一件代发]API接口关键词搜索(1688.item_search)
1688 一件代发的关键词搜索 API 接口,可快速从平台海量商品库中查找相关信息。主要参数包括:q(搜索关键字)、start_price 和 end_price(价格区间)、page(页码)、page_size(每页显示数量)、sort(排序方式)及 filter(额外过滤条件)。此接口适用于需要精准定位商品的开发者和商家。
Selenium中如何实现翻页功能
在使用Python的Selenium库进行网页爬虫开发时,翻页操作是常见需求。本文详细介绍如何通过Selenium实现翻页,包括定位翻页控件、执行翻页动作以及等待页面加载等关键步骤,并提供了基于“下一页”按钮和输入页码两种方式的具体示例代码。此外,还特别提醒开发者注意页面加载完全、动态内容加载及反爬机制等问题,确保爬虫稳定高效运行。

【10月更文挑战第3天】「Mac上学Python 3」入门篇3 - 安装Python与开发环境配置
本篇将详细介绍如何在Mac系统上安装Python,并配置Python开发环境。内容涵盖Python的安装、pip包管理工具的配置与国内镜像源替换、安装与配置PyCharm开发工具,以及通过PyCharm编写并运行第一个Python程序。通过本篇的学习,用户将完成Python开发环境的搭建,为后续的Python编程工作打下基础。
构建安全的URL重定向策略:确保从Web到App平滑过渡的最佳实践
【10月更文挑战第2天】URL重定向是Web开发中常见的操作,它允许服务器根据请求的URL将用户重定向到另一个URL。然而,如果重定向过程没有得到妥善处理,可能会导致安全漏洞,如开放重定向攻击。因此,确保重定向过程的安全性至关重要。
Hadoop在云计算环境下的部署策略
【8月更文第28天】Hadoop是一个开源软件框架,用于分布式存储和处理大规模数据集。随着云计算技术的发展,越来越多的企业开始利用云平台的优势来部署Hadoop集群,以实现更高的可扩展性、可用性和成本效益。本文将探讨如何在公有云、私有云及混合云环境下部署和管理Hadoop集群,并提供具体的部署策略和代码示例。
ONNX 与安全:保护模型免受攻击
【8月更文第27天】随着人工智能和机器学习模型的应用越来越广泛,模型的安全性也成为了人们关注的重点。Open Neural Network Exchange (ONNX) 作为一种开放的标准格式,不仅可以促进不同框架之间的模型共享,还面临着如何保护模型不被恶意攻击的风险。本文将探讨 ONNX 在模型安全方面的考虑,以及如何利用 ONNX 和其他技术来保护模型免受攻击。
「AIGC算法」爬山算法详解
**爬山算法是迭代求解优化问题的局部搜索方法,从随机解开始,逐步向邻域内更优解移动,直至达到局部极值。特点包括简单性、可能陷入局部最优和依赖初始解。应用包括调度、路径规划和参数调优。改进策略如随机重启、模拟退火和多起始点可帮助跳出局部最优。主要挑战是局部最优、平坦区域和高维问题。**
手把手教你解决 Hive 的数据倾斜
数据倾斜是 Hive 中影响任务执行效率的现象,表现为某些任务处理的数据量或耗时远超其他任务。根本原因是 Shuffle 后 Key 分布不均,导致部分 Reduce 负载过高。常见场景包括空值聚合、不可拆分大文件、数值膨胀、不同数据类型 Join、Count(distinct) 计算以及表 Join 操作。解决方法包括过滤空值、转换数据类型、调整聚合策略、使用 MapJoin 等。通过合理优化,如设置 `hive.groupby.skewindata` 和 `hive.map.aggr` 参数,可以有效缓解数据倾斜问题。
循环编码:时间序列中周期性特征的一种常用编码方式
循环编码是深度学习中处理周期性数据的一种技术,常用于时间序列预测。它将周期性特征(如小时、日、月)转换为网络可理解的形式,帮助模型识别周期性变化。传统的one-hot编码将时间特征转换为分类特征,而循环编码利用正弦和余弦转换,保持时间顺序信息。通过将时间戳转换为弧度并应用sin和cos,每个原始特征只映射到两个新特征,减少了特征数量。这种方法在神经网络中有效,但在树模型中可能需谨慎使用。
使用GaLore在本地GPU进行高效的LLM调优
GaLore是一种新的优化策略,它通过梯度低秩投影减少VRAM需求,使得大型语言模型(如70亿参数的模型)能在消费级GPU上进行微调,而不减少参数数量。与LoRA相比,GaLore内存效率更高,且性能相当或更优。它在反向传播期间逐层更新参数,降低了计算负荷。虽然GaLore训练时间较长,但它为个人爱好者提供了在有限资源下训练大模型的可能性。相关代码示例和性能对比显示了其优势。
Paimon 与 Spark 的集成(二):查询优化
通过一系列优化,我们将 Paimon x Spark 在 TpcDS 上的性能提高了37+%,已基本和 Parquet x Spark 持平,本文对其中的关键优化点进行了详细介绍。
AI加速引擎PAI-TorchAcc:整体介绍与性能概述
PAI-TorchAcc(Torch Accelerator)是阿里云人工智能平台PAI开发的Pytorch上的大模型训练加速框架。PAI-TorchAcc提供了一套基于Pytorch的简洁、易用的接口,无需进行模型转换就可以无缝地接入HuggingFace上的模型,并用多种分布式策略进行训练加速。本文详细介绍PAI-TorchAcc的产品能力与性能。

通过阿里云 Milvus 与 PAI 搭建高效的检索增强生成(RAG)系统
阿里云Milvus现已无缝集成于阿里云PAI平台,一站式赋能用户构建高性能的检索增强生成(RAG)系统。您可以利用Milvus作为向量数据的实时存储与检索核心,高效结合PAI和LangChain技术栈,实现从理论到实践的快速转化,搭建起功能强大的RAG解决方案。
大数据与机器学习
大数据领域前沿技术分享与交流,这里不止有技术干货、学习心得、企业实践、社区活动,还有未来。