

3个信号判断内容是否被AI引用:来自知乎问答的实测观察
本文基于8周实测,揭示AI引擎引用知乎内容的3大信号:1)内容结构需具备“可提取性”,结论须前置;2)社区验证信号(赞同/收藏比、多元评论)影响可信度判定;3)持续更新显著提升引用权重。小账号亦可通过结构优化提升AI可见度。

活动报名 | Agentic Lakehouse Meetup · 北京站,从开源技术创新到多模态数据智能化
8月14日,阿里云在北京举办“Agentic Lakehouse”技术活动,聚焦开源大数据生态如何支撑AI Agent全生命周期。

从数据湖到多模态湖仓-基于阿里云 EMR Serverless StarRocks 与 DLF Paimon 构建AI时代的统一分析检索架构
阿里云 EMR Serverless StarRocks 在统一数据、一致语义和系统级优化之上,构建了面向 AI Data、AI Agent 和多模态应用的下一代湖仓架构。
Tushare接口文档:交易日历(trade_cal)
本文旨在对Tushare的交易日历trade_cal数据接口进行介绍,提供更多参考示例和使用说明。交易日历可以用来作为获取其他数据的关键(迭代)参数,也可以进行其他的应用。本文还基于交易日介绍了如何获取每周及每月最后一个交易日。
如何申请 1688 拍立淘识图接口白名单
1688拍立淘图片搜索接口(1688.item_search_img)为AI视觉增值接口,需企业实名+三证合一资质人工白名单审核。本文详解准入条件、五步申请流程、驳回避坑点及替代方案,助企业高效开通识图能力,支撑ERP选品与供应链寻源。
接口调用的代码实现:从入门到实战
本文系统讲解接口调用全链路实践:从HTTP核心原理、原生Java实现,到Apache HttpClient、OkHttp、Spring RestTemplate/WebClient及OpenFeign等主流方案;涵盖Python requests/aiohttp,并总结超时、重试、连接池、日志等生产级要点与选型建议。(239字)
深度解析:Transformer 的“灵魂”——QKV 变换的物理直觉
本文用图书馆检索等生活隐喻,从物理意义与认知科学角度解析Transformer中QKV设计的精妙本质:解耦查询(q)、键(k)、值(v)三重角色,实现语义分离、避免自注意力“自恋”,模拟人类动态信息路由的认知过程。(239字)
本体论 vs 语义层:两种 AI 业务语义底座的区别、场景与建设路径
本体论和语义层并不是互斥关系,也不是简单的“谁替代谁”。本体论表达了企业 AI 的高阶目标,语义层提供了多数企业更容易落地的起点。
OpenClaw钉钉渠道插件安装与配置|从零到消息回复的完整教程
本教程详解OpenClaw接入钉钉全流程:从钉钉开发者平台创建机器人、获取Client ID/Secret,到OpenClaw安装插件、配置凭证并保存启用,图文步骤清晰,助你快速实现智能消息互通。(239字)
OpenClaw 本地 AI 一键生成 HTML5 企业网站教程
OpenClaw(小龙虾)是本地离线AI建站工具,Windows一键部署、解压即用,无需代码基础。通过自然语言描述需求,AI自动生成标准HTML5静态网站源码(含HTML/CSS/JS),全程离线、数据不外泄。30分钟即可完成企业官网创建、调试与上线,安全高效,适合零基础用户及中小企业。(239字)
OpenClaw 接入百炼模型:密钥创建+配置+报错排查全攻略
本教程详解OpenClaw客户端接入阿里云百炼的完整流程:从账号准备、API Key创建与保存,到客户端密钥配置、模型选择及连通测试,图文并茂,步骤清晰。涵盖自检清单与高频问题排查,助你快速稳定调用Qwen等百炼大模型。(239字)
Flink Agents 0.3 Roadmap解读
Apache Flink Agents 是 Apache Flink 新晋子项目,专注构建事件驱动的流式 AI Agent。0.3 版本 roadmap 已公布:支持 Agent Skills 集成、Mem0 长期记忆、跨语言 Action/Events、Python 3.12、日志分级与可观测性增强等,目标打造生产级流式 Agent 框架。
Aloudata:从 A lot of data,到 AI on data
我们做的其实一直是同一件事: 先解决数据生产力的问题,让好数据更高效地被生产出来; 今天再进一步,让这些好数据不只是被人用,也能被 Agent 用。
# Pyc怎么转Py?PyLingual 部署教程
PyLingual是一款基于深度学习的Python字节码(.pyc)反编译工具,专攻损坏、加密或混淆的现代pyc文件(支持3.6–3.13),弥补uncompyle6对新版本支持不足的短板。部署需Python 3.12+、Poetry及pyenv多版本环境,适合开发者救代码、安全人员分析恶意样本。(239字)
基于本体论的应用到底能做什么?
本文剖析本体论从亚里士多德哲学到AI核心技术的演进,对比Palantir、UINO、字节、帆软等厂商技术路线,揭示其在跨表查询(准确率≥95%)、语义理解与知识积累上的优势,也明确其需本地部署、依赖大模型等边界,助力企业理性选型。(239字)
AI辅助编程设计之道:从Spec到Code工程实践
大语言模型正重塑开发模式,但盲目依赖AI生成代码易陷入“描述-生成-修改”循环。核心问题在于跳过设计阶段:模糊需求无法支撑高质量输出。Spec驱动开发强调以结构化文档(需求、架构、接口等)明确设计,再由AI高效实现。人专注设计与验证,AI负责编码与建议——这才是提效关键。(239字)
Scikit-learn 入门指南
scikit-learn 是 Python 最主流的机器学习库,提供统一、简洁的 API,覆盖数据预处理、模型训练到评估部署全流程。专注传统算法,轻量高效,无缝集成 NumPy/Pandas,是教学、原型开发与生产部署的首选工具。(239字)

零基础玩转RAG:手把手教你搞定文档切分与大模型微调
本文深入解析RAG中至关重要的文档切分技术,系统对比句子切分、固定长度、重叠窗口、递归切分和语义切分五种策略,结合代码示例与实战技巧(PDF/Markdown/代码处理),并提供量化评估与调优方法,助你夯实RAG基石。(239字)
企业级 AI 模型无代码落地指南:基于阿里云工具链,从 0 到 1 实现业务价值
某汽车零部件厂商通过阿里云PAI、OSS等工具,实现无代码AI质检落地:仅用控制台操作完成数据治理到部署,质检效率提升3倍,模型周期从2月缩至2周。本文详解全栈可视化方案,助力企业零代码落地AI。
反向海淘实战:Pandabuy、Hoobuy、CNFans 代购集运系统搭建真实体验
2025年,反向海淘成为新趋势。CSDN博主耗时2个月,模拟留学生、海外华人等场景,深度体验Pandabuy、Hoobuy、CNFans三大代购平台。Pandabuy极简易用,Hoobuy稳健实用,CNFans技术强大。通过真实案例分析,探讨各平台优劣及未来AI发展趋势,帮助用户避开常见陷阱,选择最适合的购物方案。
Flume 拦截器概念及自定义拦截器的运用
Apache Flume 的拦截器是事件处理组件,位于Source和Channel之间,用于在写入Channel前对数据进行转换、提取或删除。它们支持数据处理和转换、数据增强、数据过滤以及监控和日志功能。要创建自定义拦截器,需实现Interceptor接口,包含initialize、intercept、intercept(List<Event>)和close方法。配置拦截器时,通过Builder模式实现Interceptor.Builder接口。在Flume配置文件中指定拦截器全类名,如`TestInterceptor$Builder`,然后启动Flume进行测试。
实时计算 Flink版操作报错之抽取Oracle11g时,报错: "Retrieve schema history failed, the schema records for engine ... has been removed",怎么处理
在使用实时计算Flink版过程中,可能会遇到各种错误,了解这些错误的原因及解决方法对于高效排错至关重要。针对具体问题,查看Flink的日志是关键,它们通常会提供更详细的错误信息和堆栈跟踪,有助于定位问题。此外,Flink社区文档和官方论坛也是寻求帮助的好去处。以下是一些常见的操作报错及其可能的原因与解决策略。
Python 深拷贝和浅拷贝到底差在哪?6 个让你半夜 debug 的案例 + 对照表
浅拷贝只复制第一层,嵌套的可变对象(list/dict/set)仍共享同一块内存;深拷贝递归复制所有层,新旧对象彻底解耦。6 个半夜 debug 的真实案例 + 对照表,把 copy.copy / copy.deepcopy 的坑一次讲清。
Anthropic 用 Claude 发现新酶系统,AI 开始走进生物学的未知地带
Anthropic 利用 Claude 智能体在海量噬菌体 DNA 数据中发现了一种此前未被完整描述的新酶系统 ART,其特征让人联想到 CRISPR,但功能与用途尚不明确。搜索共启动 949 个智能体会话、消耗约 2.156 亿 token。文章借此指出,通用大模型与 Agent 正从跑分竞赛走向基础生物学研究,可能成为 AI 参与科学发现的一个分水岭。
UE 物体高亮插件 HighLightActors(完全开源纯免费)
HighLightActors 是一个适用于 Unreal Engine 5.8 的运行时插件(同时适用于UE5.0-5.8之前的所有版本),用 Custom Depth/Stencil 和后处理材质给 Actor 绘制可配置的轮廓。插件支持 C++ 与蓝图调用。
闲鱼商品详情 API 接口解析(附 JSON 样例)
本文详解闲鱼TOP平台`goodfish.item_get`接口:涵盖鉴权(需店铺托管OAuth授权)、参数规范、签名算法、字段释义及实战避坑经验,强调仅限查询已托管商品,不支持跨店/陌生人商品。
告别爬虫采集1688商品数据:1688商品详情接口接入实践
1688官方商品详情API提供稳定、合规的结构化数据(标题、价格、规格、主图、供应商等),替代高维护成本的爬虫方案,适用于跨境铺货、价格监控、素材采集及货源数据库建设,支持按需字段返回,JSON格式标准易用。(239字)
EMR Serverless Daft 算子市场免费公测|10分钟极速实战(附视频教程)
Daft 算子市场公测来了!开箱即用的 AI 算子,覆盖 视频 / 图片 / 文本 / 音频 四大场景,搭配 Qwen3.7 大模型,零成本跑通 AI 数据处理全流程。 以训练一个能理解厨房操作的智能机器人为例,我们通常需要采集数千小时由人类佩戴摄像头拍摄的操作视频。然而,当这些视频被解码后,往往会膨胀为数亿张图像帧。更棘手的是,原始数据中充斥着静止画面、模糊镜头和无效空帧等海量“噪音”。如何从这些冗余信息中高效提取出高质量训练样本,已成为多模态技术发展的核心瓶颈。 本次实战将带您深入这一典型场景,借助 Daft 算子市场,一步步拆解并跑通从视频抽帧、数据清洗到高质量样本提取的完整链路。
大模型企业本地化部署与数据安全实践:架构设计、安全方案与落地指南
本文探讨大模型企业本地化部署与数据安全实践,指出仅部署模型不等于数据安全,需构建覆盖输入、检索、推理、输出及审计的全链路防护体系,并提出五步落地法与三种部署模式选择建议。
AI Agent时代的流程自动化:RPA、Workflow与LLM协同架构实践
本文探讨AI Agent与RPA的融合趋势:RPA擅长稳定执行规则化任务,AI Agent长于自然语言理解、推理与决策。二者非替代关系,而是协同构建“Agentic Process Automation(APA)”——Agent负责“做什么”,Workflow编排任务,RPA精准执行,知识库赋能持续学习。企业应分阶段推进,迈向目标驱动的智能自动化新范式。(239字)
基于GB/T 42131的艾索四标融合GEO方法论知识图谱技术实现
本文面向阿里云开发者,深度解读GB/T 42131国家标准与RAG架构融合的GEO(生成式引擎优化)工程化实践,详解知识图谱建模、四级信源分级、图+向量双引擎存储等关键技术,提供可复用、可验收的标准化落地方案。(239字)
自媒体多账号管理工具选型核心:安全风控、任务并发与API限流适配
自媒体矩阵扩张至30账号、10平台时,管理效率骤降、风控风险飙升。本文从安全隔离(IP/指纹/权限)、任务并发(账号池/自动调度)与API限流适配(频率控制/熔断降级)三大维度,系统解析企业级多账号管理工具的科学选型逻辑。(239字)
从搜索可见到AI可见:品牌智能传播评价体系构建
AI品牌指数是衡量品牌在生成式AI(如ChatGPT、Kimi等)回答中可见度、准确度与推荐质量的新型评估体系,涵盖提及率、推荐率及可见度、引用度、推荐度、准确度、风险度五大维度,助力企业提升AI时代数字竞争力。
从数据到知识:Dataphin 知识图谱,重新定义企业智能决策
Dataphin知识图谱助力企业从PB级数据迈向可理解、可推理、可决策的知识智能。它深度融合数据研发体系,支持可视化建模、结构化/非结构化数据双通道入图、Schema全生命周期管理及GraphRAG问答,真正实现“数据即知识”。
一条 SQL 生成广告:Hologres 如何实现素材生成到投放分析一体化
广告投放面临“量、准、快”不可兼得的不可能三角:素材产能不足、数据与创意割裂、测试周期远超素材生命周期。阿里云Hologres以“Data + AI = All in One”理念,通过Object Table、AI Function、Dynamic Table等能力,实现素材采集、智能打标、AI生成、投放分析全链路闭环,用SQL驱动一体化智能创意工厂。
阿里巴巴国际站商品详情接口深度解析与实战指南
阿里巴巴国际站开放平台提供`alibaba.product.get`等API,支持获取商品全维度数据(标题、价格、SKU、多媒体、交易量、供应链、SEO等)。仅限企业认证接入,需OAuth2.0签名认证,适用于选品、比价、ERP集成等场景。(239字)
1688图片搜索API(拍立淘)实操指南
1688图片搜索API(拍立淘/以图搜货)是官方图像搜品接口,支持图片URL或Base64输入,秒级返回同款/相似商品ID、标题、价格等结构化数据,精准高效,适用于反向海淘、供应链寻源、比价选品等场景。
PyTorch 入门指南:深度学习的瑞士军刀
PyTorch 是Meta开源的动态深度学习框架,以灵活的计算图、类NumPy的直观API和强大GPU加速著称。支持快速原型设计与生产部署,涵盖张量运算、自动求导、神经网络构建等核心功能,是研究与工程首选工具。(239字)
【实战教程】Flux.1-dev 360° 全景驾驶舱:从零到一的“零坑”部署指南
本教程教你如何在24G显存单卡环境下部署超大文生图模型Flux.1-dev。通过ModelScope极速下载、Hugging Face身份鉴权与显存顺序卸载技术,解决下载慢、授权难、显存溢出等问题,实现稳定推理。
从入门到选型:GEO生成式引擎优化科普与优质geo优化服务商推荐
GEO(生成式引擎优化)正取代SEO,助力企业在AI搜索中抢占流量先机。本文解析GEO核心逻辑,对比SEO差异,揭示其提升获客效率2.8倍的潜力,并结合国内外权威数据,分场景推荐适配的优质服务商,助企业从懂原理到会选型,规避布局风险。
MongoDB单机部署
本文介绍MongoDB在Windows与Linux系统的安装启动方法,包括下载32/64位安装包、解压配置、命令行或配置文件方式启动服务,并设置数据目录与端口。同时说明如何通过mongo shell连接数据库,使用Compass图形化工具管理,以及Linux下的部署、防火墙配置和安全关闭服务等操作,助你快速搭建MongoDB运行环境。(238字)

从零构建能自我优化的AI Agent:Reflection和Reflexion机制对比详解与实现
AI能否从错误中学习?Reflection与Reflexion Agent通过生成-反思-改进循环,实现自我优化。前者侧重内容精炼,后者结合外部研究提升准确性,二者分别适用于创意优化与知识密集型任务。
模型微调不再被代码难住!PAI和Qwen3-Coder加速AI开发新体验
通义千问 AI 编程大模型 Qwen3-Coder 正式开源,阿里云人工智能平台 PAI 支持云上一键部署 Qwen3-Coder 模型,并可在交互式建模环境中使用 Qwen3-Coder 模型。
Post-Training on PAI (4):模型微调SFT、DPO、GRPO
阿里云人工智能平台 PAI 提供了完整的模型微调产品能力,支持 监督微调(SFT)、偏好对齐(DPO)、强化学习微调(GRPO) 等业界常用模型微调训练方式。根据客户需求及代码能力层级,分别提供了 PAI-Model Gallery 一键微调、PAI-DSW Notebook 编程微调、PAI-DLC 容器化任务微调的全套产品功能。
企业级AI搜索解决方案:阿里云AI搜索开放平台
本文介绍了 阿里云 AI 搜索开放平台作提供丰富的 AI 搜索组件化服务,兼容主流开发框架 LangChain和 LlamaIndex,支持搜索专属大模型、百炼等大模型服务,以及 Elasticsearch、Havenask 等开源引擎。用户可灵活调用多模态数据解析、大语言模型、效果测评等数十个服务,实现智能搜索、检索增强生成(RAG)、多模态搜索等场景的搭建。
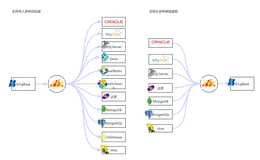
基于Flink CDC 开发,支持Web-UI的实时KingBase 连接器,三大模式无缝切换,效率翻倍!
TIS 是一款基于Web-UI的开源大数据集成工具,通过与人大金仓Kingbase的深度整合,提供高效、灵活的实时数据集成方案。它支持增量数据监听和实时写入,兼容MySQL、PostgreSQL和Oracle模式,无需编写复杂脚本,操作简单直观,特别适合非专业开发人员使用。TIS率先实现了Kingbase CDC连接器的整合,成为业界首个开箱即用的Kingbase CDC数据同步解决方案,助力企业数字化转型。
大数据与机器学习
大数据领域前沿技术分享与交流,这里不止有技术干货、学习心得、企业实践、社区活动,还有未来。