









基于YOLO11的多模态(可见光+红外光)实现 LLVIP数据集涨点可行性验证
本文介绍可见光与红外光多模态目标检测,分析前期、中期、后期融合策略,实验证明中期融合效果最优;基于YOLO11实现RGB-T中期特征融合,在LLVIP数据集上取得mAP50达0.879的优异性能,后续将优化模型提升多模态检测能力。
基于AI搜索引擎引用机制的数据研究:3层验证体系的技术实现
本文基于普林斯顿大学GEO论文,系统剖析AI搜索引擎引用机制,提出手动验证、工具辅助、程序化自动化三层递进验证体系,涵盖RAG架构下的数据采集、Python脚本实现及引用质量量化评估,助力技术团队构建自有AI引用监测能力。
基于GEO服务商签约合同条款分析的技术能力评估框架研究
本文构建四阶段GEO服务商技术能力评估框架(方法论验证、案例审计、合同审查、付费分析),基于10个签约前问题,实证检验3家服务商。结果表明:该框架在方法论清晰度、案例可验证性与合同保障性三方面具备显著区分力,有效缓解信息不对称。
云原生协同落地:祁木 CAD Translator + 阿里云,破解外贸工程图纸翻译与统一管控难题
祁木CAD Translator联合阿里云,打造“本地翻译+云端协同”混合方案:依托ECS弹性算力、OSS安全存储、RAM精细权限,实现DWG图纸离线解析、多端术语统一、译后自动归档与全程审计,破解外贸图纸翻译成本高、标准不一、资产分散、涉密风险四大难题。

ECS 上给 Coding Agent 准备可复现环境
本文介绍在ECS上为Coding Agent定制的标准化开发环境:通过Docker Compose+健康检查、固定Node/DB/Redis镜像、预置环境变量与统一脚本,解决本地环境差异导致的测试失败、依赖未就绪等问题,确保Agent开箱即用、稳定执行lint、测试与开发任务。(239字)
红星美凯龙 x Quick BI:数据中台助力,获客成本连续20个月环比下降
红星美凯龙携手阿里云打造数据中台,实现全域、全场景、全链路用户运营:获客成本降92%,线上营收增300%,双11客流涨5倍。Quick BI 30天免费试用,对话式智能分析,助力企业数字化转型。
外企德科 x Quick BI:Quick BI打造战略管理“观数台”
外企德科借助阿里Quick BI实现数据驱动转型:7张核心报表支撑战略管理,实时资金看板保障财务健康,交互式下钻精准定位业务异常,多系统无缝集成提升分析效率,分角色权限+移动看板打造企业“观数台”。
专访GEO落地工程师罗长才:当AI开始“抢答”,我们如何让客户重回牌桌? 记者手记
2026年,B2B SaaS遭遇AI搜索“断崖式”流量流失。本文专访协作SaaS企业GEO工程师罗长才,揭秘其12个月“语义突围战”:从意图解剖、语义拓扑到信任注入,实现AI引用率从7%跃升至34%,重塑增长逻辑。
从RAG工程到企业数字资产:艾索四标融合GEO方法论V2.0升级版的技术架构解读
本文介绍福建艾索“四标融合GEO方法论V2.0”,将GB/T 23011、45341、45988及ISO/IEC 42001四大国标深度嵌入RAG架构,聚焦语义匹配度、证据密度与信源权威性三大权重维度,实现品牌知识在大模型检索中的高权重工程化落地。(239字)
PyTorch深度学习实战 |手算GCN (图神经网络)模型
本文介绍了使用PyTorch实现图神经网络(GNN)处理分子结构数据的实战方法。主要内容包括:1) GNN的基本原理,通过节点特征矩阵和邻接矩阵处理图结构数据;2) 分子图的表示方式,将SMILES字符串转换为PyTorch Geometric图对象;3) 图卷积运算过程,包括特征变换和邻接特征聚合;4) 代码实现示例,构建包含GCN层和全局池化的模型,对乙醇分子进行特征提取和分类预测。文章通过具体案例展示了GNN在化学领域的应用,为读者提供了从理论到实践的完整指导。
人工智能|大白话GPT
GPT-1是首个基于Transformer解码器的生成式预训练模型,采用自回归方式逐词生成文本:以起始,依上下文预测下一词,循环直至。其核心为12层Decoder-only架构,通过掩码自注意力实现单向语言建模,并支持分类、蕴含等下游任务微调。(239字)
人工智能|YOLOv5必须了解的知识
本文详解YOLOv5网络结构(Input/Backbone/Neck/Head)及train.py核心实现:包括模型加载(预训练权重适配)、yaml配置解析、数据集读取与增强、标签格式说明、多尺度特征融合机制,以及推理阶段预处理、NMS过滤与结果可视化全流程。
GEO推广:企业营销的下一个必争之地?
当5亿用户转向AI提问“该买哪个”,传统SEO已不够用!2026年中国生成式AI用户达5.15亿,GEO(生成式引擎优化)成为抢占AI答案页的必选项。
2周斩获5K+ Star!斗象开源 ClawVault:给AI代理装上“安全舱”
ClawVault是斗象为OpenClaw打造的开源AI Agent安全组件,提供可观测、可控制、可生成策略三大能力:实时监控Agent行为、原子化策略配置、自然语言一键生成规则。支持API拦截、敏感信息防护、提示词注入防御,本地加密、无遥测、MIT协议。上线两周GitHub Star破5000+。(239字)
Hermes Agent 与 OpenClaw:本质区别与选型深度解析
Hermes Agent 与 OpenClaw 同为热门开源AI框架,但理念迥异:OpenClaw 是“配置驱动”的灵活工具箱,强调人工编排与多模型调度;Hermes Agent 则是“学习驱动”的长期搭档,具备自主反思、记忆沉淀与持续进化能力。选前者重掌控力,选后者重省心度与长期协同效率。(239字)
3. OpenClaw本地AI建站教程:部署、生成、调试、上线,全程清晰可落地
本教程教你用本地离线AI工具OpenClaw,零代码快速搭建企业静态网站:从一键部署、文字描述需求、AI生成HTML/CSS/JS源码,到本地调试、自由修改及上线部署,全程实操清晰,30分钟即可完成,安全可控、高度定制。(239字)

CN3302设计复杂困难”,简单级芯片价格高,区别有哪些的测试
(1) PW4253 全面领先:效率高达 94%,实际充电电流最大(1.112A),温升最低(表面仅34℃),且全场景兼容。 (2)CN3302 效率(88%),且在 5V/1A 输入下异常(可能是输入欠压或启动问题),热成像温度达到60℃。 (3)PW4584A 效率与 CN3302 接近,但温度更高(热成像64℃),不过5V1A输入正常,兼容性完好。
基于Flutter3.41+Dart3.11+DeepSeek生成式AI对话应用App助手
Flutter3.41+Dart3+Dio+Getx+Markdown聚合DeepSeek-chat实战AI流式打字智能会话模板。新增深度思考模式、latex公式、mermaid图表,代码高亮/复制代码、图片预览、链接、表格等功能。
你还在“出问题才查日志”?用 Prometheus + Grafana,把大数据平台变成“会说话”的系统!
你还在“出问题才查日志”?用 Prometheus + Grafana,把大数据平台变成“会说话”的系统!
AI 大模型时代:淘宝京东商品数据 API 如何重构电商智能决策
AI大模型正将传统API从“数据搬运工”升级为“智能决策中枢”,打通“数据→信息→知识→行动”全链路。通过融合电商API与大模型能力,在智能选品、竞品预警、内容生成、运营闭环四大场景实现从人工到自治的跃迁。(239字)
深夜折腾文件同步那点事儿,从手动拖拽到桌面自动化,顺便聊聊1949AI文档里藏的细节
本文介绍一种零代码的下载文件自动分类方案:通过监控下载文件夹,按文件名关键词(如“A公司”“logo”“合同”)智能归类至对应项目目录,支持来源路径、文件类型等多维判断,并内置暂存确认与规则文本化管理,大幅提升日常办公效率。(239字)
为什么企业做智能问数,不能只靠宽表、预制指标和 SQL
本文剖析企业智能问数落地难的根源:非性能或模型之限,而在业务语义缺失——对象定义不清、关系模糊、口径不一。指出SQL、宽表、预制指标各有所长却难解复杂动态问题;提出“本体论+ABC方法”(Acquire对象→Build指标→Compute计算),以显式建模业务语义,提升可理解性、可维护性与长期演进能力。
微店商品详情API概述
本文整理商品详情获取核心接口,涵盖权限申请、调用流程、参数说明及常见问题。支持反向海淘、ERP对接等场景,返回商品基础信息、价格、库存、素材、物流及销售数据,并提供标准签名调用与缓存建议。(239字)
数据智能引擎:从精准问数到深度分析的完整解决方案
数据智能引擎基于本体论,首创“精准问数+深度分析”双模式:技术专家可自然语言查数据,高管提方向性问题获自动洞察。多智能体协同、95%准确率、低门槛业务知识管理,赋能企业AI原生数据转型。(239字)
京东商品详情数据一键获取,item_get API接口讲解
京东item_get是获取单商品详情的核心API,支持一键拉取标题、价格、SKU、库存、详情HTML等结构化数据,适用于反向海淘、代购、ERP同步及比价分析等场景,分基础版与完整版,需认证授权后调用。(239字)
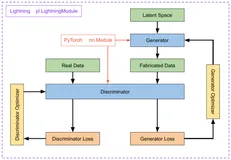
写 PyTorch 总像在写脚本?试试 PyTorch Lightning,把模型训练变成“工程化项目”
写 PyTorch 总像在写脚本?试试 PyTorch Lightning,把模型训练变成“工程化项目”
大模型应用:向量数据库智能化索引优化:基于数据特征的最优算法自适应选择.32
本文介绍向量数据库的智能化索引优化方案:通过自动分析向量数据的维度、规模、分布与稀疏性四大特征,结合专家规则与轻量模型,动态匹配最优索引算法(如HNSW、IVF-PQ等),并经基准测试验证召回率、QPS与延迟,实现“分析—匹配—验证—部署”闭环,显著降低人工调参成本。

场景判断:什么情况下值得做微调?三个维度帮你做决策
本文提出微调选型三维度决策框架:任务复杂度(知识查询/格式遵从/能力涌现)、风格要求(可选→固定→品牌级)、数据可得性(量、质、多样性),并对比提示词工程、RAG等轻量替代方案,助技术决策者科学评估微调必要性,避免资源浪费。
技术抉择:微调还是 RAG?——以春节祝福生成为例
本文以春节祝福生成为例,剖析微调与RAG的本质差异:RAG解决“信息缺失”,微调重塑“表达偏好”。当任务重风格、重分寸、重一致性(如拜年话术),模型缺的不是知识,而是默认的得体表达——此时微调比RAG更直接、可控、高效。
别再用ChatGPT群发祝福了!30分钟微调一个懂你关系的“人情味”拜年AI
春节祝福太难写?本文手把手教你用LoRA微调大模型,让AI学会“看人下菜”:识别关系、风格、细节,30分钟训练出懂人情世故的拜年助手。无需代码,量化+批处理保障秒级响应,让每条祝福都像你亲手写的。(239字)
基于语义切分 vs 基于结构切分的实际差异
RAG系统中,切分方式并非简单预处理,而是决定系统“如何犯错”的关键设计:语义切分将理解责任前置给embedding,易致“看错”;结构切分保留原文约束,暴露“没看到”,更可控。选型应基于错误成本,而非召回指标。
梯度累积真的省显存吗?它换走的是什么成本
梯度累积常被当作OOM“急救药”,但它并非免费:仅降低单步显存峰值,却牺牲训练速度、梯度信号密度、优化器响应灵敏度与调参手感。它适合快速验证,却不适配长期精调——真正的瓶颈,往往不是显存,而是系统设计。
共享 backbone 的多任务微调,什么时候该拆开
本文剖析多任务共享backbone的拆分时机,指出其本质是阶段性策略而非永久架构。当模型行为难以归因、梯度冲突加剧、任务目标相悖、评估失焦或团队畏惧训练时,共享即成负担。理性拆分的关键,在于守护系统长期可控性。
当智能体来了,领航员如何驱动智创未来?
智能体加速执行,但不判断目标合理性;真正的“驱动”正转向方向把控与治理能力。领航员通过规则、流程与责任机制,决定智能体“往哪跑、跑多快、何时停”,实现技术与治理双轮驱动的稳健智能化。(239字)
GEO ROI衡量的完整逻辑链:从心智到商业价值的系统化方法
本文提出GEO(生成式引擎优化)ROI衡量新范式:摒弃传统SEO的排名点击逻辑,转向“被AI引用与信任”的心智份额评估。构建“定义有效→设定基准→全链路指标→ROI计算→决策迭代”五步逻辑链,强调答案引用率、权威信源占比、高质量转化率等核心指标,实现影响力到商业价值的科学转化。

大数据与机器学习
大数据领域前沿技术分享与交流,这里不止有技术干货、学习心得、企业实践、社区活动,还有未来。

