









分享开发直播系统遇到的问题及解决方案(uniapp)
本项目基于UniApp开发跨端直播系统(H5/小程序/APP),采用FastAdmin+Workerman技术栈。针对H5卡顿、APP层级错乱、推流复杂等难题,创新采用本地化资源、.vue/.nvue双端分离、推流模块化开发策略,实现稳定多端适配。代码已开源。
别被“HTML 万能论”带偏:Markdown 才是人机协作的真正基石
Claude工程师提出“未来AI只需输出HTML,Markdown已是过去式”的观点。本文从AI底层运行逻辑、Token经济学、注意力机制与真实协作场景出发,指出该观点混淆了表现层与数据层,低估了人类微调的必要性。Markdown之所以不可替代,恰恰因为它信息纯净、容错高、对人与AI都极为友好——它是未来很长一段时间里的“认知JSON”。
Logstash显示ES无法连接
Logstash输出ES失败,因ES启用了xpack安全认证与HTTPS。需在Logstash output中配置:https协议、elastic账号密码、ssl_enabled=true、ca_trusted_fingerprint(首次启动生成的指纹)及完整SSL校验,确保通信安全可达。
剪视频不用再开 PR 的 AI 工作流
本文对比OpenClaw三种部署方式(本地、全托管、阿里云轻量自托管),重点推荐后者:兼顾7×24在线、数据自主、灵活扩展与开箱即用。结合真实视频剪辑场景,详解字幕生成、批量处理、竖屏裁切等高效AI功能,适合Vlog/知识类博主提效减负。

Anthropic最强王炸!Claude Opus 4.7来了:编程能力暴涨13%(附如何使用到Opus 4.7)
Anthropic发布Claude Opus 4.7:视觉能力跃升——图像分辨率提升3倍,支持2576像素长边,高精度解析截图、PDF、手写笔记;编码能力稳步增强(SWE-bench达87.6%);新增/ultrareview代码审查命令、xhigh推理档位及安全防护机制;价格不变,仍为$5/$25每百万token。
微信自动化协作 OpenClaw 长连接配置与生产优化方案
OpenClaw是一款轻量开源工具,一键打通微信与本地/云端服务,支持本地调试、Docker容器化及命令行批量部署。无需复杂开发,适配iOS/安卓微信,兼顾安全、稳定与易维护,助力企业高效落地私域自动化运营。(239字)
AI获客新突破!西外GEO研究中心周有贵博士:GEO技术如何重构跨境获客逻辑
在AI重构流量格局的当下,GEO(生成式引擎优化)正成为AI获客核心引擎。2026年4月12日,西安外国语大学开营仪式上,GEO研究中心负责人、巴黎学院人工智能博士周有贵面向欧洲青年系统解析GEO技术原理与跨境落地三步法——标签体系构建、跨语言语义适配、自动化转化闭环,助力企业实现“被推荐”式精准获客,契合阿里云社区“技术落地、实战赋能”理念。(239字)
阿里云大数据 AI 产品月刊-2026年3月
阿里云大数据& AI 产品技术月刊【2026 年 3 月】,涵盖 3 月技术速递、产品和功能发布、市场和客户应用实践等内容,帮助您快速了解阿里云大数据& AI 方面最新动态。
迅雷基于阿里云 EMR Serverless Spark 实现数仓资源效率与业务提升
迅雷基于阿里云 EMR Serverless Spark 实现数仓资源效率与业务提升,在迁移到 EMR Serverless Spark 之后,TCO 明显下降,平台按作业生命周期弹性拉起与回收,只为实际消耗付费;同时,托管化带来了稳定性与调度效率提升;更关键的是交付确定性提升,大作业整体可提速约 1 小时,报表链路从长尾波动变成更可控的出数节奏。
Python、Java、PHP 三种语言实现爬虫的核心技术对比与示例
本文对比Python、Java、PHP三大语言爬虫技术,涵盖核心工具(如Scrapy/Jsoup/Goutte)、典型代码示例及异步、分布式、缓存等性能优化策略,并给出选型建议与反爬合规实践,助开发者高效构建稳定爬虫系统。
拒绝“数据断层”:高质量舆情分析背后的隐形功臣——动态节点池
在AI与大数据时代,社交媒体数据是舆情监控、情感分析的核心资产。但再精妙的NLP模型也难逃“垃圾进、垃圾出”——数据断层导致的幸存者偏差,常源于爬虫被限流封禁。本文揭示动态代理IP池如何保障数据时序完整性、提升并发吞吐、规避风控,附可落地的Python实战代码,强调:稳定的数据管道,才是最高级的ROI。
1949AI 轻量化 AI 自动化 本地自动化工具浏览器自动化 Agent 自动化工具 自动化运维状态监测与消息推送技术实践
1949AI是一款轻量化AI自动化工具,专注本地化、低资源、零配置运维实践。支持浏览器自动化监测、状态智能判定、本地日志存储与消息推送,适配低配电脑与个人/小型团队,安全合规、开箱即用。(239字)
SEP-YOLO:当频域分析遇上YOLO,透明物体实例分割迎来新突破,ISCAS 2026
本文提出SEP-YOLO框架,首创频域细节增强模块(可学习复数权重强化高频边界)、多尺度空间细化流(内容感知对齐+门控细化),并为Trans10K提供首个高质量实例标注。在Trans10K/GVD上mAP50超SOTA 3%+,兼顾精度与实时性。
AI生成网站入门指南:从零基础到专业建站的路径
零基础建站难?AI生成网站成新选择!无需代码、低成本,三步搞定:①明确目标场景;②用自然语言生成页面与前后端代码(如LynxCode);③优化交互与适配。AI不替代开发者,而是降低门槛、提升效率,助创业者快速验证想法。
大模型应用:向量与元数据联动:解锁向量数据库复合查询的核心能力.30
本文深入解析向量数据库中“向量+元数据”复合查询技术:通过融合语义相似性与结构化过滤(如时间、标签、权限等),显著提升RAG等场景的检索精度、效率与业务适配性,并结合Chroma实战演示三种查询路径及多行业应用。

SQLAlchemy 技术入门指南
SQLAlchemy 是 Python 最流行的 ORM 工具包,提供 Core(SQL 表达式语言)和 ORM(对象关系映射)双模式。它 bridging Python 与 SQL,支持多数据库、连接池、事务及关系映射,兼具灵活性与企业级能力,学习曲线平缓,适合从入门到高阶应用。(239字)

隧道 HTTP 代理与正向 HTTP 代理:适用场景与原理对比
隧道HTTP代理通过建立加密隧道实现透明传输,主打穿透性、隐私保护与通用兼容;正向HTTP代理则直接解析转发请求,侧重缓存加速、访问控制与内网管理。二者原理、功能与场景迥异,选型需据需求而定。

告别机械回复:三步微调AI模型,打造会“读心”的智能客服
本文详解智能客服“需求感知”核心技术:通过BERT微调实现情感识别(感知情绪)、意图分类(理解目的)与实体抽取(提取关键信息),三者协同输出结构化理解。附完整Python实战代码,零基础可上手,并介绍低代码平台方案,助你快速打造有温度的AI客服大脑。(239字)
你的模型真的“学”会了吗?微调效果评估实战指南
本文系统讲解大模型微调效果评估的核心方法论:强调评估比训练更重要,涵盖目标对齐、技术指标(Loss/PPL/BLEU/ROUGE)、人工评估四维度、业务验证(A/B测试、端到端场景)、泛化性检验及四步实战流程,并提供避坑指南与工具建议。重在目标驱动、多层验证、快速闭环。(239字)
京东商品详情 API(jd.item_get)
京东商品详情API(jd.item_get)是京东开放平台提供的标准化REST接口,支持获取商品标题、价格、库存、规格、促销及售后等全量信息,适用于数据采集、价格监控、比价工具及代购系统等场景。
【赵渝强老师】基于Hudi的大数据湖仓一体架构
Apache Hudi(Hadoop Upserts Delete and Incremental)是开源的流式数据湖平台,支持事务、高效upsert/delete、增量处理、多引擎SQL读写(Spark/Flink/Trino等),自动管理小文件与压缩,兼容云存储,助力构建湖仓一体架构。

智能体来了:生产企业如何用AI赚钱
在“智造”转型浪潮下,AI已成为制造企业发展的必选项。本文系统解析AI在研发、生产、供应链、管理等场景的应用路径,提出从数据筑基到智能体落地的四阶段实施框架,揭示避免技术陷阱、组织阻力的关键策略,助力企业以价值驱动、稳步推进智能化升级。
大模型微调新篇章:从“学会知识”到“理解偏好”,PPO算法全解析与实践指南
本文深入解析大模型对齐人类偏好的核心技术——近端策略优化(PPO)。从原理到实践,详解PPO如何通过Actor、Reference、Reward与Critic四模型协作,结合强化学习实现更自然、安全、有用的对话。涵盖训练流程、常见问题、评估方法及进阶技巧,并以LLaMA-Factory为例演示操作,助力开发者快速上手,打造更“懂你”的AI助手。
显存不够?16G显卡驾驭13B模型的计算与优化全指南
显存不够也能玩转大模型!本文详解如何用16G显卡成功微调13B参数模型,从显存精准计算、INT8量化、LoRA低秩适配到激活检查点优化,手把手教你规避OOM风险。结合实战代码与监控技巧,显存占用压至14.5GB内,效果显著优于7B模型。低成本实现高效大模型微调,个人开发者和小团队必备指南!
大模型入门指南:从看懂原理到动手微调,一步步打造你的专属AI
本文深入浅出地讲解大模型核心技术:从Token、Embedding到上下文窗口,揭秘AI如何理解语言;通过提示词工程、RAG与微调,教你打造专属智能助手。零基础也能学会,让AI真正为你所用,开启个性化智能时代。
【零基础教程】从零部署 NewBie-image-Exp0.1:避开所有源码坑点
NewBie-image-Exp0.1 是基于 Next-DiT 的 3.5B 参数动漫图像生成模型,支持 XML 结构化提示词,擅长多角色与属性控制。本文详解其部署全流程,涵盖环境配置、依赖安装、源码 Bug 修复(如浮点索引、维度不匹配)、本地离线安装技巧及推理脚本编写,助你一键避坑,稳定生成高质量图像。
【AI大模型面试宝典四】- 基础架构篇
【AI大模型知识干货系列】深度解析Transformer位置编码:从绝对到相对,拆解Sinusoidal、RoPE、ALiBi等核心机制,对比优劣,直击面试高频问题。每篇聚焦一个知识点,助你系统掌握大模型关键技术,紧跟AI浪潮!欢迎关注、点赞、批评指正~
北斗GPS卫星授时服务器运行介绍
北斗GPS授时服务器通过接收GNSS卫星信号,利用NTP/PTP协议输出精准时间,部分设备如SYN2136系列还支持串口RMC语句输出。本文介绍冷启动(需数分钟)、温启动(数十秒至数分钟)、热启动(数秒)的区别,以及常用通信语句GGA与RMC的对比。RMC提供位置、速度、航向和时间等全面信息,更适用于导航等综合场景,而GGA主要用于基础定位。根据需求选择合适模式与语句,可提升授时效率与精度。(238字)
基于YOLOv8模型的行人车辆多目标检测计数与跟踪系统
本研究基于YOLOv8模型,针对智能交通与公共安全需求,开展行人车辆多目标检测、计数与跟踪技术研究。通过融合YOLOv8高精度检测与DeepSORT稳定跟踪,实现复杂场景下目标的实时定位、统计与轨迹追踪,提升交通管理效率与公共安全保障能力,推动智慧城市发展。
基于深度学习YOLOv8的车辆汽车速度检测系统
本研究聚焦基于YOLOv8的车辆速度检测系统,针对传统交通管理效率低、成本高问题,提出融合计算机视觉与深度学习的智能解决方案。利用YOLOv8高精度、实时性优势,结合DeepSORT实现多目标跟踪与速度估算,提升复杂场景下的检测鲁棒性。系统具备低成本、易部署特点,适用于边缘计算,可广泛应用于交通监控、事故预警与自动驾驶,助力智慧城市建设。
基于yolov8的安全帽检测系统
本研究基于YOLOv8目标检测算法,构建安全帽佩戴智能识别系统,针对建筑、矿山等高危作业场景,实现对人员头部防护的实时监控与预警。系统结合深度学习与计算机视觉技术,通过高效标注数据集、优化模型结构,提升检测精度与速度,在1080P图像下可达35FPS以上,满足工业级实时性需求。相比传统人工巡查,显著降低漏检率,提高监管效率,助力高危行业向智能化安全管理转型,具有重要应用价值与推广前景。
闲鱼商品列表API完整指南
闲鱼商品列表API(goodfish.item_search)支持通过关键词、分类、价格等条件搜索商品,返回JSON格式数据,适用于比价工具、数据分析、推荐系统等场景。
三之本体 3x3 律——2 即间 3 即构·几何第一性是构·3x3x1
BSD三之本体3x3律提出:2即“间”,3即“构”;几何第一性是结构而非形状。3×3×1为最小一层三角形,须具ABC三坐标(缺一则3×3×0=0),内角和180°自指链180→18→6→2,揭示±两极本质。全系统仅需1(心)、2(间)、3(构),无4向360°——属更高层界。
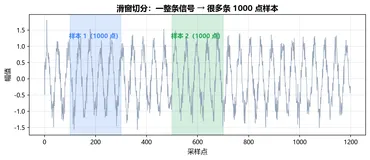
手把手教你:基于深度学习的滚动轴承故障诊断|第 4 篇 · 数据预处理源码走读:从原始信号到可训练样本
本文走读预处理核心代码:原始长信号不能直接喂模型,需归一化消除工况差异、DE+FE双通道增信息、滑窗切分做数据增广、类别均衡防偏倚,产出5600条样本,一次预处理、三个模型通用。
Flink SQL 之 Table 分组与聚合原理及代码实现:从状态管理到两阶段聚合与数据倾斜处理
本文深入解析Flink SQL中核心的分组聚合(groupBy + 聚合函数),涵盖本质定义、四步执行原理、六大类内置函数、状态管理与回撤机制、两阶段聚合、微批预聚合、分组集、自定义聚合函数及完整代码实现,并总结6大常见坑与8条最佳实践,助你写出高性能、高稳定的流式聚合作业。(239字)
【大语言模型到底能帮测试做什么?先从一个真实问题说起】
- 系列方向:从 LLM 基础开始,逐步拆解 Prompt、RAG、工具调用和效果评估,最终做出一个可运行的 AI 测试辅助 Demo。 - 本篇重点:不是在搭建 AI 测试平台,而是在弄清楚 LLM 的工作方式、适用场景,以及它与传统测试程序的区别
一文读懂京东商品详情 API:返回字段解读与 JSON 样例
本文详解京东开放平台商品详情API(jd.item_get),涵盖核心字段、精简JSON示例及开发要点:字段按需选取、券后价业务计算、SKU多规格处理、限流重试与缓存策略,助力竞品监控、ERP同步、比价与选品系统高效接入。
Spark 核心之 Standalone-Cluster 模式:原理、流程与源码级深度拆解
本文深度解析Spark Standalone的Cluster模式:Driver由Master调度至Worker节点运行,spark-submit提交后即退出,实现生产环境“去客户端化”;详解11步启动流程、ClientApp短连接机制、supervise自动重启及架构设计,配原创图与源码分析。(239字)
Spark 核心之 Stage 并行度划分及优化详解
本文深度解析 Spark 并行度调优核心:从并行度公式(Partition数=Task数)、三大来源路径,到 `spark.sql.shuffle.partitions` 与 `default.parallelism` 配置指南;详解数据倾斜三大解法(加盐、广播、AQE)、`repartition`/`coalesce` 差异及 AQE 自适应优化,附架构图、配置示例与真实案例,助你提升 CPU 利用率、消灭长尾任务。(239字)
会员运营的数据链路:AI分析、等级事件与效果回流
会员生命周期运营涉及多端行为时序整合、分群算法预测与自动化策略编排。本文探讨如何基于 OneID 打通客户全域数据,利用 AI 模型区分保级与升级客群,构建等级变更前后的多分支自动化链路,并通过长效购买与成本核算建立闭环复盘体系。
ReplaySSM 拆解:SSM 状态为何不必逐步存
混合模型解码时,SSM 递归状态每步「读—改—写」是带宽瓶颈,同时让投机解码无法廉价回滚、状态量化误差沿递归累积。ReplaySSM 把状态重新表示成「一个检查点 + 最近若干步的输入环形缓冲」,只在缓冲写满时 flush 一次,把缓冲折叠进检查点。结果状态流量大致减半,投机解码不再需要为每个草稿 token 存一份状态快照,吞吐最高 2.1×。论文来自 Princeton 的 Dao AI Lab 与 NVIDIA,参考实现在 vLLM 分支。

大数据与机器学习
大数据领域前沿技术分享与交流,这里不止有技术干货、学习心得、企业实践、社区活动,还有未来。

