









基于深度学习的摔倒检测系统
针对人口老龄化背景下老年人摔倒问题突出,传统检测方法存在佩戴不便、隐私泄露等局限,本研究基于深度学习技术,利用YOLOv8模型与Python开发非接触式摔倒检测系统。通过高效算法与高质量数据集实现精准识别,具备实时性高、适应性强等优势,可广泛应用于家庭、社区及医疗机构,有效提升老年人安全监护水平,减轻照护负担,推动人工智能在智慧医疗领域的融合应用。
1688搜索店铺列表API使用指南
1688开放平台提供搜索店铺列表API,支持按关键词、行业、地区等条件检索店铺信息,适用于市场调研、竞品监控等场景。本文详解接口摘要、参数说明及Python调用示例,助力开发者高效接入。
三、Hive DDL数据库操作
Hive 中的数据库(Schema)是构建数据仓库的基础单位。这次我们来了解 Hive 中创建、查看、切换、修改与删除数据库的 DDL 操作语法与用法,涵盖 COMMENT、LOCATION、DBPROPERTIES 等常用参数,辅以丰富示例与练习,助你扎实掌握 Hive 数据库管理核心能力。
1688店铺详情API使用指南
1688店铺详情API是阿里巴巴开放平台核心接口,支持通过店铺ID获取商家基本信息、资质、等级及主营类目等数据,适用于电商分析、供应链对接等场景。本文详解接口参数、Python调用示例及注意事项,助开发者高效集成与应用。
具身智能:零基础入门睿尔曼机械臂(五)—— 手眼标定核心原理与数学求解
本文系统讲解手眼标定技术,涵盖Eye-in-Hand与Eye-to-Hand两种架构,深入推导AX=XB方程的数学原理与求解方法,结合实际应用场景和操作步骤,为机器人视觉开发者提供从理论到实践的完整指南。
报错解决:Selenium报错“Message: session not created: probably user data directory is already in use” 等
本文详解Selenium操作Edge浏览器时常见的“版本不匹配”和“进程冲突”问题,分析报错根源,并提供手动替换驱动与webdriver-manager自动管理两种解决方案,助你高效稳定实现浏览器自动化。
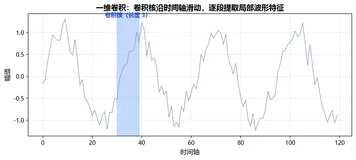
手把手教你:基于深度学习的滚动轴承故障诊断|第 6 篇 · 一维卷积与残差模块:83% 到 95% 的原理拆解
本文拆解83%到95%的原理:深度学习让模型自己看波形。浅层CNN准确率约83%,内圈与滚动体分不清;残差网络引入"捷径"F(x)+x,让网络加深而不退化、解决梯度消失,同数据同评估下准确率提到95%+,是论文最有含金量的一篇。
HDFS Federation:多 NameNode 解决元数据内存瓶颈
HDFS Federation 通过多 NameNode 拆分命名空间,将元数据压力水平分散:各 NN 独立管理自身 Namespace 与 BlockPool,共享 DataNode;ViewFs 提供统一访问入口。它解决单 NN 内存瓶颈(如 4000 万 block 需约 40GB 堆),但不提供高可用——生产环境需与 HA 叠加使用。
在线 IP 定位还是离线库:用调用量、缓存和尾延迟做决策
在线 API 和离线库不是“测试方案”与“正式方案”的区别。两者都可以用于生产,差异主要来自调用规模、延迟预算、数据流向和维护能力。 选型时可以先算真实查询量,再比较年度总成本和故障影响。 业务请求量不等于定位查询量 同一出口 IP、移动网络出口或办公网络可能在短时间内重复出现。如果每次请求都重新查询,会高估调用规模。 加入缓存后,可以先按下面的公式估算: 每日外部调用量 ≈ 每日原始查询量 × 缓存未命中率 + 定期复查量 例如,每天有一千万条访问记录,按 IP 去重和缓存
阿里云技术栈落地实战:60集方言短剧《等你平安归来》的工程化管线搭建与交付
本文是面向开发团队的AIGC短剧生产SOP,以获奖闽南语短剧《等你平安归来》为案例,详解如何基于阿里云函数计算、百炼大模型、ComfyUI与OSS,构建60集方言短剧管线,攻克角色漂移、声调失准、算力调度三大难题,输出可复用资产标准与商业闭环。(239字)
供应链安全成最大风险源,企业如何构建可控的运维体系?
本文剖析云原生时代下供应链攻击新趋势:攻击入口从服务器转向软件依赖,隐蔽性强、扩散快。聚焦DevOps薄弱点,提出开发侧建SBOM与扫描、运维侧强化可视、检测与自动化响应,推动安全从被动到主动、单点到全局升级。
埋点断流告警:零事件、没有数据与查询失败不能是一种状态
低流量没有事件不一定是故障,查询失败也不能补成零。先区分有效计数、窗口未完成、观测缺失和查询错误,再用八个合成场景验收触发与恢复。
Flink SQL 之 Table 自定义 UDF 原理及代码实现:从标量函数到表聚合函数与 TopN 实战
本文系统详解Flink SQL四大类UDF:ScalarFunction(1→1)、TableFunction(1→N)、AggregateFunction(N→1)、TableAggregateFunction(N→N),涵盖原理、注册、使用、性能优化及六大常见坑与八条最佳实践,助你轻松应对中位数、TopN、JSON展开等复杂场景。(239字)
Flink Time 之间断性 WaterMark 原理深度剖析:从触发机制到内部实现与适用场景
本文深入解析Flink断点式Watermark(Punctuated Watermark):它在每个事件到达时通过`onEvent`动态判断是否触发,实现事件级精确水位推进,适用于事务边界、心跳、批次结束等标记事件场景;虽精度高但依赖标记事件,需搭配周期性Watermark兜底防停滞。
金融私有化数据分析架构演进:专有云环境下的客户统一视图与长链路业务诊断
在金融专有云与私有化数据分析平台建设中,关键难点在于打通多端触点与核心账务系统、排查长链路业务断点并健全多层级安全权限。本文围绕金融客户经营需要,探讨统一客户标识、前后端时序对齐、分层经营协同与数据合规治理,为金融数字化选型提供参考。
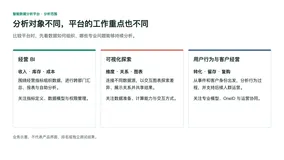
智能数据分析平台的技术路线与选型考量:五个平台的工程实践对比
数字化体系中,不同业务系统产生的数据结构差异巨大,决定了分析工具的接入范式与计算边界。本文对比五个主流智能数据分析平台在数据抽象、计算模型、工程部署及权限隔离等维度的技术路线,梳理从离线集市到实时行为分析的演进考量,并结合实际工程落地条件,为数据工程团队提供选型参考。
Daft AI Function:用 DataFrame 表达式搞定大模型调用与多模态向量化
本文介绍了在阿里云EMR Serverless Spark上通过Daft引擎的AI Function(aiquery、aiembedding、aiembeddingmultimodal)将大模型调用与多模态向量化无缝集成到DataFrame处理链路中的实践方案,解决了传统方式中链路割裂、多模态难统一、并发对齐复杂及模型服务配置繁琐等核心痛点,实现像操作普通列一样完成AI推理与向量化。
0.8MB 跑通 Qwen|第 15-2 篇:推理引擎的 prefill 与 decode——两条路径为何分开
本篇详解Qwen推理引擎中prefill与decode双路径设计:prefill一次性处理整段prompt(如18 token),批量写入KV缓存;decode逐token循环生成,追加KV。通过RK3588真机gdb断点实证,明确二者独立入口、状态流转与性能动因,手搓零依赖纯C引擎的核心逻辑。(239字)
0.8MB 跑通 Qwen|第 11-2 篇:大模型推理的前缀缓存键——怎么知道"两轮一样"?
本系列《0.8MB跑通Qwen》聚焦ARM端零依赖纯C推理引擎,实测RK3588上高效运行Qwen3-VL多模态模型。本文详解前缀缓存核心机制:以token序列最长公共前缀(LCP)为键,实现KV复用;并揭示“完全相同反不复用”的安全设计——确保prefill刷新logits,杜绝空响应。
0.8MB 跑通 Qwen|第 13-3 篇:推理引擎的回退与收益边界——哪些场景 spec 才划算
本文精析Speculative Decoding在ARM端的收益边界:基于RK3588实测,揭示“62%命中率仍变慢”的根源——单步Decode仅44ms时,验证开销与KV回滚反致负增益;明确开启条件:长上下文、高重复性、大模型、贪婪采样。零依赖纯C,适配Qwen3-VL系列。
LangGraph 会话切换与短期记忆管理
本文详解 LangGraph Agent 会话记忆机制:基于 Checkpointer + thread_id 实现多会话隔离与自动轨迹保存;演示 InMemorySaver 的交互式会话管理(切换/查看/清空);提供消息条数、Token 阈值两种修剪方案,并创新引入对话历史摘要压缩,兼顾上下文长度控制与关键信息保留,适配本地 GGUF 小模型开发。
Ubuntu 大模型HF转GGUF全流程实践指南
本文基于Ubuntu 26.04纯CPU环境,详解llama.cpp部署全流程:从Swap配置、依赖安装、源码编译,到Qwen2-0.5B模型下载、HF→GGUF格式转换(convert_hf_to_gguf.py)及Q4_K_M量化(llama-quantize),零CUDA实现轻量中文大模型本地运行。(239字)
LangChain 实现AdvancedRAG增强向量检索生成
Advanced-RAG是工业级RAG优化方案,在朴素RAG基础上不改架构,通过Multi-Query扩召回、MMR多样性检索、LLM上下文压缩、BGE重排序等多层增强,精准过滤噪声、提升上下文相关性与问答稳定性。(239字)
RWA解决供应链金融中的痛点:从应收账款数字化到链上资产融资
供应链金融长期面临“信用难传导、资产难验证”困局:中小供应商缺资金,核心企业信用却无法有效下沉。RWA(现实世界资产)并非简单上链,而是通过数字资产将真实资产、法律权利、业务数据与智能合约深度融合,实现资产状态可验证、确权自动化、融资可编程、结算原子化,构建可信高效的数字金融基础设施。
淘宝评论比价接口实战指南:商品评论 + 价格数据双链路采集与分析
本文详解淘宝“评论+比价”双链路数据整合方案:通过`taobao.item.reviews.get`与`taobao.item.get`等API,打通用户口碑与价格数据,支撑选品、竞品定价、差评归因及智能推荐。涵盖权限申请、签名算法、Python实战及合规红线,助力电商精细化运营。(239字)
企业APP开发中的接口超时与重复提交问题:排查思路与处理方案
APP在网络不稳定或用户连续点击时,可能出现接口超时、重复提交和数据重复等问题。本文从移动端、服务端和业务流程三个方面,整理问题原因、处理方法和测试要点。
AI大模型工具深度运用实践:AI智能体可以代替哪些岗位?企业利用AI Agent降低运营成本的实践分析
本文探讨AI智能体如何重构企业工作流程:从依赖人力与传统软件,转向AI深度参与业务执行。AI Agent不仅能自动完成客服、内容、数据、销售等岗位的重复任务,更通过人机协作提升效率、降低试错成本、加速组织响应,推动企业迈向智能化新范式。(239字)
大模型赋能营销内容创作与广告创意:开启企业智能营销新模式
本文探讨大模型如何赋能企业营销内容创作与广告创意,分析传统内容生产面临的周期长、同质化、反馈脱节等挑战,并系统阐述大模型在选题策划、多渠道改写、个性化生成、A/B测试及数据驱动优化中的应用路径。结合阿里云构建智能营销平台,强调知识库建设、提示词模板、审核流程与工作流集成,兼顾效率提升与合规安全。
AI搜索可信度工程指南:内容可信度、实体优化与知识图谱建设
AI搜索时代,企业网站优化重心正从关键词排名转向可信度、实体权威与知识一致性。内容需真实可验、作者明确、来源清晰;结构化数据(Schema)与知识图谱建设至关重要。赢得AI信任,方能成为其答案生态中的可信知识源。(239字)
Elasticsearch 智能助手:Agent 让运维从经验驱动迈向智能协同
阿里云Elasticsearch智能助手(ES Agent)基于五维数据联动分析,提供自然语言交互式运维能力,覆盖健康巡检、故障诊断、性能优化、容量规划等场景,将专家经验沉淀为可复用Skill,实现从“人工排查”到“智能协同”的升级。
AI搜索引擎引用源选择机制的数据分析:2026年趋势与技术解析
本文系统剖析AI搜索引擎引用源选择机制,提出目标、投入、周期、产出、风险五维分析框架,揭示其“新鲜度偏好、权威性加权、语义匹配优先”特征;指出3–6个月为典型见效周期,强调内容质量、结构化程度与持续产出能力是关键,并提供分级建设策略与三步自检法。
淘宝商品评论 API 接口技术文档(完整 JSON 返回样例)
淘宝官方评论接口taobao.item.reviews.get,支持获取商品全量评价、晒图、追评、SKU、评分等结构化数据。适用于差评监控、舆情分析、竞品口碑等场景,合规稳定、实时精准,分页查询,TOP标准鉴权。(239字)
RAG架构下的GEO工程化实践:四标融合从结构化部署到AI可见度量化
本文介绍生成式搜索引擎优化(GEO)新范式:从传统SEO的关键词排名转向RAG架构下的全链路优化。聚焦语义匹配度、结构化评分与信源可信度三大权重因子,提出以四项国家标准为底座的“四标融合”方法论,并详解Schema标记、知识图谱、AI算法适配等六大工程化落地策略,助力企业提升AI引用率与数字资产价值。(239字)
PyTorch深度学习实战 |Alexnet网络花分类任务项目版本
本文介绍了基于PyTorch的花卉分类实战项目,包含完整的项目架构和代码实现。项目采用AlexNet网络结构,通过YAML配置文件管理参数,实现了模块化开发。文章详细讲解了数据集处理(5类花卉)、模型训练(包含早停机制和学习率调度)、验证评估和预测功能。项目采用YOLOv5风格的目录结构,包含configs、models、utils等模块,支持命令行参数配置。实验结果显示该架构比简单实现准确率提升4%,最终预测功能可输出top-k分类结果及置信度。完整代码已开源,适合深度学习初学者进阶学习。
人工智能|手算Swin Transformer模型
Swin Transformer是一种高效视觉Transformer,通过移位窗口注意力(Shifted Window)替代全局自注意力,结合分层下采样与局部窗口计算,显著降低计算复杂度,同时保持强大建模能力。其核心包括Patch划分、线性嵌入、W-MSA/SW-MSA交替模块及Patch Merging,构成多尺度特征金字塔,已成为目标检测、分割等任务的主流骨干网络。(239字)
优路教育借助阿里云Flink+StarRocks+Paimon湖仓一体化构建职业教育业务全链路实时数据服务平台
优路教育大数据团队携手阿里云,基于实时计算 Flink + EMR Serverless StarRocks + DLF(Paimon) 构建了全链路实时数据服务平台,从学员画像、营销筛选到题库关联查询,实现了从“分钟级延迟”到“秒级响应”的质变,为成人教育行业的数据化转型提供了标杆实践。
宽表 vs 语义层:论 AI 时代语义编织对智能数据分析的重要性
语义层提供的是系统级业务定义,让 AI 能够在更可控的语义框架中理解问题和生成结果。这就是逻辑模型在 AI 时代更重要的原因。
YOLO26如何涨点系列篇(NEU-DET缺陷检测) | CVPR2026 DEGConv方向引导边缘门控,破解细长裂缝检测难题 ,实现涨点
在NEU-DET数据集下验证:原始mAP50原始为 0.722提升至 0.732 , R 原始为 0.643 提升至 0.682 , mAP50-95原始为0.407提升至0.413
手算循环神经网络(RNN)和LSTM
本文介绍了循环神经网络(RNN)和长短期记忆网络(LSTM)的原理与PyTorch实现。主要内容包括: RNN基础:解释RNN处理序列数据的机制,展示输入/隐藏层维度关系,并通过"不好看"情感分析示例演示数据预处理和前向传播过程。 PyTorch实现:详细构建SimpleRNN类,包含RNN层和全连接层,实现正向传播、损失计算和参数更新完整流程。 LSTM原理:对比RNN的不足,说明LSTM通过输入门、遗忘门和输出门解决长序列梯度消失问题。 LSTM实践:修改RNN代码为SimpleLS
2026 国内电商 ERP 权威测评:全链路数字化能力与技术实力深度解析
2026年,电商ERP已成生存刚需。通天晓全链路数字化方案(OMS+WMS+TMS+BMS+SCV)以CyberCloud云平台为底座,实现订单→仓储→配送→财务→决策“四流合一”,提升订单效率60%、库存周转35%、降本20万–50万元/年,赋能多渠道、大促、跨境等复杂场景。
谷歌深夜发布 Gemini 3.5:多模态能力再升级,开发者该怎么抓住这波机会?
Gemini 3.5 Flash于2026年5月发布,主打原生多模态与实时智能体能力:支持图文音视一体化理解、帧级视频诊断、100万token长上下文,并在编码(76.2%)、Agent任务(83.6%)等实测中超越前代。速度快4倍、成本更低,已免费开放。
PAI-Rec 多路召回截断实践:用 PriorityAdjustCountFilter 和 SnakeFilter 控制精排入口数量
PAI-Rec推荐开发平台提供PriorityAdjustCountFilter(按优先级截取)与SnakeFilter(按权重蛇形交错)两种多路召回截断策略,无需粗排即可将数百候选精准压缩至200个以内进入精排,兼顾保量性、多样性与业务可控性。
分享开发直播系统遇到的问题及解决方案(uniapp)
本项目基于UniApp开发跨端直播系统(H5/小程序/APP),采用FastAdmin+Workerman技术栈。针对H5卡顿、APP层级错乱、推流复杂等难题,创新采用本地化资源、.vue/.nvue双端分离、推流模块化开发策略,实现稳定多端适配。代码已开源。
Logstash显示ES无法连接
Logstash输出ES失败,因ES启用了xpack安全认证与HTTPS。需在Logstash output中配置:https协议、elastic账号密码、ssl_enabled=true、ca_trusted_fingerprint(首次启动生成的指纹)及完整SSL校验,确保通信安全可达。

大数据与机器学习
大数据领域前沿技术分享与交流,这里不止有技术干货、学习心得、企业实践、社区活动,还有未来。

