1.Hadoop 概述
1.1Hadoop 是什么
1)Hadoop是一个由Apache基金会所开发的分布式系统基础架构。
2)主要解决,海量数据的存储和海量数据的分析计算问题。
3)广义上来说,Hadoop通常是指一个更广泛的概念——Hadoop生态圈。
1.2Hadoop 发展历史(了解)
1)Hadoop创始人Doug Cutting,为了实现与Google类似的全文搜索功能,他在Lucene框架基础上进行优化升级,查询引擎和索引引擎。
Hadoop创始人Doug Cutting
2)2001年年底Lucene成为Apache基金会的一个子项目。
3)对于海量数据的场景,Lucene框架面对与Google同样的困难,存储海量数据困难,检索海量速度慢。
4)学习和模仿Google解决这些问题的办法 :微型版Nutch。
5)可以说Google是Hadoop的思想之源(Google在大数据方面的三篇论文)
GFS --->HDFS
Map-Reduce --->MR
BigTable --->HBase
6)2003-2004年,Google公开了部分GFS和MapReduce思想的细节,以此为基础Doug Cutting等人用了2年业余时间实现了DFS和MapReduce机制,使Nutch性能飙升。
7)2005 年Hadoop 作为 Lucene的子项目Nutch的一部分正式引入Apache基金会。
8)2006年3月份,Map-Reduce和Nutch Distributed File System(NDFS)分别被纳入到Hadoop项目中,Hadoop就此正式诞生,标志着大数据时代来临。
9)名字来源于Doug Cutting儿子的玩具大象
Hadoop的logo
1.3Hadoop 三大发行版本(了解)
Hadoop三大发行版本:Apache、Cloudera、Hortonworks。
Apache版本最原始(最基础)的版本,对于入门学习最好。2006
Cloudera内部集成了很多大数据框架,对应产品CDH。2008
Hortonworks文档较好,对应产品HDP。2011
Hortonworks现在已经被 Cloudera 公司收购,推出新的品牌CDP。


1.3.1Apache Hadoop
官网地址:http://hadoop.apache.org
下载地址:https://hadoop.apache.org/releases.html
1.3.2Cloudera Hadoop
官网地址:https://www.cloudera.com/downloads/cdh
下载地址:https://docs.cloudera.com/documentation/enterprise/6/release-notes/topics/rg_cdh_6_download.html
(1)2008年成立的Cloudera是最早将Hadoop商用的公司,为合作伙伴提供Hadoop的商用解决方案,主要是包括支持、咨询服务、培训。
(2)2009年Hadoop的创始人Doug Cutting也加盟Cloudera公司。Cloudera产品主要为CDH,Cloudera Manager,Cloudera Support
(3)CDH是Cloudera的Hadoop发行版,完全开源,比Apache Hadoop在兼容性,安全性,稳定性上有所增强。Cloudera的标价为每年每个节点10000 美元。
(4)Cloudera Manager是集群的软件分发及管理监控平台,可以在几个小时内部署好一个Hadoop 集群,并对集群的节点及服务进行实时监控。
1.3.3Hortonworks Hadoop
官网地址:https://hortonworks.com/products/data-center/hdp/
下载地址:https://hortonworks.com/downloads/#data-platform
(1)2011年成立的Hortonworks是雅虎与硅谷风投公司Benchmark Capital合资组建。
(2)公司成立之初就吸纳了大约25名至30名专门研究Hadoop的雅虎工程师,上述工程师均在2005年开始协助雅虎开发Hadoop,贡献了Hadoop80%的代码。
(3)Hortonworks的主打产品是Hortonworks Data Platform(HDP),也同样是100%开源的产品,HDP除常见的项目外还包括了Ambari,一款开源的安装和管理系统。
(4)2018年Hortonworks目前已经被Cloudera公司收购。
1.4Hadoop优势(4 高)
1.4.1高可靠性
Hadoop底层维护多个数据副本,所以即使Hadoop某个计算元素或存储出现故障,也不会导致数据的丢失。
1.4.2高扩展性
在集群间分配任务数据,可方便的扩展数以千计的节点。
1.4.3高效性
在MapReduce的思想下,Hadoop是并行工作的,以加快任务处理速度。
1.4.4高容错性
能够自动将失败的任务重新分配。

1.5Hadoop组成(面试重点)
1.5.1Hadoop1.x、2.x、3.x区别

1.5.2HDFS架构概述
Hadoop Distributed File System,简称 HDFS,是一个分布式文件系统。
1)NameNode(nn):存储文件的元数据,如文件名,文件目录结构,文件属性(生成时间、副本数、文件权限),以及每个文件的块列表和块所在的DataNode等。
2)DataNode(dn):在本地文件系统存储文件块数据,以及块数据的校验和。
3)Secondary NameNode(2nn):每隔一段时间对NameNode元数据备份。
1.5.3YARN架构概述
Yet Another Resource Negotiator 简称 YARN ,另一种资源协调者,是 Hadoop 的资源管理器。
1)ResourceManager(RM):整个集群资源(内存、CPU等)的老大
2)NodeManager(NM):单个节点服务器资源老大
3)ApplicationMaster(AM):单个任务运行的老大
4)Container:容器,相当一台独立的服务器,里面封装了
任务运行所需要的资源,如内存、CPU、磁盘、网络等。

说明1:客户端可以有多个
说明2:集群上可以运行多个ApplicationMaster
说明3:每个NodeManager上可以有多个Container
1.5.4MapReduce架构概述
MapReduce将计算过程分为两个阶段:Map和Reduce
1)Map阶段并行处理输入数据
2)Reduce阶段对Map结果进行汇总

1.5.5HDFS、YARN、MapReduce三者关系

1.6大数据技术生态体系

图中涉及的技术名词解释如下:
1)Sqoop:Sqoop是一款开源的工具,主要用于在Hadoop、Hive与传统的数据库(MySQL)间进行数据的传递,可以将一个关系型数据库(例如 :MySQL,Oracle等)中的数据导进到Hadoop的HDFS中,也可以将HDFS的数据导进到关系型数据库中。
2)Flume:Flume是一个高可用的,高可靠的,分布式的海量日志采集、聚合和传输的系统,Flume支持在日志系统中定制各类数据发送方,用于收集数据;
3)Kafka:Kafka是一种高吞吐量的分布式发布订阅消息系统;
4)Spark:Spark是当前最流行的开源大数据内存计算框架。可以基于Hadoop上存储的大数据进行计算。
5)Flink:Flink是当前最流行的开源大数据内存计算框架。用于实时计算的场景较多。
6)Oozie:Oozie是一个管理Hadoop作业(job)的工作流程调度管理系统。
7)Hbase:HBase是一个分布式的、面向列的开源数据库。HBase不同于一般的关系数据库,它是一个适合于非结构化数据存储的数据库。
8)Hive:Hive是基于Hadoop的一个数据仓库工具,可以将结构化的数据文件映射为一张数据库表,并提供简单的SQL查询功能,可以将SQL语句转换为MapReduce任务进行运行。其优点是学习成本低,可以通过类SQL语句快速实现简单的MapReduce统计,不必开发专门的MapReduce应用,十分适合数据仓库的统计分析。
9)ZooKeeper:它是一个针对大型分布式系统的可靠协调系统,提供的功能包括:配置维护、名字服务、分布式同步、组服务等。
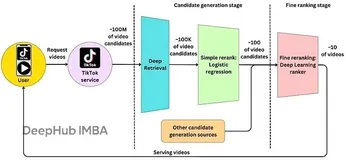
1.7推荐系统框架图