

GitHub 今天涨星榜前十:这 10 个项目分别在解决什么问题
每日速览GitHub涨星榜前十,洞察AI落地新动向:聚焦“让AI真正干活”——从本地语音识别、轻量无头浏览器到Agent记忆与多角色编排,揭示嵌入式与工业场景最急需的端侧AI能力。
Moli 拿下 PH 日榜第一,接入 Codex 后怎样完成一次网页查询?
看到 Moli 拿下 PH 日榜第一,我重新整理了团队已有的 Steam 演示:Codex 如何调用浏览器搜索、打开商品页,再比较《传送门》和《传送门 2》。本文附原始提示词、截图和 51.1 秒视频,也说清哪些是演示结果,哪些数据还需要回到原页面核对。
全平台舆情数据分析工具提升重大突发事件舆情研判效率
在全媒体传播环境下,舆论信息分散在新闻网站、公众号、社媒、短视频平台、本地论坛等不同渠道。由于多渠道信息相互独立,容易出现负面信息发现滞后、数据口径不一、难以评估事件整体影响的痛点。
考古|未知设置直接不让 ES 5.0 启动,设置现在全部要过校验
5.0 起所有设置在生效前都要校验:节点级和默认索引级设置在启动时校验,动态设置在更新前校验,且每个设置必须是"已注册"的。
Python 的赋值为什么不会复制对象?拆开引用、浅拷贝与深拷贝
list 能装下任何类型,是因为它存的是 PyObject* 指针数组:类型信息挂在对象自己头上。代价是每元素 8 字节指针加完整对象头——实测 100 万个整数,list 总内存约 34.3MB,是 array 的 9 倍。本文用 sys.getsizeof 一格格量给你看,并给出什么时候该换 array/numpy 的判断标准
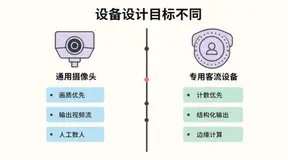
客流设备怎么辨:专用设备与通用摄像头的六个误区
采购客流平台时,“现有摄像头可直接用”半真半假:接口能通≠数据可用。通用摄像重画质,专用设备才为精准计数而生——重轨迹跟踪、去重、边缘计算。误信标称准确率、忽略安装条件、忽视数据合规与三年总成本,易致项目失效。
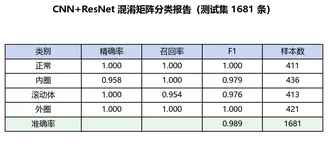
手把手教你:基于深度学习的滚动轴承故障诊断|第 5 篇 · 随机森林实战:传统方法为什么也要做
本期介绍传统机器学习方法随机森林:它像"50位评委投票",原理简单稳定。测试集准确率约73%,虽比瞎猜强,但看不懂波形形状而难再提升。论文里它是完美"对照组",衬托深度学习优势,为后续73%到95%的突破埋下伏笔。
技术方案:背景连通特征与设备约束下的抠图选型
四周底色统一的图片可按边缘颜色与连通关系去色,背景复杂、边缘细碎的图片由分割模型判断前景。本文从背景特征、设备约束和透明度处理三个方面组织选型与验收方案,属于建议流程,未包含实测数据。
图书馆预约管理系统设计与实现(Java、SpringBoot、开题、任务书、15000字、高质量)
本文设计并实现了一套基于B/S架构的图书馆自习室预约管理系统,采用Java开发、MySQL数据库,涵盖用户预约、房间管理、订单跟踪及后台运维等功能,提升高校学习资源管理效率与用户体验。(239字)
HDFS Federation:多 NameNode 解决元数据内存瓶颈
HDFS Federation 通过多 NameNode 拆分命名空间,将元数据压力水平分散:各 NN 独立管理自身 Namespace 与 BlockPool,共享 DataNode;ViewFs 提供统一访问入口。它解决单 NN 内存瓶颈(如 4000 万 block 需约 40GB 堆),但不提供高可用——生产环境需与 HA 叠加使用。
外贸找真买家实务:先定标准、公开核对与分层跟进
现在外贸客户越来越难找了,有没有什么方法能找到真正有采购需求的国外客户?本文直接回答:先把真买家标准写下来,再走公开资料核对与分层跟进;名单数据源与名单质量不包、不代发开发信、不承诺回复与成交。
代账公司如何让专业可感知:从客户比较到服务说明的整理方法
本文针对代账公司“客户只问价格”的痛点,提出将专业能力转化为客户可感知、可核对、可比较的证据:从客户真实问题出发组织内容,统一销售与交付话术,清晰界定服务边界与响应流程。方法务实、可落地,重在提升专业表达的真实性与一致性。
基于微信小程序旧物回收系统设计(Java、SpringBoot、开题、任务书、15000字、高质量)
“物尽其用”微信小程序是一款面向旧物回收的绿色环保平台,集成管理员、回收用户与出售用户三端功能,支持分类查询、设备发布、订单管理、实时定位及评价监管,提升回收效率与资源循环利用率。
Flink SQL 之 Table API 原理及代码实现:从表达式体系到内部执行流程与实战最佳实践
本文深入解析Flink Table API——SQL的类型安全替代方案。涵盖本质定义、八大操作分类、六步执行流程、Expression表达式体系,并通过完整代码演示其优势:编译期校验、IDE友好、动态构建能力强。附六大坑点与八条最佳实践,助Java团队高效开发。
一文读懂微店商品列表 API:请求参数、返回结构与分页逻辑
本文详解微店商品列表API(vdian.item.list.get):涵盖接口说明、必选/可选参数(如access_token、分页、状态与时间筛选)、返回结构及分页逻辑;附JSON样例,并提示限流、增量同步、状态过滤等实战坑点,助力开发者高效对接私域电商、多店管理等场景。(239字)
Flink 2.3 任务提交与架构模型:一次提交,七道手
本文深度解析Flink 2.3任务提交全流程:厘清Client、JobManager、TaskManager与外部组件的分工;详解7步提交链路(从StreamGraph到Task部署);对比Application/Session两种部署模式差异;剖析slot资源与四层并行度(算子/环境/客户端/系统级)的配平逻辑;并总结5大高频故障及避坑指南。
Claude Code给游戏复刻加了两句话:改名也在限制内
Anthropic 技术成员 Addy Osmani 确认,Claude Code 使用 Opus 5.5 时新增两句提示词,限制模型复刻现有特定游戏,即使改名或自称原创也不例外;原创游戏、类型化游戏及自研素材作品仍应正常工作。开发者 chasm 于 10 月 30 日公开该规则且无法关闭。文章同时澄清:一次被拒不等于侵权认定,投诉案例中作者已撤回“获授权”说法,官方留出反馈入口但未公布跨模型测试
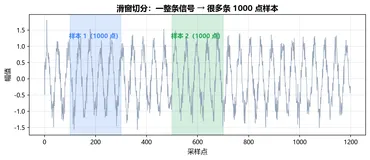
手把手教你:基于深度学习的滚动轴承故障诊断|第 4 篇 · 数据预处理源码走读:从原始信号到可训练样本
本文走读预处理核心代码:原始长信号不能直接喂模型,需归一化消除工况差异、DE+FE双通道增信息、滑窗切分做数据增广、类别均衡防偏倚,产出5600条样本,一次预处理、三个模型通用。
Python 的 list 为什么能装下任何类型?拆开 PyObject* 数组,以及它让你多付了多少内存
list 能装下任何类型,是因为它存的是 PyObject* 指针数组:类型信息挂在对象自己头上。代价是每元素 8 字节指针加完整对象头——实测 100 万个整数,list 总内存约 34.3MB,是 array 的 9 倍。本文用 sys.getsizeof 一格格量给你看,并给出什么时候该换 array/numpy 的判断标准
考古|ES 5.0 把 `string` 拆成 `text` 和 `keyword`,升级后怎么改
5.0 把 string 拆成 text(分词、全文检索)和 keyword(不分词,精确匹配、排序、聚合)。
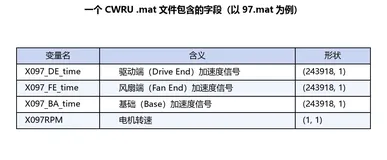
手把手教你:基于深度学习的滚动轴承故障诊断|第 3 篇 · CWRU 数据集深度解析与四类故障波形可视化
本期介绍轴承故障诊断的"教材"——凯斯西储大学公开数据集CWRU。它收录正常、内圈、滚动体、外圈四类故障的振动信号,驱动端与风扇端双传感器记录,免费可靠、论文认,是全世界通用的标准数据,为后续AI模型训练打下基础。
Python 的 str 为什么设计成不可变?拆开字符串驻留、字符串池,以及 += 拼接到底慢在哪
str 不可变换来三件事:hash 一次算完可缓存(dict 查找的地基)、子串切片能安全共享底层缓冲、跨模块传递不用防御性拷贝。实测 += 在 CPython 里已被原地扩容优化,10 万次拼接仍是线性,真正的差距是 join 只分配一次、比 += 快约 19 倍。本文拆开字符串驻留、字符串池与拼接性能把设计逻辑钉死。
熔岩AI日频热度面板MCP数据:消息面 mentions 与 weighted_heat 如何接入量化回测
介绍熔岩日频热度面板(MCP 工具 get_stock_heat_panel)的字段结构、20 个标的/92 天限制,以及把 mentions 与 weighted_heat 接入量化回测时的日期对齐、可用时间与 PIT 口径要点。
竞品被 AI 推荐时通常引用了哪些来源?我把 9,580 次推荐的引用列表分了类
竞品被 AI 推荐时,引用里最多的是媒体和自媒体文章,其次是别家官网,被推荐产品自己的官网只占 1.2%。换成按回答算、再和同题没提它的回答对照,引到它官网或点名讲它的页面是 34.1% 对 5.1%。顺带记下整理时踩的几个坑:合计被两个平台带偏、两组回答长短不一样、标题筛不出盘点文、不带引用的推荐要先剔掉。
同等预算,向量检索吞吐最高约52倍!阿里云 Milvus EAGLE 内存索引性价比实测
阿里云Milvus EAGLE单机性能强劲:1000美元月费下达23,358 QPS(98.11%召回),吞吐超竞品最高52倍;亿级数据下仍保持高召回与低延迟,兼顾性能与成本。
熔岩 MCP 三分钟接入:在 AI 办公软件里查 A股消息面热度
熔岩 MCP 三分钟接入:拿 Key、填 Streamable HTTP 地址与 Authorization,在 AI 办公软件里查 A 股消息面热度。
AI网关与大模型API聚合平台叠加后,路由和重试到底该放哪一层
本文剖析企业同时使用云AI网关与第三方大模型聚合平台时常见的“双层代理”陷阱——两层重复路由、重试、缓存导致模型漂移、会话失效、账单失真。提出“单一策略所有者”原则,明确控制面(网关)与数据面(平台)的工程边界,给出模型/供应双卡目录、端到端重试预算、会话黏性治理及可观测性验收方案。
手把手教你:基于深度学习的滚动轴承故障诊断|第 2 篇 · 环境部署:从零搭建 TensorFlow 2.x 深度学习环境(CPU 版)
本文是《滚动轴承故障诊断》系列第2篇,详解环境部署:基于Anaconda搭建Python 3.9虚拟环境,集成TensorFlow(CPU版)、NumPy、SciPy等核心库,并提供自检脚本与报错速查——打好环境基础,方能顺畅推进后续8篇模型实践。(239字)
Flink 快速入门之 Flink DataStream Batch 模式
本文深度解析Flink 2.x中被移除DataSet API后,DataStream的BATCH执行模式:它不是“慢速流”,而是在调度、数据交换、状态管理三方面彻底重构的批处理范式;详解模式切换带来的行为差异、失效特性(如checkpoint依赖功能)及避坑要点,助你真正用好流批一体。
Flink 快速入门之 Flink 代码编写注意点
本文详解Flink 2.3中十类高频生产隐患,按**提交期、运行期、运维期**三阶段归因:从序列化边界、类型识别、泛型推断,到状态TTL、Timer约定、迟到处理、Async I/O陷阱、uid强约束、Checkpoint落盘等,每条均配避坑写法与原理剖析,助你告别“一周一炸”,打造稳定三年的流作业。
1688 货源→选品筛选→数据清洗翻译→素材处理→跨平台搬家上架→库存 / 价格同步→订单回流采购
1688跨境选品与搬家API方案,打通货源→选品→清洗翻译→图片处理→跨平台上架→库存价格同步→订单回流全链路。支持官方API与低门槛聚合API双路径,适配Amazon、Temu、Shopee、TikTok Shop、Shopify等主流渠道,助力中小卖家高效合规出海。
在线 IP 定位还是离线库:用调用量、缓存和尾延迟做决策
在线 API 和离线库不是“测试方案”与“正式方案”的区别。两者都可以用于生产,差异主要来自调用规模、延迟预算、数据流向和维护能力。 选型时可以先算真实查询量,再比较年度总成本和故障影响。 业务请求量不等于定位查询量 同一出口 IP、移动网络出口或办公网络可能在短时间内重复出现。如果每次请求都重新查询,会高估调用规模。 加入缓存后,可以先按下面的公式估算: 每日外部调用量 ≈ 每日原始查询量 × 缓存未命中率 + 定期复查量 例如,每天有一千万条访问记录,按 IP 去重和缓存
IP 定位 API 验收方法:字段、延迟、错误率与授权边界
选择 IP 定位 API 时,最容易出现的问题不是候选太少,而是测试口径不一致:有的接口测试城市级,有的测试区县级;有的只统计成功请求,有的把超时也算进准确率;最后得到的排名并不能指导上线。 一份可复核的验收方案,应先确定业务目标,再固定样本、指标和失败处理方式。 第一步:把业务目标写成可判断的规则 不要只写“定位要准”。可以改成下面这样的规则: 地域报表:省、市字段非空即可使用; 区域运营:目标区县正确,无法到区县时允许回退到城市; 登录安全辅助:除行政区外,还需要 ASN
IP 地址定位服务怎么分类:专业数据 API、地图定位与公共接口
输入同一个 IP 地址,不同接口可能返回国家、省市、运营商、ASN,也可能只返回一个粗粒度城市。原因不是接口“好或坏”,而是产品类型不同。 在建立候选名单前,先把服务分成专业 IP 数据 API、地图或终端定位能力、公共查询接口三类,可以减少很多无效比较。 三类服务解决的问题不同 类型 常见输入 常见输出 更适合的用途 专业 IP 数据 API IPv4、IPv6 行政区、运营商、ASN、网络类型、风险信号 日志分析、地域展示、网络安全辅助 地图或终端定位 GPS、Wi Fi
Python 的 int 为什么不会溢出?拆开 PyLongObject 和它背后那串变长数组
很多人背过“字典查询是 O(1)”,但为什么是常数?CPython 3.13 实测 dict.get 在 100→10 万规模恒为 0.1 微秒,而 list.index 线性涨到 609 微秒(慢 4743 倍)。本文拆开开放寻址哈希表、扰动函数与 2/3 扩容阈值把 O(1) 钉死,也讲清“创建是 O(n)”这个常被混的点。
代账公司内容发了少人咨询,如何用自有记录定位问题环节
代账公司内容咨询量低?别急着加频换平台!本文提供一套基于自有咨询记录的分流自查法:先判断是“没人看”“看了不问”还是“问完沉默”,再围绕客户真实问题清单组织内容,明确服务边界与可公开凭据,小步调整、按过程指标优化。重在对准问题、降低行动成本。
HDFS 读文件流程:就近定位与故障切换机制
HDFS读取文件时,NameNode仅提供block位置(不传数据),客户端直连最近DataNode就近读取;每读完一个block自动切换至下一block的最优节点,并支持故障透明切换与校验容错——轻量定位、分布式传输、本地优先。
Python 的 dict 为什么查询是 O(1)?拆开哈希表、扰动函数与扩容阈值
很多人背过“字典查询是 O(1)”,但为什么是常数?CPython 3.13 实测 dict.get 在 100→10 万规模恒为 0.1 微秒,而 list.index 线性涨到 609 微秒(慢 4743 倍)。本文拆开开放寻址哈希表、扰动函数与 2/3 扩容阈值把 O(1) 钉死,也讲清“创建是 O(n)”这个常被混的点。
大数据与机器学习
大数据领域前沿技术分享与交流,这里不止有技术干货、学习心得、企业实践、社区活动,还有未来。