


多模态知识库:Agent 终于能看懂截图和表格了
知识库中35%的截图、表格等多模态内容常被AI“视而不见”。本文探讨如何通过结构化解析、三层记忆架构与AI+人工协同,让Agent真正“看懂”图片、PDF与表格,突破知识理解瓶颈。
新人入职第一天,Agent 就能告诉他"这个接口为什么这么设计"
本文介绍一种面向研发团队的知识沉淀新范式:通过三层记忆架构(原子事实、实体卡片、记忆图谱),将散落在老员工脑海、会议纪要、已关闭Issue中的“为什么”类隐性知识结构化沉淀,赋能AI Agent实时解答新人高频问题,加速上手、减少重复答疑、抵御知识流失。
Mem0 和结构化记忆方案在 Agent 场景下的对比实测
本文探讨Agent记忆准确率瓶颈,指出Mem0等向量检索方案在LOCOMO基准中仅约20%召回率,并提出三层结构化记忆架构(原子事实+实体卡片+记忆图谱),兼容Mem0协议,实测准确率提升至79%,显著改善生产环境可靠性。
PostgreSQL表没变大索引却膨胀了——HOT更新的两个前提条件与三个失效场景
PostgreSQL表没怎么变大,索引却膨胀了几倍——这是频繁更新的表最常见的性能退化模式。HOT(Heap-Only Tuple)更新是PostgreSQL针对这个问题的核心优化:当UPDATE不修改任何索引列,且新行能放在同一页时,可以跳过所有索引更新。但HOT有两个前提条件,任何一个被破坏,索引膨胀就会加速。本文从HOT的机制出发,拆解三个最常见的HOT失效场景,给出fillfactor调优策略和n_tup_hot_upd监控方法。
【赵渝强老师】Oracle查询结果集的行号 ROWNUM 详解
本文详解Oracle ROWNUM伪列原理与实战:强调其动态分配、WHERE前生成、不支持>1等特性;对比ROW_NUMBER()窗口函数及12c+ FETCH分页新语法;涵盖TopN、分页、常见坑点与限制,附视频与代码示例。(239字)
没人改代码接口却超时|我给数据库加了四道防线
从交易接口零星超时、优化慢 SQL 却不见效切入,讲清数据库是共享资源池,重查询会饿死交易;给出入口、语句、负载、实例四道隔离防线,拆解超时、资源组、中间件路由与熔断做法,并附负载分级表与隔离验证。
时序数据库InfluxDB内存30分钟从40%飙到98%——高基数问题的四步诊断与四种解法
时序数据库InfluxDB的内存使用率突然从40%飙升至98%,OOM Killer强制终止进程——这是高基数问题的典型表现。TSM引擎为每个序列维护独立的内存索引项,当标签组合爆炸时,序列数急剧增长,内存索引膨胀导致OOM。本文拆解从基数爆炸到OOM的完整链路,给出四步诊断法和四种解决方案,并分析如何从内核层面规避高基数陷阱。
WHERE没走索引,UPDATE锁了100万行——锁范围等于扫描行数的底层逻辑
很多人以为“我只改10行,凭什么锁了100万行”。InnoDB没有真正的“锁升级”机制——它不会主动把行锁升级为表锁。所谓的“锁升级”,本质是WHERE条件没走索引导致全表扫描,扫过的每一行都被加了锁,等效于锁了整张表。本文拆解这个反直觉结论的底层逻辑,分析RR隔离级别下间隙锁的加剧效应,给出三种典型场景和解决方案。
PostgreSQL为什么会进保护性只读|事务ID回卷与表膨胀拆解
从磁盘莫名涨满、集群突然拒写切入,拆解 PostgreSQL 的多版本垃圾回收机制,讲清长事务、悬挂复制槽、空闲事务如何压住回收位点,32 位事务 ID 为什么会绕圈并触发保护性只读,给出膨胀率、最老事务、年龄的排查命令与治理做法。
APISIX 版本升级指南:从离线交付到可控回退
本文详解APISIX网关跨版本升级(3.13.0→3.19.0)的实战要点:强调“升级≠换镜像”,须分层处理程序、静态配置与etcd动态配置;覆盖离线镜像准备、全量备份、三层验证(解析/加载/业务回归)、受控切换及可回退机制,规避路由、鉴权、TLS校验等典型故障。
用 DatI + WorkBuddy 零代码构建带数据库的 Agent 轻应用
本文介绍如何用开源语义网关DatI+微信小程序Agent,实现“数据库即后端”的轻应用闭环:国庆六天行程中,文字/截图自动记账入库(CRUD),假期结束自然语言一键生成交互式PC看板,全程零手写业务代码。
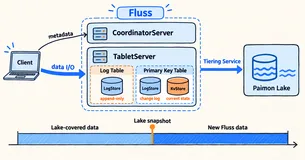
Apache Doris x Fluss:面向湖流一体的统一查询与分析
Apache Doris 5.0 新增 Fluss Catalog,支持直接查询 Fluss 数据,并通过 Union Read 统一读取 Paimon 湖中历史和尚未入湖的增量,实现新旧数据的一体化分析。
存算分离不是先进性|把计算和存储的伸缩账算清楚
从一次扩容里发现瓶颈不在计算切入,把存算分离拆成日志真源化、副本上移、缓存一致性、伸缩解耦四条变化,讲清它与分布式、与本地盘主从的边界,并给出按"两层伸缩节奏是否同频"判断该不该拆的方法与避坑清单。
国际版外卖系统:多语言资源在云上怎么发布
国际版外卖系统云上多语言发布需解耦语言包与支付配置:语言资源(JSON/PO)应存对象存储+CDN,版本化管理、支持快速回滚;支付密钥与回调地址须独立pipeline,严控变更窗口。二者权限、监控、告警均分离,确保语言热修不阻塞支付稳定,大促更安全。
双轨并行架构设计:全量迁移的并行策略、增量同步的延迟基准与双向Master实现
传统数据库迁移面临停机窗口长、数据一致性难保证、故障缺乏回退手段三大结构性挑战。双轨并行方案通过“全量迁移+增量同步+双向回切”的技术组合,将迁移从“一次性大爆炸”拆解为“可验证、可回退的渐进过程”。本文从全量迁移的并行策略、增量同步的日志解析与延迟控制、双向切换的决策点设计、一致性校验的触发机制四个层次展开。
InnoDB Change Buffer:触发条件、Merge时机、SSD时代的价值重估
Buffer Pool是InnoDB最被熟知的内存结构,但Change Buffer是写入路径上另一个关键机制。当二级索引的写入不需要立即读取索引页时,InnoDB会将变更缓存在Change Buffer中,等到索引页被读取时再合并。这个机制让二级索引的随机写入不再产生大量随机I/O,但唯一索引无法使用它,SSD时代它的价值也在被重新评估。本文拆解Change Buffer的触发条件、merge时机、存储结构,以及innodb_change_buffer_max_size的调优逻辑。
下单后不付款、库存被一直占用?订单超时自动取消与库存回补的四种方案与踩坑
用户下单后不付款,库存被订单长期占用,前台显示有货却买不了,盘点账实不符。本文对比定时轮询、Redis过期监听、时间轮、MQ延时消息四种超时取消方案,重点讲延时消息加订单状态机的实现,以及取消前二次校验支付状态、库存回补幂等,避免在付款边界误取消已支付订单。
innodb_flush_log_at_trx_commit三种值详解:数据安全与写入吞吐的权衡
Redo Log是InnoDB持久化的核心,组提交直接决定了数据库在高并发下的写入吞吐上限。innodb_flush_log_at_trx_commit三种值的真实含义是什么?组提交的三阶段流程如何将多个事务的刷盘合并为一次fsync?为什么高并发下写入吞吐不降反升?本文从Redo Log的物理结构出发,拆解刷盘机制、组提交原理与参数调优策略。
Redisson 连接 Redis 失败 报错解决方案
该异常表明Spring创建RedissonClient Bean失败,主因是Redisson无法连接本地Redis服务(127.0.0.1:6379)。常见原因包括:Redis未启动、配置地址/端口/密码错误、Redis保护模式启用或防火墙拦截。建议按“服务状态→配置核对→网络限制”顺序排查,快速定位解决。(238字)
方案写30秒,真断电花了40分钟|我把切换耗时拆成了五段
从一次真实断电切入,方案写30秒切换、实际花了40分钟。把 RTO 拆成检测、决策、执行、应用恢复、数据校验五段,给出稳态指标、七类注入点与命令、爆炸半径分级、中止条件与时间线复盘。
唯客 信息安全管理体系笔记:储备核对、异常处置与仿冒识别
对于开发者与用户而言,判断一个平台是否值得信赖,关键在于看其是否持续投入安全建设,并留下更多可被公众独立验证的技术资产与合规记录。
【赵渝强老师】崖山数据库的行地址ROWID
崖山数据库ROWID伪列高度兼容Oracle,仅适用于HEAP堆表,代表行物理存储地址,为16字节二进制类型。支持SELECT查询与快速定位,但不可INSERT/UPDATE;提供DBMS_ROWID包解析,分布式场景不支持。(239字)
蜜罐实战(二):157 个 IP,怎么从日志里认出背后的“人“
这篇不讲部署,只讲怎么读日志。看 UA 能筛掉三成多的假浏览器(补丁号全零的 Chrome/147.0.0.0),看路径能区分"广撒网"和"有目的",看网段会发现一个 /24 段里 10 个 IP 是同一个人在轮着用。四分之一流量来自 Google Cloud, 专门扫子域名。最后一个是防反制 —— 为什么不建议打回去。 顺带记一个踩过的坑:这版数据是把第一版全部退回重算出来的, 因为一开始我没发现日志里的 IP 全是 CDN 回源节点。
蜜罐实战:我在服务器上埋了 8 个假文件,12 天记录 502 次扫描
本文记录作者12天部署轻量蜜罐的实战观察:502次访问、119个独立IP,聚焦扫描者对`.env`等高危文件的执念。通过伪造配置、运维文档与接口,揭示自动化攻击的真实路径与动机,强调“防泄露重于防扫描”——真正安全始于杜绝敏感信息暴露公网。(239字)
MySQL InnoDB 并发控制核心原理:事务、隔离级别、MVCC 与锁机制
本文深入剖析InnoDB并发控制核心:以“一致性非锁定读(快照读)”与“一致性锁定读(当前读)”为双主线,系统讲解ACID、四大隔离级别、MVCC原理、锁体系及幻读本质,结合时序案例与线上故障,厘清常见误区,助你掌握MySQL高并发底层逻辑。
JOIN关联字段字符集不一致——索引失效最隐蔽的场景与排查实战
字符集不一致是索引失效中最隐蔽的场景之一。JOIN关联字段字符集不同、排序规则不匹配、隐式类型转换——这些问题不会报错,索引在EXPLAIN里也可能显示被使用,但查询性能却差了几十倍。本文拆解字符集与排序规则导致索引失效的三种典型场景,给出排查方法和解决方案,并结合真实案例展示从3秒到0.05秒的优化过程。
生产上跑着七个库|我把它们收进一个之后,账目变了
从一次梳理出七个数据组件、六条同步链路的经历切入,先用跨模型混合过滤讲透"拆开之后"的召回与拼装代价,给出五笔代价清单、四个收敛判断维度、该收敛与仍该独立的两类场景边界,再拆解多模同库的资源争抢与三层隔离手段,最后用收敛前后对比表和分步迁移的回退路径收束。
用户投诉"改过的资料又变回旧的"|异地多活的写冲突到底怎么解
从同城双活上线三个月的用户投诉切入,先分清容灾与多活、钉死"两个写入点必然产生冲突"这个前提,拆出写冲突的三种来源与可量化的冲突率统计,逐个拆解单元化、最后写入胜出、跨中心共识、冲突检测与合并四个方案的机制与代价,给出唯一性约束三种解法与自增号段的扩容陷阱,并配时钟漂移监控与会话粘性的避坑清单。
MySQL索引为什么必须用B+树?从磁盘IO深度推导
本文深入剖析InnoDB选用B+树作索引的底层逻辑,从磁盘与内存万倍性能差异出发,系统对比二叉树、AVL、红黑树、B树、Hash、LSM等结构,阐明B+树“宽矮多叉、叶节点有序链表、目录数据分离”四大优势如何精准适配MySQL OLTP场景,贯通硬件约束、存储引擎实现与SQL调优实践。(239字)
会员次卡莫名被多划一次:门店计次卡核销的幂等、并发扣减与对账实战
会员次卡被多划一次,多半不是前台手滑,而是核销链路上同一笔请求被执行了两遍。本文复盘一家6家分店、1200名会员的连锁美容养生馆次卡事故,讲清核销幂等键、带余额条件的并发扣次、卡次流水日结对账三层做法,让重复扣次客诉降到0。
阿里云国际站如何创建RDS MySQL数据库?从选型到连接完整教程
阿里云国际站部署网站或SaaS时,自建MySQL运维负担重。本文详解RDS MySQL创建、连接、备份、读写分离、慢查优化、迁移及成本管控,助开发者省心上云。
AI数据库的两个时间字段我漏了一个,Agent 的旧记忆盖住了新的
从一次"Agent 记住了却用错"的真实故障切入,讲清 AI数据库做记忆底座时真正要过的两关:写入端的丢、重、乱序,和召回端只按相似度排序的三个坑。含幂等写入、带时效衰减与去重的召回 SQL,以及记忆的有效时间与写入时间的处理方法。
EXPLAIN的partitions列显示全部分区——分区裁剪失效的6种原因排查
分区表的核心价值在于分区裁剪——优化器根据WHERE条件自动排除无关分区,只扫描必要的数据。但分区裁剪并非自动生效,对分区键使用函数、隐式类型转换、OR条件跨分区、分区键与查询条件不匹配等场景都会导致裁剪失效,查询退化为全表扫描。本文拆解分区裁剪的生效条件与6种失效场景,解析分区锁与表锁的关系,并给出分区维护的实战方法。
【数据库数据恢复】SQL Server数据库数据恢复案例—NDF文件0KB损坏修复
成都某单位业务存储设备出现硬件损坏问题,直接导致线上MSSQL数据库异常崩溃。技术人员完成存储重组、数据库文件整体恢复后,核查发现库内4个NDF数据文件大小归零,显示为0KB。 本次故障涉及数据库整体容量约80TB,库内共计1223个数据库文件。业务数据库每10天自动生成一个NDF次级数据文件,单文件容量约500GB,数据库整体包含2个LDF日志文件,数据体量庞大、文件结构复杂,恢复难度较高。
一条查询从50毫秒变340毫秒|分片键选错之后我才看懂架构选型
从一次架构改造后查询变慢切入,按"写入点几个、数据切没切"分开三种架构形态,拆解缓存融合与多数派复制机制,对比各自的瓶颈位置,指出热点两条路线都解决不了,给出带量化指标的选型四步法。
数据集成平台架构:从脚本到平台化的演进
本文讲述数据集成从“脚本乱麻”到“平台化”的演进历程:脚本时代面临散落、无监控、难维护等痛点;平台化阶段聚焦任务统一管理、DAG依赖可视化、失败告警、插件化Reader/Writer及CDC实时同步,最终实现工程化治理。
连接池配错了,数据库CPU飙到100%——连接风暴排查实录
连接池是应用与数据库之间的第一道关口,配置不当会直接拖垮数据库。连接池配得太大,应用重启时会触发连接风暴,数据库CPU瞬间飙满;连接泄漏会导致连接数持续上涨,最终耗尽数据库连接资源。本文从连接风暴的三种触发场景入手,拆解连接泄漏的隐蔽表现、连接状态异常的排查方法,并给出HikariCP关键参数的实战配置建议。
2亿行降到8000万|我放弃分库分表,用分区归档解决了
从接手 2 亿行订单表撞上查询慢、DDL 跑不完、备份窗口爆炸切入,先量热数据占比、写入增长、合规保留期三个数,再用时间分区 + 分区裁剪 + pt-archiver 分批归档 + 归档对账把存量清掉,并给出冷热分离三层架构与三个真实踩坑,最后说明归档是清存量、分库分表才是扩流量。
同城本地生活平台搭建:如何处理数据备份和导出
私有化交付常陷“能下单即验收”误区,致后续数据归属不清、导出困难。本文详解本地生活平台交付必备五项:主库信息、备份策略、业务导出方式、文件路径、只读账号,并强调财务现场核验导出、多业务统一过滤、权限最小化等关键实践,助创业者一次交清数据主权
IvorySQL 在阿里云上验证 Oracle 兼容性:UTL_URL.ESCAPE/UNESCAPE 与 SYS_CONTEXT
该参赛项目为2026直通乌镇·太乙开源竞技赛作品,基于IvorySQL补全Oracle兼容能力:已实现并合入`UTL_URL.ESCAPE/UNESCAPE`(#1728/#1748),完成`SYS_CONTEXT`会话参数支持(#1936,待合入)。全程在ARM架构倚天云服务器上开发验证,践行“真机对照、实测为准”的迁移理念。
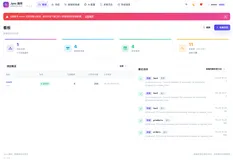
Jync 捷同 · 异构数据库实时同步工具
Jync(捷同)是一款开箱即用的异构数据库实时同步工具,单JAR启动、零外部依赖(无需Kafka/ZooKeeper)、零代码配置。支持Oracle/MySQL/达梦等17+数据库双向同步,自动同步结构与数据,内网离线可用,国产库深度适配。
50毫秒变5秒|SQL没改计划却变了,锅在统计信息采样
从一条日结 SQL 一夜之间慢了一百倍切入,拆解执行计划漂移的根因:InnoDB 统计信息靠随机采样、变更越阈值就重算、基数估不准、代价模型据此改选全表扫描。给出直方图、采样页数、重建统计等治本手段与索引提示的止血边界,并附三个避坑经验。
阿里云国际站通过经销商开户有哪些好处?
企业通过阿里云国际站授权经销商(如聚合云www.juhecloud.online)开户,可享人民币付款、本地发票、中文支持、渠道折扣、账期及迁移代运维等服务,账号仍为独立UID,直连阿里云控制台,兼顾合规性与出海便利性。
CATI电话访问系统的并发架构优化与高接通率算法机制解析
本文解析CATI电话访问系统的高并发微服务架构与智能接通率算法:通过SIP信令集群、Redis号段锁、动态号码池管理、时段预测模型及实时ASR+NLP质检,显著提升系统稳定性与接通率(达28%–35%),实现合规、高效、高质量的自动化调研。
MySQL复制机制深入:半同步复制的两种模式、MGR的Paxos实现与GTID原理
半同步复制解决了异步复制的数据丢失风险,但AFTER_COMMIT和AFTER_SYNC两种等待模式的差异直接决定了故障切换时是否丢数据。MGR基于Paxos协议实现自动选主与脑裂防护,GTID则让主从切换不再依赖手工位点。本文从复制的基本原理出发,拆解MySQL复制的三层机制——异步复制的流程、半同步复制的等待模式、MGR的一致性协议与GTID的全局事务标识,并给出生产环境的选型建议。
从设计到制造:EDG如何串联PLM、CAPP与ERP的数据流
EDG作为主数据枢纽,贯通PLM、CAPP、ERP系统:统一管理零部件编码与多视图数据;驱动设计BOM→工艺BOM→制造BOM的精准传递与校验,确保数据唯一、一致、可溯。(239字)
编码规则设计:原则、方法与要求
本规范确立企业编码八大原则(唯一、完整、准确、适应、继承、拓展、稳定、易用),明确数值/字符编码类型及定长/不定长规则,推荐4层11位数字顺序编码结构,并规定纯数字或大写字母为主、禁用符号汉字、补零对齐等统一要求。(239字)
点一次末页卡20多秒|深分页试完五种解法我才想明白
从运营点了一次列表「末页」卡住二十多秒切入,拆解 LIMIT 大偏移为什么慢、EXPLAIN 的 rows 为什么看不出来,再用覆盖索引与延迟关联、keyset 游标、解耦总数、产品层筛选、宽索引五种方案对比,最后给出该改 SQL 还是该改产品的分水岭判断。
商城搜出已下架商品、点进去却没货:搜索索引与数据库一致性的binlog同步、软删除与延迟双删实践
搜索框能搜到已经下架、售罄的商品,点进详情却提示无货,问题不在搜索引擎本身,而在数据库到索引的同步链路:软删除没被捕获、同步靠定时全量、消息乱序覆盖。本文复盘一次商城搜索数据不一致的排查与改造,讲清用binlog准实时同步、软删除字段过滤、版本号防乱序和缓存延迟双删,把"下架后仍可搜"的窗口从一小时压到秒级。
数据库双轨并行实战:不停机迁移、双向同步与全周期一致性校验
传统数据库迁移面临停机窗口长、数据一致性难保证、故障缺乏回退手段三大挑战。双轨并行方案通过“全量迁移+增量同步+双向回切”的技术组合,实现迁移期间的业务零中断和快速回退。本文拆解双轨并行的技术架构、增量捕获与双向同步机制、全周期一致性校验流程,给出可落地的实施路径。
数据库
数据库领域前沿技术分享与交流