

深度实测Gemini 4 Hydrogen:快到飞起、比GPT省4倍Token,谷歌最能打的主力来了
作者实测谷歌新发布的Gemini 4 Hydrogen,认为其速度远超Carbon、Argon等前代模型,成本也显著低于GPT-6.1 Sol。在AA智商榜High档得51分,Arena盲测总榜第五、知识工作第四。通过烤肉单分账、3D闪电地球等15场测试,Hydrogen均以更快速度和更少Token完成任务,其中3D地球比GPT省4倍多Token,展现了谷歌主力模型的回归。
【云栖特刊】阿里云AI搜索系列产品全新发布-新引擎
2026云栖大会聚焦AI搜索新范式:大模型擅“理解生成”,却难“精准检索”。阿里云发布ES Agent引擎版与AgenticSearch,以亿级租户支持、存算分离、DiskBBQ向量索引等创新,打造Agent时代上下文供给基础设施。
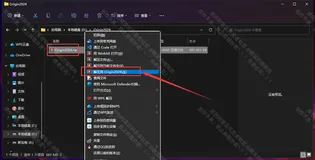
Origin2024 汉化安装专业解析|企业级部署教程+批量激活解决方案
Origin是一款由OriginLab开发的科学绘图与数据分析软件,支持Windows系统,提供丰富的2D/3D图形模板和强大的数据分析功能,如统计、信号处理、图像处理等。本文详细介绍Origin2024的下载与安装步骤,包括解压文件、运行安装程序、输入序列号、安装路径设置及破解方法,帮助用户快速完成软件安装与激活。
DeepSeek Harness 桌面端认证失败或 431 如何排查?
排查 DeepSeek Harness 桌面端认证失败与 431,区分社区报告、请求头证据及针对性清理 cookie 的限制。
理解 Harness 工程:从 Agent 循环到上下文、沙箱、验证与长时运行
这是一本面向AI工程师的精要手册,系统解析Agent核心机制:从最小循环、工具接口与上下文管理,到沙箱隔离、结果验证及超长时运行架构,直击harness工程本质。(239字)
动动嘴就能建模?Blender全流程部署AI建模插件教程 | 零门槛实现AI驱动3D创作
本文为Blender用户详解mcp插件部署全流程:基于MCP协议,实现Cursor等AI客户端与Blender双向通信。无需写代码,一句自然语言即可完成建模、材质、灯光、渲染等3D创作,10分钟极速启用AI生产力。
爬虫实战:如何优雅地抓取网页中隐藏在伪元素(::before)里的文本?
本文揭秘爬虫中“页面可见但代码抓不到”的元凶——CSS伪元素(::before/::after)。它生成的文本不在DOM中,导致requests+BS4失效。文章剖析content四种来源,提供接口直采、CSS正则解析、渲染引擎+代理IP三阶方案,并附Selenium实战代码与避坑指南。(239字)

摸鱼必备-80款在线HTML小游戏
本文推荐了80款精彩的HTML5在线小游戏,涵盖益智、冒险、射击、体育等多种类型,适合各年龄段玩家。无需下载安装,随时随地畅玩。地址:[https://game.share888.top/](https://game.share888.top/)
豆包与Kimi的内容引用机制:信息密度与平台分布解析
本文分析豆包与Kimi在内容引用上的差异:豆包偏好CSDN等平台的高信息密度技术干货,强调可操作性;Kimi倾向知乎、36氪等平台的深度分析与观点类内容,重视论证逻辑。二者均要求内容具备可验证性、数据支撑与语义完整性,为开发者提供AI搜索优化实践指南。

2万字揭秘阿里巴巴数据治理平台DataWorks建设实践
阿里巴巴一直将数据作为自己的核心资产与能力之一,从最早的淘宝、天猫等电商业务,到后续的优酷、高德、菜鸟等板块,DataWorks、MaxCompute、Hologres等产品用一套技术体系来支持不同业务的发展与创新,为企业带来整体的“数据繁荣”。 数据繁荣为我们带来了红利,同时也带动了各类数据治理需求的井喷,特别是降本等需求的不断出现,阿里云DataWorks团队将13年的产品建设经验整理成最佳实践,从数据生产规范性治理、数据生产稳定性治理、数据生产质量治理、数据应用提效治理、数据安全管控治理、数据成本治理、数据治理组织架构及文化建设等7个方面为大家揭秘数据治理平台建设实践
倍思科技 × 阿里云:让VOC洞察从“生成报告”走向“业务可用”
倍思科技联合阿里云,以Agentic Search与Elasticsearch构建VOC洞察系统:将多源数据经模型分析后注入企业知识库,结合业务规则、上下文与记忆,实现精准召回与可信报告生成,让AI真正理解业务、支撑决策。
1688商品详情API(1688.item.get/item.get_pro)全业务场景实战解析
1688开放平台商品详情接口(item.get/item.get_pro)是B2B数字化核心数据源,提供合规、稳定、结构化的全维度商品信息,覆盖SKU、阶梯价、代发规则、资质认证等。本文深度解析其在采购系统、无货源铺货、跨境运营、竞品监控、ERP集成等七大场景的落地逻辑与实战方案。(239字)
AI重构数据价值链,解码「智能问数」如何赋能医药制造
随着中国医药制造业的蓬勃发展,中国已跃居全球第二大医药市场。随着监管政策的深入实施,市场对医药企业在生产、运营、管理等方面提出了更为严苛的要求。2025年政府工作报告明确提出,持续推进“人工智能+”行动,将数字技术与制造优势、市场优势更好结合起来,支持大模型广泛应用。
Microsoft Activation Scripts v3.6 (MAS)激活工具安装教程!中文汉化版(激活工具)
Microsoft Activation Scripts v3.6(MAS)是一款开源、轻量级的批量激活工具,支持HWID、KMS38、TSforge等多种方式,可离线永久激活Win7至Win11及Office全系列。兼容旧系统如Vista,操作简单,无误报风险。
用 Python + 大模型 Agent 自动提取美股财报电话会业绩指引:FMP 数据源拆解博通(AVGO)百亿 AI 芯片订单实战
博通 2025 Q3 电话会全文 4.17 万字符、60 段,41 段是分析师提问。整篇投喂大模型既费 Token,又易把提问当成承诺。改用 FMP 电话会纪要接口拉结构化文本,按「发言人: 正文」锁 CEO/CFO 白名单,筛出 6 段核心语料(2,180 词,省 70.4% 上下文),交 DeepSeek 生成附原句证据的指引表,提取 1,100 亿积压订单等数字。
豆包商品卡优化与ChatGPT量化:GEO特工队AI的工程实践
本文用开发者视角拆解两个AI商业场景:豆包×抖音电商的商品卡,以及ChatGPT Business Hub。讲清豆包运营优化的逻辑:从官方出卡逻辑出发,把商品信息整理成可被召回、可被意图匹配的结构;再回答ChatGPT优化能否量化:用Business Hub第一方数据加多平台抽样监测,给出提及率、引用率的计算口径。文中附商品知识结构、JSON-LD与监测脚本三个示例。

密钥配置+报错排查|OpenClaw 适配DeepSeek完整教程
本教程为OpenClaw(v2.6.4/v2.6.6)对接DeepSeek大模型的零基础图文指南,涵盖实名认证、API密钥创建、配置测试及模型选用全流程,步骤清晰、截图详实,助Windows用户10分钟完成安全稳定接入。(239字)
B2B- 1688 商品详情 API 接口全解析调用
1688商品详情API(alibaba.item.get)是获取批发商品结构化数据的官方接口,涵盖商品基础信息、SKU、供应商、价格、起批量等核心字段。本文详解接口调用前提、签名规则、Python实战代码、限流处理及高频异常解决方案,助开发者快速落地批量选品、价格监控等场景。(239字)
告别爬虫采集淘宝买家秀数据:淘宝买家秀接口接入实践
本文介绍淘宝开放平台TOP买家秀API(taobao.item_review_show),提供合规、稳定、结构化的图文/视频买家秀数据获取方案,规避爬虫面临的DOM变动、防盗链、风控等痛点,附接口参数、返回字段详解及接入避坑指南。(239字)
Python图像处理利器:Pillow (PIL)入门指南
本教程系统讲解Python图像处理库Pillow:从环境搭建、核心概念(Image对象、模式、坐标系)到实战项目(批量图片处理+水印+缩略图),涵盖最佳实践、常见陷阱及NumPy/OpenCV集成等进阶内容,助你高效掌握图像处理全栈技能。(239字)
一行代码,让 Elasticsearch 集群瞬间雪崩——5000W 数据压测下的性能避坑全攻略
本文深入剖析 Elasticsearch 中模糊查询的三大陷阱及性能优化方案。通过5000 万级数据量下做了高压测试,用真实数据复刻事故现场,助力开发者规避“查询雪崩”,为您的业务保驾护航。

别再混为一谈!万字拆解内存与显存:决定你模型训练成败的硬件真相
你好,我是AI科普博主狸猫算君!本文深入浅出解析内存(RAM)与显存(VRAM)的本质区别:前者是CPU的通用办公桌,后者是GPU的专属高速实验室。重点破除“大内存=能训大模型”误区,揭示显存带宽、容量为何直接决定AI训练成败,并提供监控、排错与硬件选配实战指南。(239字)
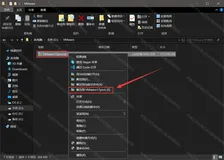
阿里云开发者分享VMware17 Pro保姆级安装秘籍,详细步骤助你轻松搞定安装!
这是一篇超详细的VMware 17 Pro虚拟机下载与安装教程。VMware 17 Pro支持多操作系统模拟运行,适合开发、测试及教育使用。文章涵盖从下载到安装的全流程,包括解压安装包、接受协议、配置安装路径等步骤,并提供虚拟机优化(如安装VMware Tools、配置快照和共享文件夹)及使用指南。同时,针对常见问题如虚拟化未启用或软件阻止启动,提供了具体解决方案,帮助用户顺利部署和使用虚拟机环境。

深度解析:Transformer 的“灵魂”——QKV 变换的物理直觉
本文用图书馆检索等生活隐喻,从物理意义与认知科学角度解析Transformer中QKV设计的精妙本质:解耦查询(q)、键(k)、值(v)三重角色,实现语义分离、避免自注意力“自恋”,模拟人类动态信息路由的认知过程。(239字)
office卸载工具教程!微软官方office卸载工具,怎么解决office卸载不干净怎么弄?Office2021家庭和学生版卸载不干净怎么办?
微软官方Office卸载工具SetupProd_OffScrub,专治卸载不干净难题:一键深度清除Office所有残留文件及注册表项,支持2013至Microsoft 365全系列,重装无忧,安全可靠。(239字)
DeepSeek 把 App 能力开放给开发者,连聊天前端也开源了
DeepSeek 将网页版和 App 背后的整套工具能力开放给开发者 API,包括联网搜索、链接读取、文档图片解析、语音听写与朗读,并开源聊天前端。服务端接管搜索与抓页流程,模型可自动多轮调用工具,兼容 Anthropic、OpenAI 等三种协议。但该能力目前仅限 deepseek-flash(V4.1-Flash),V4-Pro 尚未支持。文章还详解了文件解析的免费与计费边界、图表识别代价及语
DeepSeek Harness:权限里的两道闸,以及「never 就是全放行」这个误解
DeepSeek Harness 的权限预设其实是沙箱模式和审批策略两个独立控制打包。拆开看才发现:`never` 不是自动批准而是直接拒绝,`danger-full-access` 和 `never` 可以同时成立,`allowed-once` 只授权当前那一次。
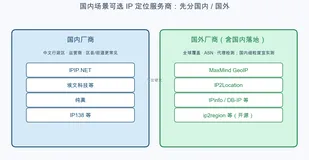
国内外IP定位服务商有哪些?从城市级到街道级的精度差异与技术选型
做网络风控、广告定向或日志归属地分析时,几乎都会碰到同一个问题:国内外能用的 IP 定位服务商有哪些?城市级、区县级、街道级差在哪,该怎么选? 实际选型里,名单通常要先分成两类 :国内厂商和国外厂商。两类在中文行政区、运营商口径、细粒度精度上的侧重点不同,不宜混在一张「谁更准」的表里硬比。 下面按这个分法摊开常见名字,再对照精度差异和选型步骤。各家字段与授权
DeepSeek Harness:启动失败时如何找到完整诊断日志?
了解 DeepSeek Harness 必需插件启动失败时诊断报告的位置、写入失败的替代输出,以及分享前的敏感信息检查。
Spark 核心之 Master 原理剖析
Spark Master是Standalone集群的“指挥中心”,负责Worker注册与心跳、Driver/Executor资源调度(基于SpreadOutApps算法)、应用生命周期管理,并通过ZooKeeper实现主备选举与状态恢复,确保高可用。(239字)
考古|ES 1.0 收掉了旧查询和 _boost,老代码里要验哪几处
1.0 的迁移说明记录了一批移除:text 查询、field 查询、boost 文档级加权、customscore 系列。

MaxCompute问答整理之2020-06月
飞天大数据平台计算引擎MaxCompute成为全球首个TPCx-BB认证的公共云产品,是除Hive、Spark以外TPCx-BB第三个标准支持的大数据引擎。
从”模型调用”到”知识执行”,企业级AI Native系统的技术演进
2026年,人工智能正从”可选项”走向”默认项”,从”辅助工具”走向”原生能力”。企业级AI系统正在经历一次关键跃迁:从早期的模型调用,走向工具编排,再走向Agent工作流,并最终迈向知识执行。本文系统梳理这一技术演进路径,分析各阶段的核心特征、技术瓶颈与突破方向,提出企业级AI Native系统的三层架构模型,并探讨AI深度嵌入软件工程、系统运行和组织流程的实践路径。我们认为,AI Native的终局不是让模型变得更聪明,而是让AI在真实业务约束下稳定地理解目标、调用工具、访问知识、遵守规则、产生可验证的结果,并对结果负责。
刚敲两个字母就有提示,ES 0.90 的 completion suggester 是怎么提前算好的
0.90.3 加入的 completion suggester 把提示数据结构写进索引文件,查询时直接读取;
AI 搜索优化(GEO)实操:AI 搜不到公司时,按这 8 步排查(附 robots.txt、JSON-LD、llms.txt 示例)
AI 搜不到你的公司,多数是因为 AI 能读到的公开网页里没有一段话把你说清楚,或者信息只在 App 里、要登录才能看。本文按「先测、再查、后补」给出 8 步排查清单和 robots.txt、结构化数据、llms.txt 示例,附一家民宿从 0 次到 5 次被 AI 提到的例子。
从0到1:《等你平安归来》60集方言AI短剧的阿里云落地执行方案(FC+百炼+ComfyUI+OSS)
本文详解闽南语AI短剧《等你平安归来》(60集)的阿里云落地实践:以FC调度ComfyUI跑AnimateDiff生成动画,百炼输出结构化剧本JSON,OSS实现四域资产治理,辅以方言声库+母语者校准保障声调准确。35天高效交付,攻克角色漂移、声调失真、算力成本三大难题,形成可复用的多语种AIGC工程化管线。(239字)
DataWorks Data Agent:一句话搞定数据开发,让周期从天级到分钟级
DataWorks Data Agent 是阿里云推出的AI原生数据开发智能体,覆盖集成、开发、运维、治理、分析全链路。它深度适配业务逻辑与开发规范,支持自然语言一键生成可信SQL及全流程交付。淘宝闪购实测:指标开发从6–8小时缩短至5–10分钟,真正实现“一句话交付”。
x±y=±1四象限缺露律——x²+y²=1无法-1性·勾股只覆盖第一象限
BSD四象限缺露律指出:x²+y²=1因平方消符号,仅Q1完备,Q2/Q4被强制折叠,Q3原位空缺(L2_covers=1<4),无法独立支撑圆的四象限生成;而|x|+|y|=1展开为x±y=±1四独立式,全覆盖无折叠。撤回857对L2的特例辩护,坚守“值同≠位同”根本判据。(239字)
AI 搜不到公司怎么排查:先分清没认出、认错了、认出但不推荐
AI 搜不到公司,通常是三种情况之一:没认出、认错了、认出但不推荐。本文给出用三个问题判断的方法,以及每种情况的处理步骤和真实案例。
从代码上下文到千亿级文档:Qoder × 阿里云 Elasticsearch 落地生产级向量检索
阿里巴巴 ATH 事业群 Qoder 技术专家夏晓文分享大规模代码检索的架构选择、工程实践与运行效果,并展望代码、记忆和企业知识的融合检索
MCP 是 API 的下一层?先搞清楚它到底解决什么问题
MCP 是 API 的下一层吗?本文讲清 MCP 解决的 N×M 集成问题、与 API 的本质区别、适用场景和当前已知风险,给 API 服务商一个冷静的接入建议。
淘宝宝贝详情API:通过商品ID获取淘宝商品详情页面数据
本文详解淘宝商品详情API(taobao.item.get):含接口规范、必传参数(num_iid、session等)、HMAC-SHA256签名规则、关键返回字段(标题、价格、库存、详情页等)及常见避坑指南,开箱即用,助力高效解析入库。(239字)
实用工具:VS Code 配置 Markdown 编译器全指南
本文介绍如何在VS Code中配置高效Markdown写作环境,通过启用内置预览、安装Markdown All in One与Markdown Preview Enhanced插件,并配置Princexml实现PDF等格式导出,全面提升编辑、预览与输出效率,适合程序员、学生及内容创作者使用。
DeepSeek Harness 为何报 0xC0000142?
排查 DeepSeek Harness 在 Windows 中返回 0xC0000142 的问题:通过最小命令对比沙箱模式、宿主和输出,理解社区对控制台及 ACL 的不同调查,并在选择只读或完全访问绕行方式前核对权限与安全边界,并通过可复现的步骤判断实际结果,避免依赖未经验证的假设。
第一个月验收GEO交付:怎样核对内容、归属、记录与承接
本文为采购方提供生成式搜索合作首月交付核对指南,强调“先约定清单、再验收月报”。聚焦内容发布、账号归属、AI提及记录、咨询承接及工时投入五类可验证项,要求每项对应具体链接、文件或原始记录,确保交付可打开、可比对、可交接。明确首月仅验过程履约,不预判效果。
大数据与机器学习
大数据领域前沿技术分享与交流,这里不止有技术干货、学习心得、企业实践、社区活动,还有未来。