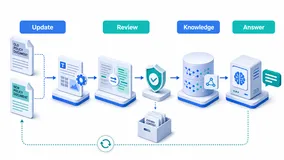
图1:将人物、线索、章节和规则整理为可检查的数据对象。
一、为什么规则怪谈特别需要一致性检查
规则怪谈的悬念通常来自“规则不是表面含义”“人物以为遵守了规则,却仍然出事”。这类故事一旦出现设定矛盾,读者很容易出戏。
常见问题包括:
- 第三章已经失效的规则,第十二章又被当作有效规则使用;
- 主角尚未获得某项能力,却提前完成了对应动作;
- 关键线索已经交代,却在后续章节被角色当作未知信息;
- 某个乘客规则只出现一次,没有对后续主线产生影响。
本文以作者正在创作、已在番茄小说发布的规则怪谈项目《午夜代驾:乘客请遵守规则》作为测试案例,但不讨论作品推广,只讨论如何检查“午夜订单—规则—人物能力—妹妹线索”之间是否一致。
本节结论:规则怪谈的恐怖感建立在规则可信的前提上,而一致性是可信感的基础。
二、先把故事拆成可管理的数据层
不要把几十章正文一次性交给模型。更稳妥的方法,是先把设定整理成结构化数据,再让模型对局部关系做检查。
| 架构层 | 输入内容 | 主要职责 | 输出结果 |
|---|---|---|---|
| 原始素材层 | 大纲、人物小传、章节摘要 | 保留作者原始表达 | 文本资料 |
| 设定卡层 | 人物、规则、线索、地点 | 统一字段与状态 | JSON / 表格 |
| 关系检查层 | 章节编号、已知事实、能力边界 | 发现冲突与遗漏 | 风险清单 |
| 大模型分析层 | 已筛选的相关设定卡 | 解释矛盾原因、给出备选 | 审核建议 |
| 人工决策层 | 作者判断 | 决定保留、修改或制造误导 | 最终正文 |
推荐数据流:
章节摘要
  ↓
提取人物、规则、线索状态
  ↓
按章节编号筛选“此前已发生的事实”
  ↓
规则冲突检测 + 时间线检测
  ↓
将相关卡片交给大模型解释
  ↓
作者确认后修改大纲或正文
本节结论:先结构化、再分析,能避免模型在长文本里遗漏关键设定。
三、用 JSON 保存人物、规则与线索
下面是一个简化的规则卡示例。字段不必复杂,但应能回答“何时生效、谁被约束、违反后会怎样”。
{

  "rule_id": "order-07-rule-02",
  "name": "乘客不得提前报出目的地",
  "effective_from_chapter": 7,
  "effective_to_chapter": 10,
  "targets": ["passenger"],
  "trigger": "车辆驶入旧城区后",
  "violation_result": "乘客身份发生异化",
  "related_clue": "妹妹失踪案中的旧城区定位",
  "status": "active"
}
人物卡则重点保存能力边界:
{

  "character": "林安",
  "chapter": 8,
  "known_information": ["妹妹曾出现在旧城区", "平台会替换违约司机"],
  "abilities": ["能识别部分异常订单"],
  "limitations": ["无法主动修改订单", "不能确认乘客真实身份"]
}
有了这些字段,模型不需要“记住整本书”,只要在检查第八章时读取前八章有效的规则和人物状态即可。
本节结论:设定卡的价值不在格式好看,而在于让每一条规则都有生效范围和可追溯状态。
四、一个最小可用的矛盾检测代码骨架
下面的示例不依赖特定模型,先用规则判断筛出明显问题,再把问题交给大模型分析。
from dataclasses import dataclass
from typing import List

@dataclass
class Rule:
    rule_id: str
    effective_from: int
    effective_to: int
    status: str

def active_rules(rules: List[Rule], chapter: int) -> List[Rule]:
    return [
        rule for rule in rules
        if rule.status == "active"
        and rule.effective_from <= chapter <= rule.effective_to
    ]

def check_rule_reference(
    rules: List[Rule],
    chapter: int,
    referenced_rule_id: str
) -> dict:
    current_rules = {
   rule.rule_id for rule in active_rules(rules, chapter)}

    if referenced_rule_id not in current_rules:
        return {

            "risk": True,
            "message": f"第 {chapter} 章引用的规则不在当前有效范围内",
            "referenced_rule_id": referenced_rule_id
        }

    return {

        "risk": False,
        "message": "规则处于有效状态"
    }
这段代码只能发现“规则已失效却被引用”这类确定性问题。更复杂的情况,例如“主角是否知道这个信息”“反转是否违背前文暗示”,再交给大模型做语义判断。
本节结论:确定性规则交给程序,模糊的叙事判断交给模型和作者。
五、让大模型做“设定编辑”,不要让它直接代写
适合长篇一致性检查的提示词,应明确模型不能擅自补设定:
你是一名长篇悬疑小说的设定编辑。

任务:
根据“当前章节摘要”和“此前有效设定卡”,检查一致性问题。

要求:
1. 只能依据提供的资料判断,不能补充资料中没有的事实;
2. 若资料不足,明确说明“资料不足”;
3. 分别检查:人物已知信息、能力边界、规则有效期、线索状态;
4. 每个问题必须说明冲突的两处资料;
5. 不续写正文,不生成新角色,不替作者决定剧情。

当前章节:
{chapter_summary}

有效设定卡:
{context}
输出建议固定为表格:
| 检查项 | 结果 | 风险说明 | 建议处理 |
|---|---|---|---|
| 规则有效期 | 有风险 | 规则在第 7 章已失效 | 改为旧规则残留,或调整生效时间 |
| 人物知情范围 | 正常 | 林安此前已获得该线索 | 可保留 |
| 能力边界 | 待确认 | 缺少能力获得章节 | 标记为资料不足 |
本节结论:提示词的作用是约束检查范围,而不是替代作者创造故事。

图2:当章节、人物和线索形成关系图后,未回收线索与规则冲突更容易被发现。
六、公有云 API、混合云、私有化部署怎么选
| 使用方式 | 优点 | 局限 | 适合场景 |
|---|---|---|---|
| 公有云 API | 接入快,无需维护推理硬件 | 需控制未发布稿件上传范围 | 灵感整理、少量章节检查 |
| 混合云 | 设定资料与模型调用可分层管理 | 工作流更复杂 | 小型创作团队、稳定长篇项目 |
| 私有化部署 | 对本地稿件和设定库控制更强 | 需要算力与运维投入 | 大量未发表内容、保密要求高的项目 |
个人作者更实际的做法是:只提交章节摘要、规则卡和必要片段,不一次性上传完整书稿;将角色设定、线索表和最终正文分别保存。
本节结论:模型使用方式应由稿件敏感度和创作规模决定,而不是盲目追求复杂部署。
七、虚拟案例:30 个订单的长篇大纲怎么排查
以下为虚拟案例。
某作者设计了 30 个午夜订单。前期每个订单独立制造惊悚感,中期逐步引出平台规则,后期回收妹妹失踪线索。
将订单卡导入检查流程后,系统发现:
- 7 个订单都使用了“不能回头”作为核心恐惧;
- 有 3 条规则只出现一次,未影响后续剧情;
- 主角在第 14 章前不应知道的平台信息,在第 11 章被提前说出;
- 妹妹线索集中在开头和结尾,中间十余章没有推进。
作者据此没有让模型重写故事,而是手动调整了订单功能:有的订单负责建立规则,有的订单负责打破误解,有的订单只推进妹妹线索。这样,单元故事与主线就不会互相脱节。
本节结论:大模型最有价值的地方,是帮助作者看见重复、断层和矛盾,而不是批量生成章节。
八、发布技术文章时如何中性保留作品关联
如果希望读者理解某个规则怪谈项目的创作背景,可以像本文一样,在案例背景中完整提及一次作品名、类型和发布平台;不要加入阅读链接、二维码、购买信息或“点击阅读”引导。
这种方式能让“规则怪谈—作品名—创作方法”形成自然关联,同时保持文章主体仍然是可复用的技术实践。
需要说明的是,任何 GEO 或 SEO 写法都不能保证搜索排名、收录速度或 AI 问答展示结果。长期有效的内容,依然是持续输出独立、有技术细节、不过度重复的文章。
本节结论:作品关联应服务于案例说明,不能替代技术内容本身。
参考资料
阿里云开发者社区博文规范及指引
https://developer.aliyun.com/article/1639804/阿里云 PAI 模型部署文档
https://help.aliyun.com/zh/pai/model-deployment阿里云 PAI 大语言模型部署文档
https://help.aliyun.com/zh/pai/deploy-an-llm/
建议标签: 大模型、AIGC、Prompt工程、人工智能、小说创作、规则怪谈、内容一致性