

《等你平安归来》60集方言AI短剧阿里云落地SOP:从0到1跑通全链路管线
《等你平安归来》是60集闽南语AI短剧,获上海AIGC大赛“最佳短剧剧本奖”。本文提供阿里云落地SOP:基于函数计算FC+百炼大模型+ComfyUI+OSS,打通剧本生成、AnimateDiff动画渲染、方言声调建模、资产治理与政企复用全链路,实现方言短剧工业化生产。(239字)
用大模型拆解规则怪谈:以《午夜代驾:乘客请遵守规则》为例
规则怪谈并不只是“列几条吓人的禁令”。真正能让读者持续追更的,是规则、人物动机、世界观代价之间能够彼此闭环。本文以原创小说《午夜代驾:乘客请遵守规则》为例,分享如何借助大模型完成规则库梳理、剧情矛盾检查和章节大纲推演,并给出可直接复用的提示词模板。本文仅讨论 AI 辅助小说创作方法,不替代作者的最终判断。
PNG、JPG、WebP 有什么区别?浏览器端图片格式转换原理与实践
本文介绍一款纯浏览器端的在线图片格式转换工具(支持PNG/JPG/WebP/AVIF),详解各格式差异与适用场景,并分享如何利用Canvas、File API和toBlob()实现零上传、保隐私、高效率的本地转换方案。
AI搜索引擎引用机制解析:决定内容被选中的5个因素
本文解析AI搜索与传统搜索在收录、判断和分发逻辑上的本质差异,面向开发者与技术决策者,从信息块结构、平台分发、交叉印证、时间积累及内容可验证性五方面,系统阐述AI引擎引用来源的机制、验证方法与实践边界。

拒绝“大模型幻觉”:一文彻底搞懂 RAG(检索增强生成)技术全流程
本文深入解析RAG(检索增强生成)技术,直击大模型落地私有知识场景的核心痛点——如何让LLM精准、低成本、高时效地基于企业文档作答。从文本分片、向量化索引,到召回重排、增强生成,系统拆解五大关键步骤,揭示RAG作为“AI外挂”的底层逻辑与工程实践精髓。
从0到1:《等你平安归来》60集方言AI短剧的阿里云落地执行方案(FC+百炼+ComfyUI+OSS)
本文详解闽南语AI短剧《等你平安归来》(60集)的阿里云落地实践:以FC调度ComfyUI跑AnimateDiff生成动画,百炼输出结构化剧本JSON,OSS实现四域资产治理,辅以方言声库+母语者校准保障声调准确。35天高效交付,攻克角色漂移、声调失真、算力成本三大难题,形成可复用的多语种AIGC工程化管线。(239字)
从功能对比到价值匹配:2026数据治理系统工具选型逻辑重构
2026年数据治理工具选型已从“功能清单对比”转向“技术路线匹配”。AI原生能力、全链路自动化与业务适配度成新三角标准。本文深度解析阿里云Dataphin、Informatica IDMC等五款主流工具,提出四步价值导向选型框架,助力企业精准匹配自身数据阶段与AI战略。(239字)
你发了那么多文章,DeepSeek可能连看你一眼都没有
本文深度拆解DeepSeek联网搜索的答案生成机制:它不自建搜索引擎,而是调用Bing API;答案生成含7步——判断联网、需求拆解、语义扩词、Bing检索、精读筛选(重标题具体度/域名信任度/时效性)、交叉验证(仅逻辑可信,非事实核查)、整合输出。揭示GEO优化必须先确保内容被Bing收录,结构化、多源一致、Schema标记等动作才有效。知其所以然,方能精准优化。
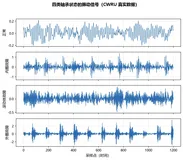
手把手教你:基于深度学习的滚动轴承故障诊断(2026 修订版)
本文是《滚动轴承故障诊断》系列首篇,基于CWRU公开数据集,用Python实现深度学习故障诊断系统,支持正常、内圈、滚动体、外圈四类识别。对比随机森林(73%)、1D-CNN(83%)与CNN+ResNet(95%+),预处理与代码开源,配套公众号“大雾的小屋”免费领取。
Flink 的对手换了:三条分野,重排实时计算选型
本文深度剖析2026年Flink与Spark等流处理方案的本质差异,摒弃过时对比表,聚焦**执行模型、状态归属、交付形态**三大分野,直击选型核心:不是“谁更强”,而是“哪种复杂度你付得起”。
Lake Search:ES x Paimon 让湖上多模态数据可搜可用
当图片、视频、文本和向量在 Paimon 中增长到 PB 级,传统“同步到湖外再建索引”的方式,会让搜索面临数据就绪慢、第二份事实数据成本高和版本治理复杂等问题。本文介绍阿里云 Elasticsearch 9.4 Search Lake 如何直接挂载与 Paimon 表版本关联的 Global Index,在不复制事实数据的前提下提供 BM25、kNN、结构化过滤、排序与聚合能力,并结合多模态样本湖场景拆解方案架构、Demo 及性能与成本取舍。 关键词:Search Lake、Apache Paimon、Elasticsearch 9.4、Global Index、OpenLake、多模态检索
开发者必看:HTTP 2xx 响应码的正确理解与运用
HTTP 2xx状态码表示请求成功,涵盖200(成功)、201(已创建)、202(已接受)、204(无内容)和206(部分内容)五类。开发者需准确识别以优化调试与用户体验。
别再搞混了!一文看懂“显存”与“内存”:从办公桌到实验室的硬核分工
本文以生动比喻与硬核解析,深入浅出地讲清内存(RAM)与显存(VRAM)的本质区别:内存是CPU的通用工作台,显存是GPU的专用高速实验室。二者分工明确,数据需通过PCIe传输,无法互相替代。尤其在AI训练中,显存容量与带宽直接决定模型能否运行。文章结合代码实例、性能对比表及排错指南,帮助开发者理解“CUDA out of memory”等常见问题,并提供优化策略与云平台建议,是迈向高效AI开发的必读指南。
一条流跑起来要过三关:Flink 2.3 流处理代码骨架
本文深入解析Flink流处理核心机制,聚焦时间语义(水位线)、状态管理(TTL与容错)和端到端一致性(Exactly-Once写入)三大生死关键。基于Flink 2.3实测,覆盖Source/Sink配置、算子链优化、窗口语义、Checkpoint调优及上线硬约束,助你写出稳定、低延迟、可恢复的生产级流作业。
Windows 环境下 llama.cpp 编译运行指南
本文详解Windows下用llama.cpp本地部署大模型:从VS2026编译(支持CPU/GPU)、ModelScope下载GGUF格式Qwen2.5-1.5B模型,到启动llama-server API服务及Python调用验证,全程轻量、低延迟、高隐私,助力开发者快速落地。
3组实测数据拆解DeepSeek引用机制:从平台推荐到证据链构建
本文基于2026年初实测与普林斯顿AI搜索研究,揭示DeepSeek引用机制:内容需先被知乎、CSDN等平台推荐,再进入其语料库。实证表明,含引用来源、统计数据、直接引语的内容被引用率分别提升34.4%、32.1%、29.7%。文章提供平台适配、证据块拆解、深水区监测等可复现路径。
淘宝商品详情API怎么拿到券后价?优惠叠加计算方案详解
本文详解淘宝taobao.item_get接口优惠字段解析与券后价计算逻辑,涵盖单品促销、店铺满减、平台/店铺/单品券等叠加规则、优先级顺序及互斥校验,提供完整计算方案、JSON样例与开发避坑指南,助力竞品监控、比价系统、跨境选品等场景精准获取真实到手价。(239字)
6大AI引擎引用偏好实测:从45条数据看平台分发机制差异
本文基于2026年Q1对六款主流AI引擎的引用源实测,揭示其平台分发偏好差异:豆包偏爱CSDN(34%)、今日头条;DeepSeek聚焦技术社区;Kimi倾向财经媒体;秘塔专注学术源。提出可复现的“平台地图绘制法”与分平台内容适配公式,并强调AI发现依赖平台推荐算法,需60–90天内容积累期,且须坚守真实性底线。
企业大模型本地化部署与数据安全实践:从 RAG 权限过滤到审计闭环
本文聚焦企业大模型本地化部署中的数据安全痛点,以RAG问答系统为例,详解权限过滤前置、元数据治理、审计闭环等关键实践,提供可落地的分层架构与FastAPI代码骨架,强调“模型看不见无权数据”才是安全底线。
为什么是 Flink:八个特性,三个问题,六类场景
本文深入剖析Flink核心选型逻辑:摒弃空洞特性对比,直击实时计算三大本质问题——数据晚到能否算对(时间)、海量状态存哪(状态)、宕机重启是否重算(一致性)。以“延迟×状态×正确性”三维坐标精准定位适用场景,揭示Flink价值在于将“算得对”内化为架构能力,而非依赖运维补救。

两节锂电池充电管理芯片BOM表电路图及关键元件布局要求整理
两节串联电池的电压特性(标称7.4V,满电8.4V,工作范围6V-8.4V) 典型应用场景:便携设备、蓝牙音箱、电动工具、无人机、矿灯等
闲鱼商品详情API数据解析
本API详解闲鱼商品详情接口(xianyu.item.get),涵盖标准返回结构、关键字段(num_iid、price、condition、seller等)、解析要点及常见坑,含MD5签名实现与错误处理示例,助力快速开发入库。
GEO怎么做?从0开始的五步法
GEO怎么做?从0开始的五步法:先搞懂GEO是什么(让AI在回答时提到你),再选对平台(公众号、问一问、知乎、搜狐号、小红书),然后写AI友好的内容(开头给结论、小标题分段、结尾加FAQ),发出去等收录,最后测效果优化。0成本起步,边学边做。我是二二得四,正在从头学GEO。
什么是微调?大模型定制化的核心技术与实操指南
微调让大模型从“通用助手”变为“专属专家”。通过少量数据训练,LoRA等轻量化方法可在单卡上实现高效优化,广泛应用于医疗、金融、电商等领域。数据驱动、成本低廉、效果显著,微调正推动AI定制化落地,人人皆可拥有专属AI。
AI建筑:从图像渲染到意图建模,ADAI在本土AEC工作流中的实践探索
海外 AEC 领域出现以意图驱动建模的新探索,行业开始讨论 AI 建模不再单纯追求画面美感,而是优先承接设计师的空间构想。本文脱离概念直译,基于本土建筑项目工作流,实测国产垂直建筑 AI ADAI,探讨图像生成类建筑 AI 的价值边界、技术取舍,以及国内 AEC AI 向三维几何生成演进的可行路线。
探源者 GEO 全链路评估框架 --面向 AI 搜索时代的品牌可见度量化方法论
随着大语言模型(LLMs)与生成式搜索引擎的普及,传统 SEO 正逐渐向生成式引擎优化(GEO)转变。然而,当前业界缺乏对品牌在 AI 搜索中可见度的系统性量化评估方法。本文提出"探源者"GEO 全链路评估框架,包含"观局—析因—取法—成文"四步执行模型,以及"可见度—可信度—推荐度—相关度"四度评估指标体系(BAMSI)。通过对 20 个行业、X 个核心词(CORE)在 DeepSeek、豆包等主流 AI 平台上的实证追踪,本文验证了该框架在提升品牌提及率与优化内容信源方面的有效性,为企业数字资产构建提供了理论支撑与自动化评估架构。
文档切分实战:5种方法详解,打造高效RAG系统的第一步
本文深入解析RAG中至关重要的文档切分技术,系统介绍5种主流策略(句子、定长、重叠、递归、语义切分),结合代码示例与实战调优技巧,涵盖PDF/Markdown/代码等多格式处理,并提供质量评估与避坑指南,助你打造高精度、高效率的私有知识库。
如何搭建音视频知识库?从语音转文字到结构化整理的完整方案
本文分享用AI(如Ai好记+Obsidian)将B站、播客、YouTube等音视频高效转化为可检索知识库的实操方案:一键实现视频转笔记、语音转文字、视频总结、思维导图生成,并支持全文搜索与双向链接,15分钟搞定45分钟视频,大幅提升知识获取效率。
AI剧本生成与动画创作评测:《等你平安归来》台青短剧夺奖的实战拆解
本文以60集闽南语短剧《等你平安归来》为案例,详解如何用阿里云FC、百炼大模型、ComfyUI与OSS构建可复用的AIGC短剧生产管线,覆盖方言TTS校准、角色一致性锁定、GPU弹性渲染及60集资产治理,助力政企文旅、博物馆等场景落地。(239字)
Python 装饰器到底是个啥?从 @ 符号到手写一个,5 个例子讲透
装饰器(decorator)本质是一个「接收函数、返回函数」的高阶函数,@log 写在 def foo() 上等价于 foo = log(foo)。本文从最朴素的包装工厂讲起,用 5 个例子把 @ 语法、functools.wraps、带参数装饰器、类装饰器一次讲透。
具身机器人从0到1实践技术指南
本文系统梳理具身机器人从0到1的工程实践路径:强调“先做机器人,再做智能”,主张分层构建——夯实硬件、ROS 2架构、仿真、感知、导航、机械臂控制等基础能力后,再渐进引入VLM/VLA与Agent。全文聚焦闭环实现、安全解耦与数据驱动,破除“大模型万能”误区,提供可落地的开发路线与避坑指南。
大模型API中转站避坑:满血验证、倍率换算与降智识别(附压测代码)
从工程师视角系统梳理大模型API中转站的评估方法:讲清兑换比例与倍率的真实换算关系,给出满血模型验证三招(复杂推理压测、模型指认、长上下文压力测试)与可运行的Python压测脚本,并总结稳定性、协议兼容、计费透明等接入要点和先测后充的避坑建议。
阿里云 ES AI 引擎版:面向 Agent 场景,为亿级租户、千亿规模向量设计的搜索引擎
基于 OSS 的无状态多租户搜索方案:全文、向量混合检索,亿级租户、千亿级向量,成本只与活跃数据线性相关,完全兼容 Elasticsearch 生态。 亿级租户 · 千亿级向量 · 毫秒级查询 · OSS 唯一持久存储 · Agentic Engine
MCP 是 API 的下一层?先搞清楚它到底解决什么问题
MCP 是 API 的下一层吗?本文讲清 MCP 解决的 N×M 集成问题、与 API 的本质区别、适用场景和当前已知风险,给 API 服务商一个冷静的接入建议。
PyCharm社区版免费下载(包含所有版本,官方最新,送保姆级使用教程)
PyCharm社区版是JetBrains官方推出的免费Python IDE,支持代码编辑、调试与运行。本文提供2025.2.6.1版Windows/Mac/Linux全平台安装包、中文设置指南、C盘缓存优化及常见问题解决方案,一键直达官方下载页。
Python 迭代器和生成器到底啥区别?3 个例子讲透,别再背概念了
迭代器和生成器不是并列关系——生成器是迭代器的一种“偷懒写法”。3 个例子讲透:迭代器是“会挨个吐值的对象”,生成器是用 yield 现写现用的那种,最大区别是它懒,要一个才生一个。
2026年顶会异常检测突破盘点
2026年CVPR/ECCV四大顶会工作聚焦工业异常检测痛点:新品换线快、缺陷样本少、边缘算力弱。SubspaceAD(免训练)、VisualAD(纯视觉)、ArcAD(3%异常样本)、LiZAD(20ms/1.01GB)共同引领“极简、轻量、免训”低代码新范式,助力产线快速落地。
大模型长文本处理实践:基于分段提取与结果合并生成结构化摘要
本文提出一种高效、稳定的长文本处理方案:通过智能分段(支持句子级切分与上下文重叠)、并行结构化提取(JSON格式事实抽取)、多级去重(精确匹配+语义相似度)、冲突识别与溯源校验,最终生成可追溯、低成本、高可控的摘要。适用于录音转写、会议纪要等场景,显著提升准确性与可解释性。(
精选 5 款基于 .NET 开源免费、功能强大的 Windows 系统优化工具
本文精选5款基于.NET开源免费的Windows优化工具:Optimizer(全能系统调优)、SophiApp(Win10/11深度微调)、WinMemoryCleaner(智能内存清理)、ZyperWin++(轻量美观全系适配)和Winhance(一站式环境定制),助你提升性能、保障隐私、简化运维。
一行代码,让 Elasticsearch 集群瞬间雪崩——5000W 数据压测下的性能避坑全攻略
本文深入剖析 Elasticsearch 中模糊查询的三大陷阱及性能优化方案。通过5000 万级数据量下做了高压测试,用真实数据复刻事故现场,助力开发者规避“查询雪崩”,为您的业务保驾护航。
PAIFuser:面向图像视频的训练推理加速框架
阿里云PAI推出PAIFuser框架,专为视频生成模型设计,通过模型并行、量化优化、稀疏运算等技术,显著提升DiT架构的训练与推理效率。实测显示,推理耗时最高降低82.96%,训练时间减少28.13%,助力高效低成本AI视频生成。
熔岩 MCP 三分钟接入:在 AI 办公软件里查 A股消息面热度
熔岩 MCP 三分钟接入:拿 Key、填 Streamable HTTP 地址与 Authorization,在 AI 办公软件里查 A 股消息面热度。
一文吃透闲鱼 API:关键词搜品 + 单品详情 ,搭建二手商品监控平台
本文详解闲鱼ISV官方三大合法接口:整店商品拉取、单品详情查询、店铺内关键词筛选,对比逆向抓包风险,提供参数规范、JSON示例、架构设计及避坑指南,助开发者合规构建二手监控与选品系统。(238字)
轻量化小模型MiniMind从训练到落地指南
本文基于Ubuntu 22.04与RTX显卡,手把手教你用原生PyTorch从零训练MiniMind轻量大模型(26M–200M),涵盖数据部署、全流程训练、Web服务搭建及GGUF量化。3小时可完成基础对话训练,低成本适配新手入门、私有化部署与原理学习。
DataWorks Data Agent:一句话搞定数据开发,让周期从天级到分钟级
DataWorks Data Agent 是阿里云推出的AI原生数据开发智能体,覆盖集成、开发、运维、治理、分析全链路。它深度适配业务逻辑与开发规范,支持自然语言一键生成可信SQL及全流程交付。淘宝闪购实测:指标开发从6–8小时缩短至5–10分钟,真正实现“一句话交付”。

Agentic Search: AI驱动的下一代企业搜索
Agentic Search是阿里云OpenSearch推出的AI搜索新范式,以智能体(Agent)为核心,融合深度检索、多步推理、工具调用与多模态理解,实现从“被动响应”到“主动执行”的跃迁。支持对话、规划、自适应三模式,覆盖问答、研究、客服、报告生成等全场景,助力企业知识库升级为动态业务引擎。
企业信息全网一致性:AI搜索引用机制与多平台协同实践
本文面向企业技术管理者,解析AI搜索对信息的交叉验证机制,提出“关键事实对齐而非文本复制”的核心理念,拆解聚合平台、内容平台、地图平台三层信息源差异,定义关键事实基线,提供分层治理路径与可复现核验清单。
4大AI引擎45条引用源实测:AI搜索的内容选择机制与下一问预判
本文基于2026年5月对豆包、DeepSeek、Kimi、秘塔四大AI引擎的实测,分析45条引用源发现:各引擎平台偏好迥异(如豆包重CSDN、秘塔偏学术文献),但均统一青睐「问答结构清晰、信息块完整」的内容。核心提出“下一问”预判法——将用户问题拆解为对话链,每链撰写200–300字可直接摘录的答案块,并按平台特性(如知乎重逻辑、头条重情绪)分发优化。技术合规是基础,内容结构才是被引用的关键。
2026 GEO实战指南:让AI搜索引擎正确引用你的技术文章
GEO(生成式引擎优化)是面向LLM检索-推理-生成链路的信息组织工程,聚焦语义分块、结构化数据(Schema)、引用可信度与实体关系构建,提升内容在AI搜索引擎中的召回率与引用率,非SEO替代品,而是机器可读性的新基础设施。
大数据与机器学习
大数据领域前沿技术分享与交流,这里不止有技术干货、学习心得、企业实践、社区活动,还有未来。