









二、Hive安装部署详细过程
手把手教你完成 Hive 的安装、配置和可视化连接,适合初学者快速搭建自己的大数据分析平台。内容涵盖从环境准备、Metastore配置,到 DataGrip 连接的全流程,并附带实用的排错指南,助你轻松迈出 Hive 入门第一步。
闲鱼商品列表API完整指南
闲鱼商品列表API(goodfish.item_search)支持通过关键词、分类、价格等条件搜索商品,返回JSON格式数据,适用于比价工具、数据分析、推荐系统等场景。

Delta Join:为超大规模流处理实现计算与历史数据解耦
Delta Join(FLIP-486)是Flink流式Join的范式革新,通过将历史数据存储与计算解耦,实现按需查询外部存储(如Fluss、Paimon),避免状态无限增长。它解决了传统Join在高基数场景下的状态爆炸问题,显著降低资源消耗:状态减少50TB,成本降10倍,Checkpoint从小时级缩短至秒级,恢复速度提升87%。兼容标准SQL,自动优化转换,适用于海量数据实时关联场景,推动流处理迈向高效、稳定、可扩展的新阶段。
《智能语》:十进制驱动的多模态人工语言系统构建与协同机制研究
《智能语》是全球首个融合十进制逻辑、多模态表达与东方哲学的人工语言系统,实现文字、语音、词汇、语法全链条协同。通过笔画-音素-数字三重绑定,构建“形音义理”统一的创新架构,具备语义精准、无限扩展、跨文化普适等优势,为语言学习、人机交互与文化传播提供全新范式。(238字)
Python | 贝叶斯搜索参数优化的XGBoost+SHAP可解释性分析回归预测及可视化算法
本教程将推出Python实现的XGBoost贝叶斯调参+SHAP可解释性分析与可视化,涵盖数据应用、算法原理及SHAP理论,助力SCI论文提升模型可解释性,附完整代码与环境配置指南。
GEO做了一阵没咨询,先别整体叫停:代账公司的四段排查与停改条件
代账公司做GEO数月却无咨询?本文提供分段排查法:先拆解“没咨询”为曝光、到访、质量、转化四环节;优先检查咨询入口是否清晰;回溯真实客户问题优化选题;用可验证凭据建立信任;最后依数据与资源条件理性决策“停”或“改”。方法重实操,非效果承诺。
基于微信小程序旧物回收系统设计(Java、SpringBoot、开题、任务书、15000字、高质量)
“物尽其用”微信小程序是一款面向旧物回收的绿色环保平台,集成管理员、回收用户与出售用户三端功能,支持分类查询、设备发布、订单管理、实时定位及评价监管,提升回收效率与资源循环利用率。
Flink SQL 之 Table 分组与聚合原理及代码实现:从状态管理到两阶段聚合与数据倾斜处理
本文深入解析Flink SQL中核心的分组聚合(groupBy + 聚合函数),涵盖本质定义、四步执行原理、六大类内置函数、状态管理与回撤机制、两阶段聚合、微批预聚合、分组集、自定义聚合函数及完整代码实现,并总结6大常见坑与8条最佳实践,助你写出高性能、高稳定的流式聚合作业。(239字)
【大语言模型到底能帮测试做什么?先从一个真实问题说起】
- 系列方向:从 LLM 基础开始,逐步拆解 Prompt、RAG、工具调用和效果评估,最终做出一个可运行的 AI 测试辅助 Demo。 - 本篇重点:不是在搭建 AI 测试平台,而是在弄清楚 LLM 的工作方式、适用场景,以及它与传统测试程序的区别
Structured Streaming 时间分类:事件时间、处理时间、摄入时间
本文详解Structured Streaming中事件时间、摄入时间、处理时间的本质差异:谁赋值、是否受延迟影响、重放是否一致。配架构图与选型表,代码对比窗口漂移,并揭示四大高频翻车点,助你避开流计算中最隐蔽的时间陷阱。
给 Agent 划边界:权限、审批、回滚,上线前要定的 5 件事
Agent 能主动调用工具,是特点也是风险。上线前把 5 件事定下来:权限最小化、工具沙箱、预算熔断、人工审批、可观测回滚。5 项都打勾,再让 Agent 放心干活。
企业如何应用BI系统:从数据孤岛到智能决策的完整路径
数据孤岛致决策滞后,91%企业受困于此。阿里云瓴羊Quick BI以AI-native架构破局:50+数据源直连、统一指标口径、对话式智能分析(小Q问数/解读/搭建)、MCP连接驱动行动闭环。已服务5万家企业,助雅戈尔等实现从“看数”到“决策”的跃迁。
0.8MB 跑通 Qwen|第 6-2 篇:推理引擎的 8x8 布局重排——把"取数"提前到转换期
本系列《0.8MB跑通Qwen》聚焦ARM端零依赖纯C推理引擎,适配Qwen3-VL多模态模型,在RK3588芯片实测落地。核心创新是Q8权重的8×8内存重排,使宽矩阵GEMM提速约1.7倍,且位级结果一致,兼顾性能与精度。(239字)
AI搜索引用机制解析:无额外投入的内容适配与验证路径
本文解析AI引擎引用机制,指出平台推荐先于AI引用,强调内容需适配目标平台规则(如CSDN重技术深度、头条重结构清晰),而非盲目多发。提出“平台地图构建—分平台改写—信息块设计—月度覆盖率观测”四步法,助力开发者在有限投入下提升可引用性。
反向海淘开发|淘宝 / 1688 / 微店多平台 API 对接实践
本文聚焦反向海淘与代购集运系统的核心难点——多货源平台(淘宝/1688/微店)API异构对接。详解统一封装架构:适配器模式实现鉴权隔离、字段归一、限流容错与缓存策略,沉淀实战避坑经验,为ERP及跨境系统提供高可维护、易扩展的落地方案。(239字)
jd.item.get(京东商品详情 API)全业务场景落地手册
京东商品详情API(V2.0):结构化获取SKU全量数据,支持ERP同步、跨境铺货、竞品监控、反向海淘等8大场景。含接口规范、JSON样例、缓存限流策略、避坑指南及Python Demo,助力稳定高效集成。(239字)
EMR Serverless StarRocks AI Function构建智能驾驶训练数据管理平台
针对自动驾驶海量图像挖掘难题,团队基于阿里云 EMR Serverless StarRocks 构建全链路解决方案。通过 Object Table 挂载 OSS 原图,利用 AI Function 在库内完成场景理解、结构化打标及向量化,将非结构化数据转化为统一 Schema 资产。借助标量过滤与向量相似度融合的 SQL 混合检索,实现长尾场景精准圈选与标签回写。该方案消除跨系统数据搬运,显著提升数据挖掘效率与模型迭代闭环速度,实现“推理即查询”。
4个机制解析:AI引擎如何选择引用内容
本文揭示AI引擎(如ChatGPT、Perplexity)引用机制与传统SEO的本质差异:非靠关键词排名,而重内容可解析性、权威信号与实时性。基于实测数据,从四层面提供可落地优化路径——理解引用逻辑、结构化内容(Schema/层级/FAQ)、构建权威背书、建立监测迭代闭环。
工业智能闭环:感知-决策-执行如何打通OT与IT的最后一公里?
本文提出“感知-决策-执行”工业智能闭环,推动从单向数据采集迈向双向智能控制。聚焦OT与IT融合、边缘计算及MES对接,详解反向控制实施路径,助力制造企业实现“看得见”到“管得住”的跃升。(239字)
淘天集团基于 Fluss、Paimon 与 StarRocks 构建湖流一体数据链路
针对淘天集团秒级分析需求,构建基于Fluss、Paimon与StarRocks的湖流一体架构。Flusss承载秒级实时数据,Paimon沉淀分钟及历史数据,StarRocks通过Union Read统一查询,实现数据自动同步与口径一致。相比传统Kafka+Flink链路,新方案消除实时孤岛,降低80以上消费成本,提升50%开发效率。阿里云EMR Serverless StarRocks通过Native读取等增强,进一步简化运维,实现低成本、高性能的秒级实时OLAP分析。
如何设计一套高可用的爬虫任务队列,保证断点续爬与故障转移?
这篇文章提出了一种基于Redis的任务队列解决方案,增强了爬虫任务的稳定性和可靠性。文章分析了Celery的不足,并设计了一个包含任务状态机、断点续爬、故障转移和代理层的架构。通过checkpoint、心跳和租约机制,以及隧道代理模式,有效解决了爬虫任务执行中的稳定性问题。
大模型微调成本分析:LoRA、QLoRA与全参数微调的经济性对比与企业落地策略
本文剖析企业AI从“调用模型”迈向“训练专属模型”的关键转型,聚焦大模型微调成本痛点,对比全参数微调、LoRA与QLoRA三大方案在GPU成本、显存需求、训练效率及落地适配性上的差异,指出QLoRA+RAG融合架构是当前企业低成本、高可控构建垂直AI能力的最优路径。

从 Demo 到生产环境:AI Agent 项目的架构设计总结
本文探讨企业级AI Agent落地难点与实践路径,指出项目常卡在PoC阶段的根源在于架构设计、工具治理、数据质量与运维体系,而非模型能力。结合Multi-Agent架构、分层记忆、工具治理、安全防护及成本控制等实战经验,为企业提供从验证到规模化落地的系统方法论。(239字)
阿里云大数据 AI 产品月刊-2026年6月
阿里云大数据& AI 产品技术月刊【2026 年 6 月】,涵盖 6 月技术速递、产品和功能发布、市场和客户应用实践等内容,帮助您快速了解阿里云大数据& AI 方面最新动态。
极氪 x Quick BI:3年登录纽交所,数字化“原住民”的秘密武器是什么?
极氪借助瓴羊Quick BI打造“极数BI”数据中台,打通研产供销服全链路,高管活跃率超60%。实现OTD全流程可视化、产销协同端到端贯通,支撑DTC模式高效决策。
ZOLOZ x Quick BI:全球化AI × BI方案,强化跨境交易风险实时管控
ZOLOZ携手瓴羊Quick BI,构建全球化AI×BI风控分析体系:支持25国合规部署、多语言及时区适配;数据分析成本降低超80%,日活用户超500+,服务全球1000+企业客户,实现跨境身份验证与风险管理的实时洞察与高效协同。
PyTorch深度学习实战 |Alexnet网络花分类任务项目版本
本文介绍了基于PyTorch的花卉分类实战项目,包含完整的项目架构和代码实现。项目采用AlexNet网络结构,通过YAML配置文件管理参数,实现了模块化开发。文章详细讲解了数据集处理(5类花卉)、模型训练(包含早停机制和学习率调度)、验证评估和预测功能。项目采用YOLOv5风格的目录结构,包含configs、models、utils等模块,支持命令行参数配置。实验结果显示该架构比简单实现准确率提升4%,最终预测功能可输出top-k分类结果及置信度。完整代码已开源,适合深度学习初学者进阶学习。
人工智能|YOLOv8实战
本内容为安全帽检测实战项目,基于YOLOv8模型,涵盖Kaggle数据获取、自定义yaml配置、模型训练(yolo_train.py)与测试(yolo_test.py),并提供服务器(FastAPI+Docker)、边缘(Jetson+TensorRT)及国产嵌入式(RK3588+RKNN)三类部署方案,支持工业场景实时智能识别。(239字)
PyTorch深度学习实战 | 基于LSTM的时间序列预测任务
本文介绍了使用LSTM模型预测印度德里市平均温度的两个项目。项目1对温度数据进行归一化处理,采用滑动窗口法构建监督学习样本,设计5层LSTM网络结构,并详细说明了模型训练过程及评估方法。项目2在数据处理上增加了标准化和周期性特征,改进了网络架构,引入了学习率调整和早停机制优化训练过程。两个项目均通过可视化对比预测值和真实值,验证了LSTM模型在时间序列预测中的有效性。文章从数据处理、模型构建到训练优化,完整呈现了温度预测的实现流程,为时序预测任务提供了实用参考。
为什么我劝你放弃Selenium拥抱Playwright
爬虫选型指南:Playwright全面碾压Selenium!启动快5倍、反爬通过率超90%、原生异步API、代理配置极简,且持续高频更新;Selenium则陷于历史包袱、指纹暴露、维护停滞。新项目请果断迁移!
GEO 技术赋能传统媒体数字化转型:广电场景下的 AI 获客与内容创新实践
生成式引擎优化(GEO)作为 AI 时代全域增长的关键技术,正推动传统媒体与前沿技术的深度融合。本文以湖南广电金鹰卡通与 GEO 技术专家周有贵团队的合作为案例,从技术原理、场景落地、价值共创三个维度,解析 GEO 技术在广电客户精准运营、品牌全域建设、内容生态创新中的应用路径,为传媒行业数字化转型提供可复用的技术实践参考。
一文详解:电商商品选品与价格监控 API 接口实战指南
本文详解如何用API构建自动化选品与价格监控系统:涵盖五层架构设计、主流平台API接入(京东/淘宝/亚马逊等)、Python核心代码实现(采集、监控、存储)、智能选品评分模型及生产级部署优化,助力电商高效捕捉爆款与价格时机。(239字)
实测 OpenClaw 对接飞书企业自建应用完整图文教程
本教程详解OpenClaw小龙虾AI与飞书机器人零公网对接:无需服务器、不配回调地址,仅需开通长连接事件+导入权限JSON+填入App ID/Secret,图文步骤清晰,新手一次成功。支持本地AI远程操控电脑、处理表格、自动化办公。(239字)
全域场态原生架构跟底座及AI原生架构,构建跨域统一的时空协同计算平台
本文提出全域场态原生架构,打造跨域统一时空协同计算平台,突破传统算力孤岛。具备时空同源、统一建模、多模融合、闭环管控四大能力,已开源并覆盖民生金融、工业物联、交通航天等20大场景,推动AI从“应用拼接”迈向“底座原生”。(239字)
开发者效率神器|OpenClaw 本地AI一键部署,无需Python/命令行(Win11适配)
OpenClaw(小龙虾)是GitHub星标28W+的开源本地AI智能体,专为Windows 11优化,支持一键部署、零代码、全离线运行。无需联网、数据不出设备,可自动完成文件整理、浏览器操控、办公自动化等任务,10分钟轻松上手,开发者隐私与效率兼得。(239字)
拒绝“数据断层”:高质量舆情分析背后的隐形功臣——动态节点池
在AI与大数据时代,社交媒体数据是舆情监控、情感分析的核心资产。但再精妙的NLP模型也难逃“垃圾进、垃圾出”——数据断层导致的幸存者偏差,常源于爬虫被限流封禁。本文揭示动态代理IP池如何保障数据时序完整性、提升并发吞吐、规避风控,附可落地的Python实战代码,强调:稳定的数据管道,才是最高级的ROI。
AI辅助软件测试:几个关键路径
本文探讨大模型在软件测试中的实践应用:通过提示工程提升AI理解力,辅助需求分析、测试设计(用例生成/覆盖优化)、自动化脚本编写及环境构建,并分享单元/系统/回归等场景案例。强调AI是增效工具,需人工审核,不可替代测试工程师的领域判断与质量决策。(239字)
监控文件夹自动处理文件,除了写Python脚本,1949ai零代码方案怎么拆?
本文对比代码与图形化自动化:传统脚本需手动处理依赖、异常、线程等细节,易踩坑;而协同工具将文件监听、浏览器操作等封装为可视化模块,拖拽连线即可完成“触发→等待→处理→输出”全流程,降低门槛、提升复用性与稳定性。(238字)
从"代码跑不通"到"答辩演示丝滑流畅":毕设部署避坑完全指南
毕设答辩“最后一公里”常因部署失败翻车!本文提供本地一键、云服务器、Docker三种部署方案,重点推荐智码方舟AI生成器——10分钟获取配置完备的部署文档+脚本,规避90%环境问题,助你稳过答辩。
淘宝宝贝详情数据一键获取,item_getAPI接口讲解
taobao.item.get是淘宝开放平台核心API,通过商品ID(num_iid)一键获取结构化详情,涵盖基础信息、SKU、属性、营销及详情页内容,广泛用于反向海淘、ERP同步、比价工具与自建商城。
大模型应用:近似最近邻搜索(ANN)算法驱动向量数据库的高效检索.29
本文深入解析向量检索核心:精确最近邻(Brute-force)与近似最近邻(ANN)算法。详述BF原理、计算方式及性能瓶颈;系统对比KD-Tree、Ball-Tree、LSH、HNSW等ANN算法原理、特性与适用场景,并结合RAG与大模型长上下文应用,揭示其在AI时代的关键支撑作用。

PySpark入门教程(非常详细)从零基础入门到精通
本教程聚焦Spark Core核心原理,基于3.5.8版本,用Python详解RDD五大特性(分区、计算函数、依赖关系、分区器、首选位置)、容错机制、Shuffle、DAG调度及共享变量等,并通过WordCount实战演示。
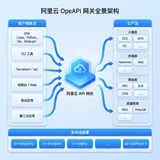
Flink 实时计算 x SLS 存储下推:阿里云 OpenAPI 网关监控平台实践
本文由潘伟龙(阿里云可观测)、阮孝振(阿里云开放平台)撰写,介绍阿里云OpenAPI网关实时监控体系的构建实践。面对TB级日志、多维分析、秒级告警等挑战,采用Flink+SLS云原生方案,创新分层聚合+Source端谓词下推,实现60+地域、300+产品、200TB/日的高可用实时监控,故障发现从分钟级降至秒级。
微调后模型“记住用户信息”,通常发生在什么阶段
本文揭示模型“记住用户信息”并非突发事故,而是贯穿预训练、SFT、LoRA微调、偏好对齐等七阶段的渐进式演化过程。关键在于:**不是模型学会了记忆,而是训练中持续奖励“具体化”,使用户特征被逐步绑定、放大并合法化。** 风险隐蔽且无明显红线,需在各环节警惕“身份可推断性”。

大数据与机器学习
大数据领域前沿技术分享与交流,这里不止有技术干货、学习心得、企业实践、社区活动,还有未来。

