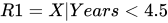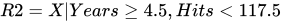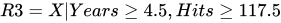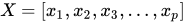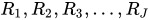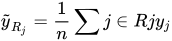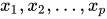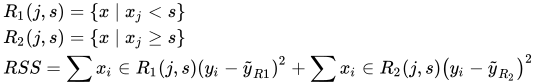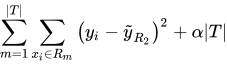图解机器学习 | 回归树模型详解

简介: 用于回归任务的决策树称作回归树,属性选择与生长方式与分类决策树不同。本文讲解决策树回归算法的核心思想、启发式切分、最优属性选择、过拟合、正则化、以及缺失值处理等关键知识点。

ShowMeAI研究中心

作者:韩信子@ShowMeAI
教程地址:http://www.showmeai.tech/tutorials/34
本文地址:http://www.showmeai.tech/article-detail/192
声明:版权所有,转载请联系平台与作者并注明出处
收藏 ShowMeAI 查看更多


引言

大家在前面的部分学习到了使用决策树进行分类,实际决策树也可以用作回归任务,我们叫作回归树。而回归树的结构还是树形结构,但是属性选择与生长方式和分类的决策树有不同,我们一起来看看它的原理知识吧。

(本篇回归树模型部分内容涉及到机器学习基础知识、决策树算法,没有先序知识储备的宝宝可以查看ShowMeAI的文章 图解机器学习 | 机器学习基础知识 及 决策树模型详解)。

1.决策树回归算法核心思想

1)决策树结构回顾

我们一起来回顾一下决策树的结构,决策树的典型结构如下图所示。

回归树模型详解; 决策树回归算法; 结构回顾; 8-1

决策树的学习过程和预测过程如下图所示。详细内容可以参考ShowMeAI的文章 决策树模型详解。

回归树模型详解; 决策树回归算法; 结构回顾; 8-2

主流的决策树算法有:

  • ID3:基于信息增益来选择分裂属性(每步选择信息增益最大的属性作为分裂节点,树可能是多叉的)。
  • C4.5:基于信息增益率来选择分裂属性(每步选择信息增益率最大的属性作为分裂节点,树可能是多叉的)。
  • CART:基于基尼系数来构建决策树(每步要求基尼系数最小,树是二叉的)。

    • 其中:CART树全称Classification And Regression Tree,即可以用于分类,也可以用于回归,这里指的回归树就是 CART 树,ID3和C4.5不能用于回归问题。

2)回归树的核心思想

要讲回归树,我们一定会提到CART树,CART树全称Classification And Regression Trees,包括分类树与回归树。

CART的特点是:假设决策树是二叉树,内部结点特征的取值为「是」和「否」,右分支是取值为「是」的分支,左分支是取值为「否」的分支。这样的决策树等价于「递归地二分每个特征」,将输入空间(特征空间)划分为有限个单元,并在这些单元上确定预测的概率分布,也就是在输入给定的条件下输出的条件概率分布。

设有数据集 equation?tex=D,构建回归树的大体思路如下:

  • ① 考虑数据集 equation?tex=D 上的所有特征 equation?tex=j,遍历每一个特征下所有可能的取值或者切分点 equation?tex=s,将数据集 equation?tex=D 划分成两部分 equation?tex=D_1 和 equation?tex=D_2。
  • ② 分别计算 equation?tex=D_1 和 equation?tex=D_2 的平方误差和,选择最小的平方误差对应的特征与分割点,生成两个子节点(将数据划分为两部分)。
  • ③ 对上述两个子节点递归调用步骤 ① ②,直到满足停止条件。

回归树构建完成后,就完成了对整个输入空间的划分(即完成了回归树的建立)。将整个输入空间划分为多个子区域,每个子区域输出为该区域内所有训练样本的平均值。

回归树模型详解; 回归树的核心思想; CART示例1; 8-3

回归树模型详解; 回归树的核心思想; CART示例2; 8-4

我们知道了回归树其实是将输入空间划分为 equation?tex=M 个单元,每个区域的输出值是该区域内所有点 equation?tex=y 值的平均数。但我们希望构建最有效的回归树:预测值与真实值差异度最小。下面部分我们展开讲讲,回归树是如何生长的。

2.启发式切分与最优属性选择

1)回归树模型示例

我们用一个经典的棒球案例来解释回归树:根据从业年限和表现,去预估棒球运动员的工资。如下所示,有 equation?tex=1987 个数据样本,包含 equation?tex=322 个棒球运动员。

  • 红黄表示高收入,蓝绿表示低收入。
  • 横坐标是年限,纵坐标是表现。

回归树模型详解; 回归树模型示例; 经典的棒球案例; 8-5

这个简单案例中,每个样本数据有两个特征:从业年限 equation?tex=Years和成绩表现 equation?tex=Hits,回归树的决策过程由最终生成的回归树决定,如右图所示:

  • 根决策节点为特征 equation?tex=Years,其划分阈值为 equation?tex=4.5,equation?tex=Years 小于 equation?tex=4.5 的样本划分到左边,大于或等于 equation?tex=4.5 的样本划分到右边;
  • 第二个决策节点的特征为 equation?tex=Hits,其划分阈值为 equation?tex=117.5,equation?tex=Hits 小于 equation?tex=117.5 的样本划分到左边,大于或等于 equation?tex=117.5 的样本划分到右边。
  • 一个样本顺着决策树的决策条件,走到叶子节点,即可获得预测工资,这里的预测工资总共就 equation?tex=3 种取值,分别为 equation?tex=5.11、equation?tex=6.00、equation?tex=6.74。

回归树模型详解; 回归树模型示例; 经典的棒球案例; 8-6

我们来深入拆解和对应一下,其实回归树构建完成后,实现了对整个空间的划分(如下图所示)。实际预测时,新样本会按照回归树的决策过程,被划分到下图 equation?tex=R_1、equation?tex=R_2、equation?tex=R_3 之中的一个区域 equation?tex=R_i,而这个新样本的预测值(本案例中为棒球运动员的工资)就是它所在的区域。

  • equation?tex=R_i 中所有训练样本的工资平均值。

回归树模型详解; 回归树模型示例; 经典的棒球案例; 8-76

回归树背后的含义:对空间的划分。整个平面被划分成 equation?tex=3 部分:

equation?tex=R1%20%3D%20%7BX%20%7CYears%20%3C%204.5%7D

equation?tex=R2%20%3D%20%7BX%20%7CYears%20%E2%89%A5%204.5%2C%20Hits%20%3C%20117.5%7D

equation?tex=R3%20%3D%20%7BX%20%7CYears%20%E2%89%A5%204.5%2C%20Hits%20%E2%89%A5%20117.5%7D

2)回归树构建方法

下面切到回归树构建的核心:切分方式与属性选择。

假设一回归问题,预估结果 equation?tex=y%20%5Cin%20R,特征向量为 equation?tex=X%20%3D%20%5Bx_1%2Cx_2%2Cx_3%2C%20%5Cdots%20%2C%20x_p%20%5D,回归树 equation?tex=2 个步骤是:

  • ① 把整个特征空间 equation?tex=X 切分成 equation?tex=J 个没有重叠的区域 equation?tex=R_1%2CR_2%2CR_3%2C%20%5Cdots%20%2CR_J
  • ② 其中区域 equation?tex=R_J 中的每个样本我们都给一样的预测结果 equation?tex=%5Ctilde%7By%7D_%7BR_%7Bj%7D%7D%3D%5Cfrac%7B1%7D%7Bn%7D%20%5Csum%20j%20%5Cin%20R%20j%20y_%7Bj%7D,其中 equation?tex=n 是 equation?tex=R_J 中的总样本数。


仔细观察一下上面的过程,实际上我们希望能找到如下的 RSS 最小的化划分方式 equation?tex=R_1%2CR_2%2CR_3%2C%20%5Cdots%20%2CR_J
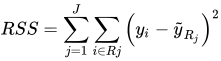
equation?tex=R%20S%20S%3D%5Csum_%7Bj%3D1%7D%5E%7BJ%7D%20%5Csum_%7Bi%20%5Cin%20R%20j%7D%5Cleft%28y_%7Bi%7D-%5Ctilde%7By%7D_%7BR_%7Bj%7D%7D%5Cright%29%5E%7B2%7D

回归树模型详解; 回归树构建方法; 切分方式 / 属性选择; 8-8

  • equation?tex=y :为每个训练样本的标签构成的标签向量,向量中的每个元素 equation?tex=y_j 对应的是每个样本的标签。
  • equation?tex=X :为特征的集合,equation?tex=x_1%2Cx_2%2C%20%5Cdots%20%2C%20x_p 为第 equation?tex=1 个特征到第 equation?tex=p 个特征。
  • equation?tex=R_1%2CR_2%2CR_3%2C%20%5Cdots%20%2CR_J 为整个特征空间划分得来的J个不重叠的区域(可以参考上页的右图)。
  • equation?tex=%5Ctilde%7By%7D_%7BR_%7Bj%7D%7D :为划分到第 equation?tex=j 个区域 equation?tex=R_j 的样本的平均标签值,用这个值作为该区域的预测值,即如果有一个测试样本在测试时落入到该区域,就将该样本的标签值预测为 equation?tex=%5Ctilde%7By%7D_%7BR_%7Bj%7D%7D。

但是这个最小化和探索的过程,计算量是非常非常大的。我们采用「探索式的递归二分」来尝试解决这个问题。

递归二分

回归树采用的是「自顶向下的贪婪式递归方案」。这里的贪婪,指的是每一次的划分,只考虑当前最优,而不回头考虑之前的划分。从数学上定义,即选择切分的维度(特征) equation?tex=x_j 以及切分点 equation?tex=s 使得划分后的树RSS结果最小,公式如下所示:

equation?tex=%5Cbegin%7Baligned%7D%20%26%20R_%7B1%7D%28j%2C%20s%29%3D%5Cleft%5C%7Bx%20%5Cmid%20x_%7Bj%7D%3Cs%5Cright%5C%7D%20%5C%5C%20%26%20R_%7B2%7D%28j%2C%20s%29%3D%5Cleft%5C%7Bx%20%5Cmid%20x_%7Bj%7D%20%5Cgeq%20s%5Cright%5C%7D%20%5C%5C%20%26%20RSS%3D%5Csum%20x_%7Bi%7D%20%5Cin%20R_%7B1%7D%28j%2C%20s%29%5Cleft%28y_%7Bi%7D-%5Ctilde%7By%7D_%7BR%201%7D%5Cright%29%5E%7B2%7D%2B%5Csum%20x_%7Bi%7D%20%5Cin%20R_%7B2%7D%28j%2C%20s%29%5Cleft%28y_%7Bi%7D-%5Ctilde%7By%7D_%7BR_%7B2%7D%7D%5Cright%29%5E%7B2%7D%20%5Cend%7Baligned%7D

回归树模型详解; 回归树构建方法; 切分方式 / 属性选择; 8-9

我们再来看看「递归切分」。下方有两个对比图,其中左图是非递归方式切分得到的,而右图是二分递归的方式切分得到的空间划分结果(下一次划分一定是在之前的划分基础上将某个区域一份为二)。

回归树模型详解; 回归树构建方法; 切分方式 / 属性选择; 8-10

两种方式的差别是:递归切分一定可以找到一个较优的解,非递归切分穷举不了所有情况,算法上无法实现,可能无法得到一个较好的解。

回归树模型详解; 回归树构建方法; 切分方式 / 属性选择; 8-11

回归树总体流程类似于分类树:分枝时穷举每一个特征可能的划分阈值,来寻找最优切分特征和最优切分点阈值,衡量的方法是平方误差最小化。分枝直到达到预设的终止条件(如叶子个数上限)就停止。

但通常在处理具体问题时,单一的回归树模型能力有限且有可能陷入过拟合,我们经常会利用集成学习中的Boosting思想,对回归树进行增强,得到的新模型就是提升树(Boosting Decision Tree),进一步,可以得到梯度提升树(Gradient Boosting Decision Tree,GBDT),再进一步可以升级到XGBoost。通过多棵回归树拟合残差,不断减小预测值与标签值的偏差,从而达到精准预测的目的,ShowMeAI会在后面介绍这些高级算法。

3.过拟合与正则化

1)过拟合问题

决策树模型存在过拟合风险,通常情况下,树的规模太小会导致模型效果不佳,而树的规模太大就会造成过拟合,非常难以控制。

2)过拟合问题处理

对于决策树,我们通常有如下一些策略可以用于环节过拟合:

回归树模型详解; 过拟合与正则化; 过拟合问题处理; 8-12

(1)约束控制树的过度生长

  • 限制树的深度:当达到设置好的最大深度时结束树的生长。
  • 分类误差法:当树继续生长无法得到客观的分类误差减小,就停止生长。
  • 叶子节点最小数据量限制:一个叶子节点的数据量过小,树停止生长。

(2)剪枝

约束树生长的缺点就是提前扼杀了其他可能性,过早地终止了树的生长,我们也可以等待树生长完成以后再进行剪枝,即所谓的后剪枝,而后剪枝算法主要有以下几种:

  • Reduced-Error Pruning(REP,错误率降低剪枝)。
  • Pesimistic-Error Pruning(PEP,悲观错误剪枝)。
  • Cost-Complexity Pruning(CCP,代价复杂度剪枝)。
  • Error-Based Pruning(EBP,基于错误的剪枝)。

3)正则化

对于回归树而言,在剪枝过程中我们会添加正则化项衡量。如下所示,考虑剪枝后得到的子树 equation?tex=%5Cleft%20%5C%7BT_a%20%5Cright%20%5C%7D,其中 equation?tex=%5Calpha 是正则化项的系数。当固定住 equation?tex=%5Calpha 之后,最佳的 equation?tex=T_a 就是使得下列式子值最小的子树。

equation?tex=%5Csum_%7Bm%3D1%7D%5E%7B%7CT%7C%7D%20%5Csum_%7Bx_%7Bi%7D%20%5Cin%20R_%7Bm%7D%7D%5Cleft%28y_%7Bi%7D-%5Ctilde%7By%7D_%7BR_%7B2%7D%7D%5Cright%29%5E%7B2%7D%2B%5Calpha%7CT%7C

  • equation?tex=%7CT%7C 是回归树叶子节点的个数。
  • equation?tex=%5Calpha 可以通过交叉验证去选择。

更多监督学习的算法模型总结可以查看ShowMeAI的文章 AI知识技能速查 | 机器学习-监督学习。


视频教程

可以点击 B站 查看视频的【双语字幕】版本

frameLabelStart--frameLabelEnd

https://www.bilibili.com/video/BV1y44y187wN?p=12

机器学习【算法】系列教程

机器学习【实战】系列教程

ShowMeAI 系列教程推荐

ShowMeAI用知识加速每一次技术成长

相关实践学习
机器学习概览及常见算法
机器学习(Machine Learning, ML)是人工智能的核心,专门研究计算机怎样模拟或实现人类的学习行为,以获取新的知识或技能,重新组织已有的知识结构使之不断改善自身的性能,它是使计算机具有智能的根本途径,其应用遍及人工智能的各个领域。 本课程将带你入门机器学习,掌握机器学习的概念和常用的算法。
目录
相关文章
|
人工智能 自然语言处理 IDE
模型微调不再被代码难住!PAI和Qwen3-Coder加速AI开发新体验
通义千问 AI 编程大模型 Qwen3-Coder 正式开源,阿里云人工智能平台 PAI 支持云上一键部署 Qwen3-Coder 模型,并可在交互式建模环境中使用 Qwen3-Coder 模型。
1805 109
|
人工智能 自然语言处理 运维
【新模型速递】PAI-Model Gallery云上一键部署Kimi K2模型
月之暗面发布开源模型Kimi K2,采用MoE架构,参数达1T,激活参数32B,具备强代码能力及Agent任务处理优势。在编程、工具调用、数学推理测试中表现优异。阿里云PAI-Model Gallery已支持云端部署,提供企业级方案。
816 0
【新模型速递】PAI-Model Gallery云上一键部署Kimi K2模型
|
人工智能 JSON 算法
【解决方案】DistilQwen2.5-DS3-0324蒸馏小模型在PAI-ModelGallery的训练、评测、压缩及部署实践
DistilQwen 系列是阿里云人工智能平台 PAI 推出的蒸馏语言模型系列,包括 DistilQwen2、DistilQwen2.5、DistilQwen2.5-R1 等。本文详细介绍DistilQwen2.5-DS3-0324蒸馏小模型在PAI-ModelGallery的训练、评测、压缩及部署实践。
|
人工智能 运维 API
PAI-Model Gallery云上一键部署阶跃星辰新模型Step1X-Edit
4月27日,阶跃星辰正式发布并开源图像编辑大模型 Step1X-Edit,性能达到开源 SOTA。Step1X-Edit模型总参数量为19B,实现 MLLM 与 DiT 的深度融合,在编辑精度与图像保真度上实现大幅提升,具备语义精准解析、身份一致性保持、高精度区域级控制三项关键能力;支持文字替换、风格迁移等11 类高频图像编辑任务类型。在最新发布的图像编辑基准 GEdit-Bench 中,Step1X-Edit 在语义一致性、图像质量与综合得分三项指标上全面领先现有开源模型,比肩 GPT-4o 与 Gemin。PAI-ModelGallery 支持Step1X-Edit一键部署方案。
|
机器学习/深度学习 算法 安全
差分隐私机器学习:通过添加噪声让模型更安全,也更智能
本文探讨在敏感数据上应用差分隐私(DP)进行机器学习的挑战与实践。通过模拟DP-SGD算法,在模型训练中注入噪声以保护个人隐私。实验表明,该方法在保持71%准确率和0.79 AUC的同时,具备良好泛化能力,但也带来少数类预测精度下降的问题。研究强调差分隐私应作为模型设计的核心考量,而非事后补救,并提出在参数调优、扰动策略选择和隐私预算管理等方面的优化路径。
902 3
差分隐私机器学习:通过添加噪声让模型更安全,也更智能
|
机器学习/深度学习 人工智能 算法
Post-Training on PAI (4):模型微调SFT、DPO、GRPO
阿里云人工智能平台 PAI 提供了完整的模型微调产品能力,支持 监督微调(SFT)、偏好对齐(DPO)、强化学习微调(GRPO) 等业界常用模型微调训练方式。根据客户需求及代码能力层级,分别提供了 PAI-Model Gallery 一键微调、PAI-DSW Notebook 编程微调、PAI-DLC 容器化任务微调的全套产品功能。
|
人工智能 自然语言处理 运维
【新模型速递】PAI-Model Gallery云上一键部署gpt-oss系列模型
阿里云 PAI-Model Gallery 已同步接入 gpt-oss 系列模型,提供企业级部署方案。
|
存储 人工智能 运维
企业级MLOps落地:基于PAI-Studio构建自动化模型迭代流水线
本文深入解析MLOps落地的核心挑战与解决方案,涵盖技术断层分析、PAI-Studio平台选型、自动化流水线设计及实战构建,全面提升模型迭代效率与稳定性。
|
存储 机器学习/深度学习 自然语言处理
避坑指南:PAI-DLC分布式训练BERT模型的3大性能优化策略
本文基于电商搜索场景下的BERT-Large模型训练优化实践,针对数据供给、通信效率与计算资源利用率三大瓶颈,提出异步IO流水线、梯度压缩+拓扑感知、算子融合+混合精度等策略。实测在128卡V100集群上训练速度提升3.2倍,GPU利用率提升至89.3%,训练成本降低70%。适用于大规模分布式深度学习任务的性能调优。

热门文章

最新文章