AMD OpenCL大学课程(11)

简介: 性能优化 1、线程映射    所谓线程映射是指某个线程访问哪一部分数据,其实就是线程id和访问数据之间的对应关系。 合适的线程映射可以充分利用硬件特性,从而提高程序的性能,反之,则会降低性能。    请参考Static Memory Access Pattern Analysis on a Massively Parallel GPU这篇paper,文中讲述线程如何在算法中充分利用线程映射。

性能优化

1、线程映射

   所谓线程映射是指某个线程访问哪一部分数据,其实就是线程id和访问数据之间的对应关系。

合适的线程映射可以充分利用硬件特性,从而提高程序的性能,反之,则会降低性能。

   请参考Static Memory Access Pattern Analysis on a Massively Parallel GPU这篇paper,文中讲述线程如何在算法中充分利用线程映射。这是我在google中搜索到的下载地址:http://www.ece.neu.edu/~bjang/patternAnalysis.pdf

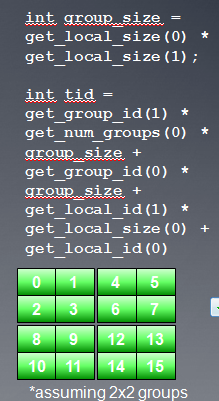
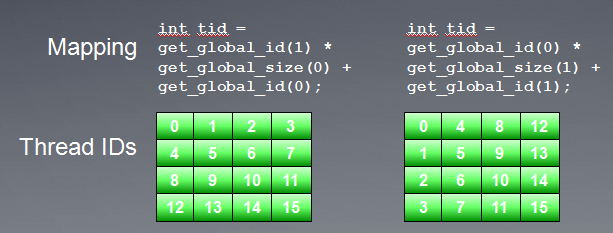
   使用不同的线程映射,同一个线程可能访问不同位置的数据。下面是几个线程映射的例子:
image

image

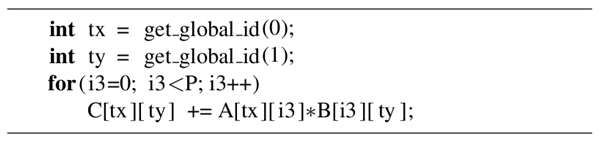
      我们考虑一个简单的串行矩阵乘法:这个算法比较适合输出数据降维操作,通过创建N*M个线程,我们移去两层外循环,这样每个线程执行P个加法乘法操作。现在需要我们考虑的问题是,线程索引空间究竟应该是M*N还是N*M?
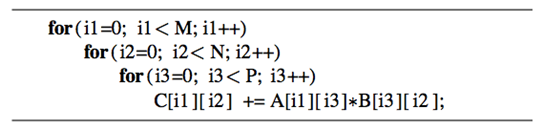
image

    当我们使用M*N线程索引空间时候,Kernel如下图所示:

image

   而使用N*M线程索引空间时候,Kernel如下图所示:image

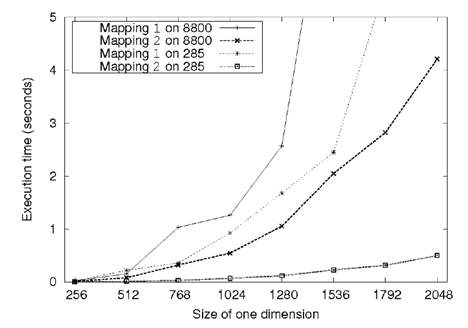
    使用两种映射关系,程序执行结果是一样的。下面是在nv的卡GeForce 285 and 8800 GPUs上的执行结果。可以看到映射2(及N*M线程索引空间),程序的performance更高。
image

    性能差异主要是因为在两种映射方式下,对global memory访问的方式有所不同。在行主序的buffer中,数据都是按行逐个存储,为了保证合并访问,我们应该把一个wave中连续的线程映射到矩阵的列(第二维),这样在A*B=C的情况下,会把矩阵B和C的内存读写实现合并访问,而两种映射方式对A没有影响(A由i3决定顺序)。

   完整的源代码请从:http://code.google.com/p/imagefilter-opencl/downloads/detail?name=amduniCourseCode4.zip&can=2&q=#makechanges下载,程序中我实现了两种方式的比较。结果确实第二种方式要快一些。

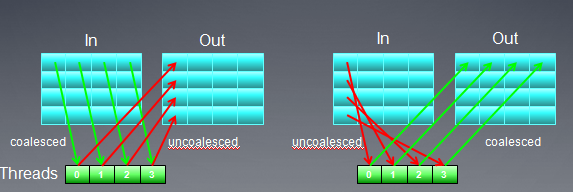
   下面我们再看一个矩阵转置的例子,在例子中,通过改变映射方式,提高了global memory访问的效率。
image

   矩阵转置的公式是:Out(x,y) = In(y,x)

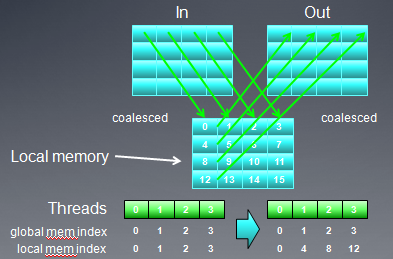
   从上图可以看出,无论采取那种映射方式,总有一个buffer是非合并访问方式(注:在矩阵转置时,必须要把输入矩阵的某个元素拷贝到临时位置,比如寄存器,然后才能拷贝到输出矩阵)。我们可以改变线程映射方式,用local memory作为中间元素,从而实现输入,输出矩阵都是global memory合并访问。
image

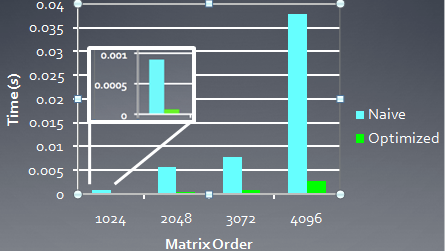
  下面是AMD 5870显卡上,两种线程映射方式实现的矩阵转置性能比较:

image

    完整代码:http://code.google.com/p/imagefilter-opencl/downloads/detail?name=amduniCourseCode5.zip&can=2&q=#makechanges

2、Occupancy

    前面的教程中,我们提到过Occupancy的概念,它主要用来描述CU中资源的利用率。

    OpenCL中workgroup被映射到硬件的CU中执行,在一个workgroup中的所有线程执行完之后,这个workgroup才算执行结束。对一个特定的cu来说,它的资源(比如寄存器数量,local memory大小,最大线程数量等)是固定的,这些资源都会限制cu中同时处于调度状态的workgroup数量。如果cu中的资源数量足够的的话,映射到同一个cu的多个workgroup能同时处于调度状态,其中一个workgroup的wave处于执行状态,当处于执行状态的workgroup所有wave因为等待资源而切换到等待状态的话,不同workgroup能够从就绪状态切换到ALU执行,这样隐藏memory访问时延。这有点类似操作系统中进程之间的调度状态。我简单画个图,以供参考:

image

  • 对于一个比较长的kernel,寄存器是主要的资源瓶颈。假设kernel需要的最大寄存器数目为35,则workgroup中的所有线程都会使用35个寄存器,而一个CU(假设为5870)的最大寄存器数目为16384,则cu中最多可有16384/35=468线程,此时,一个workgroup中的线程数目(workitem)不可能超过468,
  • 考虑另一个问题,一个cu共16384个寄存器,而workgroup固定为256个线程,则使用的寄存器数量可达到64个。

    每个CU的local memory也是有限的,对于AMD HD 5XXX显卡,local memory是32K,NV的显卡local memory是32-48K(具体看型号)。和使用寄存器的情况相似,如果kernel使用过多的local memory,则workgroup中的线程数目也会有限制。

   GPU硬件还有一个CU内的最大线程数目限制:AMD显卡256,nv显卡512。

   NV的显卡对于每个CU内的激活线程有数量限制,每个cu 8个或16个warp,768或者1024个线程。

   AMD显卡对每个CU内的wave数量有限制,对于5870,最多496个wave。

   这些限制都是因为有限的资源竞争引起的,在nv cuda中,可以通过可视化的方式查看资源的限制情况。

3、向量化

   向量化允许一个线程同时执行多个操作。我们可以在kernel代码中,使用向量数据类型,比如float4来获得加速。向量化在AMD的GPU上效果更为明显,这是因为AMD的显卡的stream core是(x,y,z,w)这样的向量运算单元。

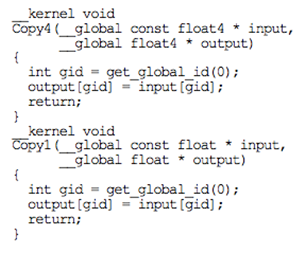
>   下图是在简单的向量赋值运算中,使用float和float4的性能比较。

image

    kernel代码为:

image

    完整代码请从:http://code.google.com/p/imagefilter-opencl/downloads/detail?name=amduniCourseCode6.zip&can=2&q=#makechanges下载

相关实践学习
在云上部署ChatGLM2-6B大模型(GPU版)
ChatGLM2-6B是由智谱AI及清华KEG实验室于2023年6月发布的中英双语对话开源大模型。通过本实验,可以学习如何配置AIGC开发环境,如何部署ChatGLM2-6B大模型。
相关文章
|
3天前
|
云安全 人工智能 运维
当攻击全面Agent化,你的安全防御能否跟上AI Speed?
多起客户侧AK泄露事件应急的真实观察
1217 3
|
26天前
|
人工智能 JSON API
全网刷屏的 Jev 模型正式开放!一手实战测评 + 保姆级教程
全网爆火的 Jev 模型是什么?有什么用?怎么使用?怎么接入 AI 编程工具?效果真的好么?傻子可懂的 Jev 保姆级实战教程 + 项目实战测评来啦
9643 32
|
12天前
|
存储 人工智能 并行计算
大模型本地部署终端选型方法论:以 Qwen3.8-27B 为例的四档分层完整流程
本文提出一套大模型本地部署终端选型方法论:定约束、定档位、定框架、定参数四步决策法,配合入门、主力、质量、无损四档分层模型。以 Qwen3.8-27B 实测数据为例,逐环节解读显存、带宽、存储、散热、系统、预算等要素,给出面向不同预算的优选方案、决策自查清单与市场观察框架。文末前瞻 AI 笔记本的 CPU+GPU 与统一内存两条路线,论证四步决策法在新品类上的延续性。
|
11天前
|
人工智能 JSON 自然语言处理
2026 年 Jev 决策模型深度拆解:原理解读、实战测评与保姆级落地教程
有一款特殊AI模型在开发者圈子刷屏,它摒弃传统大模型擅长的对话聊天能力,专注做高速结构化决策,它就是TypeSafe AI推出的Jev模型。该模型由ChatGPT共同发明人Diogo Almeida主导研发,定位为**System One Model(系统一模型)**,对标人类大脑快速直觉判断的思维模式,在响应延迟、调用成本、结构化输出稳定性上相比传统生成式大模型有着巨大差异。本文会完整拆解Jev底层原理、三大核心原语能力、适用业务场景,同时提供可直接运行的curl、Python代码示例,并且结合多组实测数据,客观分析模型优势与能力边界,帮助普通开发者和AI应用从业者快速上手落地。
824 1
|
7天前
|
人工智能 JSON 自然语言处理
2026 年 Jev 决策模型全解析:核心原理拆解,性能实战测评与落地部署教程
有一款特殊AI模型在开发者圈子刷屏,它摒弃传统大模型擅长的对话聊天能力,专注做高速结构化决策,它就是TypeSafe AI推出的Jev模型。该模型由ChatGPT共同发明人Diogo Almeida主导研发,定位为System One Model(系统一模型),对标人类大脑快速直觉判断的思维模式,在响应延迟、调用成本、结构化输出稳定性上相比传统生成式大模型有着巨大差异。本文会完整拆解Jev底层原理、三大核心原语能力、适用业务场景,同时提供可直接运行的curl、Python代码示例,并且结合多组实测数据,客观分析模型优势与能力边界,帮助普通开发者和AI应用从业者快速上手落地。
548 0
|
3天前
|
Web App开发 人工智能 JavaScript
太猛了,一个月干到15W+,给大家推荐一个最近爆火的开源逆向工具:REA
REA(Reverse Engineer Anything)是近期爆火的开源AI逆向工具,4月发布,1个月内斩获15万+ Star。它让AI Agent无需源码即可分析二进制、APK、JS/Electron、HAR包等17类目标,自动反编译、生成可运行代码,并强制返回带证据与局限的结论。全本地执行,MIT协议,支持Hopper/Ghidra/IDA等引擎,一行命令即可上手。
501 0
太猛了,一个月干到15W+,给大家推荐一个最近爆火的开源逆向工具:REA
|
8天前
|
存储 人工智能 自然语言处理
千问办公官网入口链接在哪?2026年最新QwenWork测评、千问办公怎么样?一文看懂
千问办公(QwenWork)是阿里云推出的AI智能办公平台,提供网页端和阿里云官网双入口。支持PPT/Word/Excel生成、多模态处理、网页全栈搭建、钉钉深度集成等6大核心能力。个人版免费可用,高级版198元/月;企业版198元/人/月。新用户注册即赠2000积分。阿里千问办公QwenWork官网:https://t.aliyun.com/U/0VCTGt 阿里AI工作平台,一句话完成数据分析、PPT 生成、视频剪辑、网页搭建等复杂任务
1097 0
|
6天前
|
存储 人工智能 安全
千问办公官网入口网页版登录:qwenwork.cn 注册送2000积分、登录送100积分
阿里云千问办公(QwenWork)是AI智能工作平台,支持一句话生成PPT、表格、网页、视频及数据分析。个人免费版送2000积分+每日登录赠100分,含1GB存储、5个发布页;企业版198元/席/月起。阿里千问办公QwenWork官网:https://t.aliyun.com/U/0VCTGt 阿里AI工作平台,一句话完成数据分析、PPT 生成、视频剪辑、网页搭建等复杂任务