
本文是《AI工程师踩坑实录》系列第 10 篇,收官篇。任何两段文本算出来都很像,分数挤成一团,排序完全失效,看起来像模型坏了——根因可能只是一个一行的细节,向量没归一化。这一篇用真实 embedding 在本机复现分数失真,把机制和修法一次讲透。
本篇配套的归一化对照实验脚本放在公Z号。
收官篇讲一个最不像坑的坑。它没有报错,没有崩溃,训练照常跑,检索照常出结果。
症状是,你算出来的相似度分数不对劲。要么量纲离谱(几十几百),要么挤成一团(全在 0.9 附近),阈值没法设,调试没法看,跨查询的分数没法比。第 8 篇讲 RAG 拒答阈值的时候埋了个伏笔,阈值能设的前提是分数归一化。这一篇把前置知识补上。
一、实验设置,拿真实的原始向量
用 bge-small-zh 做向量化。注意一个坑中坑,我最初用 sentence-transformers 的 encode() 提取向量,发现范数全是 1.0,点积和余弦完全一样,实验根本复现不了。翻配置才发现,bge 的 sentence-transformers 封装自带 Normalize 模块,输出永远是单位向量。
所以要用 transformers 原始 API 提取 CLS 向量。这才是自己手写 embedding 提取代码时拿到的原始输出,也是这个坑的真实案发现场。
六段文档,一段 CUDA 相关、一段 PyTorch 相关、四段完全不相关(其中一段刻意加长),一个查询。
二、真实结果,同一个查询,两种分数
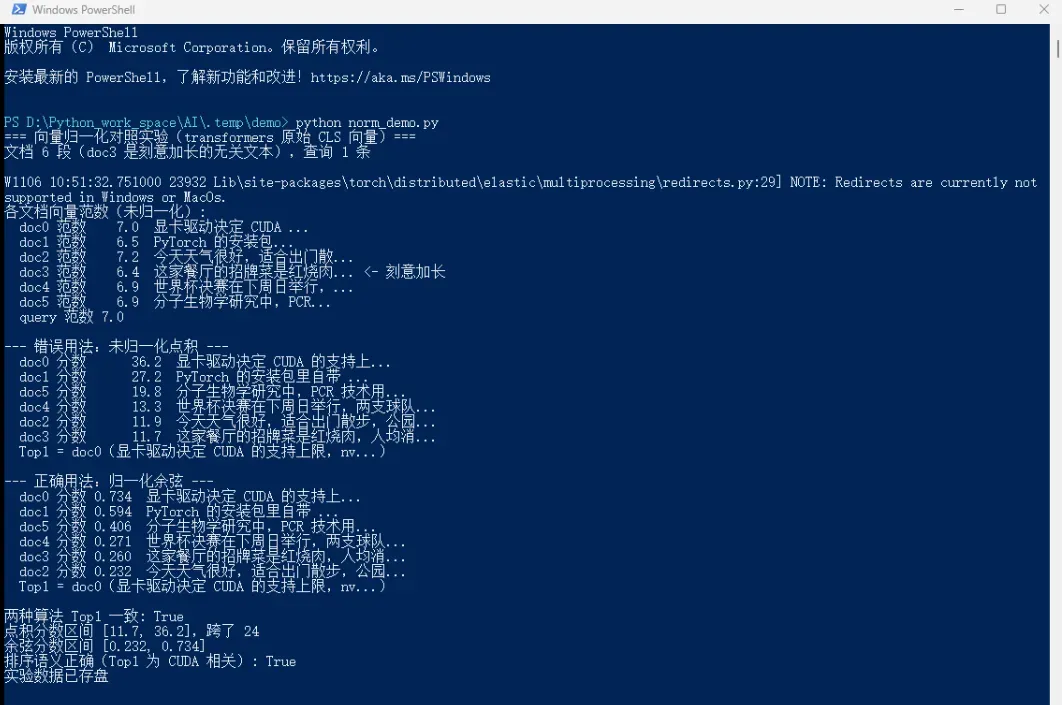
先看范数。六个文档的向量范数在 6.4 到 7.2 之间,看着差异不大。
再看分数。未归一化点积,11.7 到 36.2,跨了 24。归一化余弦,0.232 到 0.734。
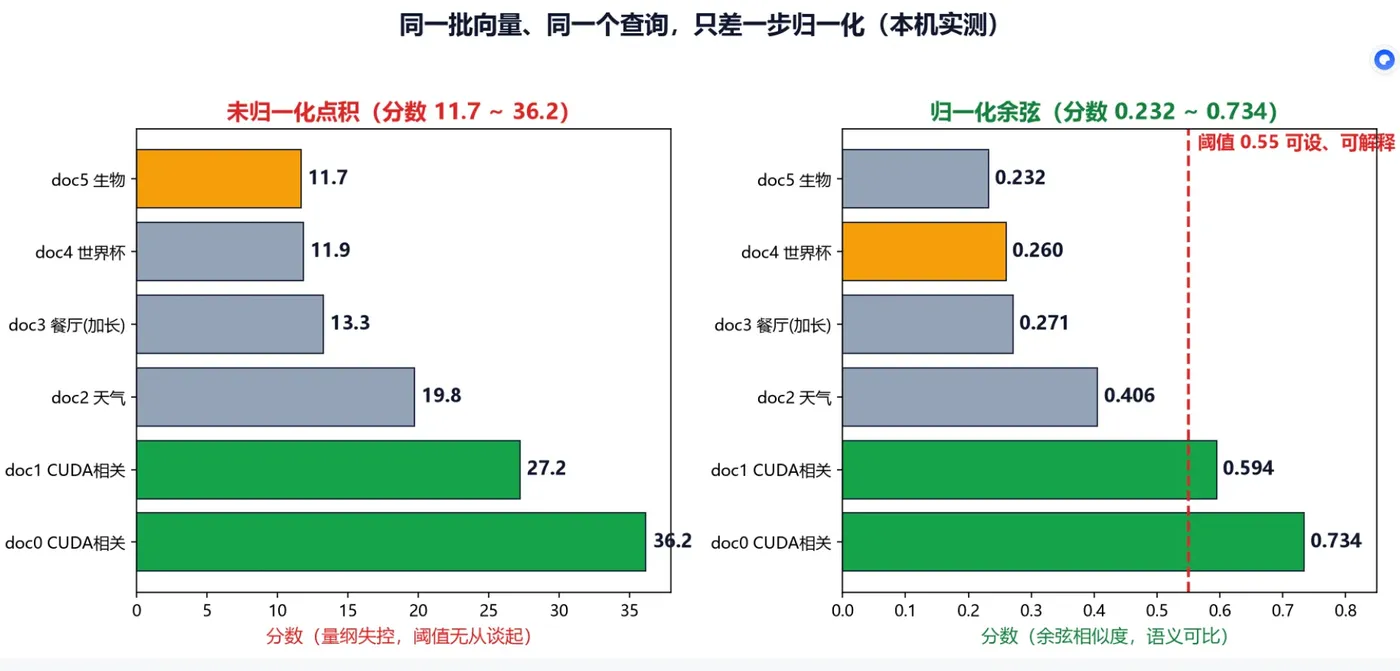
量纲爆炸意味着什么。第一,阈值没法设,第 8 篇那种「0.55 以上算相关」的闸门直接失效。第二,分数没法解释,你看着 36.2 不知道它是很相关还是不相关。第三,跨查询不可比,A 查询的最高分 36,B 查询的最高分 20,不代表 A 的结果更可信。
三、机制,点积里藏了两个不受控的变量
数学上拆开就清楚了。
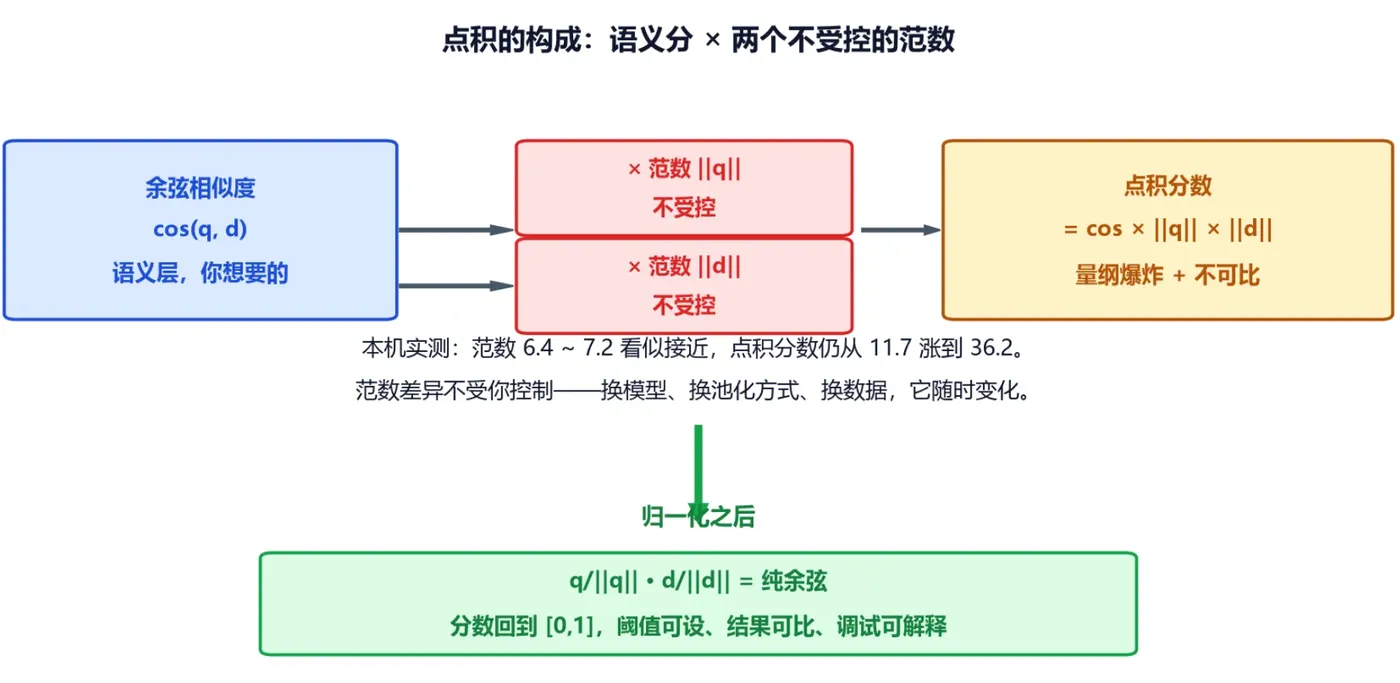
点积等于余弦相似度乘上两个向量的范数。cos 是你想要的语义分,但两个范数不受你控制,它们跟着模型、池化方式、文本内容变化,乘进去之后分数就被「劫持」了。
如实报告一个实验细节。这次实测里两种算法的排序没有翻转(Top1 都是那条 CUDA 文档),原因是六段文本的 CLS 范数恰好接近。但这是运气不是安全——范数差异是自由变量,换个模型(有些模型范数从 1 到 20 不等)、换 mean pooling、换一批数据,排序随时可能被范数大的无关文本劫持。工程上不能靠运气。
四、修法,一行代码,但位置要对
入库前归一化,查询时也归一化。
vecs = vecs / np.linalg.norm(vecs, axis=1, keepdims=True)
q = q / np.linalg.norm(q)
sims = vecs @ q   # 此时点积 == 余弦
两边的归一化都要做,只归一边等于没做。归一化之后,点积和余弦在数学上完全等价,你用哪个都行,且 faiss 这类库的 IP(内积)索引在归一化向量上就是余弦检索,速度不打折。
再给三条实战纪律。归一化放在切片入库的流水线里,而不是查询时临时做(库里存原始向量等于埋雷)。如果用 sentence-transformers,encode 时显式传 normalize_embeddings=True(虽然 bge 配置自带,但显式写出来防的是换模型那天)。上量之后用 faiss 时,先归一化再建 IP 索引,别用 L2 索引的「距离」当相似度凑合(L2 距离和余弦在归一化后单调等价,但语义方向相反,调试时容易绕晕)。
五、常见问题 3 连
1. 网上说的「相似度全是 0.9」是什么情况?
那是这个坑的另一种长相。有些模型或池化方式的输出范数天然接近 1(比如平均池化加某些缩放),点积约等于余弦再乘个 0.9 上下的系数,于是所有分数挤在 0.85 到 0.95 之间。症状不同,根因相同——分数里混进了不受控的范数因子。排序失效、阈值失效的表现是一致的。
2. 余弦相似度一定是 [-1, 1] 吗?
对文本 embedding 实际不是。真实模型的语义空间里,余弦很少低于 0(方向大多在同一半球),所以实际分布往往挤在 0.2 到 0.8。这也是为什么阈值要用自己的问答对实测分布来定(第 8 篇的方法),而不是想当然拿 0.5 当中线。
3. 归一化会影响 ANN 索引的召回吗?
归一化本身不影响(它是等比缩放,方向不变)。要注意的是索引类型和度量要配套——归一化向量 + IP 索引 = 余弦检索,这是标准组合。如果归一化后又用 L2 索引,数学上等价但距离方向相反,写代码时容易出「取 top-k 却拿了最不相似」的低级错误。
六、本篇小结 + 全系列收官
- 点积 = 语义分 × 两个不受控范数,不归一化的分数没有量纲、没有可比性、阈值无从谈起。
- 本机实测,范数 6.4-7.2 的向量,点积分数从 11.7 爆到 36.2,归一化后回到 0.232-0.734。
- 修法一行代码,但入库流水线里就要做,两边都做,别靠运气。
十篇写完,回顾一下这条线。前四篇是环境与训练(CUDA 版本、断点定位、标签错位、loss NaN),第五到六篇是工程细节(多进程卡死、PATH 优先级),第七到八篇是评估与落地(数据泄漏、RAG 幻觉),最后两篇是可信度本身(可复现性、分数可解释性)。串起来其实是一件事——让你交付的每一个数字,都经得起追问。
坑还会继续踩,踩到了继续写。
本篇坑卡片
| 字段 | 内容 |
|---|---|
| 坑名 | 相似度计算未归一化,分数失去量纲与可比性 |
| 现象原文 | 点积分数区间 11.7~36.2(量纲爆炸),阈值无法设置,分数不可解释 |
| 环境 | Win11 + CPU,bge-small-zh-v1.5(transformers 原始 CLS 向量) |
| 复现步骤 | 原始 CLS 向量未归一化点积 → 分数 11.7~36.2 → 归一化后余弦 → 0.232~0.734,阈值可设 |
| 根因 | 点积 = cos × 范数积,两个范数是随模型与文本变化的自由变量 |
| 解法 | 入库与查询两侧都归一化,之后点积与余弦等价,配 faiss IP 索引 |
| 避坑建议 | 归一化进入库流水线;sentence-transformers 显式传 normalize_embeddings;注意 bge 封装默认已归一化(自写提取代码才是案发现场) |
| 可信度 | 本机验证 |
| 版本时间戳 | 2026-11-06,bge-small-zh-v1.5 |
| 关联坑 | 第 8 篇 RAG 阈值(归一化是阈值的前提) |
专栏导航
| 篇次 | 主题 | 状态 |
|---|---|---|
| 1 | nvidia-smi 显示的 CUDA 版本到底是不是你装的那个 | ✅ |
| 2 | torch.cuda.is_available() 一直是 False,一条命令定位断点 | ✅ |
| 3 | 标签和图像没对齐,模型一直在学噪声 | ✅ |
| 4 | loss 变 NaN,用 hook 逐层定位 | ✅ |
| 5 | DataLoader 卡死在第一个 batch,Windows 多进程的坑 | ✅ |
| 6 | 装了两套 CUDA 还在串,PATH 与优先级的真相 | ✅ |
| 7 | 数据泄漏:预处理做在了划分之前 | ✅ |
| 8 | RAG 答一半开始编,检索阈值与拒答机制实操 | ✅ |
| 9 | 随机种子都设了,结果还是不可复现 | ✅ |
| 10 | 相似度全是 0.9:向量没归一化 | ✅(本篇) |
| 11 | 开了混合精度就 NaN,GradScaler 到底在做什么 | 排期中 |
| 12 | loss 不降反升,先别怀疑模型结构 | 排期中 |
| 13 | 训练降验证不降:先查数据再谈正则 | 排期中 |
系列收官预告,第一季 10 篇完结。第二季已在选题池排队(top-k 调大反而更差、Tokenizer 静默截断、ONNX 转换精度对不上等),全部延续本机真实复现的路子。感谢追更,评论区告诉我你最想先看哪篇。
版权说明,本文实验数据与截图均来自本人真机复现,专栏读者可学习使用,禁止转售或整篇搬运。
