哈喽,大家好!
我是阿星👋
最近我做了个小实验:让 Codex 研究我电脑里的某答清单,一个效率管理软件,然后做一个自己的版本。
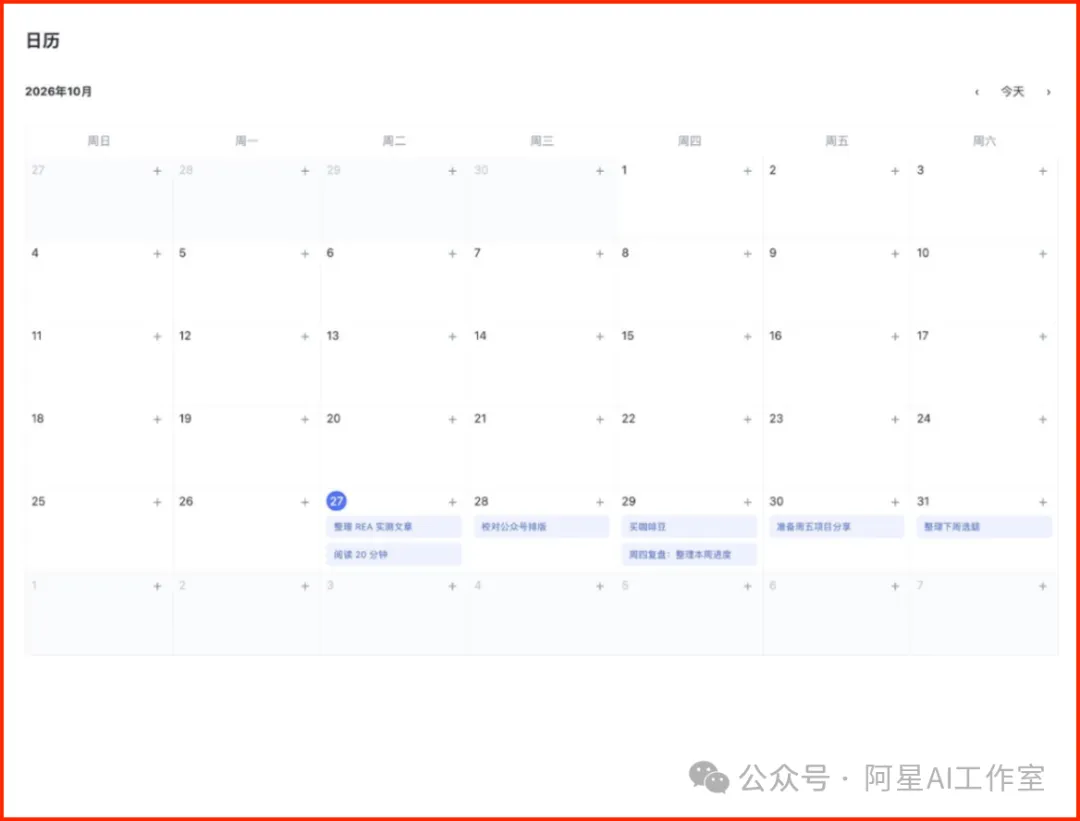
先看结果👇原版与复刻版的日历放在一起:上面是某答清单的示例数据,下面是复刻版的演示数据。
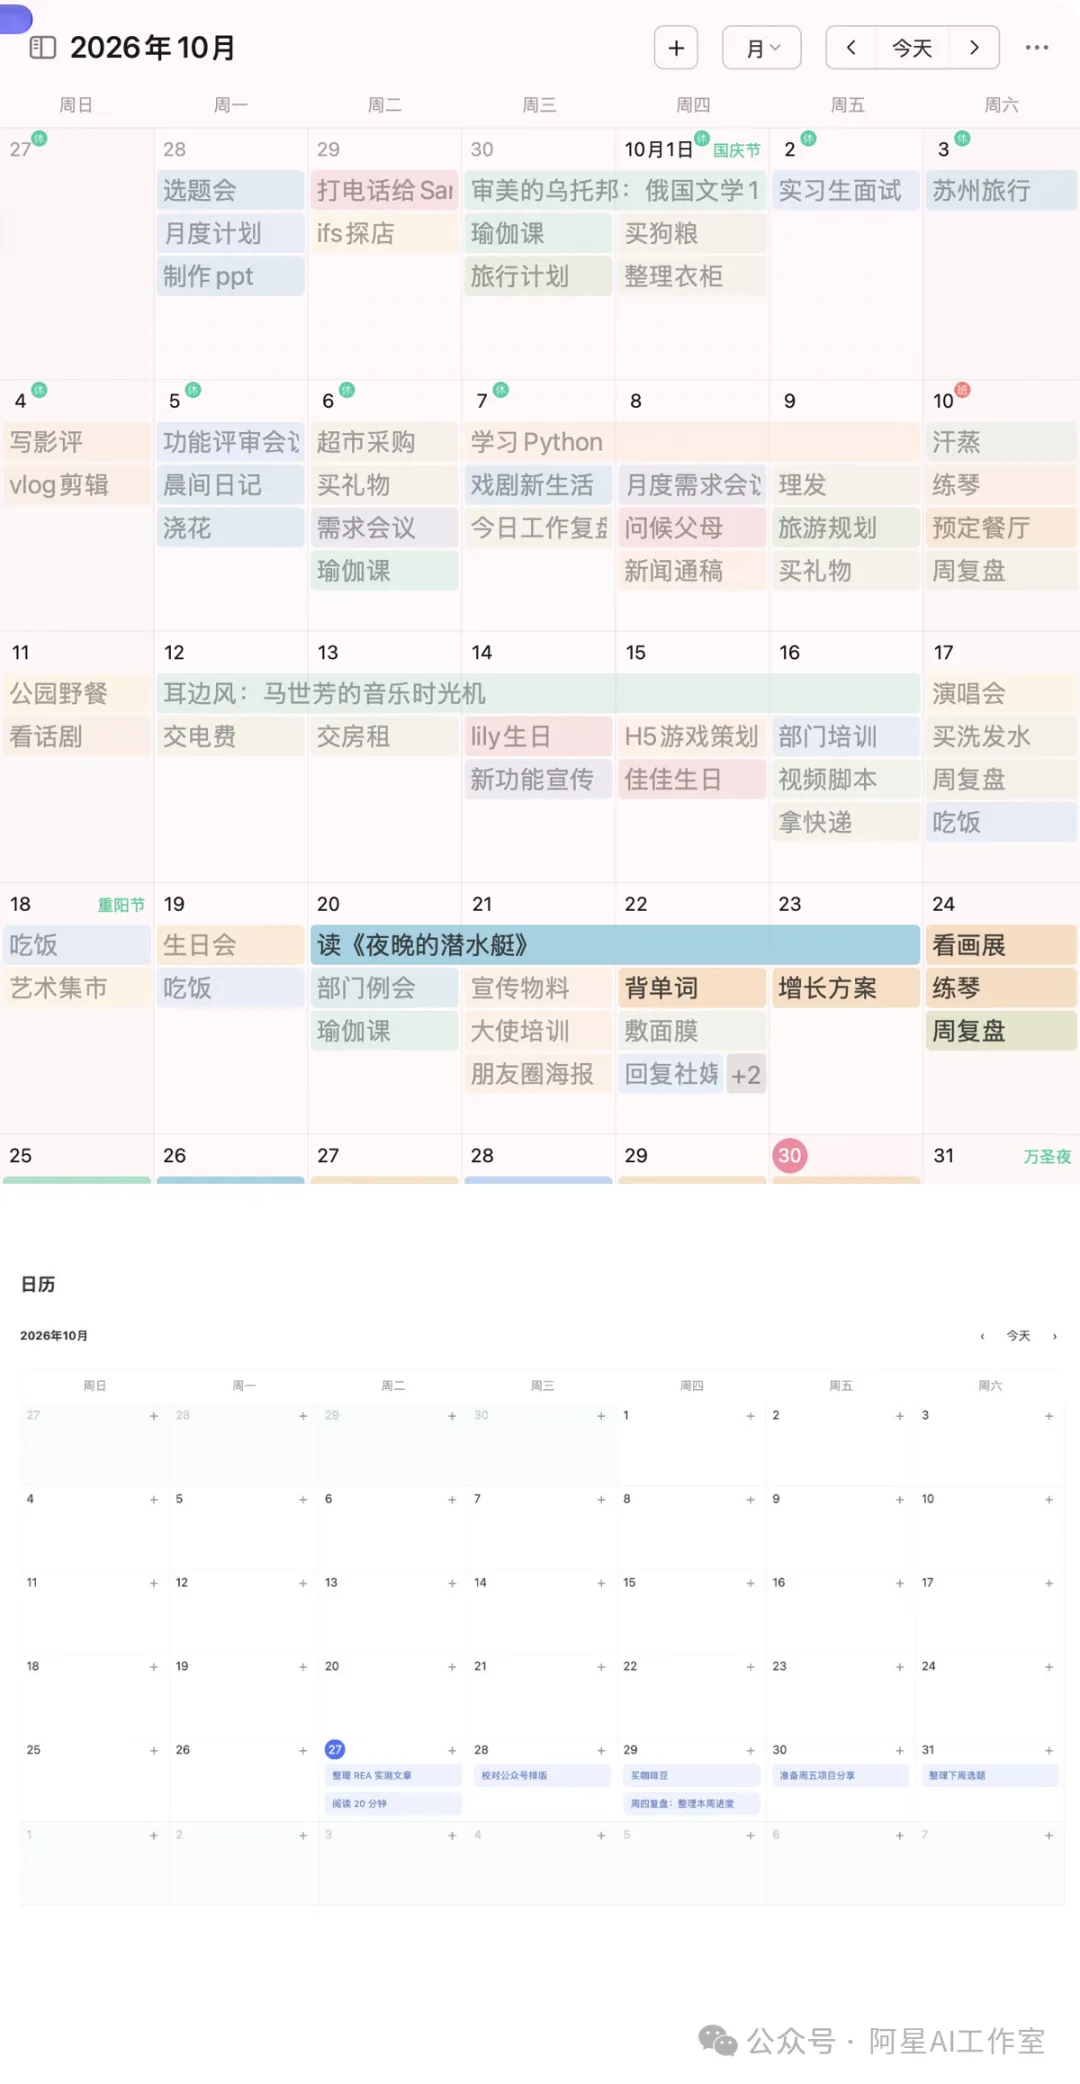
日历对比:上方原版,下方复刻版
这是一个在浏览器里运行的本地网页。任务可以新增、编辑、设置日期和优先级,也有日历和四象限。
这次有意思的地方,是我没有先把每个页面截图、每个功能写成需求文档。我给 Codex 配了一个叫 REA 的工具,让它先去看看原软件里面有什么。
01给 Codex 一套逆向工具
以前让 AI 复刻一个软件,我一般会给截图,再告诉它按钮在哪里、点下去会发生什么。
这次我想试试另一种方式:软件已经装在电脑上,能不能让 Codex 自己去调查,再根据查到的东西动手?
这里用到的 REA,全名是 Reverse Engineer Anything。它是一套给 AI Agent 使用的逆向分析工具,能帮它检查软件包、资源、界面文件,也能接其他分析工具进一步研究程序。
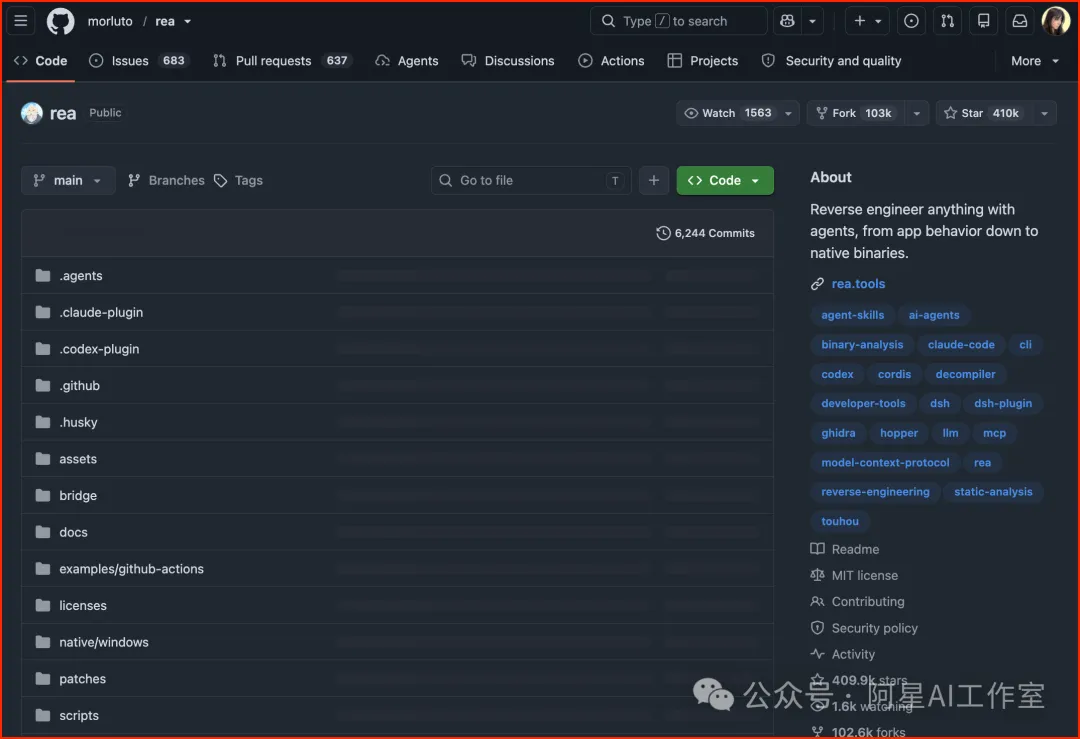
可以理解成,Codex 负责思考和动手,REA 给它提供调查工具。
我给 Codex 的任务也很直接:用 REA 看看本机的某答清单,在独立目录里复刻一个能启动的版本,界面和功能尽量接近。
这里顺便解释一下,为什么我们不能直接让 AI 打开软件,拿到它的源码。
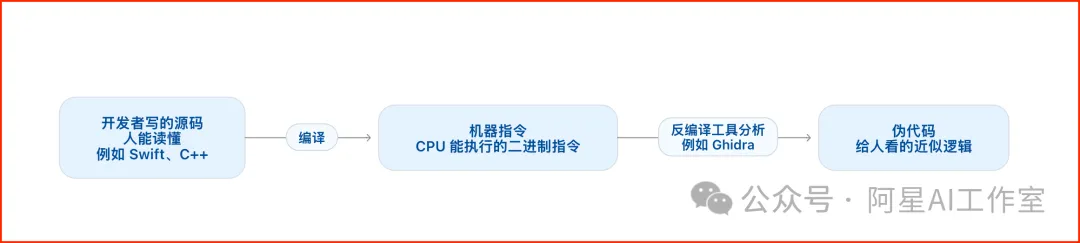
我们下载安装的应用,通常已经经过编译,变成了电脑可以运行的程序。原来代码里的注释、部分变量名和写法,编译后不一定还保留着。逆向分析就是从这个成品出发,尝试弄清它的结构和行为。
02接下来,让 Codex 把它做出来
查完之后,Codex 开始写自己的实现。
它把任务清单、详情、日历和四象限搭成了一个本地应用。任务数据保存在本机,在清单里编辑过的事项,也能按日期显示在日历里。
复刻版任务清单和详情
搜索也能用,输入关键词就可以找到相关事项。
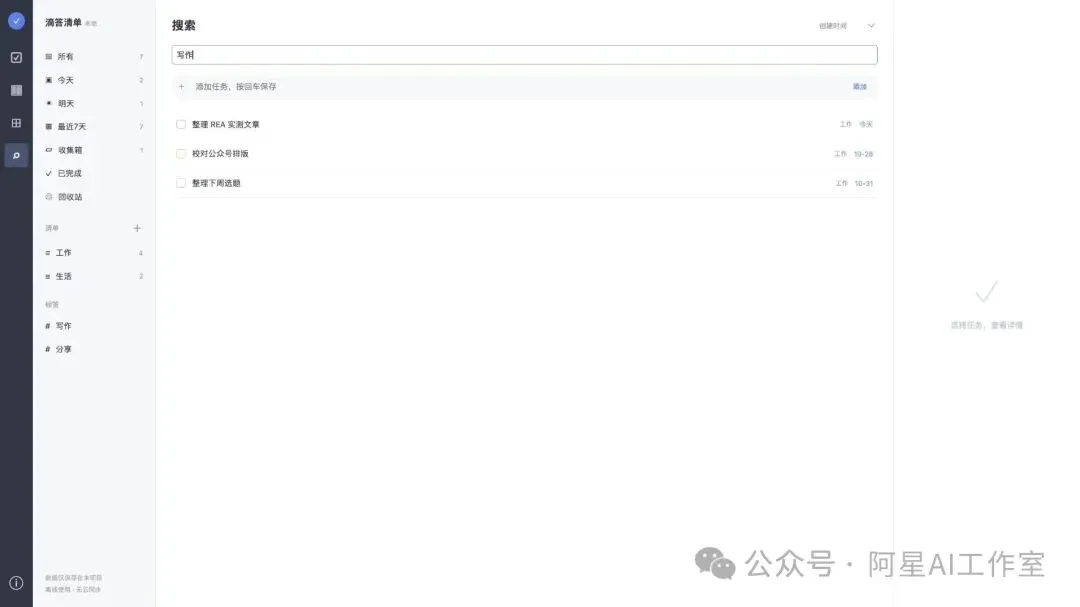
搜索写作相关任务
这里要说清楚:REA 给的是调查线索,后面的页面和功能是 Codex 重新写的,并不是把原软件的源码直接拿出来。
第一版跑起来以后,我就开始上手点。结果很快发现了三个问题。
日历和四象限里都不能直接新增事项;四象限里的任务拖不动;设成高优先级的任务,也没有放到我预期的左上角。
页面看着都有,但要真正用起来,这几步少一项都别扭。
我把这三个问题直接发给 Codex,让它接着改。
日历里,每个日期旁边加了一个+。点开以后日期已经填好,输入任务名称就可以。
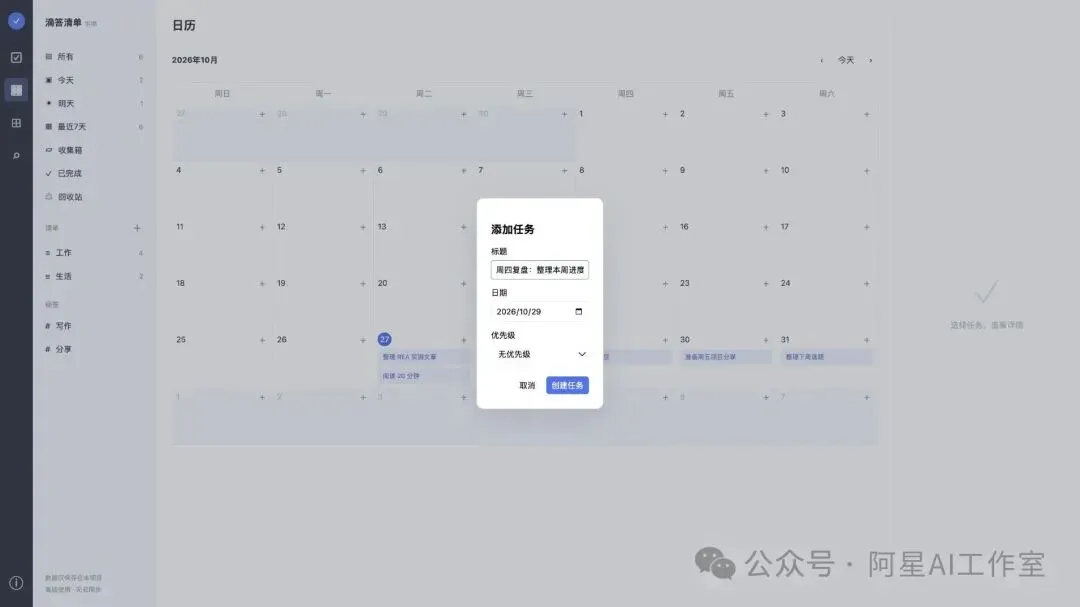
从日历新增事项
四象限也加上了新增和拖动。
我希望高优先级的任务放在左上角,拖过去以后优先级跟着调整,日期保留。
这是调整前后的样子👇
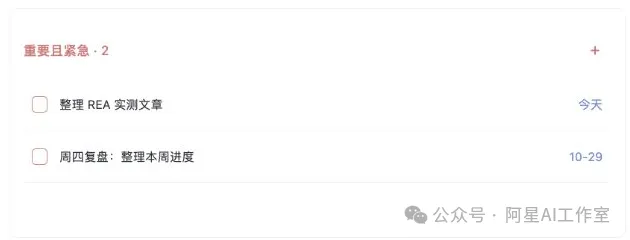
调整后任务进入左上角
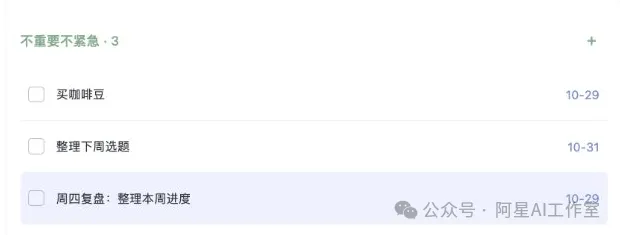
调整前任务在右下角
这一轮我没有写什么复杂的提示词,就是把自己操作时遇到的问题说清楚。
Codex 改完,我再打开看。
03REA 查到了什么?
Codex 首先检查了某答清单的 Mac 应用包。
一个应用包里除了程序,还有界面文件、图片和文案等资源。这次清点到了 401 个界面文件,接着用 REA 解析了其中 64 个,读出一部分界面对象和连接关系。
比如,里面有个叫 TTAddTaskBarViewController 的控制器。从名字可以推测,它和添加任务的界面有关。界面文件中还有按钮和连接,能给 Codex 提供进一步调查的线索。
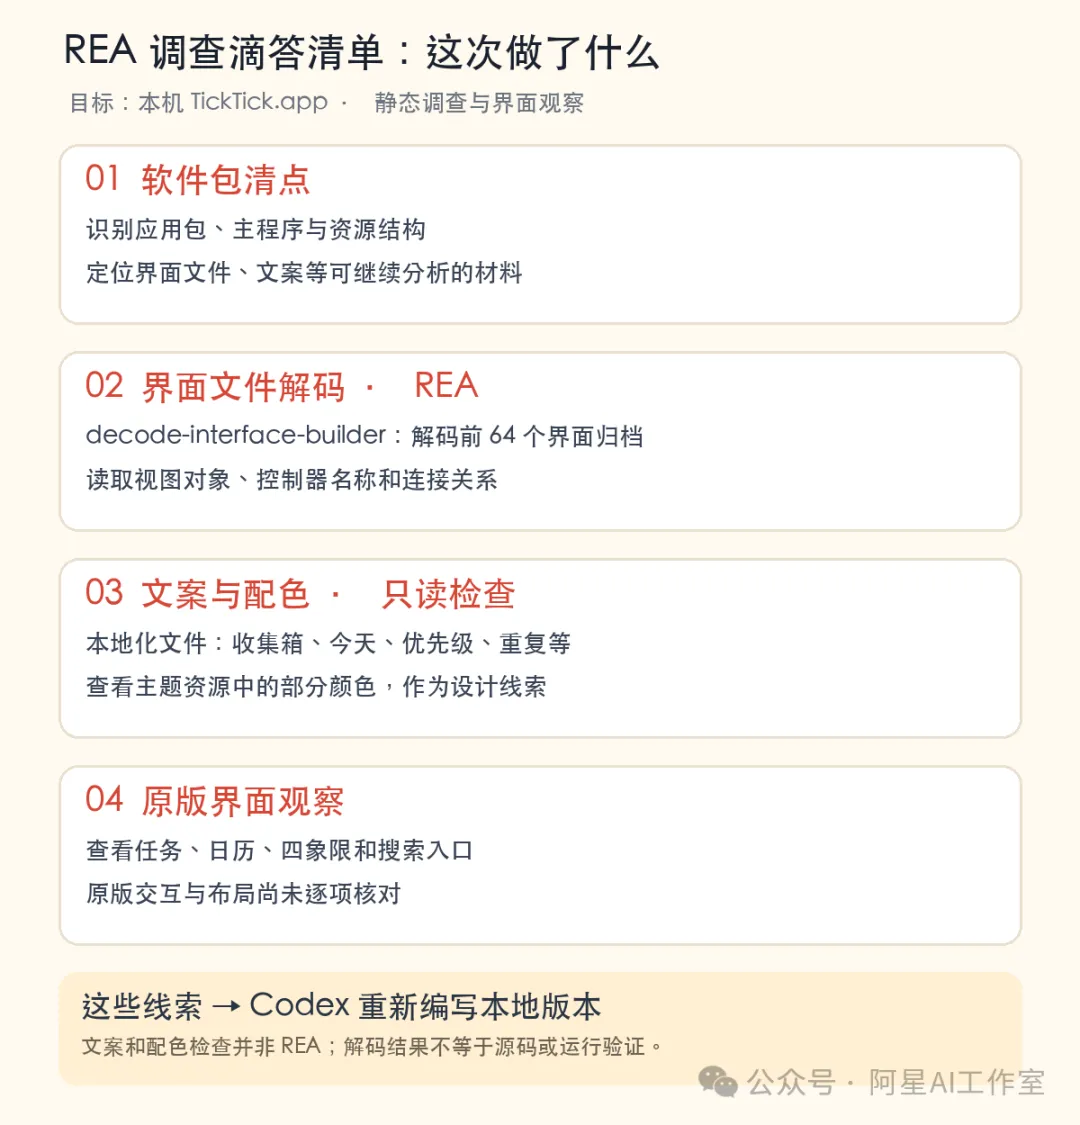
另外,软件里的中文文案也能找到:收集箱、今天、最近 7 天、优先级、重复……这些熟悉的入口和功能名称,都可以作为参考。这些信息让 Codex 知道了更多关于原软件的线索,也给后面的实现提供了参照。
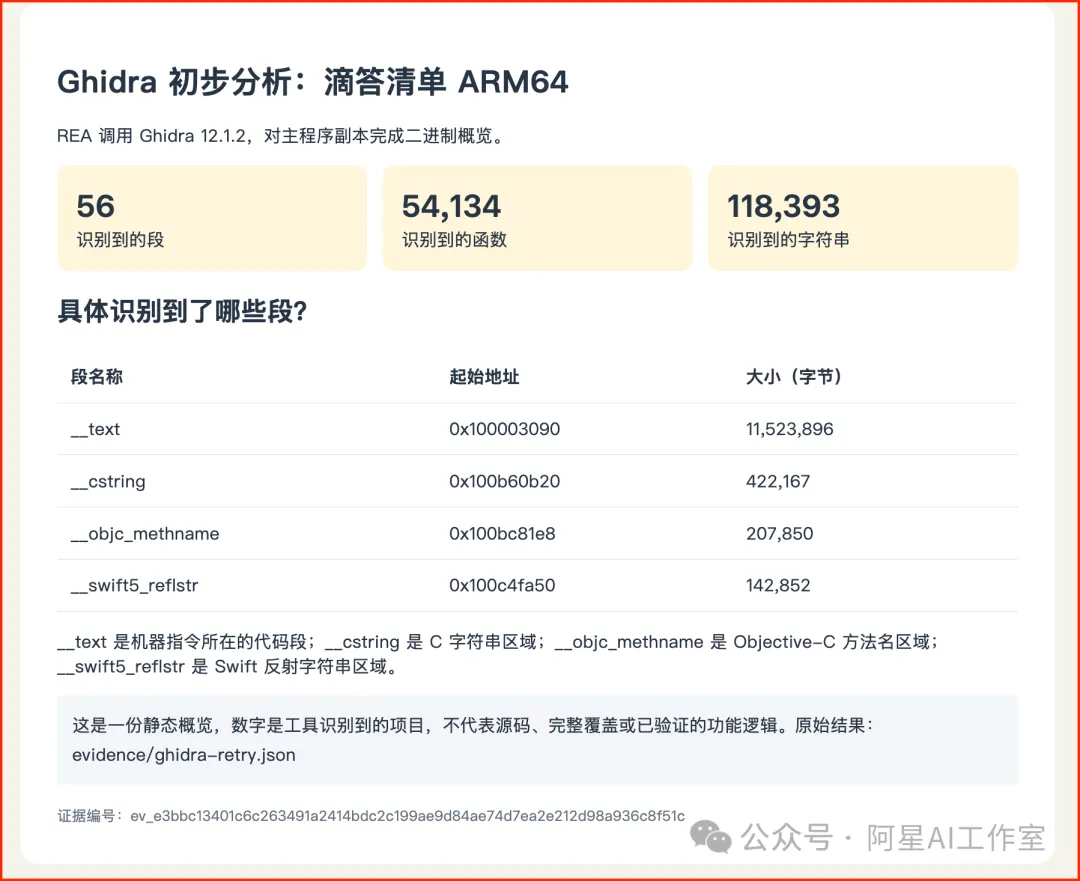
我还试着让 REA 接上 Ghidra,进一步分析某答清单的主程序,看看能不能找到更细的功能逻辑。也就是尝试把机器码还原成更容易阅读的伪代码,再交给 Codex 继续分析。
环境检查通过后,我从原程序中提取了一份适用于 Apple 芯片的 ARM64 版本,交给 Ghidra 分析。
其实做的过程中你会发现,更让人受启发的其实rea这个项目本身,因为逆向的本质是一套调查流程。rea让这套流程标准化,防止模型在反编译的时候瞎胡推断。原生二进制交给 Hopper Ghidra IDA,Android 交给 JADX,固件交给 Binwalk,抓包交给 TShark,硬件信号交给 sigrok。REA把这些能力包成统一的 MCP 工具,以及规定每一个返回值必须长什么样。
但是。。。这个Ghidra第一次分析跑了四分钟,最后超时了。我再试了一次。这次成功拿到了主程序的初步分析结果,可以看到代码段、字符串等结构。
04这次用下来
总之,现在这款复刻版能做基本的本地任务管理,云同步、提醒、习惯这些功能还没有。原版界面也没做完逐项对照,所以它离一个完整的某答清单还需要多一点的时间。
先记到这里。后面继续用,遇到问题再让它改。
如果你也想体验一把逆向,不防试试rea。
OK,我是阿星,
更多 AI 应用,我们下期再见👋