
从 Agent 循环与工具接口,到上下文、沙箱、验证与长时运行工作
一册写给 AI 工程师、开发者与严肃学习者的短篇技术手册
@techNmak —— Understanding AI https://x.com/techNmak/status/2106765347793858563
English version: Understanding Harness Engineering
0. 导言
一个能力很强的语言模型,本身并不等于一个能干活的 agent。必须有某种东西来决定模型看到什么、暴露它能采取哪些动作、执行这些动作、返回观察结果、保存有用状态、落实权限管控、在失败后恢复、判断是否还需要下一步,并最终确定任务是否真的成功了。
这层围绕模型的机制,如今越来越多地被称作 agent harness。
这套术语还很年轻。微软目前用 agent harness 指把语言模型变成 agent 的运行时脚手架——通过编排模型调用、工具调用、上下文、状态、审批和多步执行来完成这件事 [15]。Anthropic 的用法与之接近:它把持久化的 session、运行模型/工具循环的 harness、以及执行代码的 sandbox 三者分开 [12]。OpenAI 的 harness engineering 则用得更宽,指为了可靠完成 agentic 工作而做的环境工程、反馈回路、仓库结构、约束、可观测性,以及其他各类脚手架 [10]。
本文采用如下操作性区分:
- Agent harness:紧贴模型外围、让它能跨多步采取行动的运行时与控制机制。
- Harness engineering:更广的工程学科——设计接口、上下文策略、状态、执行环境、控制手段、反馈系统、恢复行为与验证机制,使 agentic 工作变得可靠。
这是本手册自定的编辑用分类,不是行业标准定义。
读完之后,你应该能解释:
- 为什么一次模型调用还不等于一个 agent;
- 最小 agent 循环是怎么运转的;
- 模型、harness、session、工具与沙箱各自有何不同;
- 为什么工具设计会改变 agent 行为;
- 为什么 MCP 有用,但它并没有规定一套完整的 agent 架构;
- 为什么活跃上下文与持久状态不是一回事;
- 为什么压缩(compaction)是有损的;
- 权限、遏制、凭据与审批各自解决的是不同问题;
- 为什么工具失败需要模型可用的错误语义;
- 为什么围绕非幂等副作用的重试会变得危险;
- 为什么验证应当与自我报告的完成状态分离;
- 长时运行的 agent 如何继承那些熟悉的持久性与一致性问题;
- 什么时候子 agent 有帮助,什么时候协调成本会占上风;
- 评测是如何把模型与 harness 一起度量的;
- 为什么随着模型进步,harness 的假设应当被重新检验。
前置知识:只需对语言模型推理、函数/工具调用、上下文窗口以及常规软件系统有基本了解。
范围:这是一册关于 agentic 模型执行外面那层系统的手册。它不是完整的 MCP 手册、不是 agent 安全教科书、不是分布式系统教科书,也不是所有 agent 框架的名录。
1. 一次模型调用不是一个 Agent
一次语言模型调用可以抽象地写成:
y ~ p_theta(. | c)
其中 c 是提供给模型的上下文,y 是生成的输出。这个式子里没有任何东西自动意味着 shell 命令会被执行、浏览器会被打开、文件会被修改、API 调用会被重试、失败会被观察到,或者工作会在第一次响应之后继续。
一个 agentic 系统,是在模型推理之外加上一个外部控制过程。一个有用的概念分解是:
agent system ~= model + harness + environment
这不是一个形式化恒等式,而是一个心智模型。模型提供习得的能力。harness 决定推理如何与动作相连、并随时间反复执行。环境则包含动作所检视或修改的外部状态。
Anthropic 区分了普通的 workflow(其执行路径在很大程度上由应用代码规定)与 agent(由模型动态选择动作与策略)[4]。微软同样区分了普通 agent、workflow,以及为更长多步工作而装配起来的 harness agent [15]。
因此,真正重要的边界并不是营销标签意义上的“聊天机器人 vs. agent”。而是:模型输出是否进入了一个与外部状态彼此作用的受控交互循环。
2. 最小 Agent 循环
一个 harness 可以用四个不断演进的对象来描述。设:
s_t = 第 t 步之前的持久状态或工作状态
c_t = G(s_t) = 为下一次模型调用所选出的上下文
a_t = M(c_t) = 模型输出,其中可能包含一个动作请求
o_t = E(a_t) = 动作若被执行,环境所产生的观察结果
随后 harness 更新状态:
s_(t+1) = U(s_t, a_t, o_t)
这套形式化是我们自己提出的,并非某个标准 API。循环是这样的:
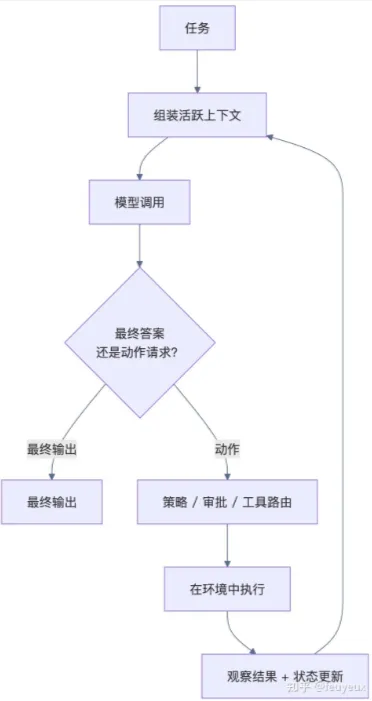
现代的 runner 通常会执行这个循环的某种变体:调用模型、检查响应、若是最终结果就返回、若请求了工具就执行、把结果追加进去,然后再次调用模型 [14]。
ReAct 是一项重要的研究前作。它研究的是那种推理与任务动作交错的语言模型轨迹,使得外部观察能够影响后续决策 [1]。现代 harness 并不需要暴露或持久化私有推理轨迹,也能保留那个在系统层面至关重要的想法:行动、观察、更新、继续。
3. Harness 究竟控制什么
“harness”这个词之所以有用,是因为我们可以列出那些不属于模型权重的职责。一个 harness 可能决定:
- 哪些指令与状态进入下一次上下文;
- 哪些工具是可见的;
- 工具 schema 如何被表达;
- 某次工具调用是否被允许;
- 是否需要人类审批;
- 工具如何执行;
- 工具结果在返回给模型之前如何被变换;
- 历史如何被持久化;
- 上下文如何被压缩;
- 何时创建子 agent;
- 错误如何被返回;
- 重试如何被处理;
- 哪些预算会终止一次运行;
- 在接受“完成”之前需要什么证据;
- trace 与指标如何被记录;
- 中断之后执行如何恢复。
并非每个 harness 都拥有上述全部关注点。有些系统会把状态、执行、策略或恢复委托给其他组件。
也正因如此,“harness”最好被当作一个控制平面(control-plane)概念来理解,而不是某个库或某个进程的同义词。
例如,OpenAI 当前的 Agents API 管理 session、编排、上下文压缩与恢复,同时允许应用自行选择工具与执行环境 [14]。微软的 Harness 则组合了 chat client、context provider、持久化、压缩、审批、可观测性与有界循环 [15]。
这些例子是实现快照,不是永久定义。截至本手册成文时,OpenAI 的 Agents API 处于公测阶段;微软打包的 Harness 工厂已发布,而后台 agent、文件访问与循环仍标记为实验性,其 shell 工具链还是预发布状态。
4. 模型、Harness、Session、工具与沙箱
这些术语描述的是不同的系统对象。
| 术语 | 有用的含义 |
|---|---|
| 模型 Model | 习得的推理系统 |
| Agent | 在通往某个任务的行动循环中运行的模型 |
| Harness | 驱动该循环的运行时/控制机制 |
| Session | 承载进行中工作的逻辑历史/状态容器;其持久性取决于具体实现 |
| 上下文 Context | 提供给某一次特定模型调用的信息 |
| 工具 Tool | 暴露给模型的可调用能力 |
| 沙箱 Sandbox | 受控的执行环境 |
| Workflow | 在很大程度上由代码规定的执行结构 |
| Evaluation harness | 运行评测并给出评分的基础设施 |
Anthropic 的 Managed Agents 架构显式地分离了 session、harness 与 sandbox。session 是仅追加的日志,harness 调用模型并路由工具调用,sandbox 则运行代码与编辑文件 [12]。
OpenAI 在其沙箱架构中做了相关区分:harness 是围绕模型调用、路由、审批、tracing、恢复与运行状态的控制平面;sandbox 则是执行平面,负责读写文件、运行命令、安装依赖与做状态快照 [14]。
这些边界的具体实现方式可以不同。但这种概念上的分离依然有用,因为这些组件的失败方式不同,所承担的信任假设也不同。
5. Agent-Computer 接口
模型从不与抽象意义上的“计算机”交互。它与一个接口交互。
某个 coding harness 可能暴露:
read_file(path, start_line, end_line)
search_code(query)
apply_patch(path, patch)
run_tests(target)
另一个可能只暴露:
shell(command)
两者最终或许都能操作同一个仓库。但它们给模型呈现的并不是同一个问题。
SWE-agent 把这个想法形式化为 Agent-Computer Interface(ACI)。这项工作并不假设“为人类开发者设计的接口自动地对语言模型最优”,而是把接口设计本身当作一个实验变量。作者围绕 agent 的行为设计了仓库导航、编辑、测试与反馈机制,然后测量这些选择如何影响性能 [2]。
其原论文报告:在所评测的 SWE-agent 配置下,SWE-bench 上 pass@1 为 12.5%,HumanEvalFix 上为 87.7% [2]。这些数字是针对该论文的模型、harness、任务与评测流程所得的历史结果,并不是关于 ACI 设计的普遍性论断。
真正留下来的贡献,是一个工程问题:
这个能力是仅仅存在,还是以一种模型能够可靠使用的形式被暴露出来?
6. 可供性、契约、观察与反馈
分析任何面向 agent 的工具,一个有用的方式是看四个属性。
- 可供性(Affordance):这个工具能执行什么操作?
- 契约(Contract):模型如何请求这个操作?
- 观察(Observation):返回什么信息?
- 反馈(Feedback):结果是否让下一个正确动作变得更容易?
以文件编辑为例。裸 shell 提供了巨大的可供性;但它也迫使模型去挑选命令、给路径正确地加引号、推断工具输出,并从格式错误中恢复。而一个结构化的 patch 工具缩小了动作面,却可能让意图更容易表达、结果更容易验证。
两种接口没有一种是普遍更优的。正确的设计取决于模型、任务、环境与评测。关键在于:接口结构会成为任务实际难度的一部分 [2,5]。
7. 工具是模型输入的一部分
工具不只是可执行的代码。它的名称、描述、参数与结果表示,通常都会被放进模型的上下文。
这意味着,工具设计在工具被调用之前就已经影响了推理。
Anthropic 把工具设计刻画为传统软件与概率性 agent 行为之间的一个接口问题。他们的工程工作强调:目的清晰、参数无歧义、命名空间划分、响应内容有用、结果 token 高效 [5]。
有两项成本值得分开看:
C_tool = C_selection + C_observation
这是一种概念性分解。C_selection 是选对工具与参数的难度。C_observation 是返回结果对上下文与推理所施加的负担。
一个后端 API 很优雅的工具,对 agent 而言仍然可能是糟糕的——如果它的描述与其他工具重叠,或者它的结果把无关数据倾倒进上下文窗口。
8. 更多工具可能让决策变得更难
一个系统可能会暴露六个高度重叠的操作:
search()
find()
lookup()
query()
grep()
retrieve()
从传统的能力视角看,这很“丰富”。但从模型的视角看,每多一个工具,就等于在动作空间里多加一个选择。
Anthropic 报告了一种常见失效模式:臃肿或重叠的工具集会造成模糊的决策点。他们的工具设计指南建议:尽可能只保留数量更少、彼此区分度更高的操作,用命名空间分隔相关能力,并且要评测命名方案,而不是假定存在某种通用约定 [5]。
这给出一条有用的生产规则:
工具数量不是 agent 能力的单调指标。
增加一个工具可以扩展可达行为,同时也可能让工具选择变得更难。这个取舍应当在有代表性的任务上实测,而不是靠审美来定。
9. 工具结果应当返回高信噪比上下文
假设一个 agent 要查一条客户记录。低层 API 可能会返回几百个字段、内部标识符、分页元数据、图片变体、审计记录与存储键。
人类写的程序可以几乎不费成本地忽略这些字段。而语言模型必须用它的上下文预算来消化返回的文本。
Anthropic 建议返回高信噪比的信息,对可能很大的结果使用过滤与分页,并在合适的地方暴露“精简模式”与“详细模式” [5,6]。究竟什么格式最好,会随任务与模型而变化。
这意味着,评价一个工具结果不能只看正确性。要问:
- 它是否返回了下一步决策所需的信息?
- 它是否省略了无关的载荷?
- 它是否保留了后续动作所需的标识符?
- 截断是否说明了如何取回更多?
- 该格式是否让结果易于解读?
工具输出是上下文工程的一部分。
10. 工具错误同样是一种观察
一次工具失败可以终止运行、触发自动重试,或者返回一个模型可见的错误并允许恢复。这三种语义是不同的。
设想:
deploy_service(environment="prod")
因为请求的分支不存在而失败。像 Error. 这样不透明的返回会迫使模型去猜。而一个更有用的返回可能是:
status: failed
reason: branch_not_found
requested_branch: release/2.4
available_branches: [...]
side_effects: none
retryable: true
确切的 schema 是应用相关的。通用原则不是。
OpenAI 当前的 Agents SDK 区分了两种情况:把 toolNotFoundBehavior 设为 return_error_to_model,可以把一个没有匹配到具体工具的函数调用转成模型可见的错误,使运行得以继续;此外,toolErrorFormatter 用来定制返回给模型的工具错误消息 [14]。Anthropic 同样建议使用可据以行动的校验错误,而不是不透明的错误码或原始 traceback [5]。
一次可恢复的失败,应当给模型足够的信息去选择一个更好的下一步,同时不假装那次失败的操作已经成功。
11. MCP 是互操作层,不是一套完整的 Agent 循环
Model Context Protocol 标准化了 AI 应用与外部能力之间的接口。
带明确日期版本的 MCP core server 规范,以 prompts、resources 与 tools 等 server 原语为中心。Tasks 是一个独立、可选的 MCP 扩展,并非核心协议的一部分。 截至本手册成文时,第一方 MCP 各处对其成熟度的描述并不一致:MCP extensions overview 把 MCP Tasks 列在官方扩展仓库之中,而 ext-tasks 仓库的 README 却把该仓库标为实验性、非官方,已发布的 Tasks 规范页面又被标为 Draft。由于这些第一方标签彼此冲突,本手册把 Tasks 当作一个仍在演进的可选扩展,而不给它指定单一的成熟度状态 [13]。
当前已发布的 Tasks 草案允许 server 为一次 tools/call 返回一个异步任务句柄,并定义了 tasks/get、tasks/update 与 tasks/cancel。它建议客户端把任务 ID 持久化到持久存储,以便在崩溃或重启之后恢复轮询。任务支持需要显式协商,且宿主支持情况可能不同 [13]。
这让 MCP 越来越有能力,但一条重要边界依然存在。MCP 本身并不决定:
- 模型循环如何被调度;
- 活跃上下文如何被选出;
- 一个任务如何被判定为完成;
- 哪些动作需要审批;
- 副作用如何被重试;
- 沙箱如何被准备;
- 多个 agent 如何协调;
- 整个 agent 如何被评测。
一个 harness 可以大量使用 MCP,同时仍然在别处拥有这些策略。概念上:
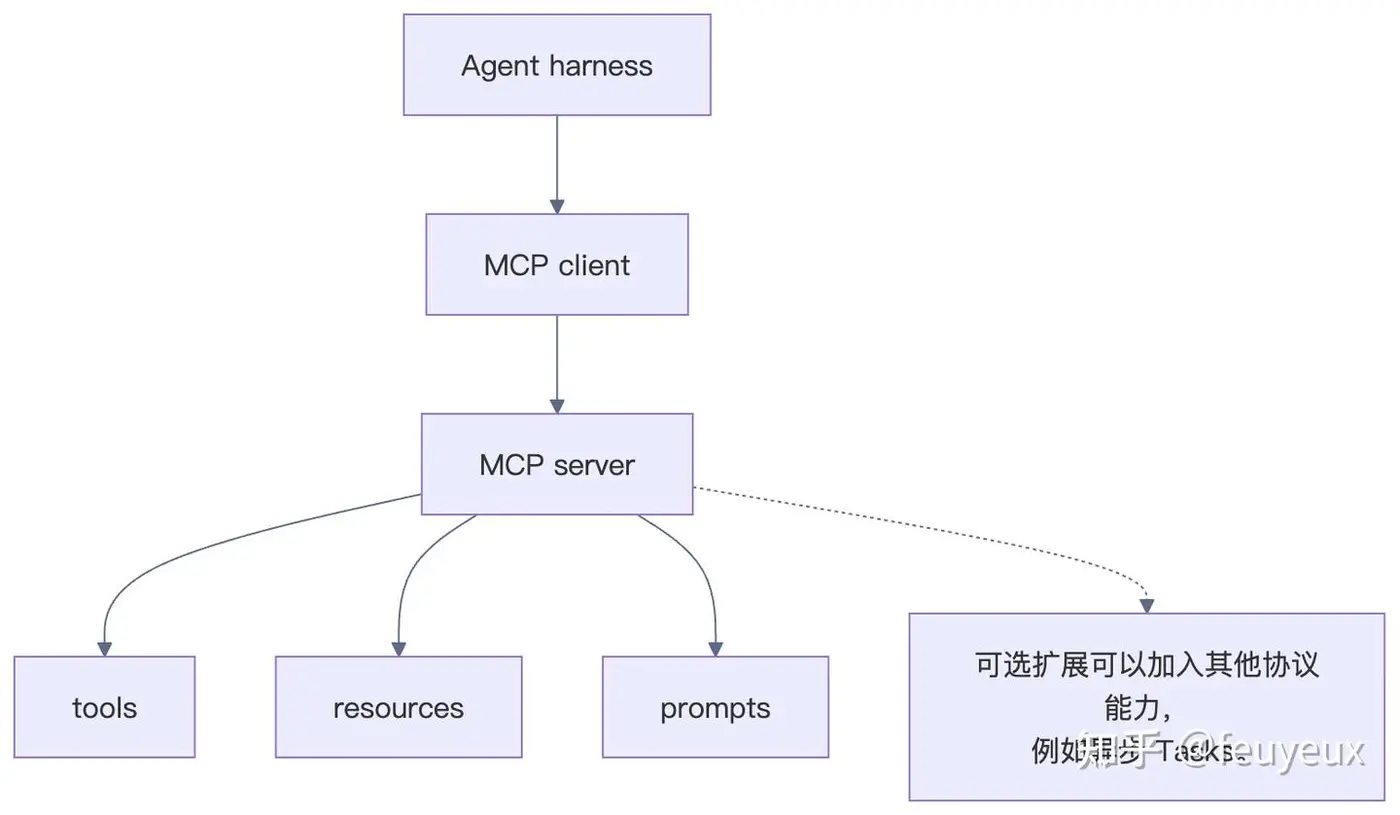
稳妥的心智模型是:这是一个可互操作的能力接口,不是一整套 agent 架构。
当前的 Tasks 草案也说明了为什么“协议状态”与“工具结果”不应被混为一谈。一个带 isError: true 的工具结果在协议层面仍然算任务完成,而 JSON-RPC 执行错误则使用任务的 failed 状态 [13]。这个区分在设计模型可见的错误处理与恢复时很有用。
12. 活跃上下文是一个 Harness 决策
每一次模型调用能看到的上下文都是有限的,而进入其中的是什么,由 harness 决定。 可能的材料包括:
- system 与 developer 指令;
- 当前的用户任务;
- 近期的消息历史;
- 工具 schema;
- 工具结果;
- 检索到的文档;
- 计划与 todo 状态;
- 早期工作的摘要;
- 文件或仓库状态;
- 记忆记录;
- 子 agent 的输出。
最朴素的做法是“把所有可能重要的东西都放进去”。它最终会因两个原因而失败。第一,上下文容量是有限的。第二,即便容量很大,相关性依然重要——无关材料会与有用的证据争夺模型注意力,并可能让决策问题变得更难。
因此,Anthropic 的上下文工程指南把上下文当作一种受约束的资源,强调即时(just-in-time)检索、token 高效的工具、压缩、结构化记忆与子 agent [6]。
13. 渐进式披露,而非巨型说明书
OpenAI 那场以 Codex 优先的工程实验遇到过一个实际的文档问题:一个庞大的仓库指令文件堆积了过多指引。它消耗上下文、难以维护,也难以机械校验。
团队转向了一份更短的入口文档,由它把 agent 引导至结构化的、仓库本地的事实来源 [10]。
一般模式就是渐进式披露(progressive disclosure):
- 提供足够的信息,帮助 agent 定位自己;
- 让更深层的信息可以被找到;
- 只在任务确实需要时才加载详细指引。
这也是工具接口会受益于搜索、过滤与精简结果模式的原因。“可用”与“相关”是两个不同的属性。 上下文窗口很大,并不会使无差别的信息倾倒成为好架构。
Agent Skills 是渐进式披露的又一种现代用法。Anthropic 与微软把 skill 描述为可复用的指令包加上可选的脚本/资源,可以在相关时被发现并加载,而不是把所有指引都塞进每一个 prompt [25,26]。与工具不同——工具的主要接口是一个可调用的动作——skill 主要打包的是可复用的指引与支撑资源,供模型在决定“怎么做”时取用。微软把这一点与显式 workflow 区分开来:后者执行路径由应用定义;其当前指南倾向于在存在检查点、可预测的顺序要求,或非幂等副作用使得重放一个灵活 skill 并不合适时,采用 workflow [26]。
一篇 2026 年的预印本分析了 SkillsBench 与 SWE-Skills-Bench 上 307 个已确认的 skill 诱发失败,其中包括 125 个功能性失败与 182 个效率退化 [24]。该研究把其中挑选出的成对失败或成本退化归因于被加载的 skill;它并未估计 skill 在任意部署中失败的普遍基准率。因此,skill 应当被评测,而不应被假定为有益。 又由于 skill 可能包含指令、资源与可执行脚本,它们的来源可信度同样是一个安全问题;第 22 节会回到这条边界。
14. 持久历史与活跃上下文是不同的状态面
一个长时运行的任务,其历史可能远远超过任何单次推理调用应当看到的量。这让持久 session 状态与活跃模型上下文之间的区分成为一件根本性的事。
Anthropic 的 Managed Agents 设计把仅追加的 session 日志存放在活跃上下文窗口之外。harness 可以从那段历史中取回若干片段,在把选定信息回传给模型之前先做变换 [12]。OpenAI 的 Agents API 同样把持久 session 与托管 harness 所执行的上下文管理行为分离开 [14]。
这两个状态面有重叠,但一般而言谁也不包含谁。持久历史可以留在下一次模型调用之外;反过来,活跃上下文也可能包含一些短暂材料——比如当前用户消息、实时的工具 schema,或从未被存进持久 session 的临时运行时元数据。
确切的存储模型因产品而异。原则更宽:
持久可得不等于自动进入每一次推理调用;而进入某一次推理调用,也不等于被持久存储。
15. 压缩是有损的
当对话增长过大时,常见策略是用一段更短的摘要替换较早的细节。这降低了活跃上下文的成本,但也可能丢失信息。
设 H 是历史,C(H) 是压缩后的表示。一般而言:
C(H) ≠ H
不能假定这个变换会保留未来每一步可能需要的全部细节。
Anthropic 明确警告说,上下文保留决策可能造成失败,因为未来的轮次可能需要此前看起来并不重要的信息。因此,他们的 Managed Agents 架构把持久 session 历史与模型所看到的压缩后上下文分开保存 [6,12]。
压缩应当被理解为上下文的变换,而不是等同于删除持久历史。真正的工程问题是:
哪些信息可以被摘要,哪些应当仍然可以直接取回,以及 agent 之后如何把被省略的细节检索回来?
16. 案例研究:Harness 的改动可以改变 Agent 质量
一个有用的真实案例来自 Anthropic 2026 年 4 月关于 Claude Code 的复盘 [19]。Anthropic 报告称,其 API 与推理层并未受影响,但有三处产品层的改动改变了用户在 Claude Code 及相关产品中体验到的质量:
- 某些模型的默认 reasoning-effort 设置被下调,后来在用户反馈后被回滚;
- 一项本意是在空闲一段时间后清理较早推理的会话优化存在缺陷,会在后续轮次中重复执行清理行为,让 Claude 显得记性变差、反复啰嗦;
- 一条本意是减少啰嗦的 system-prompt 指令,在某项更宽的评测上让 Opus 4.6 与 Opus 4.7 都下降了 3%,随后被回滚 [19]。
重点不是这三种机制普遍重要。重点在于架构层面的结论:
即使底层 API 与推理层没有变化,当产品/harness 配置发生变化时,用户所观察到的 agent 质量也会随之改变。
因此,prompt 构造、推理设置、上下文保留、工具接口以及其他运行时决策,都是已部署的 agent 系统行为的一部分。
17. 结构化的工作状态
自然语言历史并不是保存进度的唯一方式。长任务常常受益于显式的产物,例如:
- todo 列表;
- issue 追踪;
- 功能状态文件;
- 进度笔记;
- 测试结果;
- git 提交;
- 检查清单;
- 生成的计划;
- 输出清单(output manifests)。
Anthropic 的长时运行 agent 实验使用一个初始化 session 来准备结构化产物,后续的编码 session 则在此之上取得增量进展,同时为下一个 session 留下清晰状态 [7]。他们的示例使用了功能列表、git 历史、进度笔记与一个初始化脚本。
这些产物不是模型隐藏的记忆。它们是任务状态的外部表示。 正因如此,它们是可检视的、可编辑的、可版本化的,并且可被未来的 session 或人类恢复。
18. 执行环境
有些 agent 只读数据。另一些会运行代码、修改文件、浏览 web 应用、编译软件、调用内部系统,或创建持久产物。
一旦 agent 能够造成副作用,执行环境就成为架构的一部分。
一个沙箱可能提供:
- 文件系统访问;
- shell 执行;
- 已安装的包;
- 挂载的数据;
- 网络访问;
- 浏览器或计算机控制;
- 端口;
- 快照;
- 资源限制。
OpenAI 的沙箱文档明确地把这个执行平面与 harness 控制平面分开 [14]。
环境同时决定了能力与失效模式。一个正确的计划可能因为少装了一个包而失败;一个约束不当的环境则可能在成功的同时制造出不可接受的安全风险。因此,harness 工程不可能止步于 prompt 设计。
19. 沙箱是隔离边界,不是编排器
沙箱要回答的是这样一些问题:
- 这个进程能触及哪些文件?
- 它能运行哪些命令?
- 允许对外联网吗?
- 有哪些凭据或挂载是可见的?
- 什么状态能在容器之外存活?
harness 回答的是另一组问题:
- 模型下一步该看到什么?
- 哪个工具调用该被执行?
- 这次调用是否需要审批?
- 该返回什么结果?
- 循环是否该继续?
- 失败之后会发生什么?
两者在原型中可以共址,但仍应被分开推理。把控制平面置于不可信执行之外,可以保护 session 状态、审计日志、凭据与策略,使其不受沙箱内运行的模型生成代码影响 [12,14]。
20. 审批与遏制解决的是不同问题
当某个动作的后果应当由人类明确掌控时,审批是有价值的。例子包括:删除生产数据、对外发送通信、转账、提权,或发布变更。
但审批并不是一套完整的安全架构。
Anthropic 报告,在其遏制文章所讨论的遥测数据中,用户批准了大约 93% 的 Claude Code 权限提示 [3]。这是 Anthropic 自身产品的遥测数据,并非一个普遍适用的批准率。他们的论点是:频繁的提示会造成审批疲劳。
同一篇文章给出了一个更极端的内部红队例子。在 2026 年 2 月一次受控演练中,一个经由用户传入的恶意 prompt,在 25 次重试中有 24 次成功外泄了凭据 [3]。Anthropic 对该场景的结论是:当模型层的意图检查无法把恶意指令与普通用户请求区分开来时,环境层的文件系统与网络出口边界才是那道真正守住的防线。这是厂商自报的红队结果,并非一个通用的失效率。
遏制回答的是另一个问题:
即便所有更高层的行为防护全部失效,agent 仍然能够触及什么?
例子包括文件系统边界、网络出口规则、虚拟机、容器与凭据隔离。
人类评审控制的是决策。遏制控制的是可达能力。
21. 让凭据留在不可信执行之外
设想模型生成的代码运行在一个沙箱里,而同一个沙箱里还放着一批长期驻留的凭据。那么一次 prompt 注入、一个恶意依赖,或一条错误命令,就可能读到这些密钥。
Anthropic 在 Managed Agents 中描述了一种结构性的替代方案:凭据可以存放在执行沙箱之外,通过受控代理或针对特定资源的机制来使用,而不是直接暴露给生成的代码 [12]。
他们的遏制工作把这条通用安全原则讲得很清楚 [3]:
一个从不进入沙箱的资源,就无法从该沙箱中被直接读取。
这道边界比“告诉模型不要碰密钥”硬得多:前者是一条指令,后者改变的是可达状态空间。
22. 观察是有来源的
agent 的输入并非只来自用户。一个 harness 可能会把以下东西放进上下文:
- 网页;
- 邮件;
- issue 描述;
- 文档;
- 文件;
- 数据库记录;
- MCP 资源;
- 被加载的 skill 指令与资源;
- 工具结果;
- 子 agent 报告;
- 存储的记忆。
这些观察可能包含敌意或误导性的指令。 一个有用的概念表示是:
o_i = (content, source, trust, time, permissions)
这是我们的心智模型,不是某种标准传输格式。重点在于:仅仅因为一串字符串变成了 token,它们就并不彼此平等。 一条 system 指令与一段从任意网站抓取的文本,都可能进入模型上下文,但它们的来源与权威性天差地别。
Anthropic 的遏制工作明确把工具、文件与网络访问列为外部攻击向量,并讨论了持久状态这个新的、可以把已被污染的信息一路带下去的攻击面 [3]。它还报告了一个具体失效案例:一个已获批准的网络域名通过一个合法 API 实现了数据外泄,以至于 Anthropic 后来把网络出口白名单看得更像一项能力授予,而不仅仅是一个目的地过滤器。同一篇文章还警告说:如果父 agent 把子 agent 的输出当作天然比原始工具输出更安全,就会产生信任升级。
独立研究从另一个角度印证了同一条更宽的安全边界。AgentDojo 评测 agent 在处理不可信工具数据时遭遇的 prompt 注入;其 NeurIPS 2024 初版包含 97 个真实任务与 629 个安全测试用例,覆盖邮件、银行、旅行、消息等环境 [21]。这个基准之所以存在,正是因为工具返回的数据可能包含会影响后续 agent 动作的对抗性指令。
skill 构成了一条相关的信任边界。Anthropic 警告说,skill 可能包含指令与代码,只应从可信来源使用或经过仔细审计;一个恶意 skill 可能以与其声明目的不符的方式引导工具使用或代码执行 [25]。微软同样建议把 skill 当作第三方代码对待 [26]。而在微软的 Agent Skills provider 实现中,load_skill、read_skill_resource 与 run_skill_script 默认需要审批——除非应用有意为可信来源放宽这项策略。
23. 停止条件是 Harness 的一部分
一个自主循环需要一条“何时停止”的规则。可能的停止条件包括:
- 模型返回最终输出;
- 某个可验证的任务判定条件得到满足;
- 需要人类输入;
- 某个护栏阻断了进一步动作;
- 某个工具进入不可恢复的失败状态;
- 某个资源预算耗尽;
- 收到取消请求。
一个生产级 harness 应当区分“完成”与“终止”。例如:
task complete ≠ turn budget exhausted
OpenAI 当前的 Agents SDK 支持显式的最大轮次限制。达到该上限会停止循环,但并不能证明任务成功 [14]。微软的 Harness 同样提供了有界循环行为与可配置的迭代上限 [15]。
因此,一次停止可能意味着成功、策略阻断、超时、预算耗尽、失败或人工接管。这些状态不应被折叠成一个泛泛的“完成”。
24. 预算限制自主性
一个 harness 可能强制若干项彼此独立的预算:
B = (B_turns, B_tokens, B_time, B_cost, B_tools, B_concurrency)
这个向量是我们的概念记号。并非每个平台都直接暴露每一项预算。设计要点在于:自主性不仅受权限限制,也受资源限制。
- 一次运行可以被允许访问数据库,但同时被限制在 20 次工具调用之内。
- 子 agent 系统可以获准启用,但并发 worker 数量受限。
- 一个浏览器 agent 可以被允许运行十分钟,但不允许无限期运行。
预算把“继续尝试”从一种无界行为,变成了一项可操作的策略 [14,15]。它们也让失败更容易分类。一个超时的任务,与一个达到了可验证成功条件的任务,是两回事。
25. 验证不同于自我报告的完成
一个 agent 可能会说:
这个 bug 修好了。
那是一个主张,不是证据。
对软件工作而言,更强的证据可能包括:
- 原来的复现步骤不再失败;
- 回归测试通过;
- 应用被端到端地跑过一遍;
- 受影响的状态确实按预期发生了变化。
Anthropic 的长时运行 agent 工作发现,编码 agent 可能在没有充分端到端测试的情况下就把功能标记为完成。他们的 harness 通过要求用浏览器自动化与结构化的功能状态做显式验证,改善了这一行为 [7]。
独立的评测工作把同一区分变得更具体。在 τ-bench 中,成功是通过把最终的数据库状态与一份标注过的目标状态做比较来评估的,而不是相信 agent 的对话性声明。该基准还引入了 pass^k,用于衡量一个 agent 在多次试验中是否稳定成功 [22]。τ-bench 中的对话用户本身也是由一个语言模型模拟的,因此即便最终环境状态是与标注目标比较的,交互轨迹仍不是确定性的。
一般原则是:
只要可行,完成就应当绑定到模型自身断言之外的可观察状态。
对于确定性属性,确定性验证更可取。对于主观属性,一个独立的评估者或人类可能仍然有用。
26. 确定性强制 vs. 模型判断
有些决策确实需要理解与判断:
- 这个搜索结果相关吗?
- 接下来该检查哪个文件?
- 这段解释是否满足了用户的意图?
另一些约束则通常可以被机械检查:
- 这个 JSON 合法吗?
- 这笔金额超出了允许阈值吗?
- 这个路径在挂载目录之外吗?
- 这条依赖边是被禁止的吗?
- 这次运行是否已超出工具调用预算?
一条有用的设计规则是:
性质能机械判定的,用确定性强制;确实需要理解与判断的,用模型或人类判断。
这是一条指导方针,不是一条定理。
OpenAI 当前的 Agents SDK 提供了 input、output 与 tool guardrails,可以校验或阻断执行 [14]。Anthropic 的遏制工作主张在系统能够强制施加硬性可达性限制时使用环境边界 [3]。OpenAI 的 Codex 优先仓库同样把一些架构规则从散文描述搬进了 linter 与结构化测试 [10]。
模型不该被要求去记住一条系统本来就能低成本执行的规则。
27. 生成者与评估者是不同的角色
有些输出无法被确定性测试完全检查。例子包括:文笔质量、设计质量、研究的完备性、含糊的规划,以及某些形式的策略解释。
Anthropic 在长时运行的应用工作中实验性地把生成与评估分离,用不同角色来生成工作、批评它、再迭代 [11]。
这里有用的概念并不是“每个任务都需要多个 agent”,而是:
产出一个答案与判断一个答案,是两种不同的操作。
评估者也会出错。因此,基于模型的 grader 应当被当作另一个可能出错的组件,它自身的可靠性也需要被评估。只要存在确定性检查,确定性检查就仍然更强。
28. 反馈回路给 Agent 外部证据
一次性(one-shot)的模型调用只能给出一个输出。而 agent 往往能做更有用的事:
- 行动;
- 观察后果;
- 修订。
对编码与运维工作而言,有用的反馈可以包括:
- 编译器输出;
- 单元测试;
- 集成测试;
- 截图;
- 浏览器状态;
- 日志;
- 指标;
- trace;
- 数据库内容;
- API 响应。
OpenAI 的 harness 工程报告描述了如何把应用状态、日志、指标与 trace 暴露给 Codex,使 agent 能够检视并验证自己的改动 [10]。
一个能改变状态、却无法把结果状态暴露出来的工具,只能形成一条很弱的反馈回路。
因此,harness 设计在某种程度上,就是让相关的真实状态可被查询。
29. 长时运行的 Agent 继承持久性问题
一次五秒的工具调用通常可以失败并重试,而不需要多少协调。一个持续数小时或数天的任务则完全不同。在长时运行的工作期间:
- harness 可能崩溃;
- 一个 worker 可能消失;
- 一个沙箱可能被回收;
- 网络可能断开;
- 用户可能暂停任务;
- 审批可能在数小时之后才到达。
Google 的 Agent Executor 正是围绕这个运维问题设计的,它为 agent、harness、工具与沙箱提供事件日志、快照、恢复与分布式执行 [16]。截至本手册成文时,Google 的 google/ax 仓库警告说,其核心概念、协议与规范仍在细化之中,在稳定发布前可能发生实质变化。
Anthropic 的 Managed Agents 架构在 harness 之外使用一个持久 session,使得崩溃的 harness 可以被重启并从 session 日志中恢复 [12]。
随着 agent 工作变得更长、更分散,harness 继承了那些熟悉的系统问题:持久性、恢复、一致性、重试与故障隔离。
30. 恢复需要控制状态与世界状态
设想一个 harness 发出请求:
create_ticket(...)
远端系统创建了工单。随后网络在 harness 收到响应之前断开。重启之后,harness 知道自己曾经打算调用这个工具,却可能不知道那个外部副作用是否已经提交。
盲目地再跑一次同样的动作,就可能多出一张重复的工单。这引出一条重要区分:

这些状态转移并不保证原子性。 一份持久的事件日志能帮助 harness 记住自己请求过什么、观察到了什么 [16]。但它不会自动让每一个外部副作用都变得可安全重复 [18]。
31. 幂等性对重试很重要
一个操作在通常的系统意义上是幂等的,当且仅当重复执行同一个意图操作,其意图效果与只执行一次相同 [18]。抽象地:
f(f(s)) = f(s)
例如这样一个操作:
set_ticket_status(id, "closed")
往往可以被设计成幂等的。而这样的操作:
charge_card(...)
send_email(...)
create_order(...)
天然不适合重复执行。
因此,可靠的 agent 系统可能需要这样的机制:
- 幂等键(idempotency keys);
- 唯一操作 ID;
- 去重记录;
- 事务性写入;
- 重试前先读(read-before-retry)检查;
- 针对具体工具的重试策略。
RFC 9110 对幂等 HTTP 请求语义使用的是同一个底层概念,并解释了为什么当客户端丢失了某个请求的响应时,幂等性很重要。
更普适的一层教训很直白:
自动重试是一项针对具体工具的策略,不是一种通用的恢复手段。
32. 并发带来一致性问题
子 agent 与分布式 worker 可能并发地操作共享状态。这引出了那些熟悉的问题:
- 更新以什么顺序提交?
- 两个 worker 会不会互相覆盖?
- 会不会两者都认领了同一个任务?
- 哪条事件流是权威的?
- 冲突的副作用如何被检测?
Google 的 Agent Executor 明确强调会话一致性,并通过架构约束减少分布式 agent 工作流中的数据损坏 [16]。
确切的解法取决于应用。有些系统把写操作串行化;另一些则按任务或资源对状态做分区。关键在于:多 agent 并发不只是一个提示词问题,它同时也是一个状态一致性问题。
33. 子 Agent 是一个 Harness 选择
一个 harness 可以把整个任务交给一个模型实例,也可以把独立的子任务委派给额外的 agent。
当工作能被干净地分解时,委派可以提升吞吐量。它也可能带来:
- 重复劳动;
- 不一致的假设;
- 通信开销;
- 更高的 token 成本;
- 错误传播;
- 对共享状态的争用。
Google Research 评测了 180 种 agent 配置,发现架构带来的影响强烈依赖于任务结构。在他们报告的设置中,集中式协调让 Finance-Agent 相对单 agent 基线提升了 80.9%,而每一个被测的多 agent 变体在顺序性的 PlanCraft 任务上性能都下降了 39%–70% [17]。
这些是该实验设置下的结果,不是普适的扩展律。能长期成立的规则是:
委派应当由任务分解来论证,而不是由“更多 agent 天生更好”这一信念来论证。
34. Agent 可读性
OpenAI 使用 agent legibility(agent 可读性) 这个词,指代 agent 优先工程环境的一项重要属性 [10]。基本思路是:agent 需要的信息,应当能从它自己就能检视的系统中找到。
- 对一个代码仓库,这可能包括结构化文档、可预测的包边界、清晰的所有权、测试入口点、可检索的日志、本地指标,以及可运行的应用状态。
- 对一个数据系统,这可能意味着易于发现的 schema 与元数据。
- 对 UI 工作,这可能意味着截图、DOM 状态,以及确定性的应用启动方式。
这比“文档质量”要多。 一个系统之所以容易被它最初的人类作者理解,可能只是因为他们带着 agent 并不具备的口口相传的隐性知识(tribal knowledge)。harness 工程的作用,是把重要的假设沉淀到可检视的产物里。
35. 对可强制执行的规则,机制强于散文
假设有一条架构规则:
领域 A 不得从领域 B 导入其内部实现代码。
一种选择是把这条规则写进指令文件。另一种选择是实现一个能拒绝该非法依赖的结构化测试。
第二种做法改变了失效模式。 agent 不再需要完美地记住规则;非法状态会在验证环节失败。
OpenAI 报告在其 Codex 优先仓库中使用自定义 linter 与结构化测试来强制执行架构规则 [10]。
指令依然有用,因为不是每个属性都能形式化。但当一条规则客观且可机械检查时,把它写成代码就能减少对模型服从性的依赖。
36. 可观测性有两个受众
传统可观测性帮助工程师理解运行中的软件。Agent 系统增加了第二个受众:agent 本身。
对人类运维人员有用的信号包括:模型轮次、工具调用、工具失败、延迟、token 用量、成本、重试、审批事件与最终结果。对 agent 有用的信号则包括:应用日志、trace、截图、浏览器状态、测试结果与资源状态。
第一类帮助人们调试 harness。第二类给模型提供关于它正在操作的那个系统的证据。OpenAI 的 Codex 优先工程工作正是通过把日志、指标与 trace 直接暴露给编码 agent 来演示这一点的 [10]。
37. Agent Harness vs. Evaluation Harness
Agent harness 让模型能够运转。Evaluation harness 度量它运转得怎么样。
Anthropic 把 evaluation harness 描述为这样一套基础设施:端到端运行任务、提供稳定的环境、记录试验、执行 grader 并汇总结果 [8]。
独立基准进一步说明了环境为何重要。τ-bench 针对最终数据库状态与多次试验的可靠性来评测使用工具的 agent [22]。ToolSandbox 评测有状态的工具使用,其中包含工具之间的隐式依赖、on-policy 对话,以及跨任意轨迹的中间/最终里程碑 [23]。两者合起来,让一个 agent 更难仅仅靠产出一份看似合理的对话记录就拿到分数。
这个区分之所以重要,是因为一次 agent 评测度量的东西通常不止模型。一个有用的概念分解是:
measured agent performance = F(model, harness, environment, task, grader)
这不是一个统计模型;它是在提醒你注意依赖关系:改变 harness 可以在不改变模型权重的情况下改变结果。改变环境同样可以。
38. 环境可以改变 Benchmark 分数
静态问答类基准大多只给模型输出打分。而 agentic 编码类基准可能涉及包安装、编译、测试执行、创建子进程、磁盘使用、CPU 与内存压力,以及重复的工具交互。这让基础设施成为任务的一部分。
Anthropic 在 Terminal-Bench 2.0 上实验性地改变了计算资源,并报告在其资源最紧张与最充裕的两种配置之间存在 6 个百分点的差异(p < 0.01)。更值得留意的是结果的形态:从 1x 到大约 3x 的资源余量区间内,基础设施失败显著下降,而成功分数仍落在统计噪声范围内(p = 0.40)。超过大约 3x 之后,额外资源开始让一些能实质改变任务成败的策略成为可能。因此,Anthropic 建议:当资源方法论没有被记录并对齐时,对小于 3 个百分点的排行榜差距应保持怀疑 [9]。
正确的结论不是“更多内存让模型更聪明”,而是:
一个 agentic 基准可能同时度量了模型行为与运行时资源之间的交互。
因此,有意义的比较需要足够详细的 harness 与环境信息,才能复现那些运行条件。
39. Harness 的假设会过期
一个 harness 常常包含针对已知模型行为的变通方案。这些变通不应被假定为永久有效。
Anthropic 报告说,因为 Claude Sonnet 4.5 会在接近上下文上限时过早收尾而加入的上下文重置机制,在同一 harness 换用 Claude Opus 4.5 之后变得不再需要。行为变了,于是那个重置就成了死重。在同一组实验中,Anthropic 报告了一个具体的 RetroForge 对比:一次单 agent 的 Opus 4.5 运行持续 20 分钟、花费 9 美元,而更完整的 harness 跑了六小时、花费 200 美元。作者报告说在那次实验中,更完整的 harness 产出了实质更好的输出质量,但成本高出了 20 多倍。后来用 Opus 4.6 做的实验又移除了额外的脚手架,包括冲刺分解。planner 仍然有用,而 evaluator 则变得更加依赖任务:它在任务处于模型能力边缘时增值最多。这些是针对具体任务的实验结论,不是普适的成本比例 [11]。
OpenAI 当前的 Agents API 同样把 Codex harness 当作一个会随模型能力演进而演进的、版本化的系统 [20]。
这提示了一条更强的设计原则:
harness 的每一个组件,都是关于“当前某个局限”的假设,它都应当为所服务的模型与任务分布,同时证明:它带来的质量提升值得它付出的执行成本。
当模型变化时,重新检验那个假设。否则,harness 会不断堆积已经过时的层,它们带来延迟、token 成本、复杂度,以及新的失效模式。
40. 常见失效模式
一个生产级 harness 应当让失效可观察、可归类。
| 失效模式 | 说明 |
|---|---|
| 工具选择失败 | 能力存在,但模型选错了工具。 |
| 工具契约失败 | 选对了工具,但参数无效。 |
| 观察失败 | 动作成功了,但返回的信息充满噪声、含糊或不完整。 |
| 上下文失败 | 重要信息在压缩过程中被遗漏、过时、被埋没或被销毁。 |
| 状态失败 | 系统丢失了关于进展、审批、计划或先前动作的记录。 |
| 环境失败 | 包、文件、浏览器状态、计算资源或权限与假设不符。 |
| 验证失败 | 模型在没有测试外部结果的情况下宣布成功。 |
| 授权失败 | agent 要么被挡住了本应被允许的工作,要么被授予了超出需要的权限。 |
| 恢复失败 | 一次重试复制了某个副作用,或一次重启无法让控制状态与世界状态对账。 |
| 协调失败 | 子 agent 重复劳动、假设分歧,或花在协调上的资源多于用在解决问题上的。 |
| 预算失败 | 这次运行在达到成功终态之前,就耗尽了允许的轮次、时间、token、成本或并发度。 |
| 来源 / prompt 注入失败 | 不可信的工具数据、检索内容、存储状态、skill 或子 agent 输出被当作权威指令,从而把 agent 带偏 [3,21]。 |
| Skill 诱发失败 | 被加载的 skill 主题上相关,却导致必需的工作被错误实现或被省略;或者引入了过多不必要的流程,造成实质性的效率退化 [24]。 |
harness 工程在很大程度上,就是把这些宽泛的失效类别变成可观察、可测试的系统属性。
41. 常见误解
- “harness 就是 system prompt。” 不是。指令只是 harness 的一部分。harness 还可以拥有状态、工具分发、审批、压缩、恢复、预算与验证。
- “harness 就是沙箱。” 不是。harness 控制工作;沙箱只是工作执行的一个地方 [14]。
- “MCP 就是 agent。” 不是。MCP 标准化的是可互操作的能力面与扩展。agent 循环及其策略仍然需要编排 [13]。
- “上下文窗口等于记忆。” 不是。持久状态可以存在于当前模型上下文之外。
- “压缩保留了完整对话。” 不是。除非被省略的信息在别处仍可取回,否则摘要是一种有损表示。
- “更多工具总能提升能力。” 不是。重叠的工具与噪声很大的结果会让选择与后续推理变得更难。
- “有了人工审批提示,任意执行就安全了。” 不是。审批与环境遏制解决的是不同问题。
- “工具失败了,那就重试。” 不能自动这么做。有副作用的操作可能需要幂等或去重语义。
- “agent 说它完成了,所以任务完成了。” 自我报告弱于可观察的验证。
- “更多 agent 更好。” 一般不是。在严格串行的工作上,协调成本会占上风 [17]。
- “模型更强了,旧的 harness 改进就都有用了。” 不是。随着模型行为变化,脚手架可能变得不再必要 [11]。
- “skill 只是无害的 prompt 模板。” 不是。skill 可以包含指令、资源与可执行脚本。第三方 skill 应当被视为带来源标记的代码/配置,并按它们所暴露的能力加以评审、限定在沙箱中执行,并纳入审批管控 [25,26]。
42. 一套生产级心智模型
评估一个 agent 系统时,问这些问题:
- 模型实际收到的是什么? 指令、历史、工具 schema、检索到的状态、摘要、产物。
- 谁在控制循环? 应用代码、托管 harness、workflow 引擎,还是另一个 agent。
- 有哪些动作可用? 函数工具、MCP 工具、shell、浏览器、文件、API、子 agent。
- 动作在哪里执行? 可信进程、本机、容器、虚拟机、远程服务。
- 什么能挺过下一轮或进程崩溃? Session 事件、文件、快照、外部副作用。
- 哪些规则是被机械强制的? Schema、挂载、网络边界、审批、测试、预算。
- 错误是如何表示的? 致命异常、重试、模型可见的观察、人工介入。
- 哪些动作可以安全重试? 幂等操作、可去重操作,还是两者都不是。
- agent 如何获得真实状态? 测试、日志、浏览器状态、数据库状态、外部响应。
- 什么能证明完成? 模型声明、确定性校验器、外部状态、评估者,还是人类。
- 如果一直不成功,这次运行靠什么停下来? 轮次、时间、token、工具、成本或策略预算。
- 中断之后会发生什么? 恢复、重试、重新拉起环境、回滚,还是重启。
- 不可信的观察能携带指令吗? Web 数据、工具输出、文件、记忆、被加载的 skill、子 agent 报告。
- 子 agent 如何被协调? 任务边界、共享状态、合并策略、并发上限。
- 这个 harness 如何被评测? 消融实验、有代表性的任务、稳定的环境、结果指标。
一个回答不了这些问题的系统,在 demo 里或许照样能跑;但要在生产环境里推理它,就困难得多了。
43. 完整的心智模型
一幅紧凑的生产全景图是:
- 模型提供习得的能力。
- harness 决定这份能力如何与工作相连。
- 持久 session/状态层决定什么能跨轮次或跨重启存活。
- 上下文策略决定模型此刻能看到什么。
- 执行环境决定哪些事情真的有可能发生。
- 权限与遏制决定一次失败能波及多大的范围。
- 反馈告诉系统一个动作是否奏效。
- 验证决定“完成”是否有证据支撑。
- 恢复决定中断之后工作能否继续。
- 评测决定 harness 究竟是在真正帮上忙,还是只是在徒增机制与开销。
这就是 harness 工程的核心。
参考文献
正文中的编号引用指向下列来源。产品与规范行为的核对时间为 2026 年 10 月。
- S. Yao 等. ReAct: Synergizing Reasoning and Acting in Language Models. ICLR 2023. https://arxiv.org/abs/2210.03629
- J. Yang 等. SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering. NeurIPS 2024. https://arxiv.org/abs/2405.15793
- Anthropic. How we contain Claude across products. 2026. https://www.anthropic.com/engineering/how-we-contain-claude
- Anthropic. Building effective agents. https://www.anthropic.com/engineering/building-effective-agents
- Anthropic. Writing effective tools for agents — with agents. 2025. https://www.anthropic.com/engineering/writing-tools-for-agents
- Anthropic. Effective context engineering for AI agents. https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents
- Anthropic. Effective harnesses for long-running agents. 2025. https://www.anthropic.com/engineering/effective-harnesses-for-long-running-agents
- Anthropic. Demystifying evals for AI agents. 2026. https://www.anthropic.com/engineering/demystifying-evals-for-ai-agents
- Anthropic. Quantifying infrastructure noise in agentic coding evals. 2026. https://www.anthropic.com/engineering/infrastructure-noise
- OpenAI. Harness engineering: leveraging Codex in an agent-first world. 2026. https://openai.com/index/harness-engineering/
- Anthropic. Harness design for long-running application development. 2026. https://www.anthropic.com/engineering/harness-design-long-running-apps
- Anthropic. Scaling Managed Agents: Decoupling the brain from the hands. 2026. https://www.anthropic.com/engineering/managed-agents
- Model Context Protocol. Core server specification, Extensions overview, and Tasks extension. 当前文档核对于 2026 年 10 月。
- OpenAI. Agents API, Agents SDK, and Sandbox Agents documentation. 当前文档核对于 2026 年 10 月。
- Microsoft. Agent Framework: Agent Harness. 当前文档核对于 2026 年 10 月。https://learn.microsoft.com/agent-framework/agents/harness
- Google Cloud. Introducing Agent Executor, Google’s distributed Agent Runtime. 2026. https://cloud.google.com/blog/products/ai-machine-learning/agent-executor-googles-distributed-agentruntime/
- Google Research. Towards a science of scaling agent systems: When and why agent systems work. 2026. https://research.google/blog/towards-a-science-of-scaling-agent-systems-when-and-why-agent-systemswork/
- IETF. RFC 9110: HTTP Semantics, Section 9.2.2 Idempotent Methods. 2022. https://www.rfc-editor.org/rfc/rfc9110.html
- Anthropic. An update on recent Claude Code quality reports. 2026. https://www.anthropic.com/engineering/april-23-postmortem
- OpenAI. Introducing the Agents API. 2026. https://openai.com/index/introducing-the-agents-api/
- E. Debenedetti 等. AgentDojo: A Dynamic Environment to Evaluate Prompt Injection Attacks and Defenses for LLM Agents. NeurIPS 2024,Datasets and Benchmarks Track。https://doi.org/10.52202⁄079017-2636
- S. Yao, N. Shinn, P. Razavi, K. Narasimhan. τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains. ICLR 2025. https://arxiv.org/abs/2406.12045
- J. Lu 等. ToolSandbox: A Stateful, Conversational, Interactive Evaluation Benchmark for LLM Tool Use Capabilities. Findings of NAACL 2025. https://aclanthology.org/2025.findings-naacl.65/
- G. Dong 等. Agent Skills Can Be Harmful: An Empirical Study of Skill-Induced Failures in LLM Agents. arXiv:2608.11888, 2026. https://arxiv.org/abs/2608.11888
- Anthropic. Agent Skills. Claude Platform 当前文档,核对于 2026 年 10 月。https://platform.claude.com/docs/en/agents-and-tools/agent-skills/overview
- Microsoft. Agent Skills. Agent Framework 当前文档,核对于 2026 年 10 月。https://learn.microsoft.com/agent-framework/agents/skills
