2.0 的迁移文档里有一节 "Removed features",是一次集中清理:rivers 直接删除、facets 删除(1.0 起已废弃)、MVEL 脚本语言删除(默认改为 Groovy)、delete-by-query 和 multicast 发现降级为插件、
_shutdownAPI 无替代删除、murmur3和_size变成插件。清单里每一项都是 0.90–1.x 年代的常用工具,这一批改动决定了 1.x 能不能升到 2.x。
说明
实测环境:本地另起一个 Elasticsearch 7.17.29 单节点实例(官方 tar 包,端口 9200,独立 path.data);本机没有 0.90 / 1.x / 2.x 二进制,所以这里验的是这些旧写法在较新版本上的当前行为,不是当年的执行过程。文末「在 7.17.29 上跑一遍」里的命令与响应均取自该实例。
这份名单在当年有多重
今天的人看这份名单,大概只觉得是一堆陌生的名词。但在 2014 年前后,它们各有各的常用场景:
- rivers 是"从外部数据源往 ES 灌数据"的官方方案(MySQL、CouchDB、RSS、Twitter 等);
- facets 是聚合的前身,1.0 之前唯一的统计手段(见 facets 与聚合的由来);
- MVEL 是 ES 最早的默认脚本表达式语言,写
_score * doc['x'].value那批脚本用的就是它; - multicast 让节点"零配置互相发现",本地起几个节点就自动成集群;
- delete-by-query 还是核心 API,删数据直接就用了;
_shutdown是关节点的 API——当时,靠 HTTP 关掉一个节点是正常操作。
Rivers
Rivers 在 2.0 被整体移除。官方文档给的理由是(migrate_2_0/removals.asciidoc @ v2.4.6):
Elasticsearch does not support rivers anymore. While we had first planned to keep them around to ease migration, keeping support for rivers proved to be challenging as it conflicted with other important changes that we wanted to bring to 2.0 like synchronous dynamic mappings updates, so we eventually decided to remove them entirely.
本来计划留着 rivers 方便迁移,但保留它与 2.0 想要的"同步动态映射更新"等改动冲突,最终整体删除。这条对 1.x 用户是硬阻断:用 river 从 MySQL、CouchDB、RSS 之类外部源拉数据的集群,必须先改成自己写同步程序(后来的 Logstash JDBC input、自研写入端都在这个位置上)。
Facets
Facets 从 1.0 开始废弃,2.0 正式删除,替代者是 aggregations:
Facets, deprecated since 1.0, have now been removed. Instead, use the much more powerful and flexible aggregations framework. This also means that Kibana 3 will not work with Elasticsearch 2.0.
后半句是个附带伤害:Kibana 3 依赖 facets,所以它无法配合 2.0 使用。升级 2.x 时 Kibana 必须一起升到 4。
facet 到 aggregation 的改写大致是:terms facet → terms 聚合;range facet → range 聚合;date_histogram facet → date_histogram 聚合;statistical facet → stats/extended_stats 聚合;filter facet → filter 聚合;geodistance facet → geo_distance 聚合。aggregation 支持嵌套,原来靠多个 facet 拼接的分析可以压成一次请求。
MVEL
MVEL 脚本语言被删除,默认脚本语言改为 Groovy。1.x 里写过 script: "doc['field'].value * factor" 这种 MVEL 脚本的,需要按 Groovy 语法过一遍;简单表达式可能不用改,类型转换、空值处理这类地方行为可能不同,要逐条验证。脚本相关的迁移细节在 2.0 迁移文档的 Scripting 一节里单独展开。
Delete-by-query 变成插件
老的 delete-by-query 快但不安全:
The old delete-by-query functionality was fast but unsafe. It could lead to document differences between the primary and replica shards, and could even produce out of memory exceptions and cause the cluster to crash.
问题在于它可能造成主分片与副本分片数据不一致,还可能 OOM 把集群搞崩。2.0 改成基于 scroll + bulk 实现(由插件提供),对命中大量文档的查询会慢一些,但安全:
./bin/plugin install delete-by-query
文档同时提醒:当时长跑的 delete-by-query 任务无法取消,这也是它只作为插件提供的原因之一。
Multicast 发现变成插件
多播发现的问题在文档里写得很具体:Linux 不允许在 localhost 上监听多播,OS X 则不管绑定地址是什么都会往所有网卡发多播包,另外有些网络默认禁掉多播:
Support for multicast is very patchy. Linux doesn't allow multicast listening on localhost, while OS/X sends multicast broadcasts across all interfaces regardless of the configured bind address. On top of that, some networks have multicast disabled by default.
于是默认发现机制改为 unicast(默认探测本机前 5 个端口),需要多播就装插件:
./bin/plugin install discovery-multicast
这条在当时是运维向的破坏性变更:不少测试集群靠零配置多播组网,升级后必须显式配置 discovery.zen.ping.unicast.hosts。
_shutdown API
_shutdown API 直接删除,没有替代方案,节点应该由操作系统和启停脚本管理。也就是说,任何用 HTTP 远程关停节点的自动化脚本在 2.0 之后都要换成 SSH/systemd 之类的外部手段。
murmur3 与 _size
murmur3 字段(把字段值的哈希写进索引)和 _size 元数据字段(记录原始 _source 的字节数)都移出核心,改为插件:
./bin/plugin install mapper-murmur3
_size 对应 mapper-size 插件。使用它们的索引必须先装插件,否则升级后映射解析会失败。
升级前的自查顺序
- 先查有没有 river(包括插件列表和
_river索引),有就先改造数据同步链路; - 查查询里有没有 facets,尤其是 Kibana 版本——Kibana 3 必须同步升级;
- 查脚本语言设置和脚本内容,MVEL 改成 Groovy;
- 查有没有 multicast 发现、有没有自动化脚本依赖
_shutdown; - 查 mapping 里有没有
murmur3、_size,提前装好对应插件。
这份名单的价值在于"它们为什么被删"
一条条看"删了什么"意义不大,要看的是这些功能被删的共同原因:
- rivers:和 ES 的核心职责(存和搜)无关,是数据同步。放在 ES 内部维护,既分散精力,又与"同步动态映射更新"这类改动冲突。删掉之后,这块需求交给了 Logstash 和自研同步程序;
- facets:被维度更高的聚合模型取代(见 facets 与聚合的由来);
- MVEL:通用语言加沙箱的路子走不通,后来换成 Painless 这种专用语言;
- multicast:零配置发现听起来方便,文档列出的问题是 Linux 和 OS X 的多播行为不一致,有些网络还默认禁用多播;
_shutdown:节点的启停交给操作系统和启停脚本,ES 不再提供远程关停。
被删的东西大多是"当初加进来、但与核心职责无关"的能力。2.0 这次集中清理,是把与存储和检索无关的部分移到插件或外部工具。
升级前怎么确认自己有没有踩中
# 1) 有没有 river(插件 + _river 索引)
curl -s 'localhost:9200/_cat/plugins?v'
curl -s 'localhost:9200/_cat/indices?v' | grep -i river

# 2) 有没有 facets 在用(含 Kibana 版本)
grep -rn '"facets"' --include=*.json . | head -20

# 3) 脚本语言设置与脚本内容
curl -s 'localhost:9200/_cluster/settings?include_defaults=true' | grep -i script
grep -rn 'lang.*mvel\|"mvel"' . | head -20

# 4) 有没有 multicast 发现 / _shutdown 调用
grep -rn 'multicast' /etc/elasticsearch/elasticsearch.yml
grep -rn '_shutdown' --include=*.sh --include=*.py . | head -10

# 5) mapping 里的 murmur3 / _size
curl -s 'localhost:9200/_all/_mapping' | grep -o 'murmur3\|_size' | sort -u
这五条跑完,基本能确定 2.0 能不能升。第 2 条里的 Kibana 要单独留意:Kibana 3 的某些可视化依赖 facets,升级 ES 到 2.0 但 Kibana 没同步升级,会出现"图表全空"——是统计接口没了,不是数据丢了。
在 7.17.29 上跑一遍
2.0 删掉的几样东西,在较新版本里各发一次就能看到。
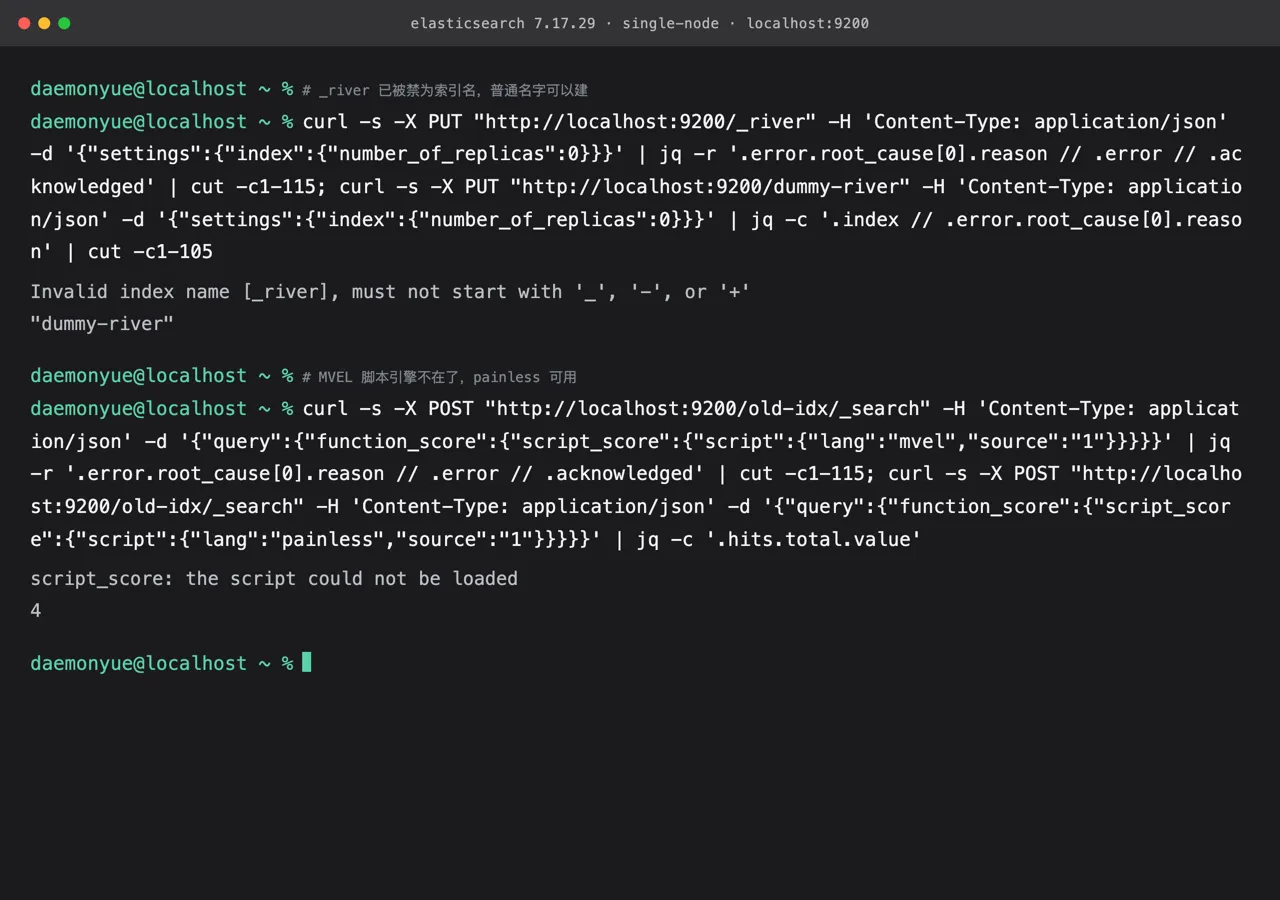
图 1:7.17.29 单节点实例的实测输出。_river 作为索引名被拒、普通名字可建;mvel 脚本报加载失败,painless 命中 4 条。
curl -s -X PUT 'http://localhost:9200/_river' -H 'Content-Type: application/json' \
  -d '{"settings":{"index":{"number_of_replicas":0}}}' | jq -r '.error.root_cause[0].reason'
# Invalid index name [_river], must not start with '_', '-', or '+'
curl -s -X PUT 'http://localhost:9200/dummy-river' -H 'Content-Type: application/json' \
  -d '{"settings":{"index":{"number_of_replicas":0}}}' | jq -c '.index'
# "dummy-river"
for lang in mvel painless; do \
  curl -s -X POST 'http://localhost:9200/old-idx/_search' -H 'Content-Type: application/json' \
    -d "{\"query\":{\"function_score\":{\"script_score\":{\"script\":{\"lang\":\"$lang\",\"source\":\"1\"}}}}}" \
    | jq -r '.error.root_cause[0].reason // .hits.total.value'; done
# script_score: the script could not be loaded
# 4
图 1 把「rivers 与 MVEL 已经不在」落到了两条具体报错上。要注意 _river 被拒是索引命名规则,不等于 2.0 当年的 rivers 服务实现被复现;本机只验了入口。
边界:
- 图 1 出自 7.17.29 单节点实例,没有 0.90 / 1.x / 2.x 二进制;
- 验的是旧写法在当前版本是否被接受,当年的执行过程与性能未测;
其余同类旧写法未逐个枚举。
facets 的拒绝行为已单独验过,本篇未重复测;rivers 的同步机制未测。
写在最后
2.0 删的这些,大多是"加进来但与核心职责无关"的能力。升级前按上面五条命令自查,尤其是 river 和 Kibana 版本这两项,它们决定的是"能不能升"而不是"要不要改代码"。
这是两类问题,要分开排期:
- 能不能升:有阻塞项就升不了,必须先解决。river、Kibana 版本属于此列;
- 要不要改代码:升了之后某些写法不灵了,需要改。工作量大,但可以选择什么时候改。
先解决前者,再排后者。把两类混在一起排期,结果往往是先改了一堆代码,最后发现还有个阻塞项没处理,前期工作白做。
关于"删除"这件事本身,判断这类集中清理是必要的。一个功能加进来容易,去掉难,因为总会有人在用;但不清,系统会越来越臃肿,每个新功能都要考虑跟一堆历史包袱兼容。2.0 这么做,说明当时维护者把"长期健康"排在了"短期兼容"前面。
对使用者的启示:依赖某个边缘功能时,要留意它是否还在被积极维护,以及它与核心职责是否相关,这类功能最容易出现在删除清单上。
参考
本文对照 Elasticsearch
v2.4.6标签的官方文档核对,引文逐字取自原文。「在 7.17.29 上跑一遍」里已实际验证_river索引名被命名规则拒绝、mvel脚本报the script could not be loaded,而普通索引名与painless都可用。本机无 2.x 二进制,验的是入口在当前版本的状态;rivers 同步机制未实测。